
NVIDIA RTX SparkがゲームにおけるニューラルレンダリングとAIキャラクターを強化
NVIDIA RTX Sparkは、スリムなノートPCやコンパクトなデスクトップでAI開発、クリエイション、ゲームを実現する新しいWindows PCプラットフォームです。NVIDIA Blackwell RTXを搭載しています…
見出し・要約・本文から、情報のつながりを探します。
NVIDIA RTX Sparkは、スリムなノートPCやコンパクトなデスクトップでAI開発、クリエイション、ゲームを実現する新しいWindows PCプラットフォームです。NVIDIA Blackwell RTXを搭載しています…
Simplismartは、年間化した収益のランレートが6か月で14倍に成長し、米国が同社の収益の半分以上を占めていると述べています。
10月27日、楽奇RokidはAIメガネRokid Glasses 2、フルカラーAIメガネRokid Color、およびインタラクティブリングRokid Ringを発表しました。
指数の実装とETFの認可により、香港株市場のAIおよび半導体セクターは新たな組み入れツールと資金流入の入り口を迎えました。
2026年の長沙・1024プログラマーの日に開催されたCEIC消費電子イノベーション大会とCSDNは、深圳で開発者向けの本格的な技術の祭典を共同で実現しました。CEIC組織委員会の常務副主任である楊涛氏がインタビューで述べたように、「消費電子分野におけるあらゆる体験の革新は、結局のところ私たちプログラマーが打ち込むコードによって生み出されるのです。」現在の技術の転換点において、単なる手書きのコードから、エージェントや豊富な端末側APを活用する時代へと進んでいます…
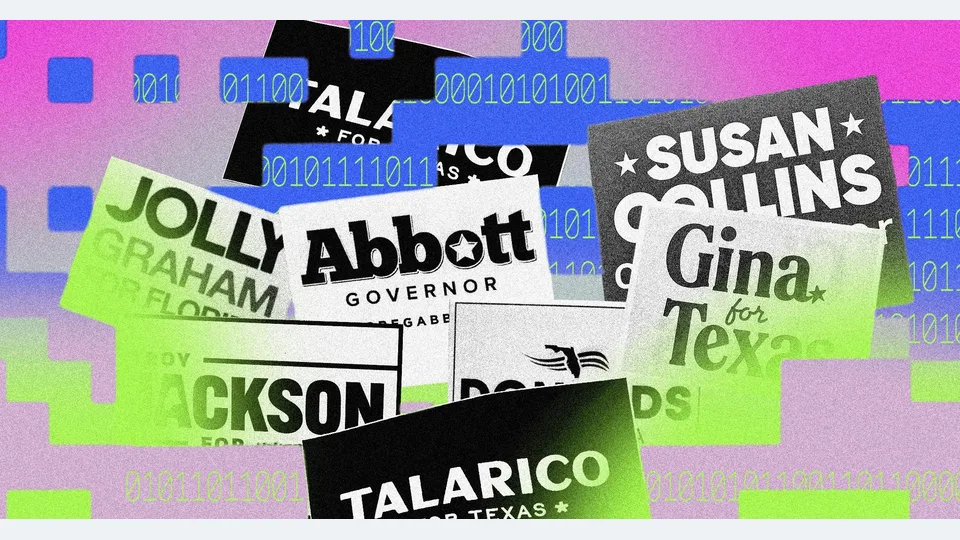
『The Verge』2026年10月27日の報道によると、米国各地のコミュニティでは、データセンターの大規模な建設とそれに伴うインフラ整備費用の急増をめぐり広範な反対運動が勃発しており、この問題は複数の連邦議会選挙および州知事選挙に深刻に影響を及ぼしている。テクノロジー系資本の参入も加速しており、マーク・アンドリーセン氏とグレッグ・ブロックマン氏が支援するスーパーPAC「Leading the Future」は、1年間で4,500万ドルを投入しているほか、Anthropicが支援する「Public First Action」も同様に参画している。
注目する理由:材料の出典が明確であり(The Verge)、公開日時が現在のシステム時刻と一致している(2026-10-27)、内容は検証可能な公共政策および選挙動向に焦点を当て、具体的な主体・金額・時間軸・組織間の関係性を含んでおり、時事性と事実に基づく正確性の要件を満たしています。
vLLMセマンティックルーターは、270億パラメータ規模のオープンウェイトなマルチモーダル意思決定モデルであるd3-ultraをリリースしました。同モデルはテキスト、画像、動画を一度に読み込み、各回答に対する確率を返却し、チームのSR-Textテストで87.2点を獲得しています。この記事「vLLMセマンティックルーター、270億パラメータ規模のオープンマルチモーダル意思決定モデルd3-ultraをリリース」は、MarkTechPostに最初に掲載されました。

arXiv:2610.34907v1 発表タイプ:新規 要旨:NVIDIA Hopperで導入されたテンソルメモリアクセラレータ(TMA)は、実運用のGPUカーネルにおいて広く用いられているにもかかわらず、その使用状況は極めて選択的である。CUTLASS、FlashAttention-3、FlashInferなどの専門的なカーネル開発者たちは、カーネル内の一部のテンソルオペランドに対してTMAを適用する一方で、他のオペランドについてはcp.asyncや直接グローバルロード、あるいは分散共有メモリ(DSM)に回帰している。ベンダーのドキュメントではAPIが説明され、最近のマイクロベンチマークによる研究ではTMAのスループットが単独で評価されているが、実際の実務者が直面する問いにはいずれも答えられていない。すなわち、カーネル内で特定のメモリオペランドが存在する場合、それをTMAで処理すべきなのか、また、もしTMAを使うならクラスタマルチキャストを併用すべきか否かという問題である。本研究では、H100を対象としたワークロードに基づく特性評価を通じて、このギャップに取り組む。我々はTMAの利用状況を体系的に整理し、多
arXiv:2610.33275v1 発表タイプ:新規 要旨:計算ノートブックはセッション全体にわたってGPUを占有しますが、GPUが計算を行うのはセルが実行中であるときだけで、それ以外の時間はアイドル状態となります。サーバーレス実行であれば、セル間でGPUを解放できますが、新しいワーカー上で蓄積されたノートブックの状態を再構築するには、各GPUセルごとに大きなコストが伴います。本論文では、対話型ノートブック向けのサーバーレスGPUプラットフォームであるLooseLeafを提案します。LooseLeafは、各セルの状態とインポートクロージャー、すなわちそのセルが必要とする最小限の変数やパッケージを導出します。実世界のノートブック5,000件に対する分析から、これらのクロージャーは非常に小さく、ユーザーによるセルの編集によっても、準備に要する時間は数秒程度であることが示されました。LooseLeafは、ユーザーがセルを編集している間に、これらのクロージャーを用いてGPUワーカーを準備します。実行後、ワーカーは…

arXiv:2610.33475v1 発表タイプ:新規 要旨:クラウドデータセンターにおける基盤となる大規模言語モデル(LLM)の広範な導入は、ステートレスなディープラーニングから分散型でメモリ集約的な生成ワークロードへと、根本的なパラダイムシフトを示しています。しかし、厳しいサービスレベル目標(SLO)の下で巨大な基盤モデルを運用するには、重要な物理的およびシステム上のボトルネックが露呈します。これらの課題には、依然として克服されていない高帯域幅メモリ(HBM)の壁、計算負荷に依存するプリフィル処理とメモリ帯域幅に制約されるデコード処理との間の運用上の非対称性、急増するキー・バリュー(KV)キャッシュの膨張、コスト面で非常に負担の大きいサーバーレス環境でのコールドスタート、さらにはハードウェアの信頼性に関する脆弱性などが含まれます。既存の文献レビューは依然として層ごとの分断状態にあり、低レベルのアクセラレータ仮想化とクラスター間の統合が切り離されたままです。
arXiv:2610.33501v1 発表タイプ:新規 要旨:大規模言語モデル(LLM)のサービスでは、推論スループットを向上させるためにバッチ処理が用いられるが、キー値(KV)キャッシュはシーケンス長に応じて増大し、GPU上での並行処理能力を制限する要因となっている。CPUオフロードによりホストメモリを活用してKV容量を拡張することは可能だが、既存のシステムは依然として大部分がGPUに依存しており、CPU上に常駐するリクエストが進捗するのは、GPUスケジューラが適切なオーバーラップの機会を提供した場合に限られる。その結果、ホストメモリとCPU計算は独立したサービス資源として機能せず、負荷下ではCPU側の進捗が断続的になり、末端のトークン間遅延(ITL)が過剰に増大するという問題が生じる。本稿では、ホストを独立してスケジュール可能なデコードエンジンへと変える、LLM向けの実行時環境であるDualPaceを提案する。DualPaceは、スケジューリング権限を二つのエンジン間に分割し、GPUエンジン
上場準備を進めるなか、AnthropicのS-1届出書は、生成AIがメタンに依存している現状を露骨に示している。「電力供給へのアクセスや、十分な電力供給が確保できるデータセンターの立地を巡る競争は激化している。」米証券取引委員会に月曜日提出された文書において、Anthropicは、データセンターがますます「天然ガス」に依存するようになっていることを認めている[…]

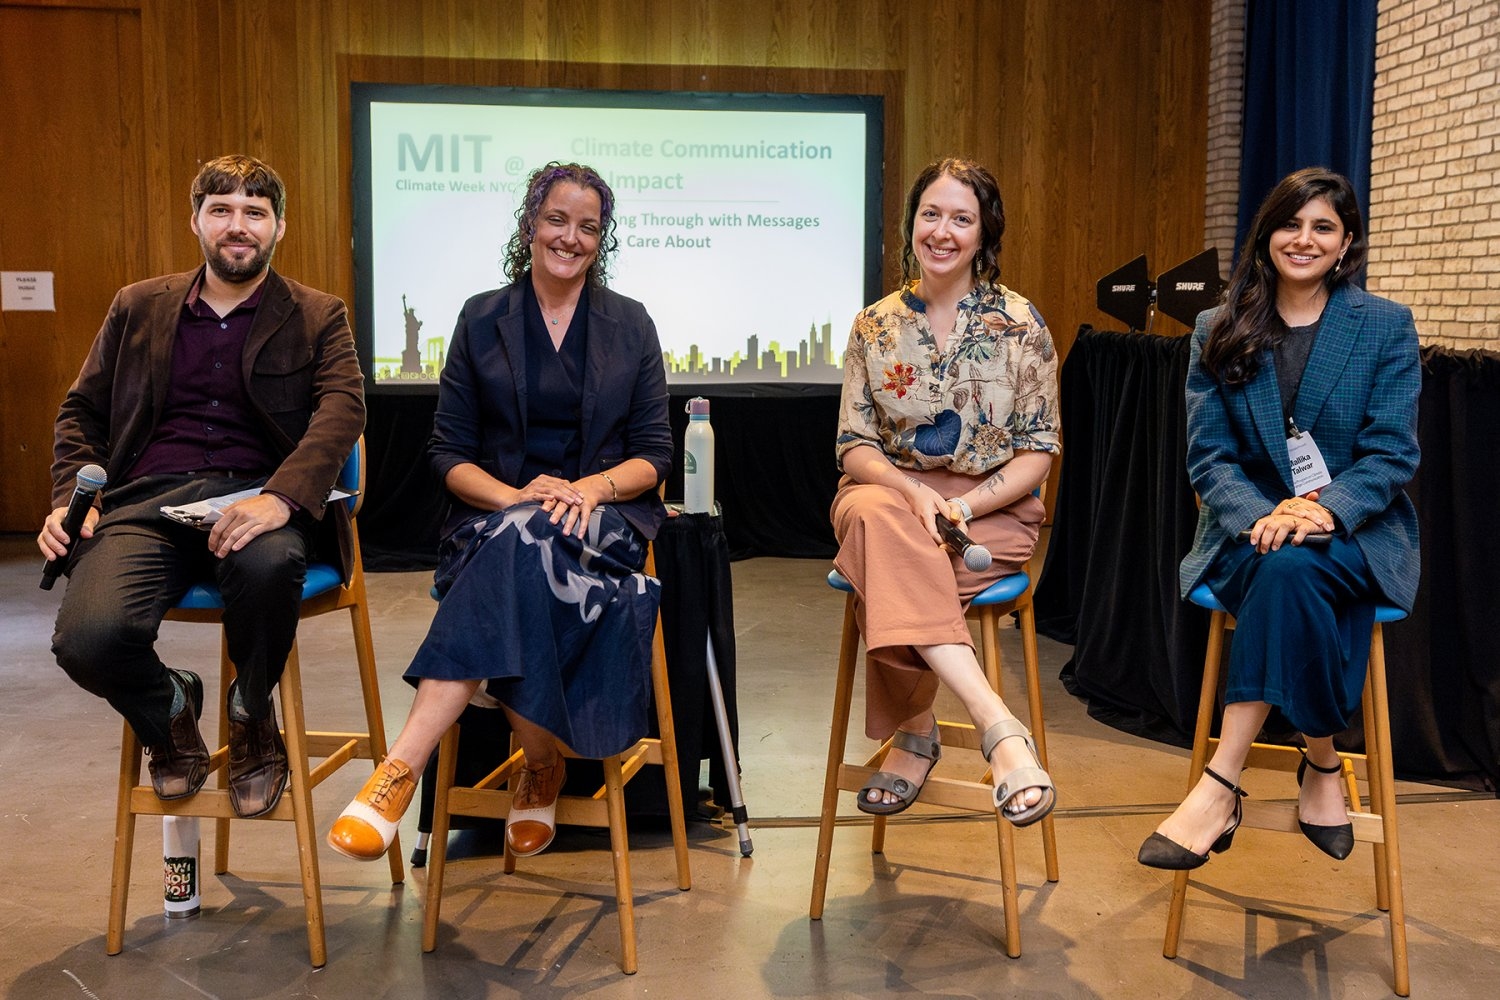
MITコミュニティの各層が集まり、データセンターや強力な温室効果ガスから農業や教育に至るまで、幅広いテーマについて議論を交わしました。
本日は、ワークステーション向けのASRock製ハイエンドRadeon AI推論カード「Creator Radeon AI Pro R9700」をご紹介します。32GBのメモリを搭載し、価格は1,700ドルというこのカードは、ローカルでのAI推論を実行するワークステーションを手頃なコストで構築するうえで非常に優れた選択肢です。記事「ASRock Creator Radeon AI Pro R9700レビュー:AMD流ワークステーション向け推論」は、ServeTheHomeに初出しました。
SpaceXは、AIチップおよび関連するデータセンター設備の購入費用として、約400億ドルの資金調達に関する拘束力のある契約を締結したと、同社は月曜日の規制当局への提出書類で明らかにしました。声明において、SpaceXはこれを史上最大規模のGPU向け資金調達であると述べています。
AIファクトリーは、これまでに作られた中でも最も技術的に複雑な運用環境の一部です。数十万ものGPU、NVIDIA Spectrum-Xイーサネット……
8年前、チップメーカーのマーベル・テクノロジー社はナノメートル単位での技術革新を一気に進めることを決断し、以来その成長軌道は着実に上向き続けている。半導体製造において、ナノメートル表記はトランジスタの正確な物理寸法を示すのではなく、プロセスノードと呼ばれるチップ製造技術の世代を指すものである。先進的なプロセスノードは一般に、より高いトランジスタ密度と性能の向上を実現する[…] 「AI需要の高まりの中で、マーベルの初期のチップ製造への賭けが実を結ぶ」という記事は、最初にSiliconANGLEに掲載された。
数千台のGPUで大規模なAIモデルをトレーニングする作業は、クラスターの耐障害性を最適化するために監視と自動化を組み込む必要がある、極めてリスクの高い運用です…
京東広告は華為の鲲鵬と協力し、霊衢相互接続を活用して300TB規模の共有メモリプールを構築、RPC通信を再構築することで、エンドツーエンドの推論遅延を15%低減しました。また、KVキャッシュおよびRPCの性能が大幅に向上し、2026年の618大促における主要なシナリオでトラフィックの5%による検証も実施されています。さらに、この協業は検索・推薦といったサーチ&レコメンデーションの各シーンへ波及しており、SuperCacheやAgentサンドボックスなど、Agentic AIの先端分野にも展開しています。
注目する理由:この報道は、2026年10月26日にtmtpost.comが公開したオリジナルの技術ニュースに基づいており、実際の導入事例に焦点を当てた技術連携について述べています。具体的には、協業主体(JD広告/Huawei Kunpeng)、技術的アプローチ(Lingqu Interconnect、二段階キャッシュ、UBプロトコルによるURMAへの直接接続)、定量的な効果(遅延が15%削減、TP99の最適化率が85%超)、検証されたシナリオ(618セール時のトラフィックの5%)および今後の進化計画(SuperCache、Agentサンドボックス)を明示しています。すべての重要な事実は資料内で相互に裏付けられており、外部からの補足情報や主観的な推論は一切含まれていません。
2026年10月23日、博納映画が製作した『三星堆:未来往事』は、国内で初めて公開許可を取得し、制作全工程にAIを活用して商業系映画館で正式公開された長編映画として、全国の映画館に上陸した。本作は全編デジタルキャラクターによる作品で実写俳優は登場せず、制作費は千万規模に達したにもかかわらず、初週末の興行収入は約118万元にとどまり、上映スケジュールや来場率も低迷しており、物語の受容度と産業化の実装との間に存在する現実的なギャップが浮き彫りになった。
注目する理由:本報道は、钛媒体が2026年10月26日に公開した深掘り記事に基づいており、映画の技術的定位(初のAIによる劇場用長編映画)、制作状況(120万枚のベース画像、600対1の廃棄率、フレームごとの手作業による調整)、産業上の意義(審査から配給までの全フローの実証)および市場反応(低興行収入、チケット価格をめぐる論争、観客の様子見)を網羅しています。情報要素はครบถ้วนで、出典も明確、時効性も高く、資料に記された事実の範囲を超えていません。