본문으로 건너뛰기
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI 뉴스 검색

제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.

발행 시간순

NUMA-Torch: 멀티소켓 CPU에서 컴파일러 기반 NUMA 인식 LLM 프리필

arXiv:2611.07105v1 발표 유형: 신규 초록: 온칩 캐시에 매개변수를 저장할 수 없는 충분히 큰 변환기 기반 대규모 언어 모델(LLM)의 경우, 멀티 소켓 CPU에서의 프리필 처리량은 최대 부동소수점 처리량이 아닌 지속 가능한 DRAM 대역폭에 의해 종종 제한됩니다. 표준 PyTorch 컴파일(즉, TorchInductor) 경로에서는 메모리 뱅크와 연산 코어 간의 연관성을 고려하지 않고 모델 가중치를 할당합니다. 이로 인해 가중치 접근의 상당 부분이 소켓 간 상호 연결을 통과하게 되어 각 소켓에서 사용할 수 있는 유효 메모리 대역폭이 크게 저하됩니다. 우리는 TorchInductor를 NUMA-aware로 만드는 컴파일러 수준의 솔루션을 통해 이러한 병목 현상을 해결합니다. 각 NUMA 소켓을 독립적인 텐서 병렬 파티션으로 취급하여 NUMA-aware Tensor Parallelism(NUMA-TP)을 도입합니다. 이 방법은 소켓 간에 가중치를 투명하게 분할하고 연산 커널을 스케줄링하여 스레드 풀과 메모리 할당이 CPU 연관성을 활용해 해당 소켓 내에서 엄격히 로컬로 유지되도록 합니다. 우리는 GPT-2(117M, 345M, 762M) 및 BERT(Small, Large)와 같은 표준 다중 헤드 주의와 MLP를 테스트하며, Multi-Query Attention과 GeGLU 게이트된 MLP를 결합한 Gemma 3 270M에서도 이 접근법을 평가합니다. 데이터 지역성을 엄격히 준수함으로써 우리의 접근법은 소켓 간 트래픽을 성공적으로 완화하여 듀얼 소켓 Haswell 플랫폼에서 최대 2.63배, 듀얼 소켓 Cascade Lake 플랫폼에서 최대 1.87배, 그리고 사중 소켓 Haswell-EX 플랫폼에서 최대 2.27배의 프리필 속도 향상을 달성했습니다.

듣는 기계 만들기

파리스 스마라그디스 교수는 음성 인식, 음악 이해, 환경 모니터링 등 다양한 분야에 활용될 초인간 수준의 청력을 갖춘 컴퓨터를 개발하고 있습니다.

新闻源配图 · MIT News AI
진행 상황 및 관련 보도

프론티어 대규모 언어 모델에서의 애쉬 동조에 대한 정량적 접근

arXiv:2610.36668v1 발표 유형: 신규 초록: 애쉬 동조 실험은 최근 대규모 언어 모델(LLM)에서의 동조를 측정하는 방법으로 상당한 주목을 받고 있습니다. 기존 연구들이 LLM에서의 동조를 입증하는 데 집중해 왔다면, 우리 연구는 이 접근법에 추가적인 정량적 층을 더합니다. 우리는 프론티어 LLM을 여러 질문 세트에 대해 샘플링하는 대신, 단일 질문을 반복적으로 샘플링하여 LLM의 확률적 특성을 활용해 답변 분포를 생성합니다. 이를 통해 모델에 가공된 합의가 제시되기 전후의 답변 분포를 비교할 수 있습니다. 우리의 실험은 프론티어 LLM이 실제로 동조를 보임을 확인하며, 기존 문헌을 뒷받침하고, 분포 간 비교를 통해 추가적인 정보를 제공합니다.

진행 상황 및 관련 보도

대규모 언어 모델에서 세계 모델로의 발전

옌더리, 텐센트의 수석 전문가 LLM은 확률 모델이며, 인과관계를 이해하지 못합니다. 대규모 언어 모델(LLM)은 언어를 실제로 이해하는 것이 아니라 다음 토큰을 예측하는 데 그칩니다. 이는 지루한 ‘글자 연속하기’ 기계와 같아서 한 단계씩 나아가며 그때그때 계산할 뿐, 되돌아가지 않습니다. 본질적으로 LLM은 확률 모델로서, 통계적 동시 발생 구조 속에서 ‘무엇이 자주 무엇과 함께 나타나는지’를 학습하고, ‘대체로 그렇다’는 결과를 출력할 뿐 ‘왜 그런지’는 이해하지 못합니다…

从大语言模型迈向世界模型
진행 상황 및 관련 보도

vLLM 시맨틱 라우터, d3-ultra 출시: 27B 규모의 오픈형 멀티모달 의사결정 모델

vLLM 시맨틱 라우터가 27B 규모의 오픈 웨이트 멀티모달 의사결정 모델인 d3-ultra를 출시했습니다. 이 모델은 텍스트, 이미지 및 비디오를 한 번에 처리한 뒤 모든 답변에 대한 확률을 반환하며, 팀의 SR-Text 테스트에서 87.2점을 기록했습니다. 해당 게시물 “vLLM 시맨틱 라우터, 27B 규모의 오픈 멀티모달 의사결정 모델 d3-ultra 출시”는 MarkTechPost에 처음 게재되었습니다.

新闻源配图 · MarkTechPost
진행 상황 및 관련 보도

바이두, 수백 페이지 문서 파싱을 위한 무제한 OCR 2 오픈소스 출시

바이두는 MIT 라이선스를 적용한 3B 규모의 OCR 모델인 ‘Unlimited OCR 2’를 출시했으며, 이 모델은 한 번의 요청으로 수백 페이지에 달하는 문서를 처리할 수 있습니다. 해당 모델의 SR-SWA 주의 메커니즘은 단계별 디코딩 비용을 거의 일정하게 유지하며, MarathonDocBench에서 77.1점의 성능을 기록했습니다. 본 글은 ‘바이두, 수백 페이지 문서 파싱을 위한 Unlimited OCR 2 오픈소스화’라는 제목으로 MarkTechPost에 처음 게재되었습니다.

新闻源配图 · MarkTechPost
진행 상황 및 관련 보도

시스코 파트너 서밋: AI 시대의 채널을 규정할 다섯 가지 인사이트

30년에 달하는 역사의 대부분 동안 시스코 파트너 서밋은 파트너들이 시스코 시스템즈 주식회사의 기술을 어떻게 판매하는지에 초점을 맞춰 왔습니다. 올해 밴쿠버에서 열린 행사에서는 상황이 달랐습니다: 거래가 더 이상 주요 이벤트가 아닌 세상에서 파트너들이 어떻게 수익을 창출하는지에 관한 것이었습니다. 시스코는 주가가 […] 하락한 가운데 엄청난 모멘텀을 바탕으로 이번 행사에 참석했습니다. 해당 게시물 ‘시스코 파트너 서밋: AI 시대의 채널을 규정할 다섯 가지 인사이트’는 실리콘앵글에 처음 게재되었습니다.

진행 상황 및 관련 보도

TMA를 언제, 왜 사용해야 하는가: NVIDIA Hopper GPU에서의 텐서 메모리 가속에 대한 워크로드 기반 특성 분석

arXiv:2610.34907v1 발표 유형: 신규 초록: NVIDIA Hopper에서 도입된 텐서 메모리 가속기(TMA)는 실제 생산 환경의 GPU 커널에서 광범위하게 사용되고 있지만, 그 활용은 상당히 선택적입니다. CUTLASS, FlashAttention-3, FlashInfer 등에서 활동하는 전문 커널 개발자들은 커널 내 일부 텐서 피연산자에 대해 TMA를 적용하되, 다른 피연산자에 대해서는 cp.async, 직접 글로벌 로드, 또는 분산 공유 메모리(DSM)로 대체합니다. 벤더 문서에서는 API를 설명하고, 최근의 마이크로벤치마킹 연구에서는 TMA의 처리량을 단독으로 평가하고 있지만, 이러한 접근 방식들은 실무 현장에서 실제로 직면하는 질문에 답하지 못합니다: 커널 내 특정 메모리 피연산자가 주어졌을 때, 이를 TMA로 처리해야 하는지, 그리고 만약 그렇다면 클러스터 멀티캐스트를 함께 사용할 것인지 여부를 결정하는 문제입니다. 우리는 H100을 대상으로 한 워크로드 기반 특성 분석 연구를 통해 이와 같은 간극을 해소하고자 합니다. 우리는 TMA와 다중

진행 상황 및 관련 보도

트랜스포머 이론을 시험에 들이기

arXiv:2610.32104v1 발표 유형: 신규 초록: 변환기 아키텍처의 능력과 한계를 규명하기 위해 여러 가지 형식적 이론들이 개발되어 왔으며, 각 이론은 아키텍처의 서로 다른 특징을 포착하는 다양한 추상화 방식을 사용한다. 이러한 이론들은 기본 가정과 개념적 틀의 차이로 인해, 변환기가 어떤 과제를 쉽게 또는 어렵게 여길지에 대한 예측에서 서로 상충될 수 있다. 우리는 변환기 능력에 관한 일곱 가지 이론(Star-free, $\mathsf{AC}^0$, $\mathsf{TC}^0$, C-RASP, MPC, BAPO, 그리고 Sensitivity)을 정리하고, 이를 다양한 계산 구조를 포괄하는 여러 과제 세트에 걸쳐 공통적인 예측 매트릭스로 변환하였다. 또한 이 매트릭스를 완성하기 위한 새로운 이론적 결과를 제시한다. 이후 우리는 이론적…

진행 상황 및 관련 보도

v0.43.0

## 변경된 내용 * model_prefetch: https://github.com/Comfy-Org/ComfyUI/pull/17178에서 @rattus128이 모든 그래프 정리 작업을 동기화했습니다 * https://github.com/Comfy-Org/ComfyUI/pull/17172에서 @kijai가 MOSS-image에 로프 스케일링 지원 기능을 추가했습니다 * [파트너 노드] https://github.com/Comfy-Org/ComfyUI/pull/16943에서 @dante01yoon이 API 노드의 파트너 노드 로그인 토큰을 갱신했습니다 * [파트너 노드] feat(HeyGen): https://github.com/Comfy-Org/ComfyUI/pull/17043에서 @bigcat88이 HeyGen Voice 즉석 클론 및 텍스트 음성 변환 기능을 추가했습니다 * [파트너 노드] feat(ClarityAI): https://github.com/Comfy-Org/ComfyUI/pull/17192에서 @bigcat88이 Crystal Video Upscaler 노드를 추가했습니다 * [파트너 노드] feat(BFL): https://github.com/Comfy-Org/ComfyUI/pull/17200에서 @bigcat88이 FLUX 3 비디오 노드에 2K/4K 해상도 옵션을 추가했습니다 * MOSS-image 지원

진행 상황 및 관련 보도

양날의 검: AI는 시스템 보호를 강화하는 동시에 악성 행위자들에게 새로운 취약점을 열어준다

사이버보안 업계는 강력한 최첨단 AI 모델이 양날의 검임을 깨닫고 있습니다. 기업들은 이러한 모델을 활용해 소스 코드와 시스템 구성의 취약점을 그 어느 때보다 빠르게 식별할 수 있습니다. 그러나 알고 보니 악성 행위자들도 이와 같은 작업을 수행할 수 있습니다. AI 모델이 사이버보안 분야를 새로운 차원으로 전환시킨 대표적인 사례는 다음과 같습니다 […] 본 글은 ‘양날의 검: AI가 시스템 보호를 한층 더 정교하게 만드는 동시에 악성 행위자들에게 새로운 취약점을 열어주다’라는 제목으로 SiliconANGLE에 처음 게재되었습니다.

진행 상황 및 관련 보도

케빈 루스는 AGI에 사로잡혔다. 당신은 왜 그렇지 않은가?

오늘은 AI 산업의 최근 급격한 변화를 상세히 다룬 신간 『AGI 연대기』의 저자이자 기자인 케빈 루스와 이야기를 나눕니다. 케빈은 오랜 기간 뉴욕타임스의 기자로 활동해 왔으며, 인기 팟캐스트 ‘하드 포크’의 진행자이기도 합니다. 그러나 그는 이 프로그램의 친구인 케이시 뉴턴과 함께 최근 […]을 떠났습니다.

Kevin Roose is AGI-pilled. Why aren’t you?Kevin Roose is AGI-pilled. Why aren’t you?
진행 상황 및 관련 보도

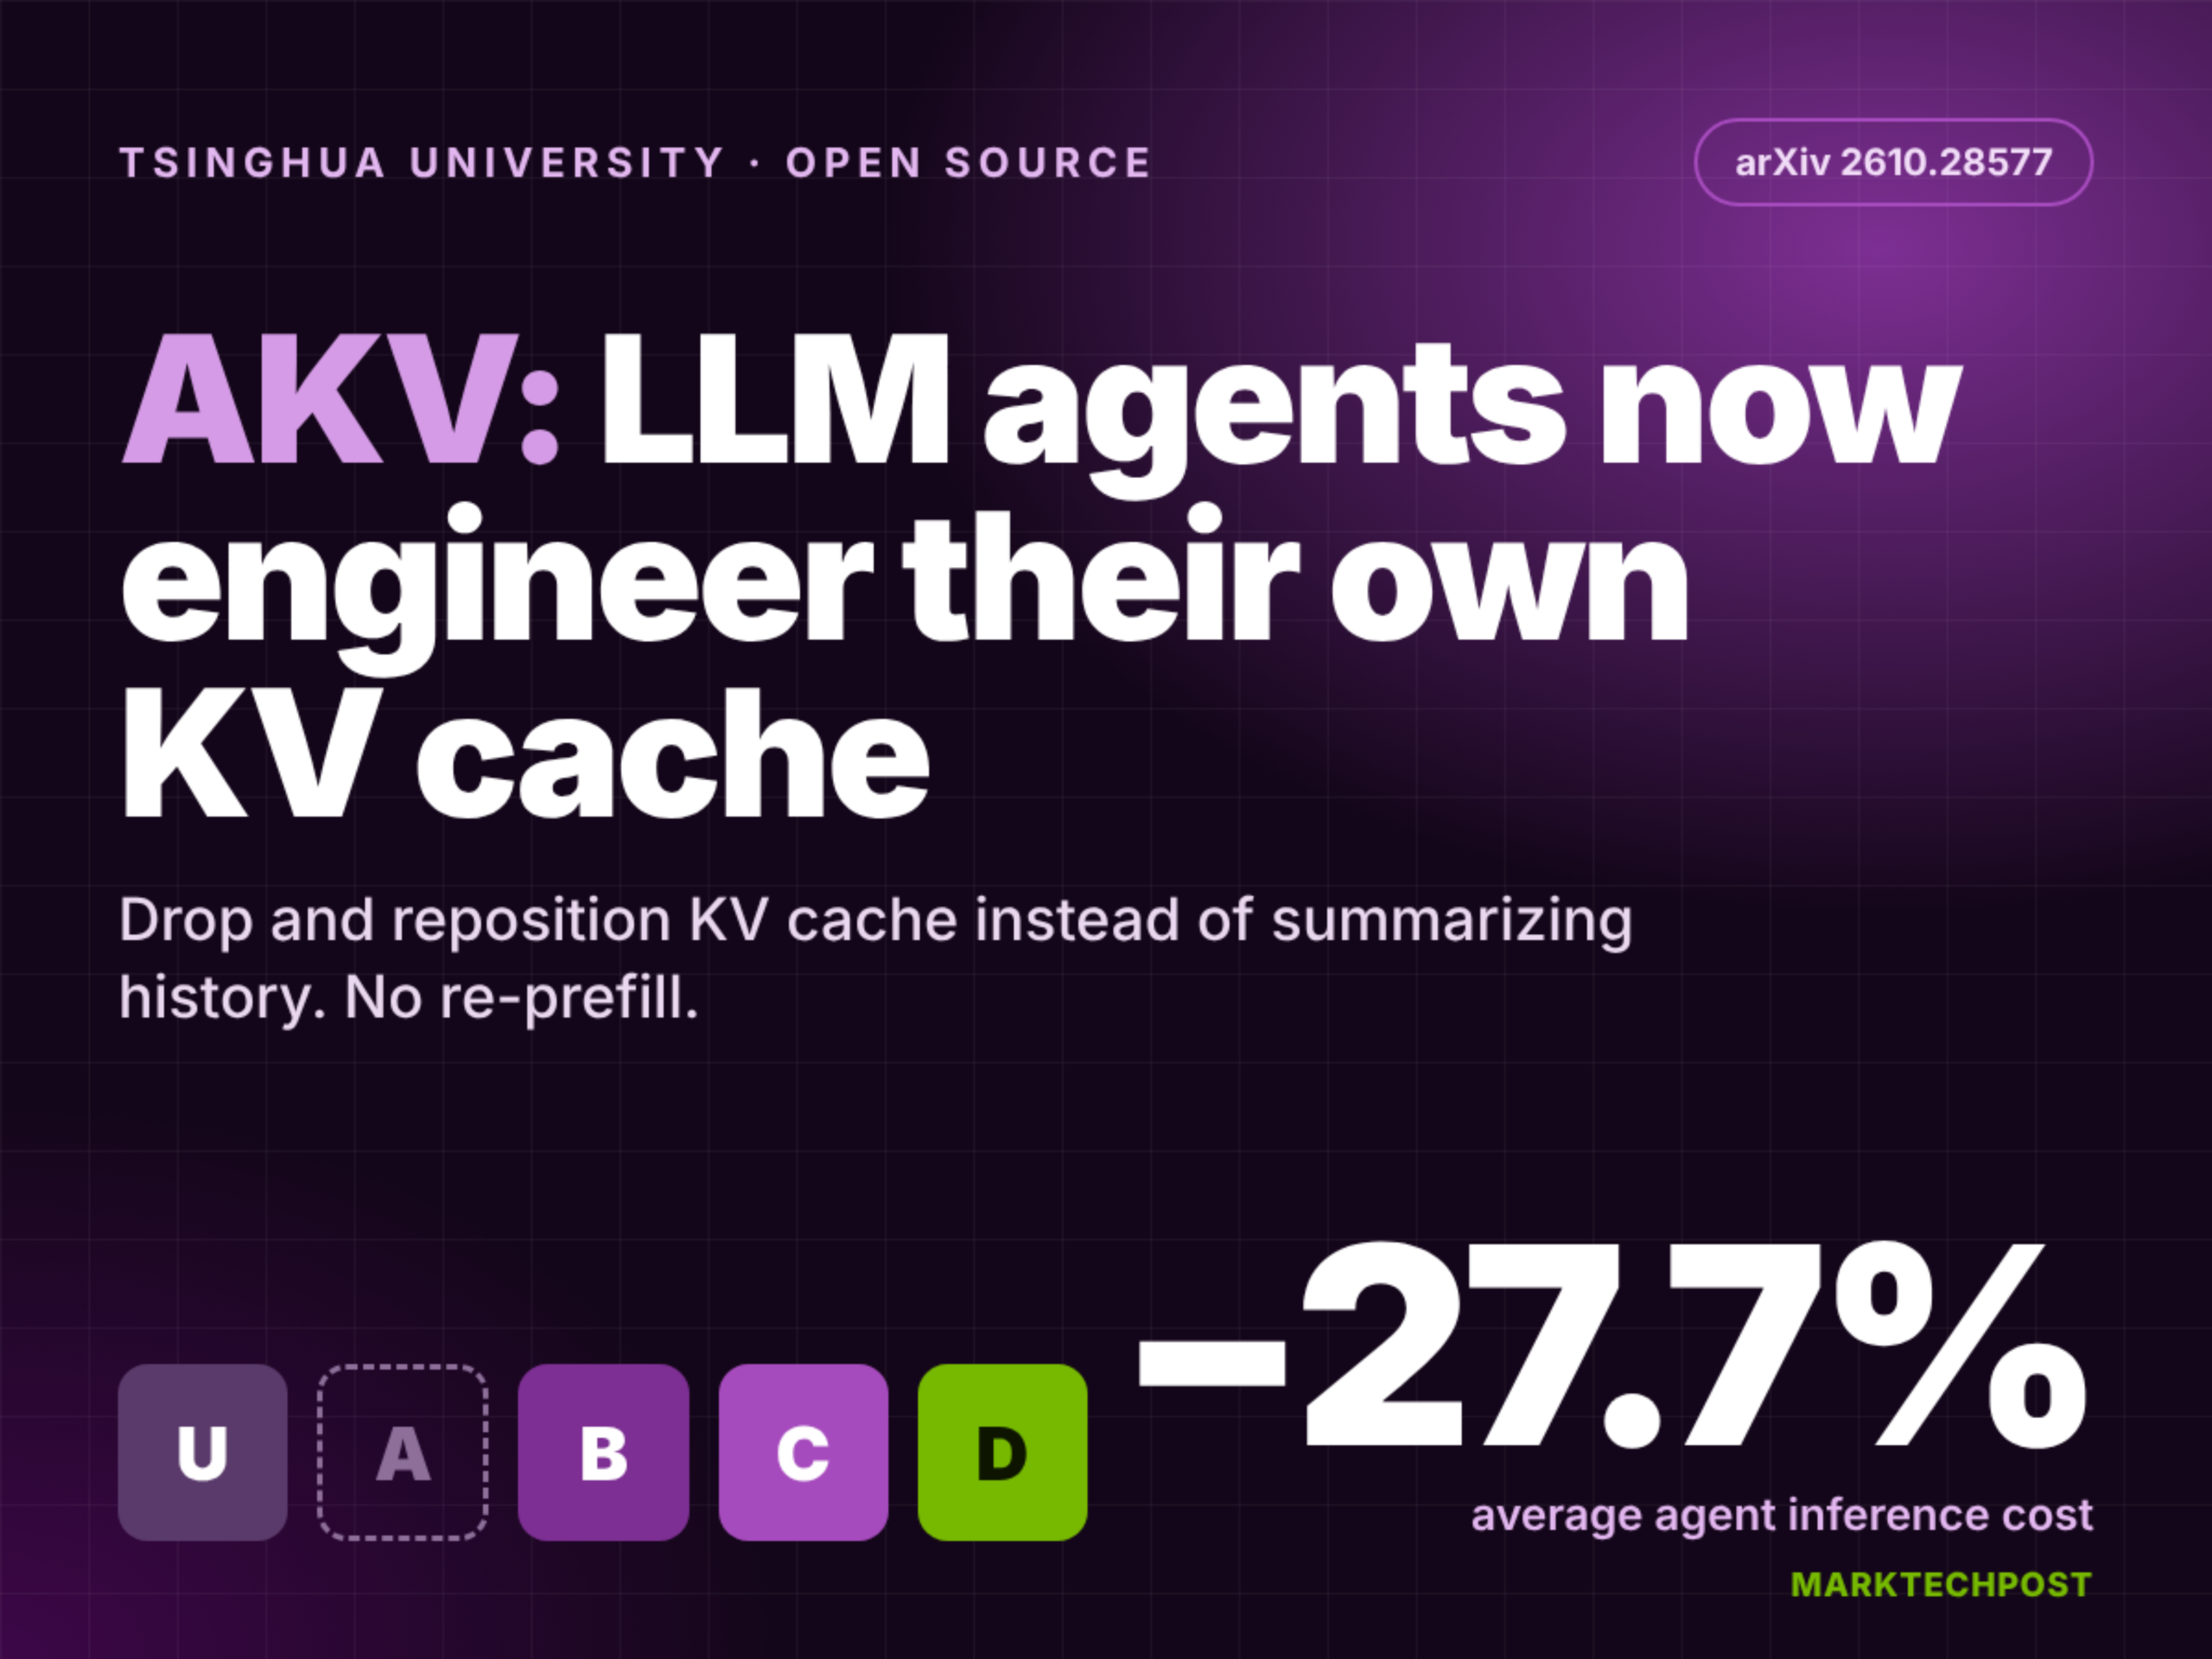
칭화대학교와 홍콩중문대학교가 공동으로 오픈소스 AKV를 출시했습니다: LLM 에이전트를 위한 KV 캐시 엔지니어링 서비스 시스템

칭화대학교와 홍콩중문대학교의 연구진은 2026년 10월 26일, SGLang 기반으로 구축된 대규모 언어모델(LLM) 에이전트 전용 KV 캐시 엔지니어링 서버인 AKV를 오픈소스로 공개했습니다. 이 시스템은 기존의 텍스트 히스토리 요약 방식이 아닌, 에이전트가 스스로 KV 캐시를 적극적으로 버리고 재배치하도록 함으로써, 4개의 에이전트 벤치마크에서 추론 비용을 평균 27.7% 절감하고, 과제 평균 점수를 1.7점 상승시켰습니다. 해당 코드는 Apache-2.0 라이선스를 적용했으며, 현재 Qwen, GPT-OSS-120B, MiniMax-M2.7 등의 모델을 지원합니다.

Tsinghua AI Open-Sources AKV, a Cache Engineering Server for LLM Agents on SGLang

추천 이유:이 성과는 LLM 에이전트의 효율적 추론을 위한 새로운 패러다임을 제시합니다. 텍스트 절단이나 요약에 의존하는 ‘컨텍스트 엔지니어링’과 달리, AKV는 KV 캐시 상태를 직접 조작하여 중복 프리필을 방지함으로써 장거리 상호작용에서의 KV 부하를 크게 완화합니다. 실제 실험 결과, 높은 동시성 환경에서 P95 지연 시간이 229.9초에서 30.6초로 감소하여 명확한 엔지니어링 가치와 재현 가능성을 입증했습니다. 해당 정보는 MarkTechPost가 발표한 권위 있는 기술 보고서에 근거하며, 게시일시(2026-10-26T07:56:45Z)가 현재 시각과 일치해 최신 공개된 진행 상황임을 나타냅니다.

진행 상황 및 관련 보도

중국 소매업체들은 AI 도구에 비용을 지불하는 반면, 소비자들은 여전히 보조금을 추구하고 있다

싱글스 데이 기간 동안 챗 어시스턴트는 쿠폰을 활용해 주문을 유도할 수 있는 반면, 마켓플레이스 소프트웨어는 이미 디자인 및 운영 업무에 대한 비용을 청구하고 있습니다. 플랫폼들은 소비자의 신뢰를 수익화하는 속도보다 기존 예산을 더 빠르게 수익화하고 있습니다.

진행 상황 및 관련 보도

SyncVid: 동기화된 비디오 생성을 위한 세계-불변 디퓨전

arXiv:2610.31765v1 발표 유형: 신규 초록: 단일 참조 비디오로부터 동적 장면의 여러 비디오를 생성하려면, 서로 다른 시점 간에 관찰된 내용과 미관찰된 내용을 일관되게 합성해야 합니다. 기존의 비디오 디퓨전을 위한 카메라 제어 방법들은 일반적으로 카메라 임베딩, 시각 간 주의 메커니즘, 기하학적 조건부 등 다양한 아키텍처적 기법에 의존합니다. 이러한 접근법은 정적인 장면의 콘텐츠에는 효과적이지만, 시점 간 및 시간에 걸쳐 일관성을 유지해야 하는 세밀하고 동적인 기하학적 특성에는 종종 어려움을 겪습니다. 우리는 각 2D 이미지 평면에서 독립적으로 샘플링하는 대신, 소스 비디오로부터 도출된 표준적인 3D 공간에서 가우시안 노이즈 사전 분포를 샘플링하고 이를 타겟 카메라로 래스터화함으로써 디퓨전 과정 자체를 동기화합니다. 우리의 m

SyncVid: World-Equivariant Diffusion for Synchronized Video Generation
진행 상황 및 관련 보도

LazyFlash: 가속화된 장문 컨텍스트 미세조정을 위한 전방 밀집·후방 희소 주의

arXiv:2610.31911v1 발표 유형: 신규 초록: 대규모 언어 모델(LLMs)이 점점 더 긴 시퀀스를 처리함에 따라, 주의 메커니즘은 주요 계산 병목으로 부각되고 있습니다. 희소 주의는 대부분 추론 단계에 초점을 맞추지만, 여전히 많은 방법들이 밀집형으로 학습되거나 희소 학습을 지원하지 못하며, 추가적인 복잡성으로 인해 희소성이 실제 월클럭 속도 향상으로 이어지기 어려워져 결국 실무에서는 밀집형 주의가 널리 사용되고 있습니다. 본 논문에서는 주의 학습이 후방 패스에 의해 주로 결정된다는 관찰에 기반한 전방 밀집·후방 희소 주의 방식인 LazyFlash를 제안합니다. LazyFlash는 전방 패스를 정확히 밀집형으로 유지하여, 학습된 모델이 vLLM과 같은 기존 시스템에서 아무런 변경 없이 서비스할 수 있는 표준 밀집형 모델로 남도록 합니다. 후방 패스에 대해서는 LazyFlash는 그라디언트-a를 제안합니다.

진행 상황 및 관련 보도