본문으로 건너뛰기
AI NEWS JOURNAL
AI, IN PERSPECTIVE

전체 AI 소식

출처, 주제, 시간으로 전체 뉴스에서 관심 소식을 찾아보세요.

발행 시간순

Mirendil, 1,000만 토큰 규모의 최초 모델인 Fern 0.1을 출시했습니다

Mirendil은 1,000만 토큰의 컨텍스트 창을 갖춘 처음으로 제작된 모델인 Fern 0.1을 출시했습니다. 이 모델은 에이전트형 AI 연구개발 작업을 목표로 하며, 1,000만 토큰 기준 RULER 단일 바늘 테스트에서 100% 점수를 기록했지만, 에이전트형 코딩에서는 최첨단 모델들에 비해 다소 뒤처집니다. 해당 게시물 “Mirendil, 1,000만 토큰 컨텍스트를 갖춘 첫 번째 모델 Fern 0.1 출시”는 MarkTechPost에 처음 게재되었습니다.

진행 상황 및 관련 보도

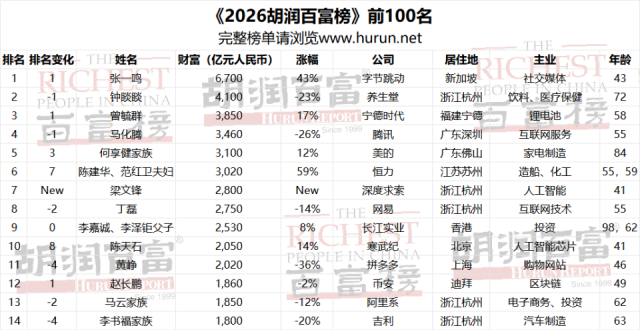
Anthropic가 증권신고서를 제출했으며, 규정을 위반한 사용자가 매출의 최소 5%를 기여한 것으로 나타났다; 후룬 부자 순위 100대 명단에 량원펑 등 AI 분야의 거물들이 대거 이름을 올렸다 | AI 업계에서는 또 어떤 일이 벌어지고 있을까

1. 워커들에게 더 적합한 GPT-6.1 Terra가 출시되며, API 가격은 절반으로 인하되고 컴퓨터 작업 속도는 더욱 빨라집니다. 10월 26일, OpenAI는 GPT-6.1 Terra를 발표했으며, 주요 기능으로 시각적 이해력, 컴퓨터 작업 능력, 사실 정확성 및 프로그래밍 능력을 향상시켰습니다....

Anthropic发招股书,违规用户贡献至少5%收入;胡润富豪榜百强名单,梁文锋等AI大佬纷纷上榜 | AI圈又发生什么了
진행 상황 및 관련 보도

‘높은 점수를 얻는 것’이 곧 ‘완전한 납품 가능성’을 의미하는 것은 아니다: AI 순위표가 신뢰 재평가의 시기를 맞고 있다

구 버전 순위의 점수는 만점에 근접했지만, 신규 버전의 실전 성적은 집단적으로 낙제점을 기록했다. 대형 모델 평가 자체가 하나의 비즈니스로 전환되면서, 기업들의 선택 기준은 이제 순위를 보는 데서 비용 계산으로 옮겨가고 있다.

진행 상황 및 관련 보도

대규모 언어 모델에서 세계 모델로의 발전

옌더리, 텐센트의 수석 전문가 LLM은 확률 모델이며, 인과관계를 이해하지 못합니다. 대규모 언어 모델(LLM)은 언어를 실제로 이해하는 것이 아니라 다음 토큰을 예측하는 데 그칩니다. 이는 지루한 ‘글자 연속하기’ 기계와 같아서 한 단계씩 나아가며 그때그때 계산할 뿐, 되돌아가지 않습니다. 본질적으로 LLM은 확률 모델로서, 통계적 동시 발생 구조 속에서 ‘무엇이 자주 무엇과 함께 나타나는지’를 학습하고, ‘대체로 그렇다’는 결과를 출력할 뿐 ‘왜 그런지’는 이해하지 못합니다…

从大语言模型迈向世界模型
진행 상황 및 관련 보도

MiniMax M3.1Flash의 출시로 ‘문제 재출’ 의혹이 제기됨: 기존 문제에서는 높은 점수, 신규 문제에서는 작동 불능, 환각률 최대 92.8%

MiniMax는 2026년 10월 19일 저가형 대규모 언어 모델 M3.1Flash를 발표했으며, 종합 평가 점수는 42점이었다. 이 모델의 비용은 이전 세대에 비해 70% 감소했지만, 곧바로 ‘문제 답안 복사’ 의혹에 직면했다. AA에서 공개된 기존 문제에서는 거의 만점을 받았고, 문항을 재구성한 뒤에도 여전히 원래 답안을 제시했다는 것이다. 마오보스와 Binkg 등 평가자들은 이 모델의 신·구 문제 처리 능력 간 단절, 토큰 소모량 이상, 지식 테스트 시 환각 발생률이 무려 92.8%에 달한다는 점을 지적했다. 10월 23일 MiniMax는 모델 가중치를 오픈소스로 공개해 독립적인 검증을 가능하게 했으나, 문제 인식 메커니즘과 한·중·영 문장에 따른 응답 차이의 원인은 아직 명확히 밝혀지지 않았다.

추천 이유:해당 보도는 다수의 실측 결과(비잉크 제목 변경 실험, 필자 재현, AA와 플로틀리-밀라의 이중 평가 비교), 검증 가능한 데이터(토큰 수량, 가격, 정확도/환각률) 및 모델 행동의 모순점(영어는 오류·중국어는 정답, 구형 문제는 안정적·신형 문제는 붕괴)을 바탕으로 하며, 현재 대규모 언어모델 평가의 신뢰성 위기의 핵심 증상을 체계적으로 제시합니다: 높은 점수가 반드시 강력한 일반화 능력을 의미하는 것은 아니며, 저렴한 가격 우위와 실제 능력의 진정성 사이에 긴장이 존재합니다. 정보원은 티미디어가 공식적으로 배포한 심층 조사로, 원본 테스트 과정, 스크린샷 증거 및 타임스탬프를 포함하여 시의성과 세부 사항의 밀도 모두 우수합니다.

진행 상황 및 관련 보도

왼손에는 오픈소스 모델, 오른손에는 크리에이티브 에이전트를 갖춘 Hi3D의 AI 3D 후반전

저자|신시아 편집|정현 2026년의 AI 3D 분야는 미묘한 분수령에 서 있다. 1차 시장의 열기는 여전히 고조되고 있으며, 새로운 모델과 스타트업이 끊임없이 등장하고 있다. 단일 이미지로부터 3D를 생성하는 방식의 프론트엔드 렌더링 품질은 거의 현실과 구분하기 어려울 정도로 완성도를 갖추었다. 그러나 화려한 데모의 겉면을 벗겨 보면, 대부분의 생성 결과는 여전히 ‘회전대 전시’ 수준에 머물러 있다. 정교하게 제작된 캐릭터나 기계 모델이 조명 아래에서 천천히 회전하며, 비늘, 옷 주름, 금속의 음각까지 생생하게 표현된다. 하지만 이러한 세부 요소들이 게임 엔진의 애니메이션 설정, 산업 시뮬레이션, 그리고 3D 프린팅의 실제 생산 공정으로 넘어가면 곧바로 문제점이 드러난다. 구조적 파손, 뒷면 붕괴, 세부 부위의 접착, 메쉬의 편집 불가능 등 다양한 결함이 동시다발적으로 발생하며, 막대한 인력 보정 비용이 AI가 가져온 효율성 혜택을 모두 소진해 버린다. 이제는 프론트뷰의 사실성만으로 3D 품질을 판단할 수 없다는 것이 새로운 업계의 공감대가 되었다. AI 3D 경쟁은 ‘생성 가능 여부’를 두고 치열했던 전반기에서, 이제는 ‘실제 적용 가능성’을 놓고 치열한 후반기에 접어들었다. 바로 이 시점에서 선도 플레이어인 Hi3D가 두 가지 중요한 카드를 연달아 내놓았다. 생산 검증을 거친 Hi3D V1.0 기반을 공식 오픈소스로 공개하는 동시에, 크리에이터 중심의 Hi3D Agent를 출시했다. 이는 산업의 하부 구조와 연결되면서도, 실제 창작 워크플로우의 깊숙한 영역까지 심층적으로 통합하는 접근이다. 그에 앞서 설립된 지 3년도 채 되지 않은 이 회사는 이미 탄탄한 성과를 보여 왔다. 반년 만에 두 차례 연속으로 투자를 유치해 총액이 약 5,000만 달러에 달했으며, 샤오미의 레드시트 차이나, IDG 캐피탈, 메이퇀 롱주 등 굵직한 투자기관들이 대거 참여했다. 자사의 Hi3D 플랫폼은 120여 개 국가와 지역, 200만 명 이상의 크리에이터를 포괄하며, 투즈루 테크놀로지, xTool 등 주요 장비업체들과도 깊이 통합되어 있다. 희박 기하학 기술의 학문적 돌파부터 생산급 모델의 오픈소스 공개, 그리고 Agent 창작 시스템의 전주기적 통합에 이르기까지, Hi3D는 3D 생성의 후반기를 향한 진입권을 확보했다. 01 3D 생성, 과대평가된 데모와 과소평가된 생산 갭 단일 이미지로부터 3D를 생성하는 기술의 근본 논리는 태생적으로 시점 편향을 내포한다. ULIP, Uni3D 등의 지표가 거듭해서 경신되면서, 전면 위주로 전체보다는 일부를, 외관 위주로 내부 구조보다는 표면만을 중시하는 관행이 지난 몇 년간 이 분야의 공통된 모습이 되었다. 그러나 3D 자산의 본질은 회전 가능하고, 편집 및 가공이 가능한 입체 객체라는 점이다. 한 장의 캐릭터 이미지 속에는…

진행 상황 및 관련 보도

바이두, 수백 페이지 문서 파싱을 위한 무제한 OCR 2 오픈소스 출시

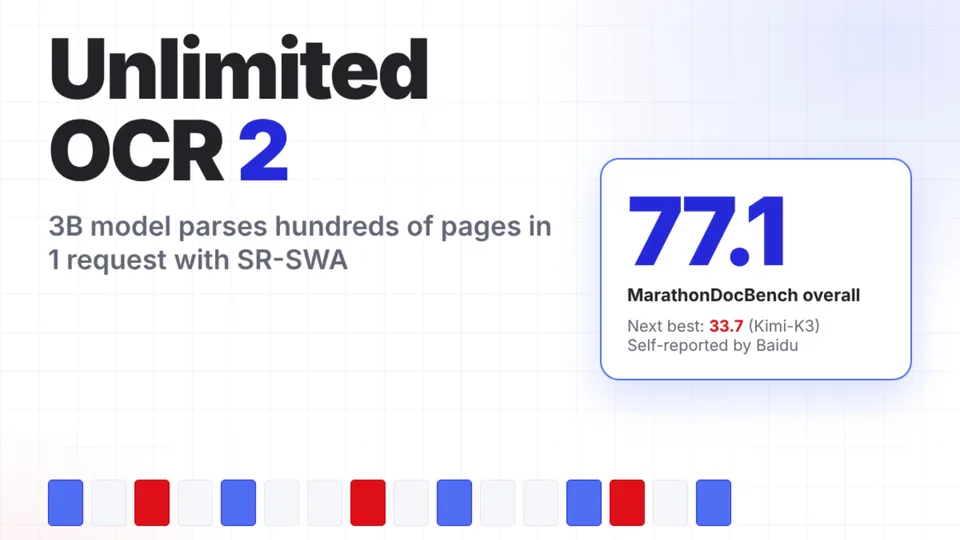
바이두는 MIT 라이선스를 적용한 3B 규모의 OCR 모델인 ‘Unlimited OCR 2’를 출시했으며, 이 모델은 한 번의 요청으로 수백 페이지에 달하는 문서를 처리할 수 있습니다. 해당 모델의 SR-SWA 주의 메커니즘은 단계별 디코딩 비용을 거의 일정하게 유지하며, MarathonDocBench에서 77.1점의 성능을 기록했습니다. 본 글은 ‘바이두, 수백 페이지 문서 파싱을 위한 Unlimited OCR 2 오픈소스화’라는 제목으로 MarkTechPost에 처음 게재되었습니다.

新闻源配图 · MarkTechPost
진행 상황 및 관련 보도

LLM 에이전트의 일관성을 위한 재귀적 의미 차이

arXiv:2610.33012v1 발표 유형: 신규 초록: 도구 사용 기능을 갖춘 대규모 언어 모델(LLM) 에이전트는 동일한 초기 상태에서 독립적인 실행 간에 일관되지 않은 행동을 보이며, 서로 다른 도구를 호출하거나 상충되는 출력을 생성하거나 서로 다른 전략을 추구합니다. 이러한 변동성은 시간이 지나면서 누적되어 배포의 신뢰성을 저해합니다. 기존 평가 지표들은 주로 완료 기반 점수를 통해 작업 정확도를 측정할 뿐, 여러 실행에 걸친 에이전트 행동의 일관성을 포착하지 못합니다. 또한, 에이전트의 행동은 확률 분포를 이용한 토큰 수준 또는 의미 클러스터링을 활용한 단일 응답 수준에서 각각 분석되지만, 어느 방법도 궤적의 향후 단계들로 일관성 부족이 어떻게 전파되는지를 파악하지 못합니다. 우리는 재귀적 의미 발산(RSD)이라는 비정식

진행 상황 및 관련 보도

통합 지상 및 비지상 6G 네트워크에서 의도 기반 서비스 오케스트레이션을 위한 지식 기반 LLM

arXiv:2610.33007v1 발표 유형: 신규 초록: 통합 지상망 및 비지상망(TN/NTN) 6G 네트워크에서의 자연어 기반 서비스 의도는 불완전하거나 모호하거나 일관성이 없을 수 있어, 신뢰할 수 있는 네트워크 기반 오케스트레이션을 위해 제한 없는 LLM 생성이 어려운 상황을 야기합니다. 본 논문에서는 문법 제약을 적용한 의미 분석과 지식 그래프(KG) 기반 명확화 루프를 결합한 지식 기반 LLM 프레임워크를 제안하며, 대표적인 네 가지 서비스 클래스에 걸쳐 검증된 오케스트레이션 준비 완료 상태의 서비스 프로파일을 생성합니다. 200개의 샘플로 구성된 의도 데이터셋에서, 이 프레임워크는 요청당 평균 0.66회의 명확화 단계를 거쳐 분류 정확도 89%와 정책 타당성 95%를 달성합니다. 순수 LLM 기반 베이스라인과 비교했을 때, 제안된 프레임워크는 정책 타당성을 향상시키고 co

진행 상황 및 관련 보도

Nemotron 3.5 Bolt 74B-A9B 24GB: 로컬 AI를 위한 하이브리드 비전-언어 모델

arXiv:2610.33039v1 발표 유형: 신규 초록: 우리는 로컬 에이전트 워크로드를 위한 메모리 사용량 당 속도와 지능을 최적화하는 하이브리드 Mamba-Transformer 비전-언어 모델인 Nemotron 3.5 Bolt 74B-A9B 24GB를 소개합니다. Nemotron 3.5 Super VL 120B-A12B 모델 계열에서 파생된 Nemotron 3.5 Bolt 74B-A9B 24GB는 스타 엘라스틱 압축과 2비트 퀀타이제이션 기반의 학습 후 양자화 기반 증류 기술을 결합하여 메모리 제약 환경에서도 효율적으로 배포할 수 있도록 설계되었습니다. 이 모델은 추론, 에이전트 기반 도구 활용, 그리고 웹 및 터미널 상호작용에 최적화되어 있습니다. 또한, 목표한 추론 속도를 달성하기 위해 모델과 함께 공개되는 LiLiCorr 사양형 드래프터를 별도로 교육했습니다. 그 결과 생성된 모델은 일반적인 에이전트 작업에 대한 여러 벤치마크에서 유사한 메모리 사용량과 속도를 가진 주요 경쟁 모델들보다 높은 정확도를 보여줍니다.

新闻源配图 · arXiv cs.CV
진행 상황 및 관련 보도

이득을 넘어선 것: 에이전트 스킬 퇴역을 위한 스킬 내재화 측정

arXiv:2610.32322v1 발표 유형: 신규 초록: LLM 에이전트는 약 10만 개의 항목을 보유하고 다수의 모델에 서비스를 제공하는 공공 허브에서 기술을 검색합니다. 모델이 발전함에 따라, 특정 모델이 내부적으로 학습하여 해당 기술을 필요로 하지 않게 되었음을 확인하고 그 모델에 대해 해당 기술을 폐기해야 하지만, 현재까지는 이러한 내부화 정도가 알려진 신뢰성으로 측정된 바 없습니다. 기존에 발표된 규칙들은 기술을 포함한 실행과 제외된 실행 간의 성능 차이만을 기준으로 기술 폐기를 판단합니다. 그러나 내부화된 기술의 경우에도, 그리고 모델과 기술 모두 해당 능력을 제공하지 못하는 상태(우리가 ‘미해결 상태’라고 부르는 경우)에서도 성능 향상은 거의 제로에 가깝습니다. 따라서 우리는 대신 해당 기술을 보류하고, 그 기술을 기반으로 새롭게 구성된 과제에서 모델의 성능을 평가하며, 다른 모델이 해당 기술로부터 이익을 얻는 경우에만 높은 비지원 점수를 신뢰합니다. 이는 높은 점수의 거의 절반이 아무런 기술도 없는 과제에서 나온다는 사실에 근거합니다.

진행 상황 및 관련 보도

용매: 다단계 역합성에 대한 장기적 추론

arXiv:2610.32308v1 발표 유형: 신규 초록: 다단계 역합성은 목표 분자를 연속적인 반응 단계를 거쳐 구매 가능한 빌딩 블록으로 재귀적으로 변환하는 과정을 요구하며, 최근 연구에서는 이 과제를 해결하기 위해 대규모 언어 모델(LLM)의 추론 기법을 활용하기 시작했습니다. LLM 추론 기법은 최근 발전 과정에서 장기적 지평 영역으로 진입했으며, 모델들은 상호 의존적인 여러 단계에 걸쳐 목표를 달성하고 환경과 상호작용하며 피드백에 적응합니다. 이러한 변화는 AI 기반 수학 연구에서의 획기적인 성과들로도 잘 드러나며, LLM의 능력을 크게 향상시켰습니다. 이러한 최첨단 분야에서 우리는 8B 규모의 LLM인 Solvent를 소개합니다. Solvent는 다단계 역합성 문제에 대한 장기적 추론을 성공적으로 확장한 모델입니다. 두 차례에 걸친 사후 학습 커리큘럼을 통해 Solvent는 반복적인 작업을 병렬로 수행하는 방법을 학습합니다.

진행 상황 및 관련 보도

DMAIC-벤치: 다단계 분석 작업에서 에이전트의 자기성찰에서 자기절제까지

arXiv:2610.32305v1 발표 유형: 신규 초록: 다단계 분석 작업에서는 LLM 에이전트가 다음 단계를 계속할지, 경로를 변경할지, 또는 중단할지를 결정하기 위해 중간 증거를 활용해야 합니다. 에이전트가 자신의 출력을 비판하는 자기반성은 널리 연구되어 왔지만, 이러한 비판만으로는 증거가 다음 행동에 영향을 미쳤는지 여부를 확인할 수 없습니다. 우리는 이러한 능력을 ‘자기억제’라고 부릅니다. 기존의 에이전트 벤치마크는 대부분 과제 완료 여부나 출력 품질을 측정할 뿐, 이 능력은 검증되지 않은 상태입니다. DMAIC-Bench는 린 식스 시그마의 명시적인 통계적 전제 조건을 기반으로 하여, 4개 산업 분야의 15개 산업 사례에 걸쳐 97개의 초기 설정된 과제를 통해 이를 평가합니다. 쌍으로 구성된 역설적 변형 과제들은 동일한 워크플로우 위치에서 서로 반대되는 행동을 요구함으로써, 정당화된 억제와 무분별한 중단을 구분합니다. 우리는 실행 추적 정보를 통해

진행 상황 및 관련 보도

역사 문서 전사용 OCR 시스템의 엔터티 인식 기반 평가

arXiv:2610.33004v1 발표 유형: 신규 초록: 광학 문자 인식(OCR)은 역사 기록 보관소의 디지털화에 필수적이지만, 문자 오류율(CER)과 같은 표준 평가 지표만으로는 이름, 날짜, 식별자 등 의미 있는 정보가 제대로 유지되는지를 반드시 반영하지 못합니다. 본 연구에서는 역사 문서에서의 OCR 품질을 평가하는 데 있어 보완적인 관점으로서, OCR 오류를 엔터티 수준에서 분석합니다. 공개된 벤치마크 데이터셋인 Berrutti 아카이브의 175개 문서와, 게재 승인 시 공개될 수동으로 주석된 5,209개의 엔터티 언급을 추가하여, 시퀀스 인식 기반 OCR 시스템, OCR 전용 비전-언어 모델, 그리고 범용 비전-언어 모델을 비교합니다. 전역적 전사 정확도 외에도

진행 상황 및 관련 보도

접두사 키와 값의 중요성 늦게 부각: 루프형 언어 모델에서 자기-추론적 디코딩을 위한 RIPE 캐싱

arXiv:2610.34436v1 발표 유형: 신규 초록: 루프형 언어 모델은 토큰당 레이어 블록을 $R$번 실행하므로, 해당 모델의 키-값(KV) 캐시에는 각 반복 레이어마다 $R$개의 평면이 저장된다. 또한 자기-사려 깊은 디코딩(몇 개의 루프로 초안을 생성하고 $R$개 전체로 검증하는 방식)에서는 이 모든 평면을 읽는다. 우리는 접두사 키와 값이 후반부에서 특히 중요하다는 점을 발견했다. 동일한 섭동 크기에서도, 루프 25~32는 루프 2~9에 비해 각각 $e^{15.0}$(Huginn-0125) 및 $e^{12.8}$(Raven-Llama) 배 더 민감하며, 각 루프마다 평면들은 기하급수적으로 마지막 평면에 접근하여, 각각 0.88과 0.81에 도달한다. 이때 가장 깊은 평면 하나만으로 충분한지 여부는 후반부 평면들이 얼마나 성숙했는지에 따라 달라진다. Raven에서는 이를 저장하는 것만으로도 bf16에서 fp32로 변경한 경우와 구별할 수 없으며, Huginn에서는 위치의 1%가 전체 오차의 74%를 차지한다. 우리는 이를 RIPE로 발전시켰으며, RIPE는 가장 깊은

진행 상황 및 관련 보도

OpenAI, GPT-6.1 Terra를 출시하며 에이전트 작업에 대한 GPT-6.1 Sol의 API 가격을 절반으로 인하

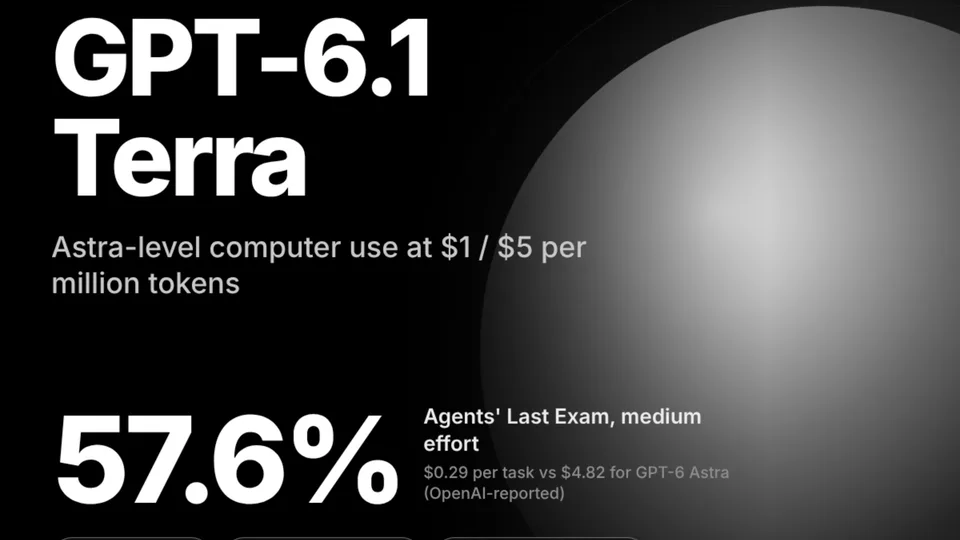
OpenAI는 GPT-6.1 Terra를 출시했으며, 이 모델은 매 백만 토큰당 1달러/5달러의 가격으로 제공되는 고속 컴퓨터 사용 및 비전 모델입니다. 이 모델은 GPT-6 Astra의 중간 수준 노력 기반 에이전트들의 최종 시험 점수를 달성하며, 작업당 비용은 0.29달러로, 기존의 4.82달러에 비해 크게 낮아졌습니다. 해당 게시물인 “OpenAI, GPT-6.1 Terra 출시… 에이전트 작업 시 GPT-6.1 Sol의 API 가격 절반”은 MarkTechPost에 처음 게재되었습니다.

新闻源配图 · MarkTechPost
진행 상황 및 관련 보도