
Granola 推出语音听写功能,与 Wispr 展开竞争
反其道而行之!在 Wispr 将会议记录功能加入其语音听写应用后,Granola 也为其会议记录工具增添了语音听写功能。语音 AI 领域的战火愈发激烈。

检索标题、摘要与正文,把分散的信息连起来。
反其道而行之!在 Wispr 将会议记录功能加入其语音听写应用后,Granola 也为其会议记录工具增添了语音听写功能。语音 AI 领域的战火愈发激烈。
有很多视觉素材可供使用和学习。
Edge Sound Research Inc. 今日宣布已筹集200万美元新融资,用于构建一种音频基础设施,该设施能够分离出有用的声音,并将其与其他传感器数据相结合,以帮助物理人工智能系统实时理解当前发生的情况。本轮融资由 Stormbreaker Ventures 领投,使公司累计融资额达到900万美元。当…… 该文章“Edge Sound 融资200万美元,助力物理人工智能理解音频”首发于 SiliconANGLE。
扩展 AI 智能体的规模,需要将其视作受监管岗位上的员工,制定书面规则、明确职责,并指定一名负责人对其绩效负责。特邀作者、Get Covered 公司首席运营官里克·福尔格曼建议企业:应从由既定规则规范的任务入手,在不同工作流的风险水平下调整其自主权,并在扩大智能体权限之前定期评估成效。
arXiv:2610.33036v1 发布类型:新 摘要:口语风格字幕(SSC)旨在生成自然语言描述,用于刻画语音的表达方式,捕捉诸如声音音色、韵律和表现力等副语言特征。许多下游应用,包括对话式 AI 智能体、可控语音生成以及大规模音频标注,都需要针对特定维度的风格字幕,以描述语音的特定方面(例如说话者特质、情感或表达风格),而非单一的无差别描述。然而,现有研究缺乏对可控口语风格字幕的统一建模方法。我们通过将 SSC 定义为一项遵循指令的音频-语言任务来弥补这一不足,在该任务中,明确的指令会指定口语风格的维
在大规模发布数百篇据称包含长期悬而未决的数学问题解决方案的论文后不到一个月,OpenAI 再次推出了三项“重大”发现,涉及数学、计算机科学和物理学领域。与以往不同的是,此次 OpenAI 选择由其称之为“牧者”的外部专家来指导相关成果的产出……

在准备上市之际,Anthropic提交的S-1文件使生成式AI对甲烷的依赖暴露无遗。“在获取电力供应以及具备充足电力保障的数据中心选址方面,竞争十分激烈。”在周一提交给美国证券交易委员会的文件中,Anthropic承认,数据中心正日益依赖“天然气”[…]

过去三年,企业人工智能领域的讨论主要聚焦于模型能够说出什么;而未来三年,焦点将转向系统被允许做什么。这是一项更为棘手的问题,单靠更强大的模型难以解决。10月28日星期三,我将赴波士顿参加彭博科技峰会:“构建……” 本文《当企业从AI实验迈向自主运营时,值得关注的事项》首发于SiliconANGLE。
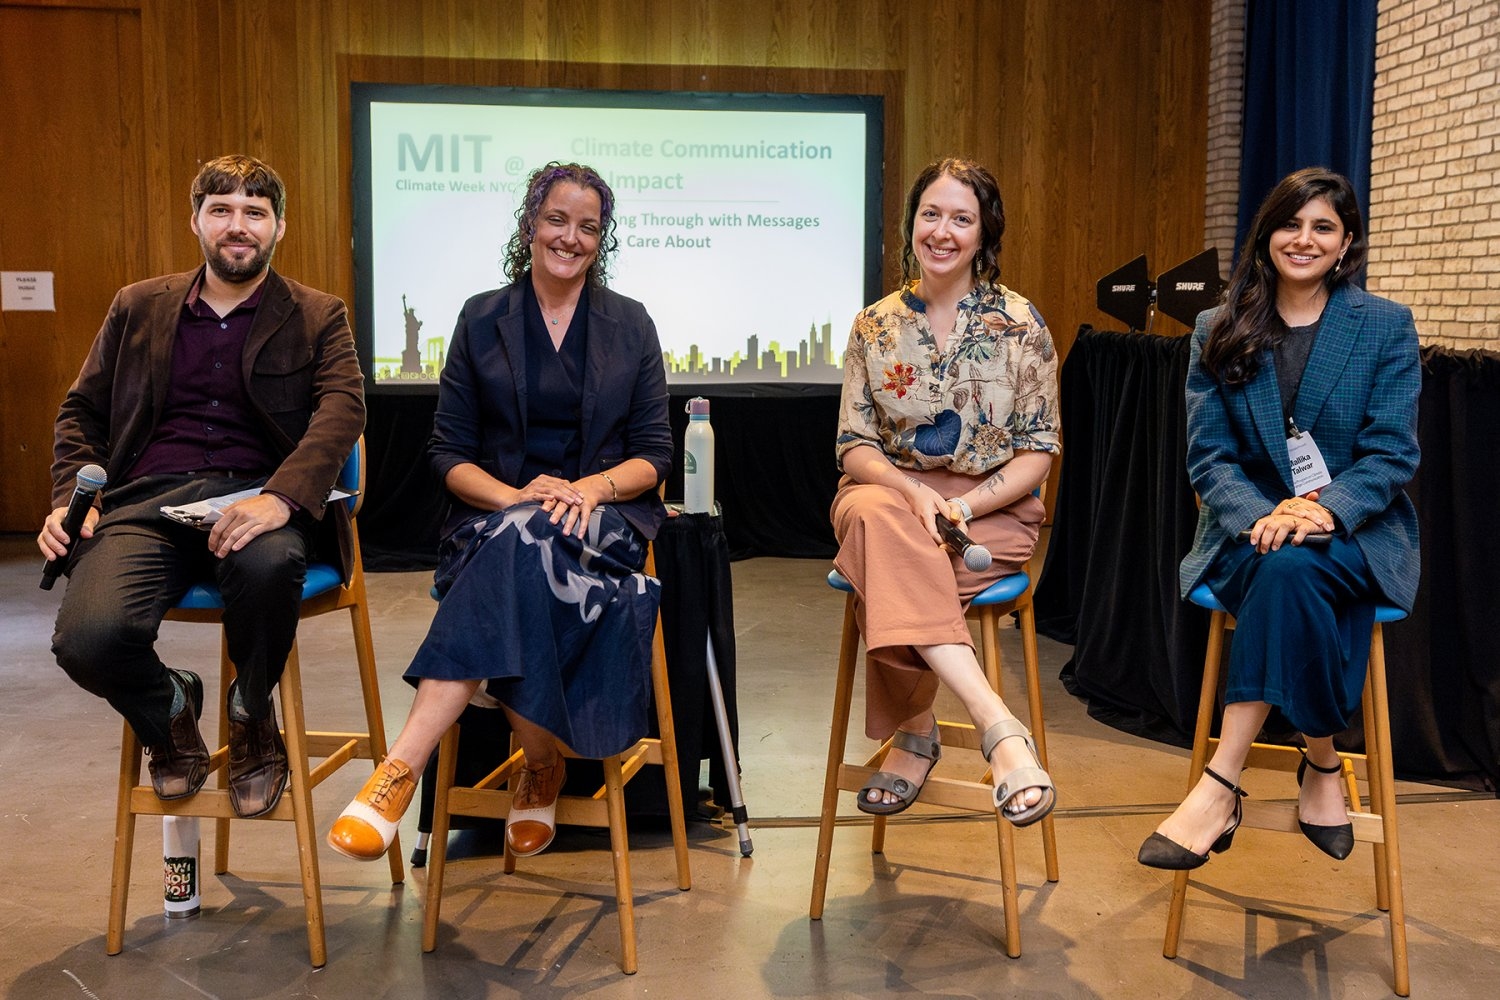
麻省理工学院社区的各界代表齐聚一堂,就数据中心、超级污染物、农业与教育等议题展开了讨论。
二手奢侈品寄售零售商 The RealReal 表示,它正在升级其机器人防护系统,从而有效增加 AI 智能体在其网站上购物的难度。这一变化是在《The Verge》报道称一名 AI 智能体可能被用于利用 The RealReal 的商品预留系统之后几天推出的。在该零售商的官网上,[…]

Anthropic终于向美国证券交易委员会提交了S-1招股说明书,这份文件旨在让投资者深入了解其业务的方方面面,从高管薪酬、IPO募资的使用计划,到可能阻碍其实现雄心的风险等。这份长达300多页的文件内容十分丰富……

Anthropic认为,“闭环”是实现人工智能成功的最佳路径,同时也可能给人类带来“生存性”威胁。
微软正向美国、英国、加拿大和印度的多达6万名员工提供自愿离职补偿计划。在致全体员工的一封信中,微软首席人事官艾米·科尔曼写道,此举将为员工“提供在获得经济支持与职业规划资源的情况下离开微软的机会”,因为公司正寻求在不进行另一次[…]的情况下缩减员工规模。

今天,我采访了记者兼新书《AGI编年史》的作者凯文·鲁斯。这本书详细记录了人工智能行业近期发生的剧烈变革。凯文曾长期担任《纽约时报》记者,并主持过热门播客节目“Hard Fork”,但他与节目好友凯西·牛顿刚刚离开了[…]


Anthropic已向美国证券交易委员会提交了S-1招股说明书,为旗下Claude的母公司做好准备,力争在首次公开募股方面抢先于OpenAI。在提交给SEC的文件中,Anthropic表示计划在纳斯达克交易所上市,股票代码为“ANT”。这家人工智能公司已秘密向SEC提交了[…]

Coyotec 既会说双语,又爱骂人,还教听众如何防范美国移民及海关执法局(ICE)。它的走红正值越来越多的广播机构开始尝试打造人工智能虚拟人格之际。
arXiv:2610.31734v1 发布类型:新 基本摘要:一场电子竞技的实时直播需要一位导演来决定哪路摄像机画面该播出,以及一位解说员在每一秒都对这一选择进行解说,而他们往往无法预知接下来会发生什么。流媒体视频语言模型已经学会了进行赛事解说,但仅限于由人类导演事先制作好的直播内容。我们研究的是实时直播制作场景:模型仅接收所有选手的原始摄像头画面,必须完全依靠过往信息同时完成导播与解说任务。我们提出了 DirCast,一种能够同时胜任这两项工作的单一流媒体视频语言模型。它每秒以低分辨率扫描所有摄像头,通过“保留”或“切换”的决策机制判断是否以及何时切镜,并在发言前以高分辨率读取所选画面。其上下文会记录哪些内容已播出,以及哪些…

arXiv:2610.32107v1 发布类型:新 摘要:参与对话不仅涉及决定该说些什么,还涉及是否应该开口。在诸如狼人杀这样的环境中,由于参与者利益相冲突,这种判断显得尤为重要,因为无论是发言还是沉默,都会受到他人的解读与评判。因此,对于一个参与狼人杀游戏的 LLM 智能体而言,何时发言以及说什么至关重要。在本研究中,我们介绍了一款专为 AIWolfDial 共享任务中的“随时发言赛道”开发的狼人杀 AI 智能体。我们的系统基于现有的 Inner Thoughts 框架,通过生成内部思考并评估每种想法的价值,来决定对话中的发言时机。
arXiv:2610.32022v1 发布类型:新 摘要:在人机交互中,意图识别要求智能体通过推断说话者的潜在目标来化解含糊不清的自然语言指令。近年来,研究日益聚焦于两种颇具代表性的范式来应对这一任务:结构化符号推理与多模态输入增强。然而,在那些歧义源于未明示的人类意图而非缺失可观测场景信息的情形下,基于增强的方法是否确实具有优势,仍不明确。本文开展了一项对比与诊断性研究,将采用结构化社会与具身推理的FISER框架与CEMIR(上下文增强型多模态意图识别)方法进行基准测试——后者是一种实施多模态增强的技术。
arXiv:2610.32042v1 发布类型:新 提要:跨语言配音旨在将源语言语音转换为目标语言语音,并使其与原视频保持同步。这一任务的关键在于生成忠实且在源语言时序框架内自然可说的译文,而这并不容易,因为不同语言在音长、节奏和发音方式上存在差异。本文提出了一种名为 X-Dubbing 的方法,将该任务建模为一种同时考虑时间约束的语音转文本翻译与视频感知的文本转语音问题。具体而言,我们的方法由一个能够生成具有时间结构脚本的配音翻译器,以及一个能将其与源视频同步呈现的配音演员组成,二者均以一种与语言无关的时间预算为基础。此外,我们还通过 dubbing 对翻译器进行了进一步优化。