
자동 워크로드 복구로 분산 학습 지속
분산 AI 학습이 확장됨에 따라 하드웨어 및 소프트웨어 의존성에서 발생하는 장애가 학습 진행을 점점 더 방해하게 되며, 이로 인해 빠르고 안정적인 복구가...
제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.
분산 AI 학습이 확장됨에 따라 하드웨어 및 소프트웨어 의존성에서 발생하는 장애가 학습 진행을 점점 더 방해하게 되며, 이로 인해 빠르고 안정적인 복구가...
오늘 우리는 하드웨어 가속기용 Ray 특별 관심 그룹(SIG)을 발표합니다. 10여 년 전 UC 버클리에서 Ray가 탄생했을 당시, 컴퓨팅 환경은 매우... 글 '하드웨어 가속기용 Ray 특별 관심 그룹(SIG) 발표'는 PyTorch에 처음 게시되었습니다.

텐센트 테크 기업펭귄 지능연구소 산하 AI 분야 주간 관찰: 매주 한 차례, 정보 통합보다 한 단계 더 깊이 있게 글|보양 편집|쉬칭양 I. 산업 01. AI 결산 시즌에 매도세가 발생하고, 인프라 확장은 의문을 받고 있다 ....

Mirendil은 1,000만 토큰의 컨텍스트 창을 갖춘 처음으로 개발한 모델인 Fern 0.1을 출시했습니다. 이 모델은 에이전트형 AI 연구개발 작업을 목표로 하며, 1,000만 토큰 기준 RULER 단일 바늘 테스트에서 100% 점수를 기록했지만, 에이전트형 코딩에서는 최첨단 모델들에 비해 뒤처집니다. 해당 게시물 “Mirendil, 1,000만 토큰 컨텍스트를 갖춘 첫 번째 모델 Fern 0.1 출시”는 MarkTechPost에 처음 게재되었습니다.
## 변경된 내용 * model_prefetch: https://github.com/Comfy-Org/ComfyUI/pull/17178에서 @rattus128이 모든 그래프 정리 작업을 동기화했습니다 * https://github.com/Comfy-Org/ComfyUI/pull/17172에서 @kijai가 MOSS-image에 로프 스케일링 지원 기능을 추가했습니다 * [파트너 노드] https://github.com/Comfy-Org/ComfyUI/pull/16943에서 @dante01yoon이 API 노드의 파트너 노드 로그인 토큰을 갱신했습니다 * [파트너 노드] feat(HeyGen): https://github.com/Comfy-Org/ComfyUI/pull/17043에서 @bigcat88이 HeyGen Voice 즉석 클론 및 텍스트 음성 변환 기능을 추가했습니다 * [파트너 노드] feat(ClarityAI): https://github.com/Comfy-Org/ComfyUI/pull/17192에서 @bigcat88이 Crystal Video Upscaler 노드를 추가했습니다 * [파트너 노드] feat(BFL): https://github.com/Comfy-Org/ComfyUI/pull/17200에서 @bigcat88이 FLUX 3 비디오 노드에 2K/4K 해상도 옵션을 추가했습니다 * MOSS-image 지원
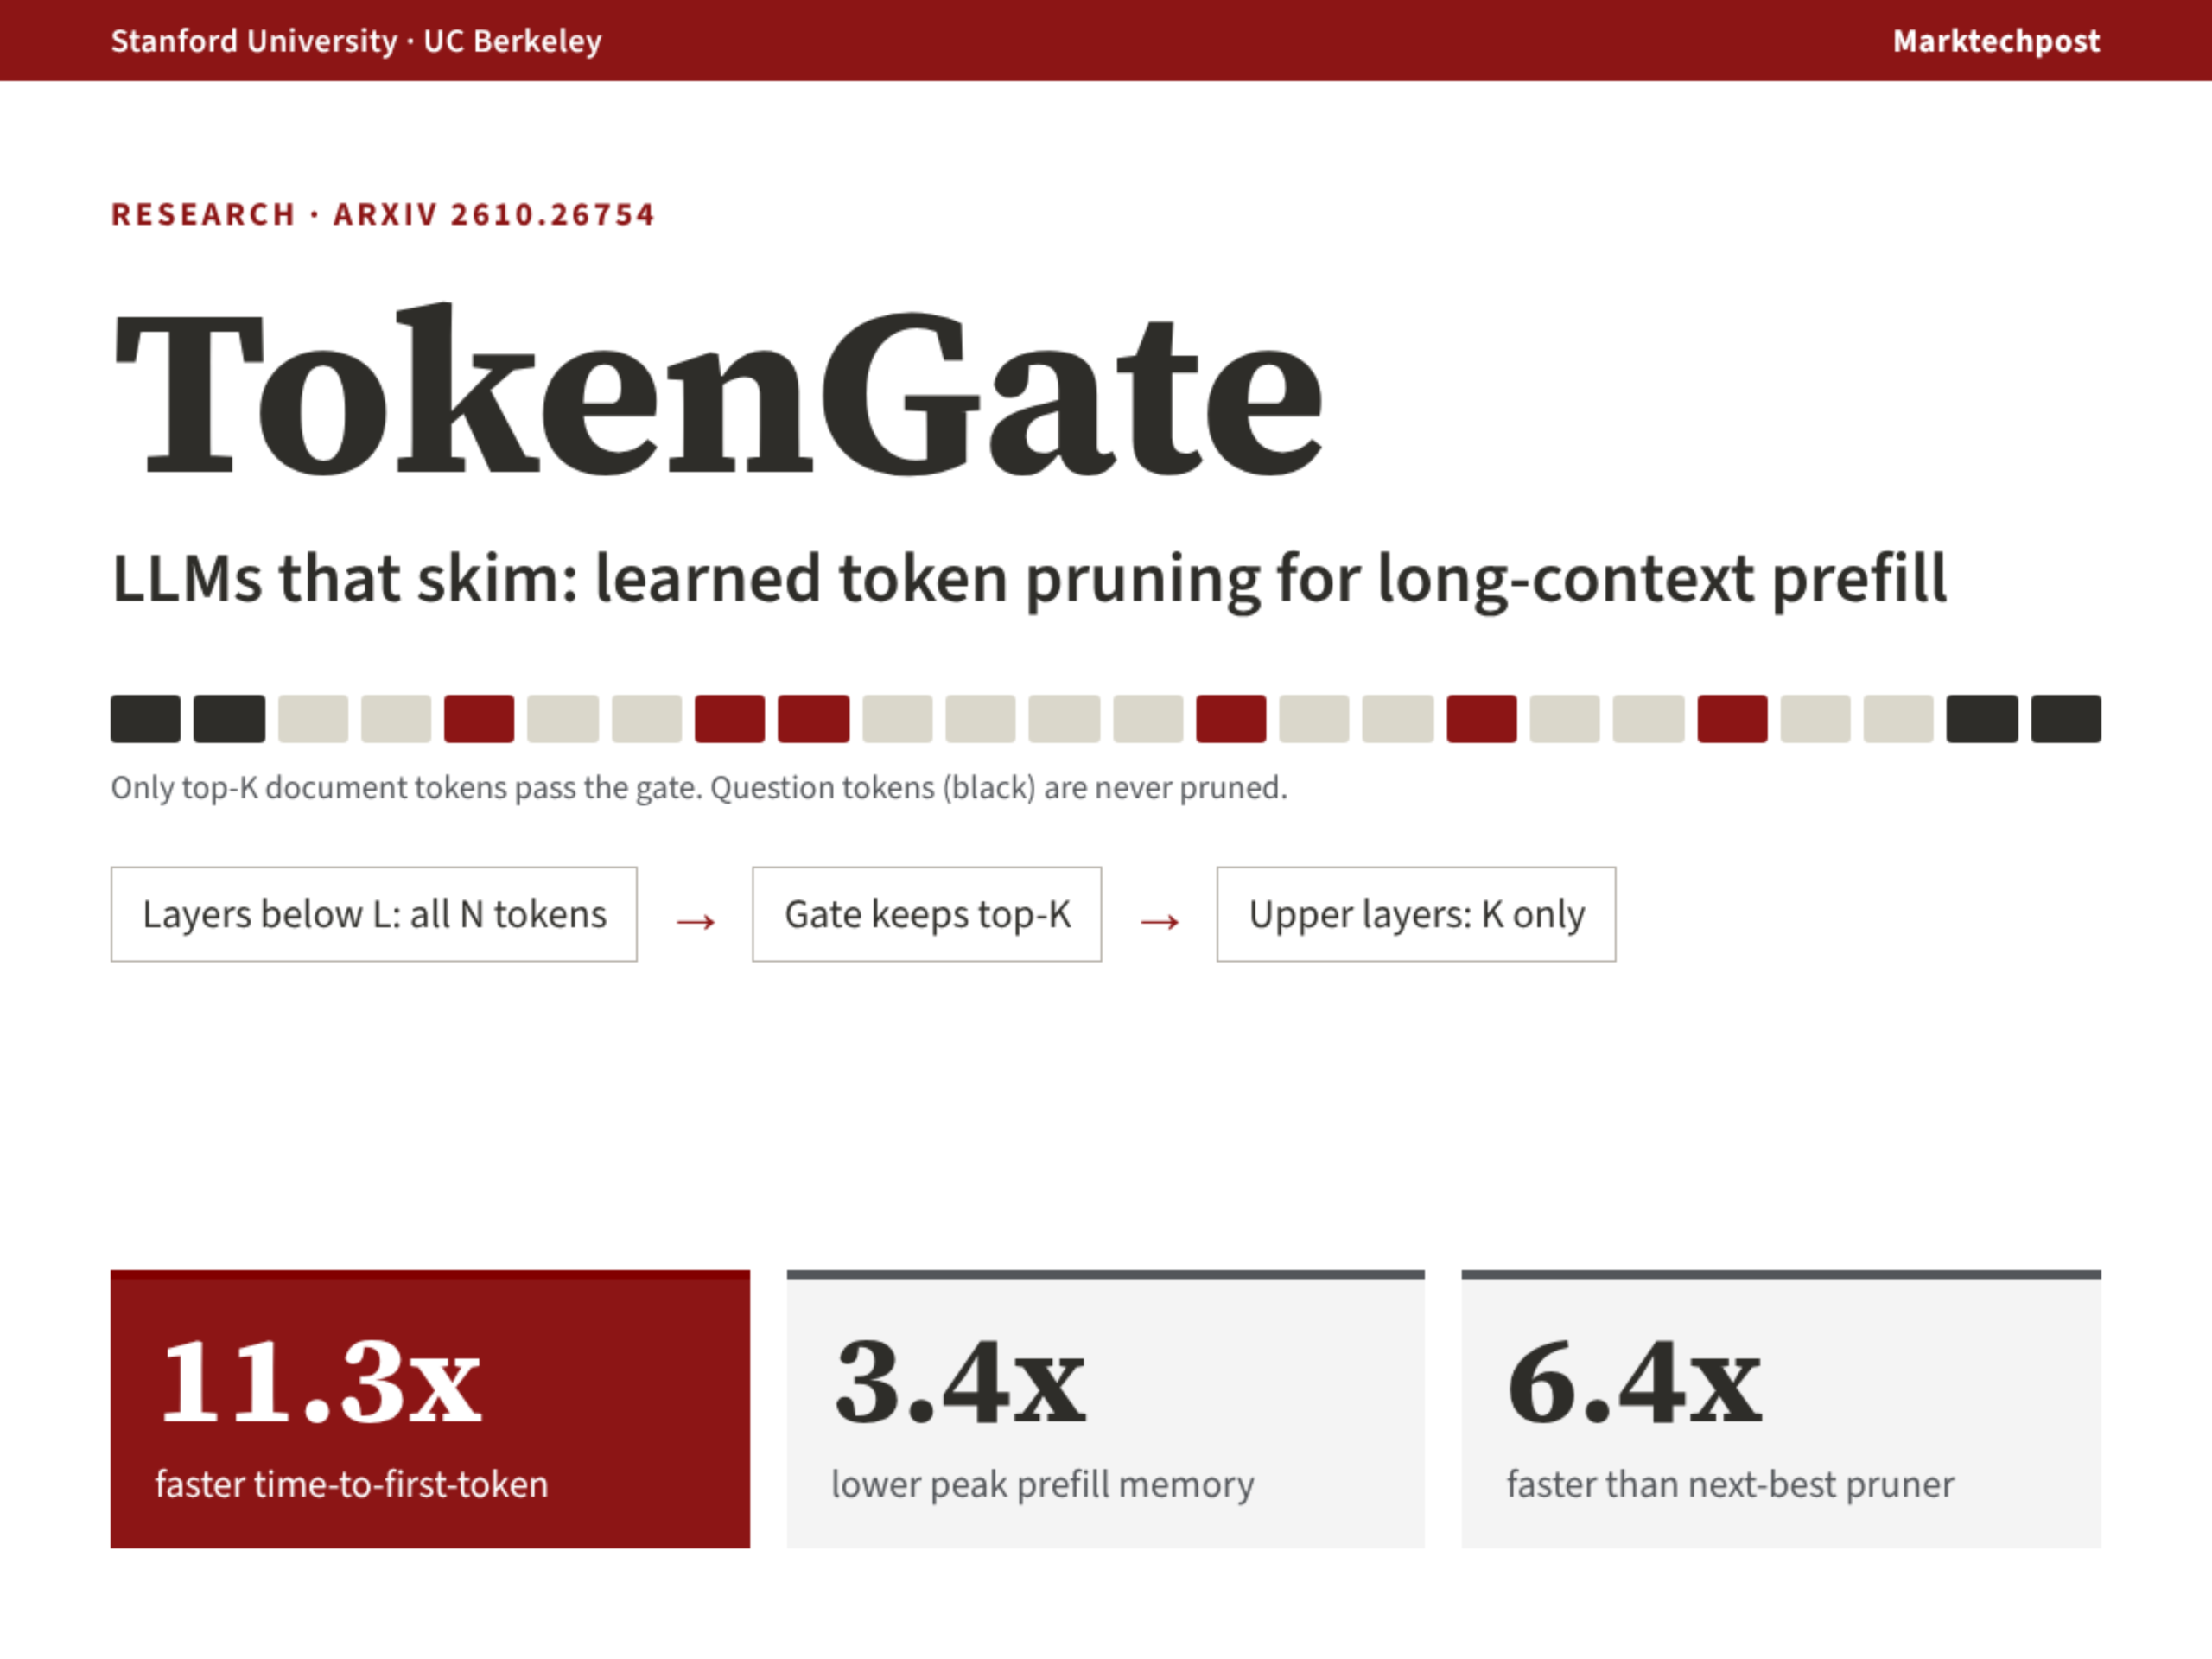
스탠퍼드 대학교와 캘리포니아 대학교 버클리 캠퍼스의 연구진은 기존 대규모 언어 모델(LLM)에 적용 가능한 플러그 앤 플레이 방식의 학습형 토큰 가위 모듈인 TokenGate를 제안했습니다. 이 방법은 정확도를 유지하면서, 긴 컨텍스트를 사전 채워 넣는 첫 글자 생성 시간(TTFT)을 1.4배에서 최대 11.3배까지 가속화하고, 최대 메모리 사용량을 1.5배에서 최대 3.4배까지 절감합니다. 관련 코드와 체크포인트는 오픈소스로 공개되었습니다.
세바스티안 라슈카는 2026년 10월 24일, Ahead of AI 매거진(magazine.sebastianraschka.com)에서 총 8강으로 구성된 11시간이 넘는 파이썬 및 파이토치 실습 동영상 강좌를 공개했으며, 추론 모델의 평가, 추론 시 확장, 강화학습(RLVR)과 지식 증류를 체계적으로 다루고, 모든 방법을 사전 훈련된 Qwen3-0.6B 모델을 기반으로 구현했습니다.
추천 이유:이 강좌는 저자가 ‘0부터 구축하는 대규모 언어 모델’에 이어 선보이는 심화 기술 교육 콘텐츠로, 현재 주류 LLM의 핵심 발전 방향인 추론 능력 강화에 초점을 맞추고 있습니다. 기초 환경 구축부터 GRPO 강화학습, 자기 증류 등까지 포괄하는 완전한 기술 체인을 다루며, 모든 구현은 ‘0부터 수작업으로 작성’되어 재현 가능하다는 점을 명시하고 있어 높은 교육적 가치와 엔지니어링 참고 가치를 갖습니다.
AWS는 SageMaker에서 호스팅되는 Kokoro-82M 텍스트 음성 변환 모델을 활용한 기술 솔루션을 발표했으며, 양방향 WebSocket을 통해 AI 에이전트가 텍스트를 생성하는 동시에 음성을 합성함으로써 엔드투엔드 음성 응답 지연 시간을 크게 단축했습니다. 이 솔루션은 Base64-SSE와 통합 바이너리 전송이라는 두 가지 오디오 피드백 방식을 제공하며, ‘가치 검증형’(proof-of-value)으로 명시되어 아직 생산 준비 상태에 이르지 않았습니다.
이 글은 Hugging Face와 Amazon이 공동으로 발표한 기술 블로그 시리즈의 첫 번째 편으로, AWS Trainium AI 가속 칩에서 TorchNeuron을 활용한 PyTorch 모델 추론 성능 분석 방법을 체계적으로 소개합니다. 여기에는 Neuron 백엔드 통합 원리, torch.profiler 구성 방법, NeuronConfig 및 NeuronProfiler 도구의 사용법, Neuron Explorer를 이용한 시각적 추적 등이 포함되며, RMSNorm을 사례로 삼아 세 가지 구현 방식(순수 PyTorch, torch.rms_norm 내장형 병합, torch.compile 자동 병합) 간의 장치별 처리 시간 차이를 비교합니다.
i14는 30.28억 개의 파라미터를 갖는 Laplace 3B 모델을 출시했으며, Softmax 주의 메커니즘을 대체해 게이트 제어 선형 주의(GLA)를 채택했습니다. 이 모델은 추론 시 각 시퀀스의 재귀 상태 크기가 항상 29.5 MB로, 컨텍스트 길이와 무관합니다. 해당 모델은 AWS trn2.48xlarge 인스턴스 한 대(Trainium2 칩 16개 탑재)에서 훈련 및 서비스 검증을 완료했으며, 훈련 처리량은 초당 12만 토큰에 달하고, 서비스 처리량은 초당 11,544 출력 토큰(동시 실행 시퀀스 수 1,280)입니다. 모든 성능 데이터는 i14와 AWS GenAIIC 팀의 내부 실측 결과입니다.
Hugging Face는 TorchTPU를 발표하여 PyTorch에 원래의 TPU 백엔드 지원을 제공함으로써, Transformers, Diffusers 등과 같은 라이브러리들이 torch_xla에 의존하거나 JAX로 이전할 필요 없이 바로 TPU에서 실행될 수 있도록 했습니다.
PyTorch 2.15는 Apple Silicon 맥을 위한 주요 MPS 백엔드 업그레이드를 제공하며, macOS에서 처음으로 FP8 텐서 연산을 네이티브로 지원합니다. 또한 MoE 모델의 디코딩 속도가 5~6.5배 향상되고, 비디오 VAE 디코딩 시 최대 GPU 메모리 사용량이 270 GiB에서 8 GiB로 감소하며, 다수의 연산자들이 MPSGraph에서 전용 Metal 커널로 이전되었습니다.
Hugging Face와 AWS가 공동으로 TorchNeuron을 출시했습니다—PyTorch용 원생형 Trainium 백엔드로, 2026년 10월 20일부터 공개 베타 테스트를 시작합니다. 이 기술을 통해 Transformers, Diffusers 등 주요 라이브러리들이 수정 없이 바로 Trainium 칩에서 실행될 수 있게 되어, 텍스트 생성 및 이미지 생성 모델의 사용 편의성과 호환성을 크게 향상시킵니다.
PyTorch (Part 3)에서 직업 : 관심은 모든 프로필입니다
PyTorch에서 직업 (2 부) : nn에서. 융합된 MLP에 선형
PyTorch (Part 1)에서 직업 : 토치에 초보자 가이드. 이름 *