
早报|15999起,苹果发布M6 MacBook Pro/张一鸣以6700亿元登顶胡润百富榜/电视新规:不得播放开机广告
· IDC:中国手机 Q3 出货下滑 15.2%,折叠屏连续四季度下降 · 邓煜:AI 公司应公开证明思路,让用户决定数据是否用于训练 · 研究:豆包引用抖音的权重升至 31.8%#欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。
检索标题、摘要与正文,把分散的信息连起来。
· IDC:中国手机 Q3 出货下滑 15.2%,折叠屏连续四季度下降 · 邓煜:AI 公司应公开证明思路,让用户决定数据是否用于训练 · 研究:豆包引用抖音的权重升至 31.8%#欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。
对机器而言,“夜晚”是什么?
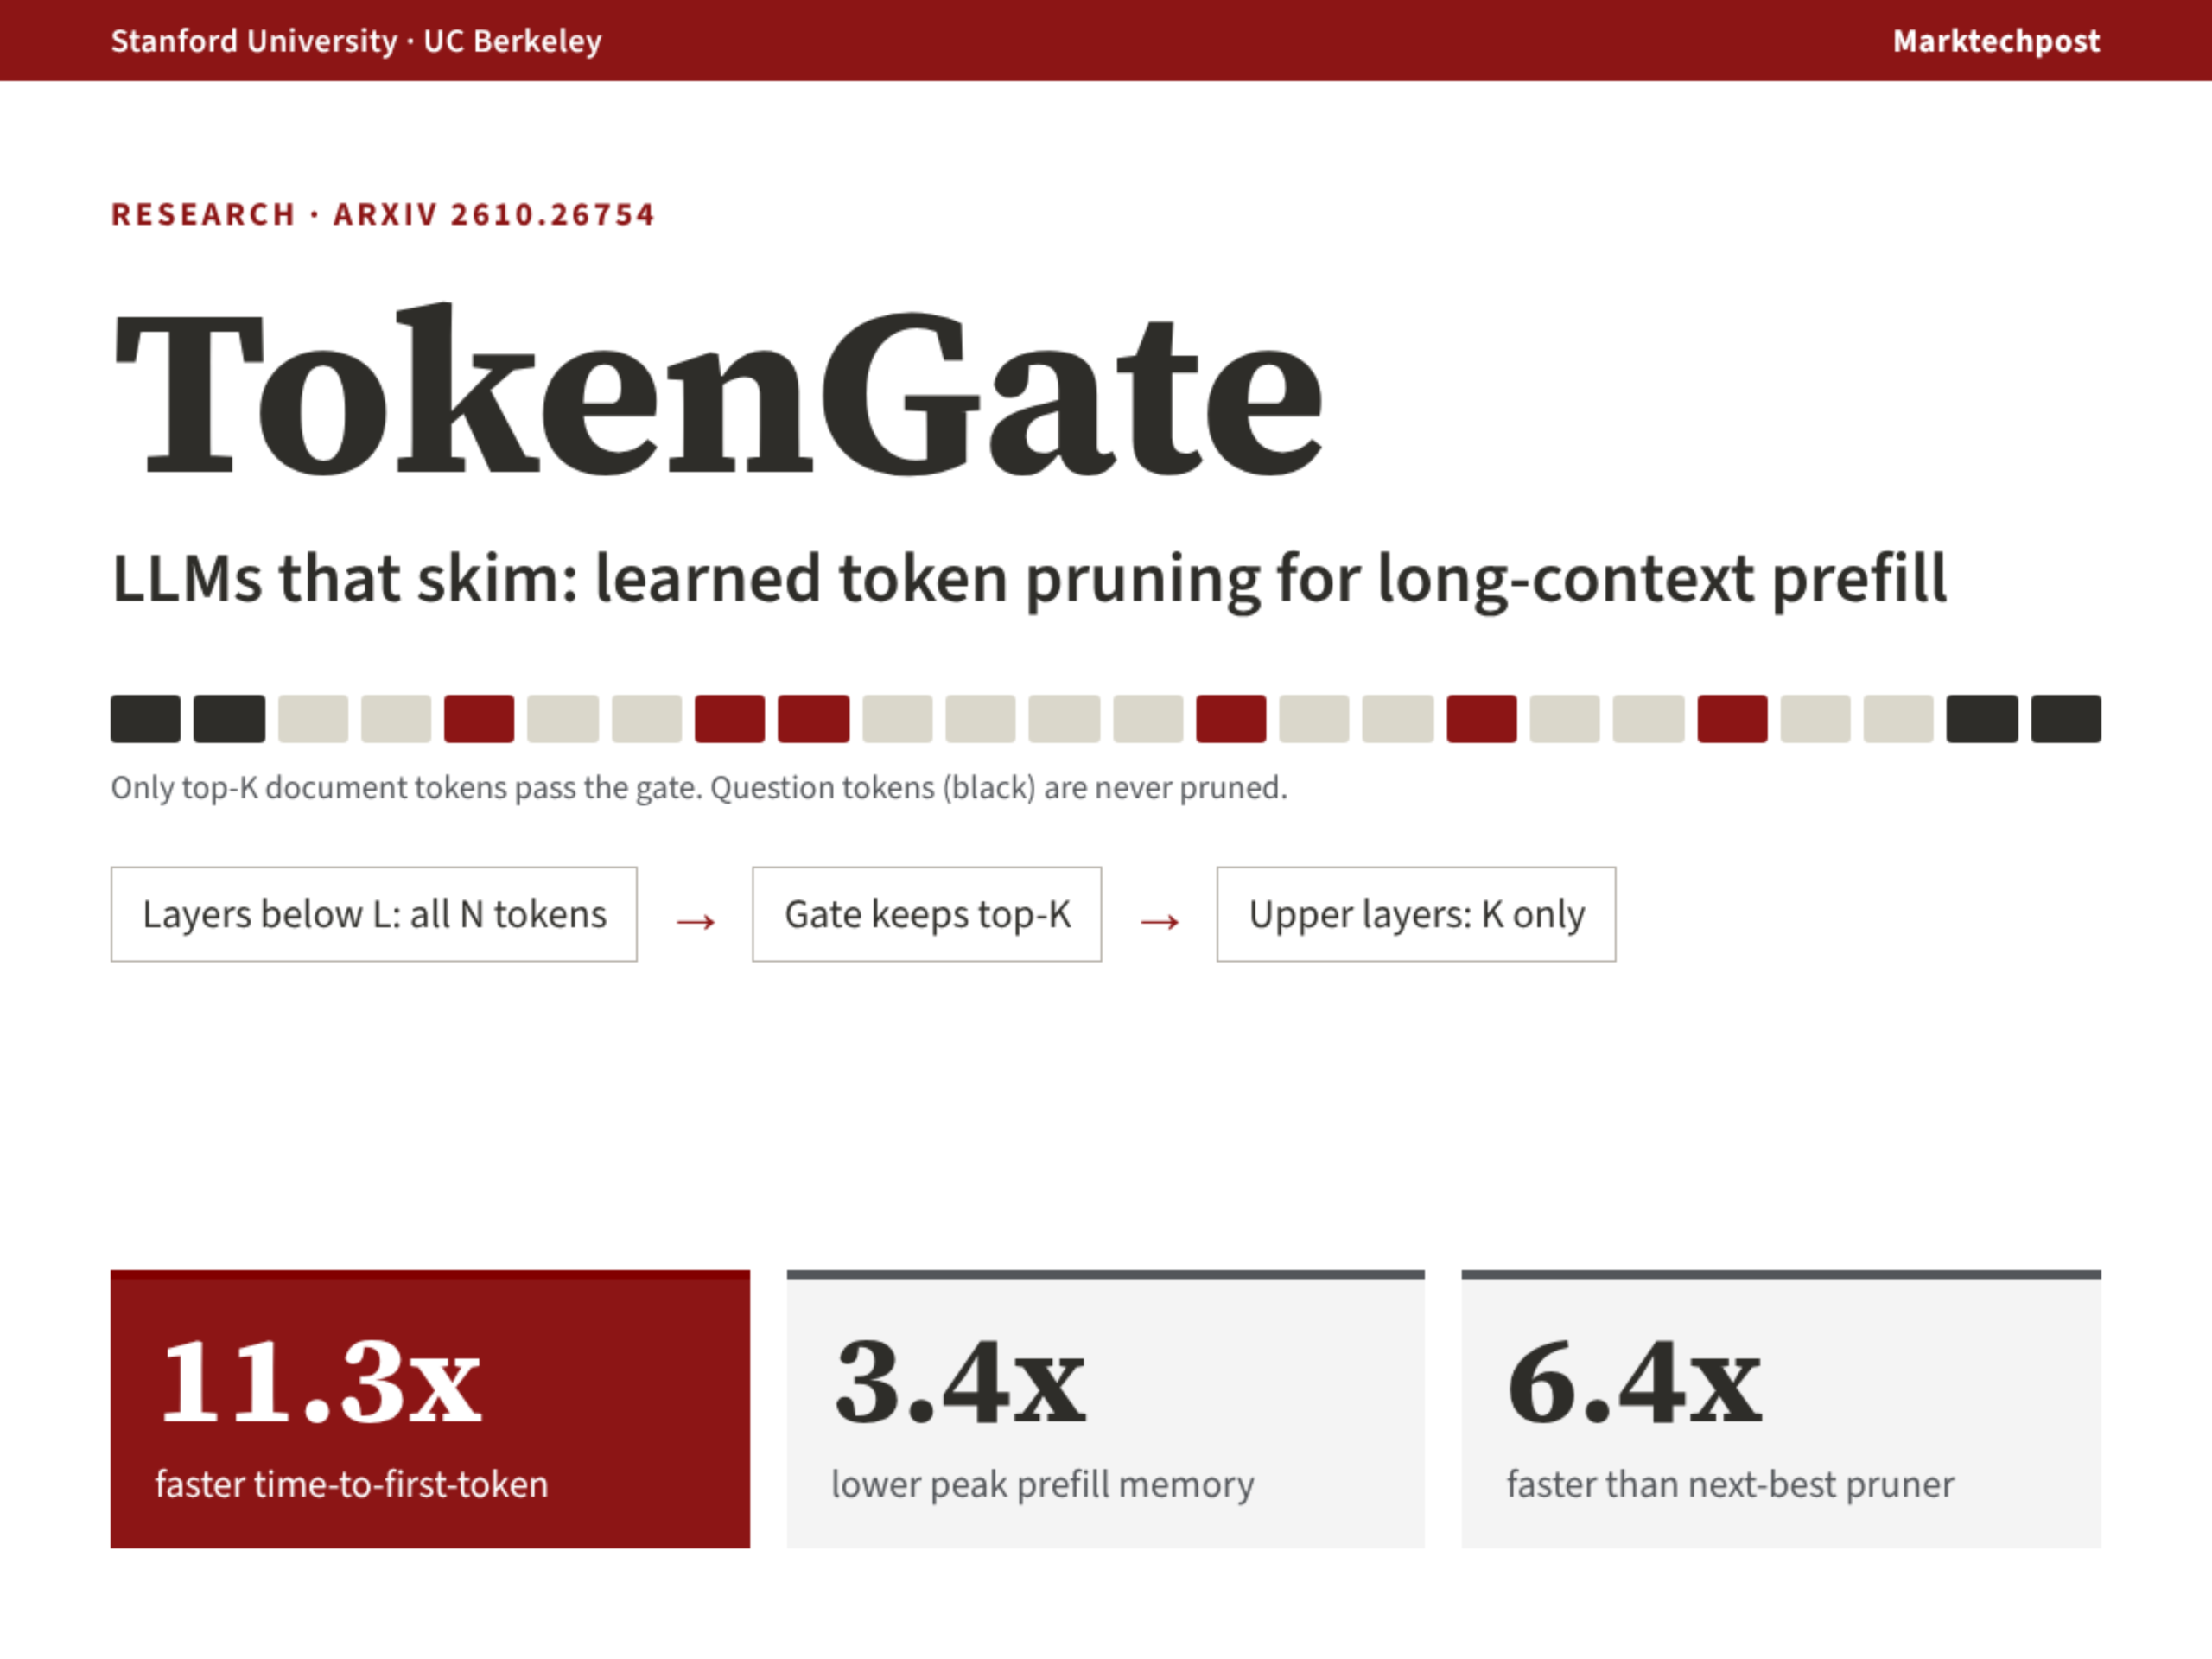
斯坦福大学与加州大学伯克利分校研究人员提出TokenGate——一种可即插即用的学习型令牌剪枝模块,适用于现有大语言模型(LLM)。该方法在不损失准确率的前提下,将长上下文预填充的首字生成时间(TTFT)加速1.4至11.3倍,峰值内存降低1.5至3.4倍。相关代码与检查点已开源。
Sebastian Raschka于2026年10月24日在Ahead of AI杂志(magazine.sebastianraschka.com)发布一套共八讲、超11小时的Python与PyTorch实操视频课程,系统讲解推理模型的评估、推理时扩展、强化学习(RLVR)与知识蒸馏,基于预训练Qwen3-0.6B模型实现全部方法。
推荐理由:该课程是作者继《从零构建大语言模型》后推出的进阶技术教育内容,聚焦当前主流LLM的核心演进方向——推理能力增强,覆盖从基础环境搭建到GRPO强化学习、自蒸馏等完整技术链,且明确声明所有实现均‘从零手写’、可复现,具备强教学性与工程参考价值。
AWS发布技术方案,利用SageMaker托管的Kokoro-82M文本转语音模型,通过双向WebSocket实现AI代理边生成文本边合成语音,显著降低端到端语音响应延迟;方案提供Base64-SSE与统一二进制传输两种音频回传方式,并明确标注为‘价值验证型’(proof-of-value),尚未进入生产就绪状态。
本文为Hugging Face与Amazon联合发布的技术博客系列首篇,系统介绍如何在AWS Trainium AI加速芯片上使用TorchNeuron进行PyTorch模型推理性能分析,涵盖Neuron后端集成原理、torch.profiler配置方法、NeuronConfig与NeuronProfiler工具使用、Neuron Explorer可视化追踪,并以RMSNorm为例对比三种实现(朴素PyTorch、torch.rms_norm内置融合、torch.compile自动融合)的设备耗时差异。
i14推出30.28亿参数的Laplace 3B模型,采用门控线性注意力(GLA)替代Softmax注意力,其推理时每序列递归状态恒为29.5 MB,与上下文长度无关;该模型在单台AWS trn2.48xlarge(16颗Trainium2芯片)上完成训练与服务验证,训练吞吐达12万token/秒,服务吞吐11544 output token/秒(1280并发序列),所有性能数据均为i14与AWS GenAIIC团队内部实测结果。
Hugging Face 发布 TorchTPU,为 PyTorch 提供原生 TPU 后端支持,使 Transformers、Diffusers 等库可直接在 TPU 上运行,无需依赖 torch_xla 或迁移到 JAX。
PyTorch 2.15 为 Apple Silicon Mac 带来重大 MPS 后端升级,首次在 macOS 上原生支持 FP8 张量运算,MoE 模型解码速度提升 5–6.5 倍,视频 VAE 解码峰值显存从 270 GiB 降至 8 GiB,并将大量算子从 MPSGraph 迁移至专用 Metal 内核。
Hugging Face联合AWS推出TorchNeuron——PyTorch原生Trainium后端,自2026年10月20日起开放公测。该技术使Transformers、Diffusers等主流库无需修改即可直接运行于Trainium芯片,显著提升文本生成与图像生成模型的易用性与兼容性。
用PyTorch(第2部分)进行剖析:来自nn. 折叠 MLP 的线性