
自動ワークロードリカバリで分散トレーニングを継続
分散型AIトレーニングがスケールするにつれ、ハードウェアおよびソフトウェアの依存関係における障害がトレーニングの進行をますます妨げるようになり、迅速で信頼性の高いリカバリが求められています...
見出し・要約・本文から、情報のつながりを探します。
分散型AIトレーニングがスケールするにつれ、ハードウェアおよびソフトウェアの依存関係における障害がトレーニングの進行をますます妨げるようになり、迅速で信頼性の高いリカバリが求められています...
本日、ハードウェアアクセラレータ向けRay特別研究グループ(SIG)を発表いたします。10年以上前にUCバークレーでRayが誕生した当時、コンピューティングの状況は非常に… この投稿「アクセラレータ向けRay特別研究グループ(SIG)の発表」は、PyTorchに最初に掲載されました。

NVIDIA DSX AI Factoryプラットフォームは、オープンソースを含む、エコシステムがより効率的なAIファクトリーを設計・構築・運用できるよう支援する技術を統合しています...
Mirendilは、1,000万トークンのコンテキストウィンドウでゼロから事前学習された初のモデルであるFern 0.1をリリースしました。同モデルはエージェント型AIの研究開発を対象としており、1,000万トークン規模でのRULERシングルニードルテストでは100%のスコアを獲得していますが、エージェント型コーディングにおいては最先端モデルには及ばない結果となっています。この記事「Mirendil、1,000万トークンのコンテキストを持つ初のモデルFern 0.1を公開」は、MarkTechPostに最初に掲載されました。
## 変更点 * model_prefetch:https://github.com/Comfy-Org/ComfyUI/pull/17178 で @rattus128 により、すべてのグラフクリーンアップを同期化 * MOSS-image にロープスケーリング対応を追加:https://github.com/Comfy-Org/ComfyUI/pull/17172 で @kijai による実装 * 【パートナーノード】APIノードにおいて、パートナーノードのサインイントークンを更新:https://github.com/Comfy-Org/ComfyUI/pull/16943 で @dante01yoon による実装 * 【パートナーノード】feat(HeyGen):HeyGen Voice の即時クローンおよびテキスト読み上げ機能を追加:https://github.com/Comfy-Org/ComfyUI/pull/17043 で @bigcat88 による実装 * 【パートナーノード】feat(ClarityAI):Crystal Video Upscaler ノードを追加:https://github.com/Comfy-Org/ComfyUI/pull/17192 で @bigcat88 による実装 * 【パートナーノード】feat(BFL):FLUX 3 Video ノードに 2K/4K 解像度を追加:https://github.com/Comfy-Org/ComfyUI/pull/17200 で @bigcat88 による実装 * MOSS-image をサポート
機械にとって「夜」とは何でしょうか?
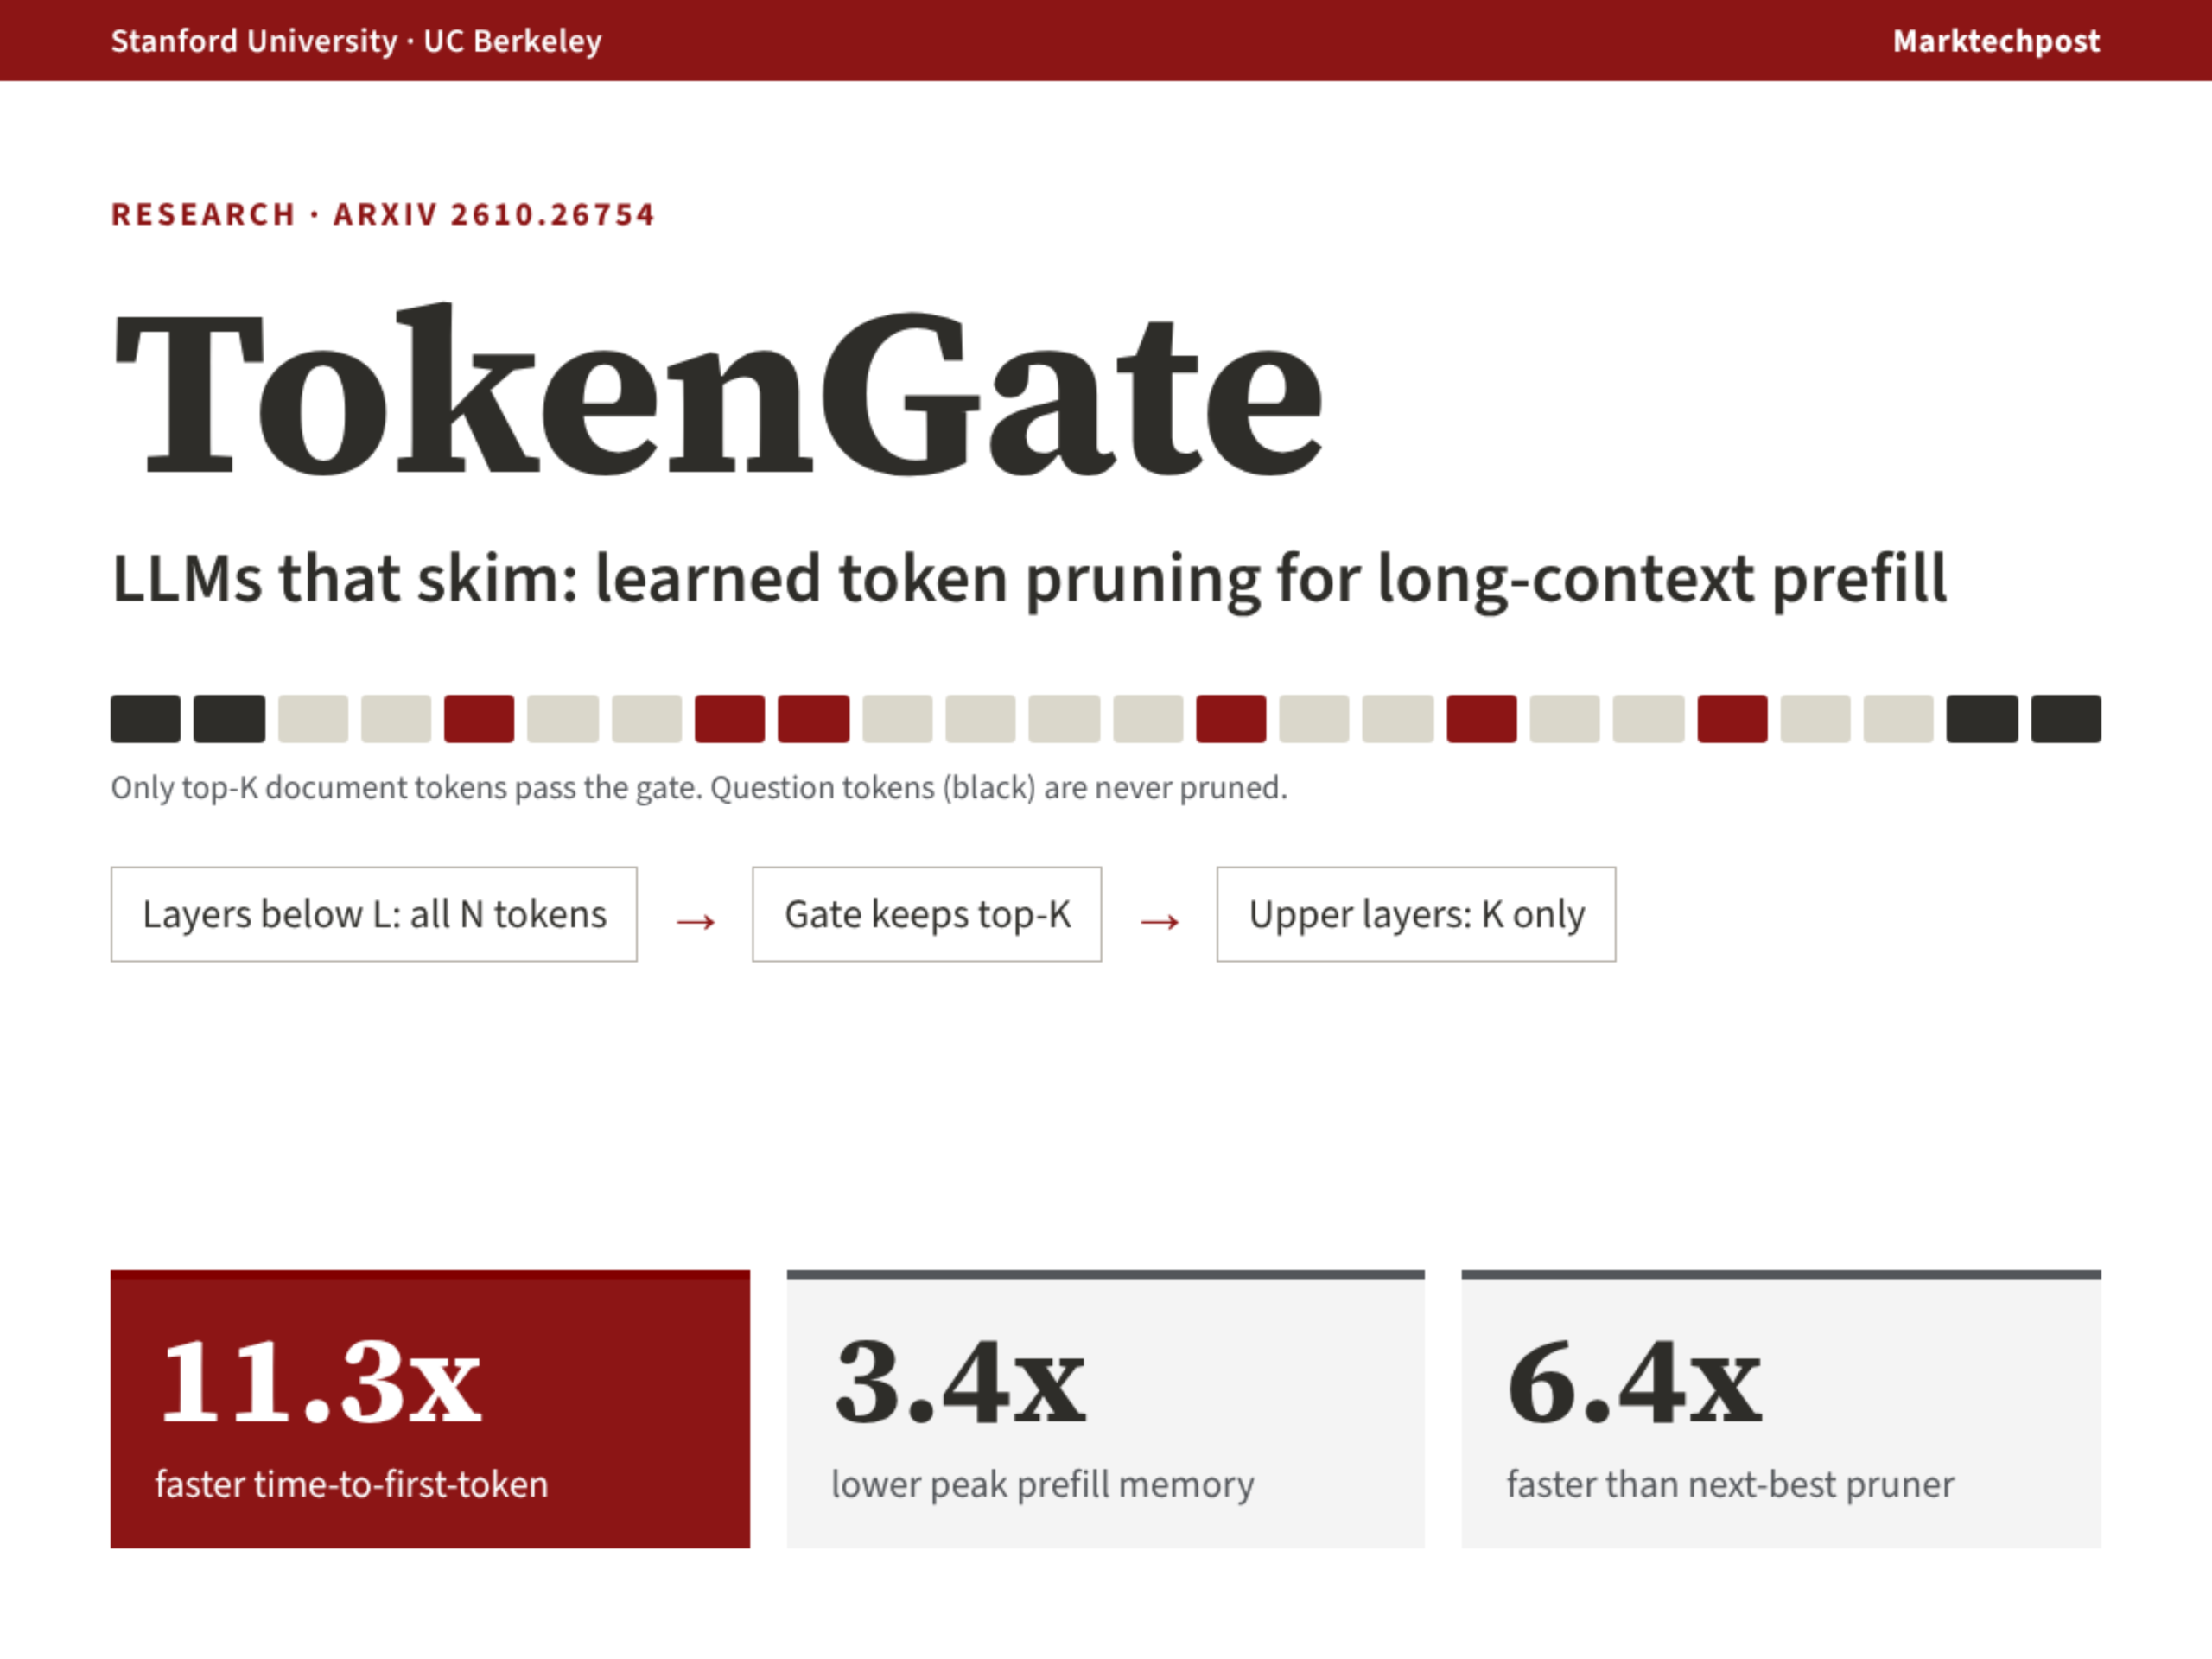
スタンフォード大学とカリフォルニア大学バークレー校の研究者らは、既存の大規模言語モデル(LLM)に適用可能なプラグアンドプレイ型の学習ベースのトークン剪枝モジュール「TokenGate」を提案しました。この手法は、精度を損なうことなく、長文コンテキストに対する初期文字生成時間(TTFT)を1.4倍から11.3倍に加速し、ピークメモリ使用量を1.5倍から3.4倍削減します。関連コードおよびチェックポイントはオープンソースとして公開されています。
セバスティアン・ラシュカは2026年10月24日、Ahead of AI誌(magazine.sebastianraschka.com)において、全8回・総計11時間超のPythonおよびPyTorchに関する実践型ビデオ講座を公開しました。同講座では、推論モデルの評価、推論時のスケーリング、強化学習(RLVR)、知識蒸留について体系的に解説し、すべての手法を事前学習済みQwen3-0.6Bモデルを基に実装しています。
注目する理由:本コースは、著者が『ゼロから大規模言語モデルを構築する』に続いて提供する高度な技術教育コンテンツであり、現在の主流LLMの核心的な進化方向である推論能力の強化に焦点を当てています。基礎環境の構築からGRPO強化学習、自己蒸留に至るまで、一連の技術スタックを網羅しており、すべての実装が「ゼロから手書き」で再現可能であることを明示しています。そのため、高い教育効果と実践的なエンジニアリングリファレンスとしての価値を備えています。
AWSは技術ソリューションを発表し、SageMakerでホストされるKokoro-82Mのテキスト音声変換モデルを活用して、双方向WebSocketを通じてAIエージェントがテキストを生成しながら同時に音声を合成することで、エンドツーエンドの音声応答遅延を大幅に低減します。このソリューションでは、Base64-SSEと統一バイナリ転送の2種類のオーディオ戻り方式を提供しており、明示的に「価値検証型」(proof-of-value)と位置付けられていますが、まだ本番運用に向けた準備状態には至っていません。
本記事は、Hugging FaceとAmazonが共同で公開する技術ブログシリーズの第1弾であり、AWS Trainium AIアクセラレーションチップ上でTorchNeuronを用いたPyTorchモデルの推論性能分析の手法を体系的に紹介します。内容には、Neuronバックエンドの統合原理、torch.profilerの設定方法、NeuronConfigおよびNeuronProfilerツールの利用、Neuron Explorerによる可視化トレースが含まれます。さらに、RMSNormを例に、3つの実装(従来のPyTorch、torch.rms_normの組み込み融合、torch.compileによる自動融合)間のデバイス上での実行時間の差異を比較しています。
i14は、30.28億パラメータを備えるLaplace 3Bモデルを発表しました。このモデルでは、Softmaxアテンションの代わりにゲート制御線形アテンション(GLA)を採用しており、推論時の各シーケンスあたりの再帰状態は常に29.5 MBで、コンテキスト長に依存しません。同モデルは、AWS trn2.48xlarge(Trainium2チップ16基搭載)1台でトレーニングおよびサービス検証を実施し、トレーニングスループットは12万トークン/秒、サービススループットは11,544出力トークン/秒(1,280同時実行シーケンス)に達しました。すべての性能データは、i14とAWS GenAIICチームによる社内実測結果です。
Hugging Face は TorchTPU をリリースし、PyTorch にネイティブな TPU バックエンドを提供することで、Transformers や Diffusers などのライブラリを torch_xla に依存したり JAX へ移行することなく、直接 TPU 上で実行できるようにしました。
PyTorch 2.15 は、Apple Silicon Mac に重大な MPS バックエンドのアップグレードをもたらし、macOS 上で初めて FP8 テンソル演算をネイティブにサポートします。また、MoE モデルのデコード速度が 5~6.5 倍に向上し、ビデオ VAE のデコードにおけるピークメモリ使用量は 270 GiB から 8 GiB へと大幅に削減され、さらに多数のオペレーターが MPSGraph から専用の Metal カーネルへ移行されました。
Hugging FaceとAWSが共同でTorchNeuronを発表しました。これはPyTorch向けのネイティブなTrainiumバックエンドで、2026年10月20日よりパブリックベータが開始されます。この技術により、TransformersやDiffusersなどの主要ライブラリを変更することなく直接Trainiumチップ上で実行でき、テキスト生成および画像生成モデルの使いやすさと互換性が大幅に向上します。
PyTorch のプロファイリング (パート 3): 注意は、すべてのプロファイルです
PyTorch(パート2)でプロファイリング:nnから。 溶融MLPへのリニア
PyTorch(パート1)でプロファイリング:トーチガイド。 プロフィール