
Show HN: LLM-cost-watch – Claude에게 왜 귀하의 LLM 청구서가 급증했는지 물어보세요
기사 URL: https://github.com/rohith0707/llm-cost-watch 댓글 URL: https://news.ycombinator.com/item?id=50415785 포인트: 1 # 댓글: 0
제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.
기사 URL: https://github.com/rohith0707/llm-cost-watch 댓글 URL: https://news.ycombinator.com/item?id=50415785 포인트: 1 # 댓글: 0
기사 URL: https://github.com/llmbrake/llmbrake 댓글 URL: https://news.ycombinator.com/item?id=50386174 포인트: 2 # 댓글: 0
arXiv:2611.03836v1 발표 유형: 신규 초록: 대형 언어 모델은 추론(생성) 시 다양한 응답을 제공하며, 이는 전통적으로 온도 파라미터에 의존합니다. 조건부 상호정보 접근법을 사용하여 응답 다양성에 대한 양적이고 엔트로피 기반의 분석을 제시합니다. 무에서 최대 상호정보에 이르는 세 가지 한계 행동을 정의합니다: 중재자, (조건부) 독립, 그리고 중립(결정론적). 각 행동에 대한 예시를 제시하고, 이를 온도 분석, 언어 분석, 프롬프트 압축 및 지식 그래프에 적용할 수 있도록 제안합니다.
arXiv:2610.37679v1 발표 유형: 신규 요약: 도구를 사용하는 언어 에이전트는 간접적인 프롬프트 주입에 취약하며, 점점 늘어나는 연구들은 모델 내부를 분석하여 안전하지 않은 행동이 실행되기 전에 이를 포착하려고 시도하고 있지만, 그 결과는 매우 상반됩니다. 우리는 이러한 갈등의 대부분이 평가 과정에서 발생하는 오류 때문이라고 주장하며, 평가와 학습 집단 모두에서 주입 노출과 행동적 약속을 분리하는 이중 계층화 프로토콜을 제안합니다. 주요 Qwen AgentDojo 그리드에서, 무지한 상태로 불안전한 행동과 나머지 행동을 혼합한 대조를 기반으로 학습된 모니터들은 대부분 노출을 인식하는 방식으로 학습됩니다. 즉, 에이전트가 실제로 행동을 따르든 아니든 노출된 경로를 표시하며, 어떤 경우에 안전하지 않은 행동으로 이어지는지 거의 예측하지 못합니다. 노출된 사례들만을 대상으로 재학습한 동일한 탐지 계열은 모델 자체가 수행하는 안전하지 않은 도구 호출을 최대 2초 전까지 예측할 수 있습니다.
arXiv:2610.37788v1 발표 유형: 신규 초록: 언어 모델 기반 비서는 사용자가 잘못된 답변을 제시하면 때때로 올바른 답변을 수정하기도 한다. 이러한 행동은 ‘아첨’으로 불리며, 일반적으로 선호 기반 사후 학습에 기인한다고 여겨지지만, 초기 측정에서는 사전 훈련된 모델에서도 발견되었다. 우리는 이 현상이 어디에서 발생하는지 파악하기 위해 학습의 모든 가능한 단계에서 이를 측정하였다: 기본 모델부터 감독 학습, 선호도 최적화를 거쳐 출시에 이르기까지, 5개 계열의 오픈 체크포인트 13개를 대상으로 분석했다. 또한, 주입된 주장이 모델의 답변을 얼마나 변화시키는지와 답변이 얼마나 견고하게 유지되었는지를 구분하고, 주장의 주체와 그 신뢰도, 그리고 주장의 강도를 다양하게 설정하여 실험을 진행했다. 그 결과, 서로 다른 기원을 가진 두 가지 아첨 행동이 나타났으며, 이 두 행동 모두 다양한 데이터셋에서 재현되었다. 주장에 대한 복종은 i
이제 PDF, Google 문서, Google 스프레드시트, 프레젠테이션 자료, Markdown 파일, TXT 파일 및 코드를 Google Gemini 내에서 직접 생성하고 미리 보고 편집할 수 있습니다. 새로운 파일 편집 기능은 오늘부터 모든 Gemini 사용자에게 제공되며, PDF 미리 보기와 편집은 웹과 모바일 모두에서 지원되지만 다른 모든 파일 형식은 현재 웹 버전에서만 이용 가능합니다.

역전! 위스프가 자사의 받아쓰기 앱에 회의록 기능을 추가한 뒤, 그라놀라도 회의록 작성 도구에 받아쓰기 기능을 탑재했습니다. 음성 AI 전쟁이 점점 흥미로워지고 있습니다.

GitHub Copilot Fusion이 일반에 공개되었습니다. 각 작업마다 개별 모델을 선택하는 대신, Copilot Fusion을 선택하면 Copilot이 지능적으로 어떤 모델을 사용할지 라우팅하고 오케스트레이션해 줍니다.… 글 ‘GitHub Copilot Fusion으로 모델을 라우팅하고 오케스트레이션하세요’는 The GitHub Blog에 처음 게재되었습니다.
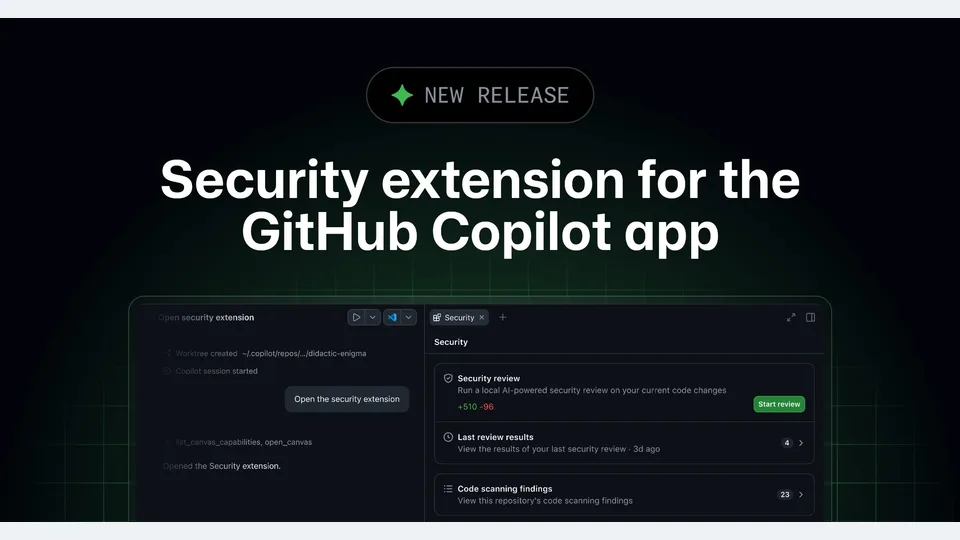
이제 GitHub Copilot 앱을 떠나지 않고도 리포지토리의 GitHub 코드 스캐닝 알림을 처리할 수 있습니다. 현재 공개 미리보기 중인 새로운 GitHub 보안 확장 기능을 통해 가장 중요한 알림을 찾고, Copilot에 이를 설명하거나 수정을 도와달라고 요청할 수 있습니다. 이 글은 GitHub 보안 확장 기능이 처음으로 게시된 GitHub 블로그의 내용입니다.
arXiv:2610.36178v1 발표 유형: 신규 초록: 우리는 임의의 숫자를 요청받았을 때 언어 모델이 1부터 N까지의 각 정수에 부여하는 확률을 표본 오차 없이 측정한다. 고정된 프롬프트 하에서 모델은 하나의 확률 벡터를 정의하며, 이는 표본 추출로 추정하는 방식이 아니라 각 정수의 점수화된 표현을 모두 합산하여 계산함으로써 기존 연구들[1, 4]에서 제한되던 노이즈를 제거한다. 우리는 두 개의 추론 스택에서 N = 100까지의 다섯 가지 범위에 걸쳐 18개의 오픈 웨이트 모델 라인을 29가지 디코딩 구성하에 평가하였으며, 그 중 15개 모델은 사용 가능한 답변을 제공하는 기본 체크포인트와 지도 조정 체크포인트가 모두 일치하였다. 지도 조정은 이 15쌍 모두에서 분포를 보다 균일하지 않게 만들며, 하나의 휴리스틱인 ‘둥근 수 회피’를 도입하고 또 다른 휴리스틱인 ‘종점 회피’를 더욱 명확히 한다. 기본 체크포인트
arXiv:2610.36353v1 발표 유형: 신규 초록: 대규모 언어 모델(LLM)은 종종 모호한 입력에 대해 하나의 의도된 의미만 있는 것처럼 답변합니다. 이는 문제가 되는데, 입력의 모호성은 불확실성의 상류 원천이기 때문입니다. 즉, 프롬프트가 여러 가지 타당한 해석을 허용할 때, 핵심 질문은 모델이 과연 직접 답변을 해야 하는지 여부입니다. 기존의 입력 불확실성 처리 방법들은 종종 LLM이 생성한 문장이나 명확화에 의존하지만, 이러한 변환 과정 자체가 모호성을 측정하기 전에 이미 입력을 해석해 버릴 수 있습니다. 우리는 입력 모호성 감지를 위한 라벨 보존형 페르투베이션 프레임워크를 제안하며, 이 프레임워크에서는 페르투베이션이 원래 입력에 가까운 상태로 유지되면서 동시에 해당 입력의 라벨을 보존합니다. 우리는 이 원칙을 두 가지 감지기로 구현했습니다: 블랙박스 기반 규칙 기반 페르투베이션 라이브러리와
LangChain이 Slack에서 브랜드에 맞는 동영상, 그래픽 및 프레젠테이션을 제작하는 오픈소스 디자인 에이전트인 Content Studio와 이를 구동하는 하네스를 어떻게 구축했는지.
기업용 음성 인공지능 기업인 리갈 보이스 주식회사는 오늘 자사 플랫폼에 목표 지향형 에이전트를 추가하여, 이를 활용하는 기업들이 전화 통화가 달성해야 할 목표를 명확히 정의할 수 있도록 하고, 그 목표 달성을 위한 작업을 분담하는 두 가지 AI 모델을 제공합니다. 새로운 에이전트는 리갈이 “다음과 같은 전화 상담에서 흔히 나타난다”고 밝힌 문제 해결을 목표로 합니다. 이 글은 ‘리갈, 목표 지향형 에이전트 공개… 모든 전화 통화에 배우와 감독 모델을 도입’이라는 제목으로 실리콘 앵글에 처음 게재되었습니다.
에이전트가 대중화됨에 따라, 일부 출판사들은 사람들이 인간이 아닌 AI를 위해 맞춤 제작된 콘텐츠에 비용을 지불하기를 기대하고 있습니다.
실리콘밸리의 다음 한 차례 재편은 어쩌면 여기에서부터 시작될지도 모릅니다.
모델 크레딧이 페스티벌 프로모션과 통신사형 팩에 등장하고 있다. 불투명한 마진으로 성장해 온 소규모 리셀러들은 품질에 대한 의문, 규제 강화, 그리고 더 많은 자금을 갖춘 경쟁업체들에 직면했다. 지속 가능한 중개업체들은 비밀 가격 인하가 아니라 라우팅, 신뢰, 통합에 대해 비용을 청구할 것이다.
AI 순위에서 1위는 바뀌지만, 사용자가 매일 이용하는 제품은 반드시 바뀌지 않습니다. 대규모 모델 간의 다음 경쟁은 단순히 누가 더 강력한 모델을 보유하느냐를 넘어, 한 번의 사용을 습관으로 만드는 데에 있습니다.
arXiv:2610.32101v1 발표 유형: 신규 초록: 대규모 언어 모델(LLM)은 출력 분포가 익숙한 의미적 패턴에 집중되는 모드 붕괴 현상을 보입니다. 다양성이 사라지면, 반복적인 샘플링은 발견이 아니라 의미적 반복으로 변하게 되어 흔하지는 않지만 더 강력한 해결책들이 드러나기 어려워지고, 자가 진화와 지속적 학습을 유지하기도 어렵게 됩니다. 대부분의 해결책들은 추론 단계에서만 개입하여 샘플을 조정할 뿐, 다양성을 모델의 핵심 역량으로 만들지는 않습니다. 우리는 훈련 시점에서 다양성을 모델 내부에 내재화하는 프레임워크인 PRISM을 제안합니다. PRISM은 (i) 각 프롬프트에 대해 다양하면서도 정확한 다중 교사 솔루션을 매칭하는 부분모듈러 큐레이션과, (ii) 특수 토큰 변형을 임플로…
arXiv:2610.32429v1 발표 유형: 신규 초록: 대규모 언어 모델(LLM) 에이전트는 점점 더 비동기적으로 작업을 수행합니다. 주 에이전트는 하위 에이전트들이 실행되는 동안에도 계속 작업을 진행하며, 그 결과가 도착하기 전에 작업 상태가 변경될 수 있습니다. 이때 주 에이전트는 어떤 작업을 업데이트하거나 보존하고, 어떤 검사를 다시 수행할지 결정해야 하며, 동시에 금지된 변경 사항을 피해야 합니다. 최종 작업 성공 여부만으로는 이러한 결과가 올바르게 처리되었는지 여부를 확인하기 어렵고, 자연스러운 비동기적 도착 현상은 재현하기도 어렵습니다. 우리는 LLM 에이전트의 비동기적 작업 실행을 평가하는 벤치마크인 Async-RBench를 제안하며, 8가지 시나리오를 포괄하는 200개의 실행 가능한 작업을 제공합니다. 각 시나리오 컨트롤러는 미리 정의된 작업 상태 조건을 활용해 결과 전달을 관리하고, 이벤트 응답 계약(ERC)은 각 응답이 무엇을 의미하는지를 명시합니다.
arXiv:2610.33006v1 발표 유형: 신규 초록: 트랜스포머 기반 대규모 언어 모델(LLM)은 컨텍스트 크기가 증가함에 따라 상당한 연산 및 메모리 비용을 수반하므로, 추론 전에 컨텍스트를 더 짧은 표현으로 압축하는 방법이 필요합니다. 기존의 소프트 프롬프트 압축 방식은 일반적으로 목표 모델과 동일한 트랜스포머 백본을 사용하며, 압축된 표현을 생성하는 과정에서 상당한 지연 오버헤드가 발생합니다. 이로 인해 이러한 방식은 컨텍스트를 한 번 압축한 뒤 여러 쿼리에 걸쳐 재사용하는 오프라인 환경에만 제한됩니다. 우리는 Mamba 상태공간 모델(SSM)을 기반으로 한 플러그 앤 플레이형 온라인 컨텍스트 압축기인 Boa Compressor를 제안합니다. 이 압축기는 임의 길이의 컨텍스트를 단일 선형 시간 패스로 인코딩하여, 그 결과 얻은 표현을 바탕으로 우리가 조건부…