本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

2026年に最も注目されるAI搭載ウェアラブルデバイスの総覧:Bee、Friend、Limitlessなど十数機種が一斉に登場

TechCrunchは2026年10月25日、Bee、Friend、Limitless、Muse Charm、Nirva、Omi、Plaud NotePin、Rabbit R1、Streamリングなど、十数種類のAI搭載ウェアラブルデバイスを総括したレビューを公開し、価格、機能の位置付け、発売状況、ならびにプライバシーに関する論争について取り上げた。

The hottest AI wearables and gadgets you should know about

注目する理由:この報道は、権威あるテクノロジー系メディアであるTechCrunchが2026年10月25日に発表した年間新製品総覧であり、現在の主要なAIハードウェアメーカーおよびスタートアップ企業を網羅しています。情報の視点は価格、形状、核心機能、市場投入スケジュール、論争点といった各側面にわたり、すべての記述は資料に明示された事実に基づいており、推測や拡張は一切含まれていません。
経緯と関連報道

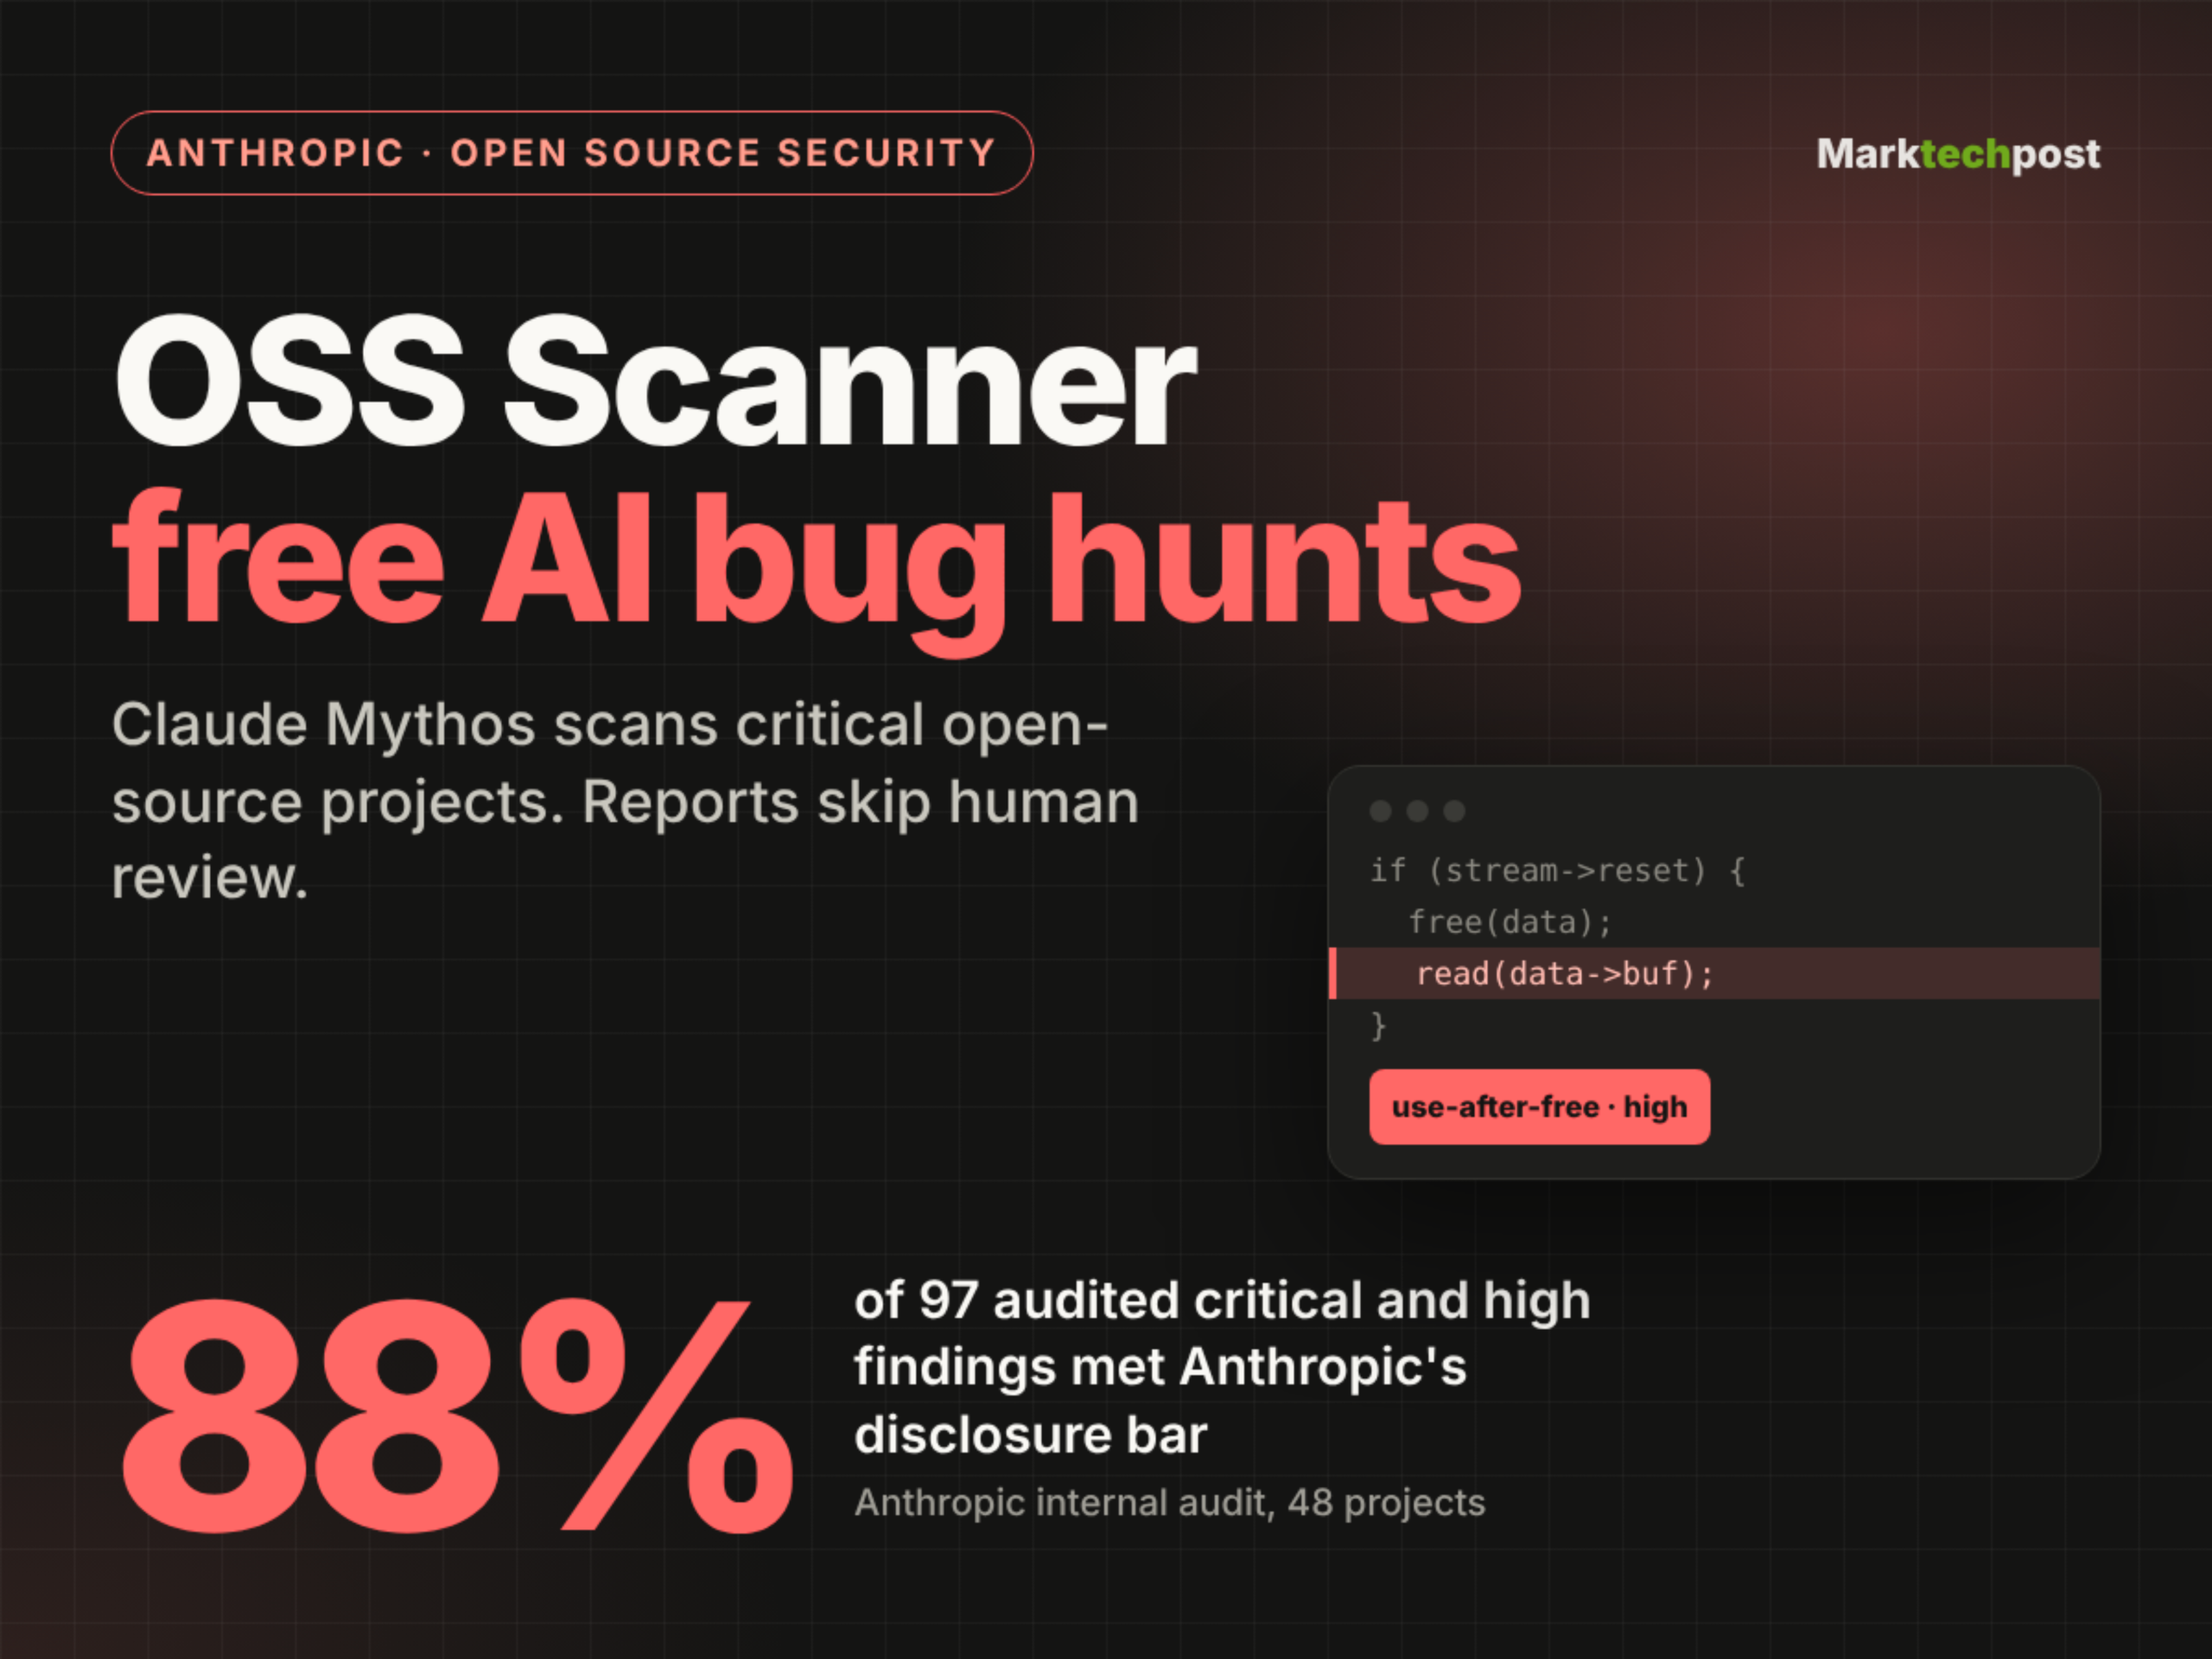
Anthropicが、主要なオープンソースプロジェクト向けの無料AI脆弱性スキャナー「OSS Scanner」を発表しました

Anthropicは2026年10月8日、Claude Mythosなどの強力なモデルを基にした無料でオプトイン型のAI脆弱性スキャンツール「OSS Scanner」をリリースし、重要なオープンソースプロジェクト向けに設計しました。10月19日時点で、114のプロジェクトが受け入れられ、11日間で深刻度レベル77件および高リスクレベル803件の脆弱性(モデルによる評価)が報告され、サンプリングされた監査結果の88%が同社の開示基準に適合していることが確認されました。

Anthropic Launches OSS Scanner, a Free AI Vulnerability Scanner

注目する理由:このツールは、オープンソースセキュリティ分野におけるLLMの大規模な実装事例を示しており、無償・完全自動・オフラインでの監査を特徴としています。ただし、人手によるレビュー工程を省略することで、誤検知や重複する問題が生じるリスクも伴います。その精度データ(有効率88%、偽陽性率1%)および実際のプロジェクトからのフィードバック(wolfSSLやcurlなど)は、現在のAI主導型脆弱性発見能力に関する実証的なベンチマークを提供しています。

経緯と関連報道

KimiがK3.1 Proを発表:エンドポイントタスク能力がトップに躍進、シミュレーションによるデバッグとマルチモーダルプログラミングにより具現知能の原型を示す

Kimiは2026年10月25日にK3.1 Proモデルを発表し、Terminal-Bench 4.0のタスクテストにおいて成功率67.2%で首位に立った。また、エミュレーターのバグを自律的に修正し、物理シミュレーション、音声解析、3Dシーン構築、動画編集といった多様なタスクをこなす能力を備えており、身体拡張型知能技術の道筋を探る方向性を示している。

根据报道中的虚拟人行走训练和模拟器调试制作的编辑示意,非软件实拍截图

注目する理由:本資料は、钛媒体が許諾して公開した実測レポートに基づいており、Artificial Analysis、Terminal-Bench 4.0 などの権威ある第三者評価データ、公式による自主テスト結果、ならびに著者による多様なシーンにおける機能検証を網羅しています。K3.1 Pro の実行性能、シミュレーションのクローズドループ、マルチモーダルプログラミングにおける実質的な進歩に焦点を当てるとともに、性能上の限界や未公表の情報(例:Flash/Ultra はまだリリースされていない)についても明示しており、事実確認および出典表示の要件に準拠しています。

経緯と関連報道

パネルメーカー各社は、AIによる上流コストの圧迫に対応するため一斉に価格を引き上げているが、下流の受け入れ度は低く、端末製品の品質管理にも圧力がかかっている

2026年9月以降、TCL華星、京東方、惠科などのパネルメーカーが相次いで値上げ通知を発表しています。その主な要因は、AI大規模モデルの発展に伴うHBM需要の急増により、成熟プロセス向け半導体の生産キャパシティが逼迫し、ドライバIC、PCB、ガラス基板など主要部材の価格が上昇していることです。同時に、コーニングをはじめとする上流サプライヤーも一斉に価格を引き上げています。コスト面での圧力は明確ですが、下流のテレビ/ディスプレイブランドによる調達価格は広く値上がりしておらず、端末ユーザーからは過熱やブラックスポットといった品質管理上の問題が頻発しているとの不満が寄せられています。そのため、値上げはまだ実際の取引価格の上昇や体験の向上には反映されていません。

AI大模型狂飙,面板行业也扛不住了

注目する理由:材料システムは、AI産業が直接的な関連性のないハードウェア業界に及ぼすクロスチェーンによる伝播メカニズムを明らかにした——AIによるパネル需要の押し上げではなく、ウェハ生産能力の再配分を通じて全チェーンにわたるコストの再設定が引き起こされているのだ。同時に、価格上昇の動きと市場の実際の反応(価格の硬直化、出荷の減少、ユーザーからの苦情)との間に顕著な乖離が存在することも示しており、産業における交渉力と製品力の不一致という深い矛盾を浮き彫りにしている。

経緯と関連報道

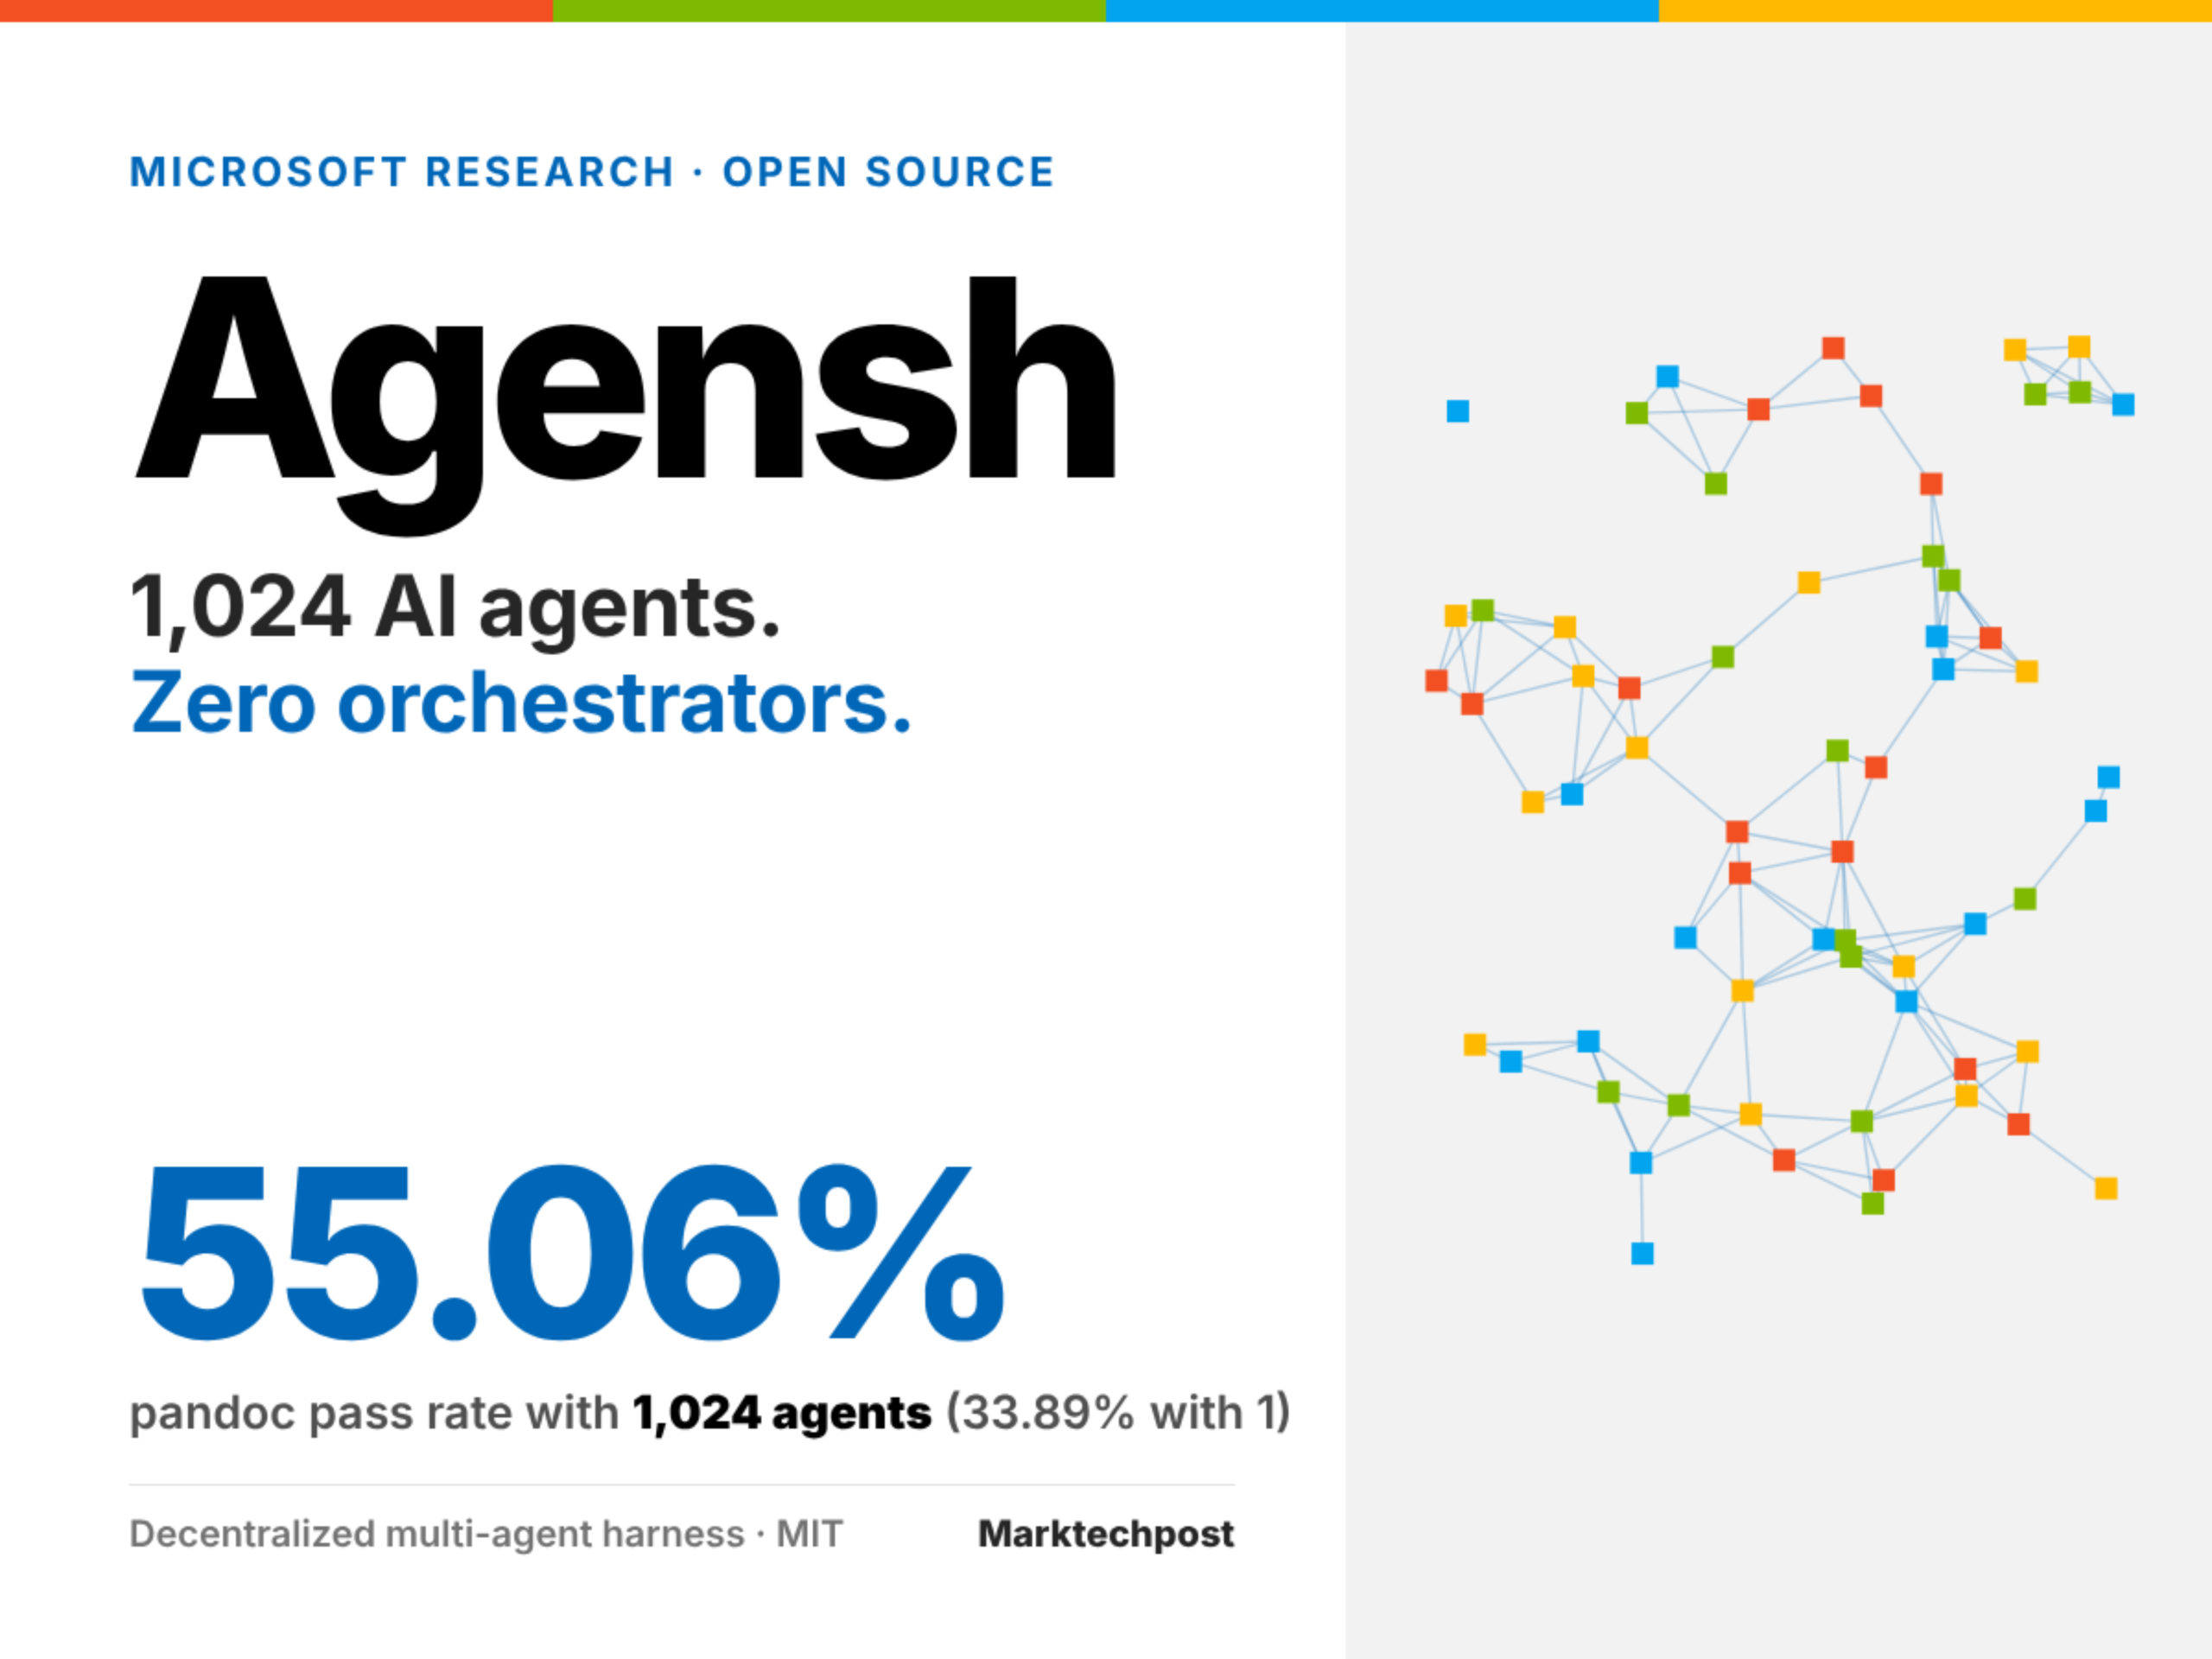
マイクロソフトがAgenshをオープンソース化:1024個の自律協調型AIコーディングエージェントをサポートする分散型フレームワーク

マイクロソフト研究院は2026年10月25日、中央調整者を必要としないマルチエージェント実行時フレームワークであるAgenshをオープンソース化しました。Agenshは、ProgramBench上で1~1024のLLMベースのコーディングエージェントが自己組織的に協調して動作することを支援します。システムはGitea、Mattermost、DeLMスタイルの共有ボードに基づいて分散型の調整を実現しており、すべてのエージェントが同一のプロンプト駆動型五段階ループを実行します。また、Linux+Docker環境下でスケーラビリティが検証されています。

Microsoft Open-Sources Agensh: A Multi-Agent Harness for 1,024 Agents

注目する理由:この成果は、マルチエージェントシステムアーキテクチャの重要な進化を示しており、従来の「マスターエージェント」型パラダイムを廃し、プロンプトエンジニアリングと軽量なサービスの組み合わせによって大規模な自己組織化を実現しています。ProgramBenchにおける実証データ(たとえば、128個のエージェントによる5つのタスクの均等分配において49%の性能向上)は、分散型AIの設計・実装に新たなベンチマークを提供しています。また、MITライセンスでオープンソース化されており、Copilot CLIなどの主流な単一エージェントツールとも互換性があるため、実際の開発における参考価値も備えています。

経緯と関連報道

NVIDIAを引きずり込んでAppleに真っ向から対抗し、マイクロソフトのハイエンドAI PCという賭け

マイクロソフトは、NVIDIA RTX Sparkを搭載したSurface Laptop Ultraで、ローカルAI開発者およびハイエンドクリエイターの獲得を目指している。ハードウェアは大容量の統合メモリ、CUDA、RTXグラフィックス機能をポータブルデバイスに持ち込んだが、Macに対する持続的な競争力を確立できるかどうかは、依然としてアプリケーションの適応性、エージェント体験、そして実際のワークフロー次第である。

注目する理由:この競争が最終的に問うべきは、ローカルAIが創作や開発の効率を実際に向上させられるのか、そしてユーザーがそれに伴うデバイス・ソフトウェア・移行コストを負担する価値があるのか、という点です。ハードウェアは新たな可能性をもたらしますが、その可能性がどれほどのユーザーに届くかは、エコシステムと実際の使用体験によって決まります。

経緯と関連報道

Apple初の折りたたみ式スクリーン搭載iPhone Duoが発売と同時に、画面の集中的な割れ問題が発生している

複数のユーザーから、Apple初の折りたたみ式スマートフォン「iPhone Duo」について、開封後わずかな時間でヒンジの真上部分の画面にひび割れや線状の破損が生じるという報告が寄せられており、故障の発生が極めて集中しているとのことです。オーストラリアおよび中国国内でも同様の事例が確認されており、原因はヒンジの組み付け公差にあると疑われています。Apple公式からのコメントはまだなく、アフターサービスでの判定結果次第で、無償交換か高額な自己負担による修理が決まる見込みです。

注目する理由:本件は、新製品における大規模な初期不良をめぐる事案であり、消費者の権利と企業の責任の境界に直面するものであるとともに、三包法規の適用性やAppleCare+サービスの位置付けといった公共的課題も重なり、典型的な警鐘としての意義と権利救済の参考価値を有している。

経緯と関連報道

llama.cpp 发布 b11867 版本:服务端入口重构,全面支持多平台与异构加速后端

llama.cpp 于 GitHub 正式发布 b11867 版本,核心变更包括服务端(server)入口点重构(PR #31113),新增 server_role 机制;同时提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的 40+ 预编译二进制包,支持 CPU、CUDA(12.4/12.8/13.4)、Vulkan、ROCm 10.0、OpenVINO、SYCL(FP16/FP32)、Snapdragon(Adreno+Hexagon)等多元硬件后端。

注目する理由:按信源设置仅收录,不参与自动精选

経緯と関連報道

セバスチャン・ラシュカが8本のビデオコース「ゼロから推論モデルを構築する」を公開しました

セバスティアン・ラシュカは2026年10月24日、Ahead of AI誌(magazine.sebastianraschka.com)において、全8回・総計11時間超のPythonおよびPyTorchに関する実践型ビデオ講座を公開しました。同講座では、推論モデルの評価、推論時のスケーリング、強化学習(RLVR)、知識蒸留について体系的に解説し、すべての手法を事前学習済みQwen3-0.6Bモデルを基に実装しています。

注目する理由:本コースは、著者が『ゼロから大規模言語モデルを構築する』に続いて提供する高度な技術教育コンテンツであり、現在の主流LLMの核心的な進化方向である推論能力の強化に焦点を当てています。基礎環境の構築からGRPO強化学習、自己蒸留に至るまで、一連の技術スタックを網羅しており、すべての実装が「ゼロから手書き」で再現可能であることを明示しています。そのため、高い教育効果と実践的なエンジニアリングリファレンスとしての価値を備えています。

経緯と関連報道

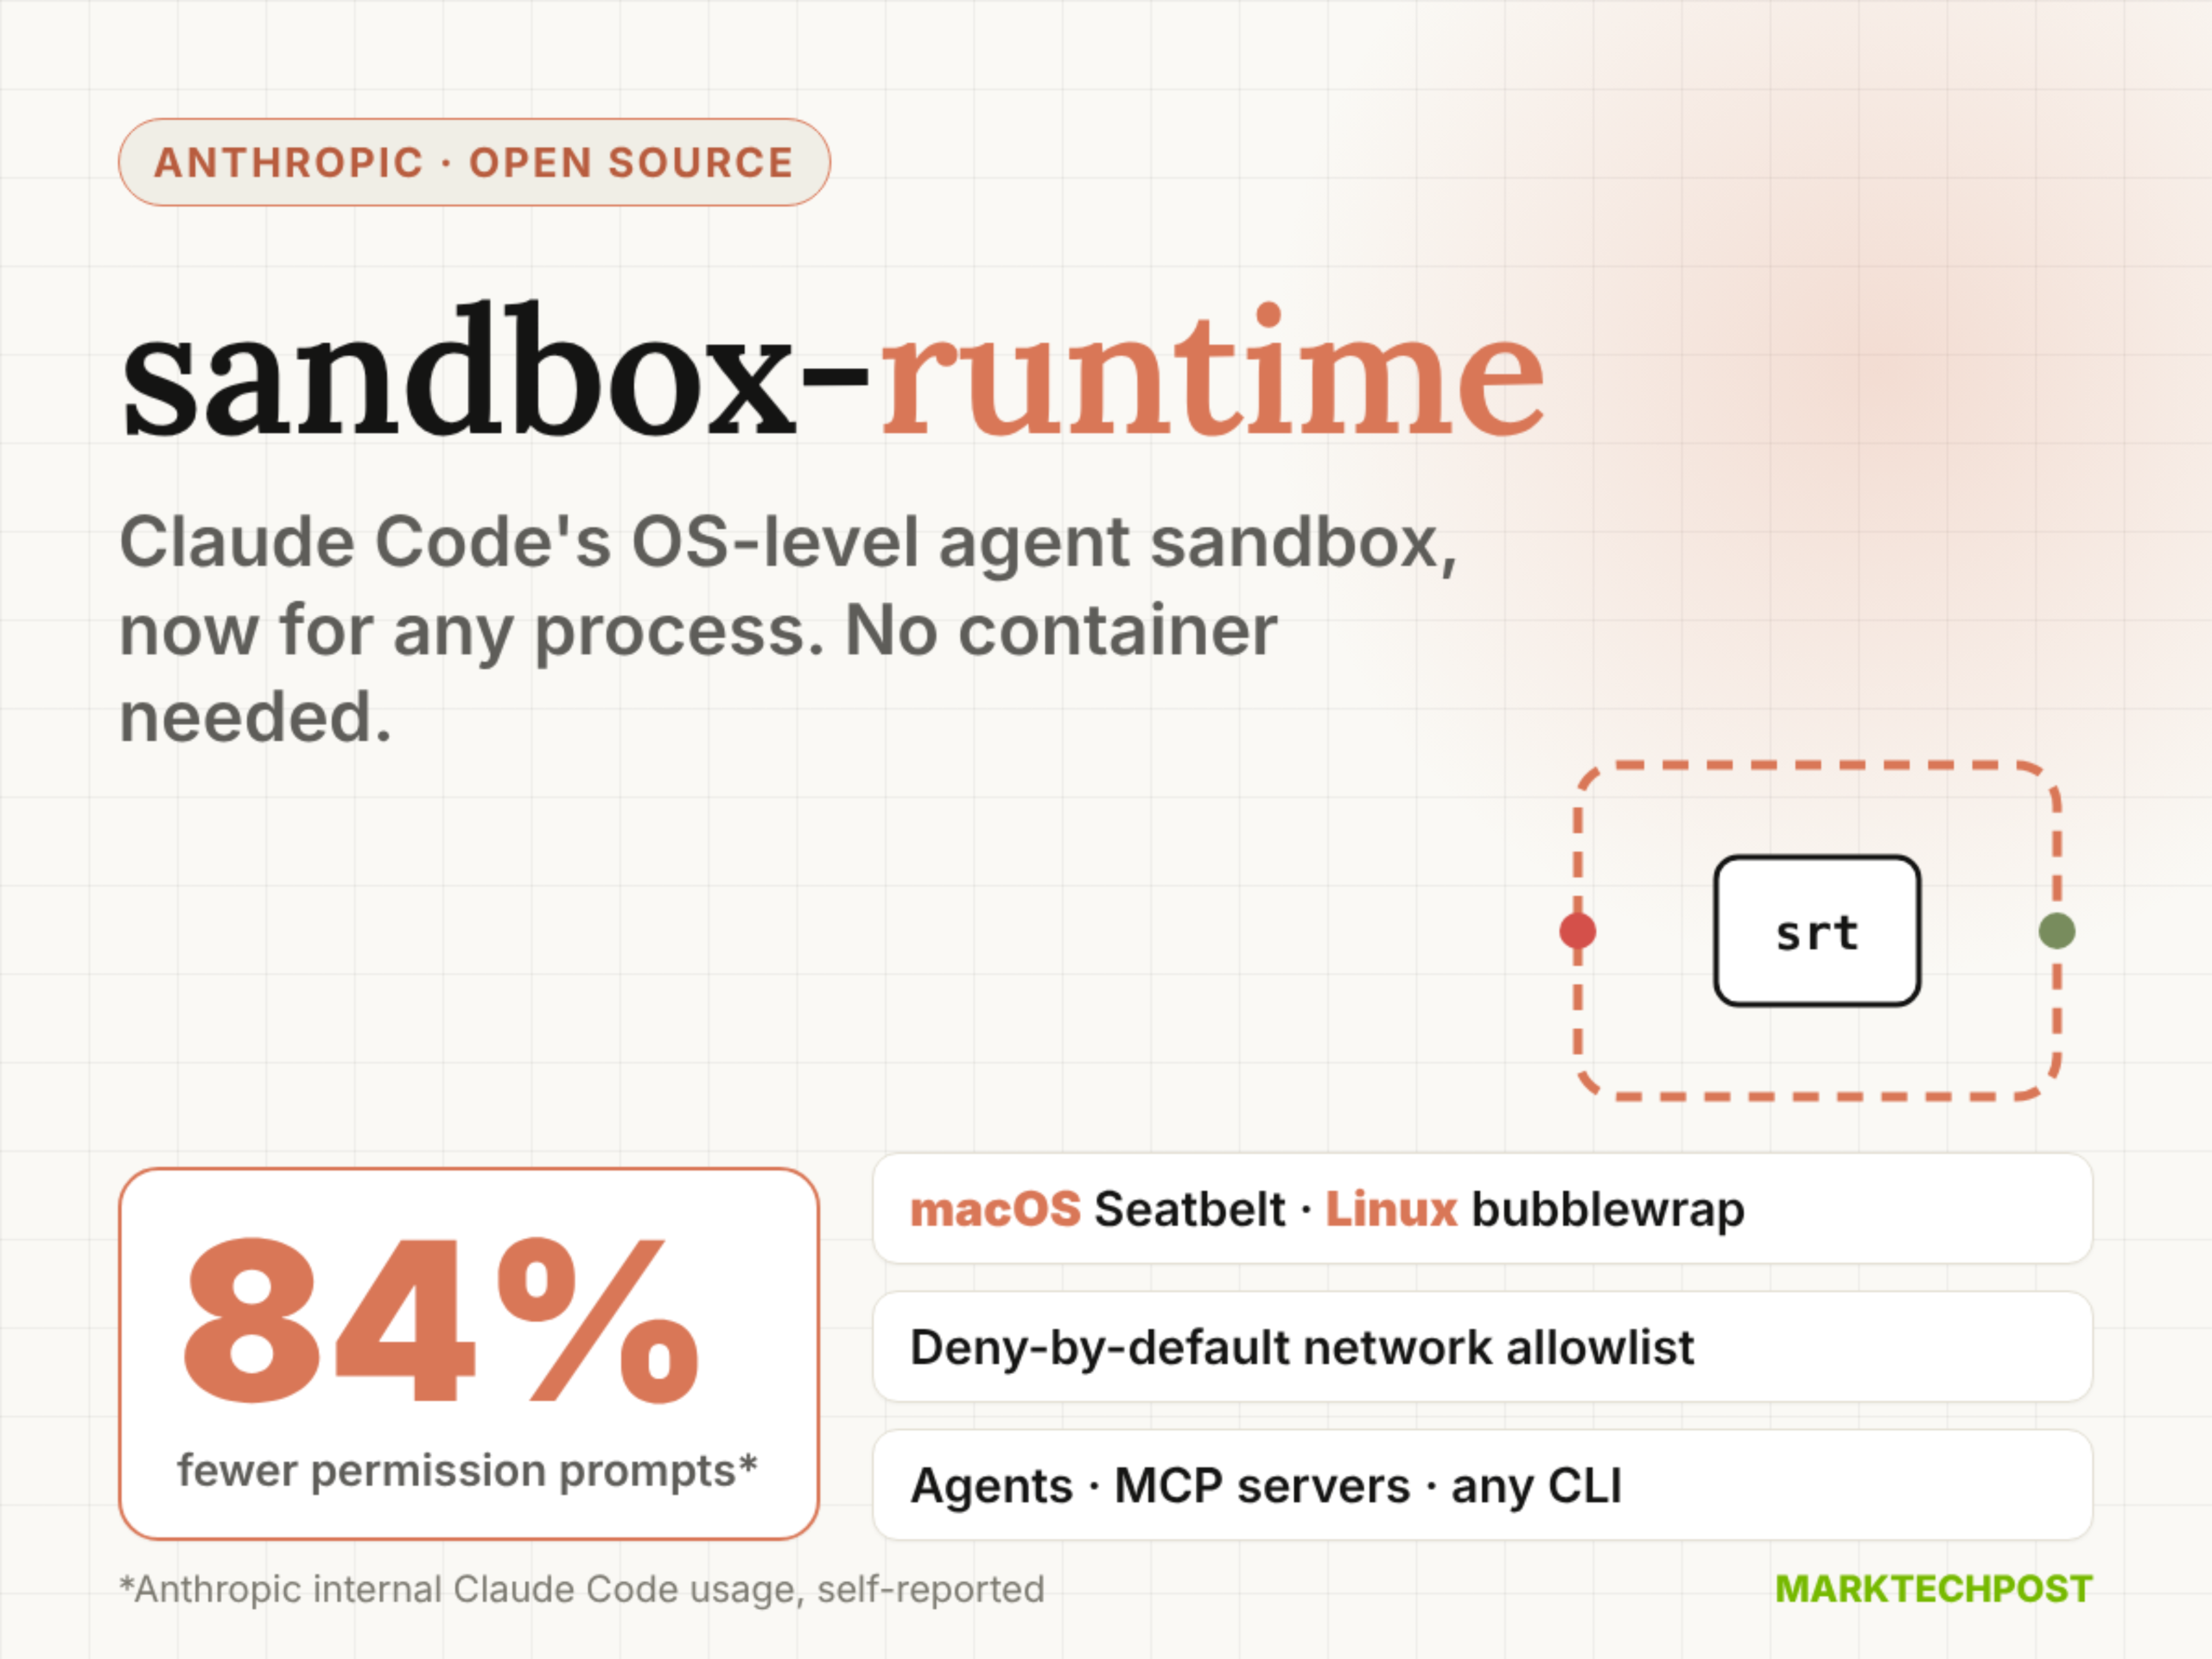
AnthropicがOSレベルのサンドボックスであるsandbox-runtimeをオープンソース化:AIエージェントにコンテナレスなファイルおよびネットワーク隔離を提供

Anthropicは2026年10月24日、AIエージェント、MCPサーバー、CLIツールのファイル読み書きおよびネットワークアクセス権を制限するための、コンテナに依存しないOSレベルのサンドボックスツールであるsandbox-runtime(srt)をオープンソース化しました。macOS(Seatbelt)、Linux(bubblewrap)、Windows(alpha)をサポートしており、npmパッケージのバージョンはv0.0.81で、ライセンスはApache-2.0です。

Meet Anthropic’s sandbox-runtime: OS-Level Sandboxing for AI Agents, No Containers

注目する理由:このツールは、AIセキュリティインフラストラクチャの重要な進化を示しています。OSのネイティブな隔離メカニズムにより、細粒度でプロセスツリー全体を網羅するサンドボックス制御を実現し、プロンプトインジェクションや権限の過剰付与といったリスクに正面から対処しています。また、Claude Code内部での使用においてもその効果が検証されています。

経緯と関連報道

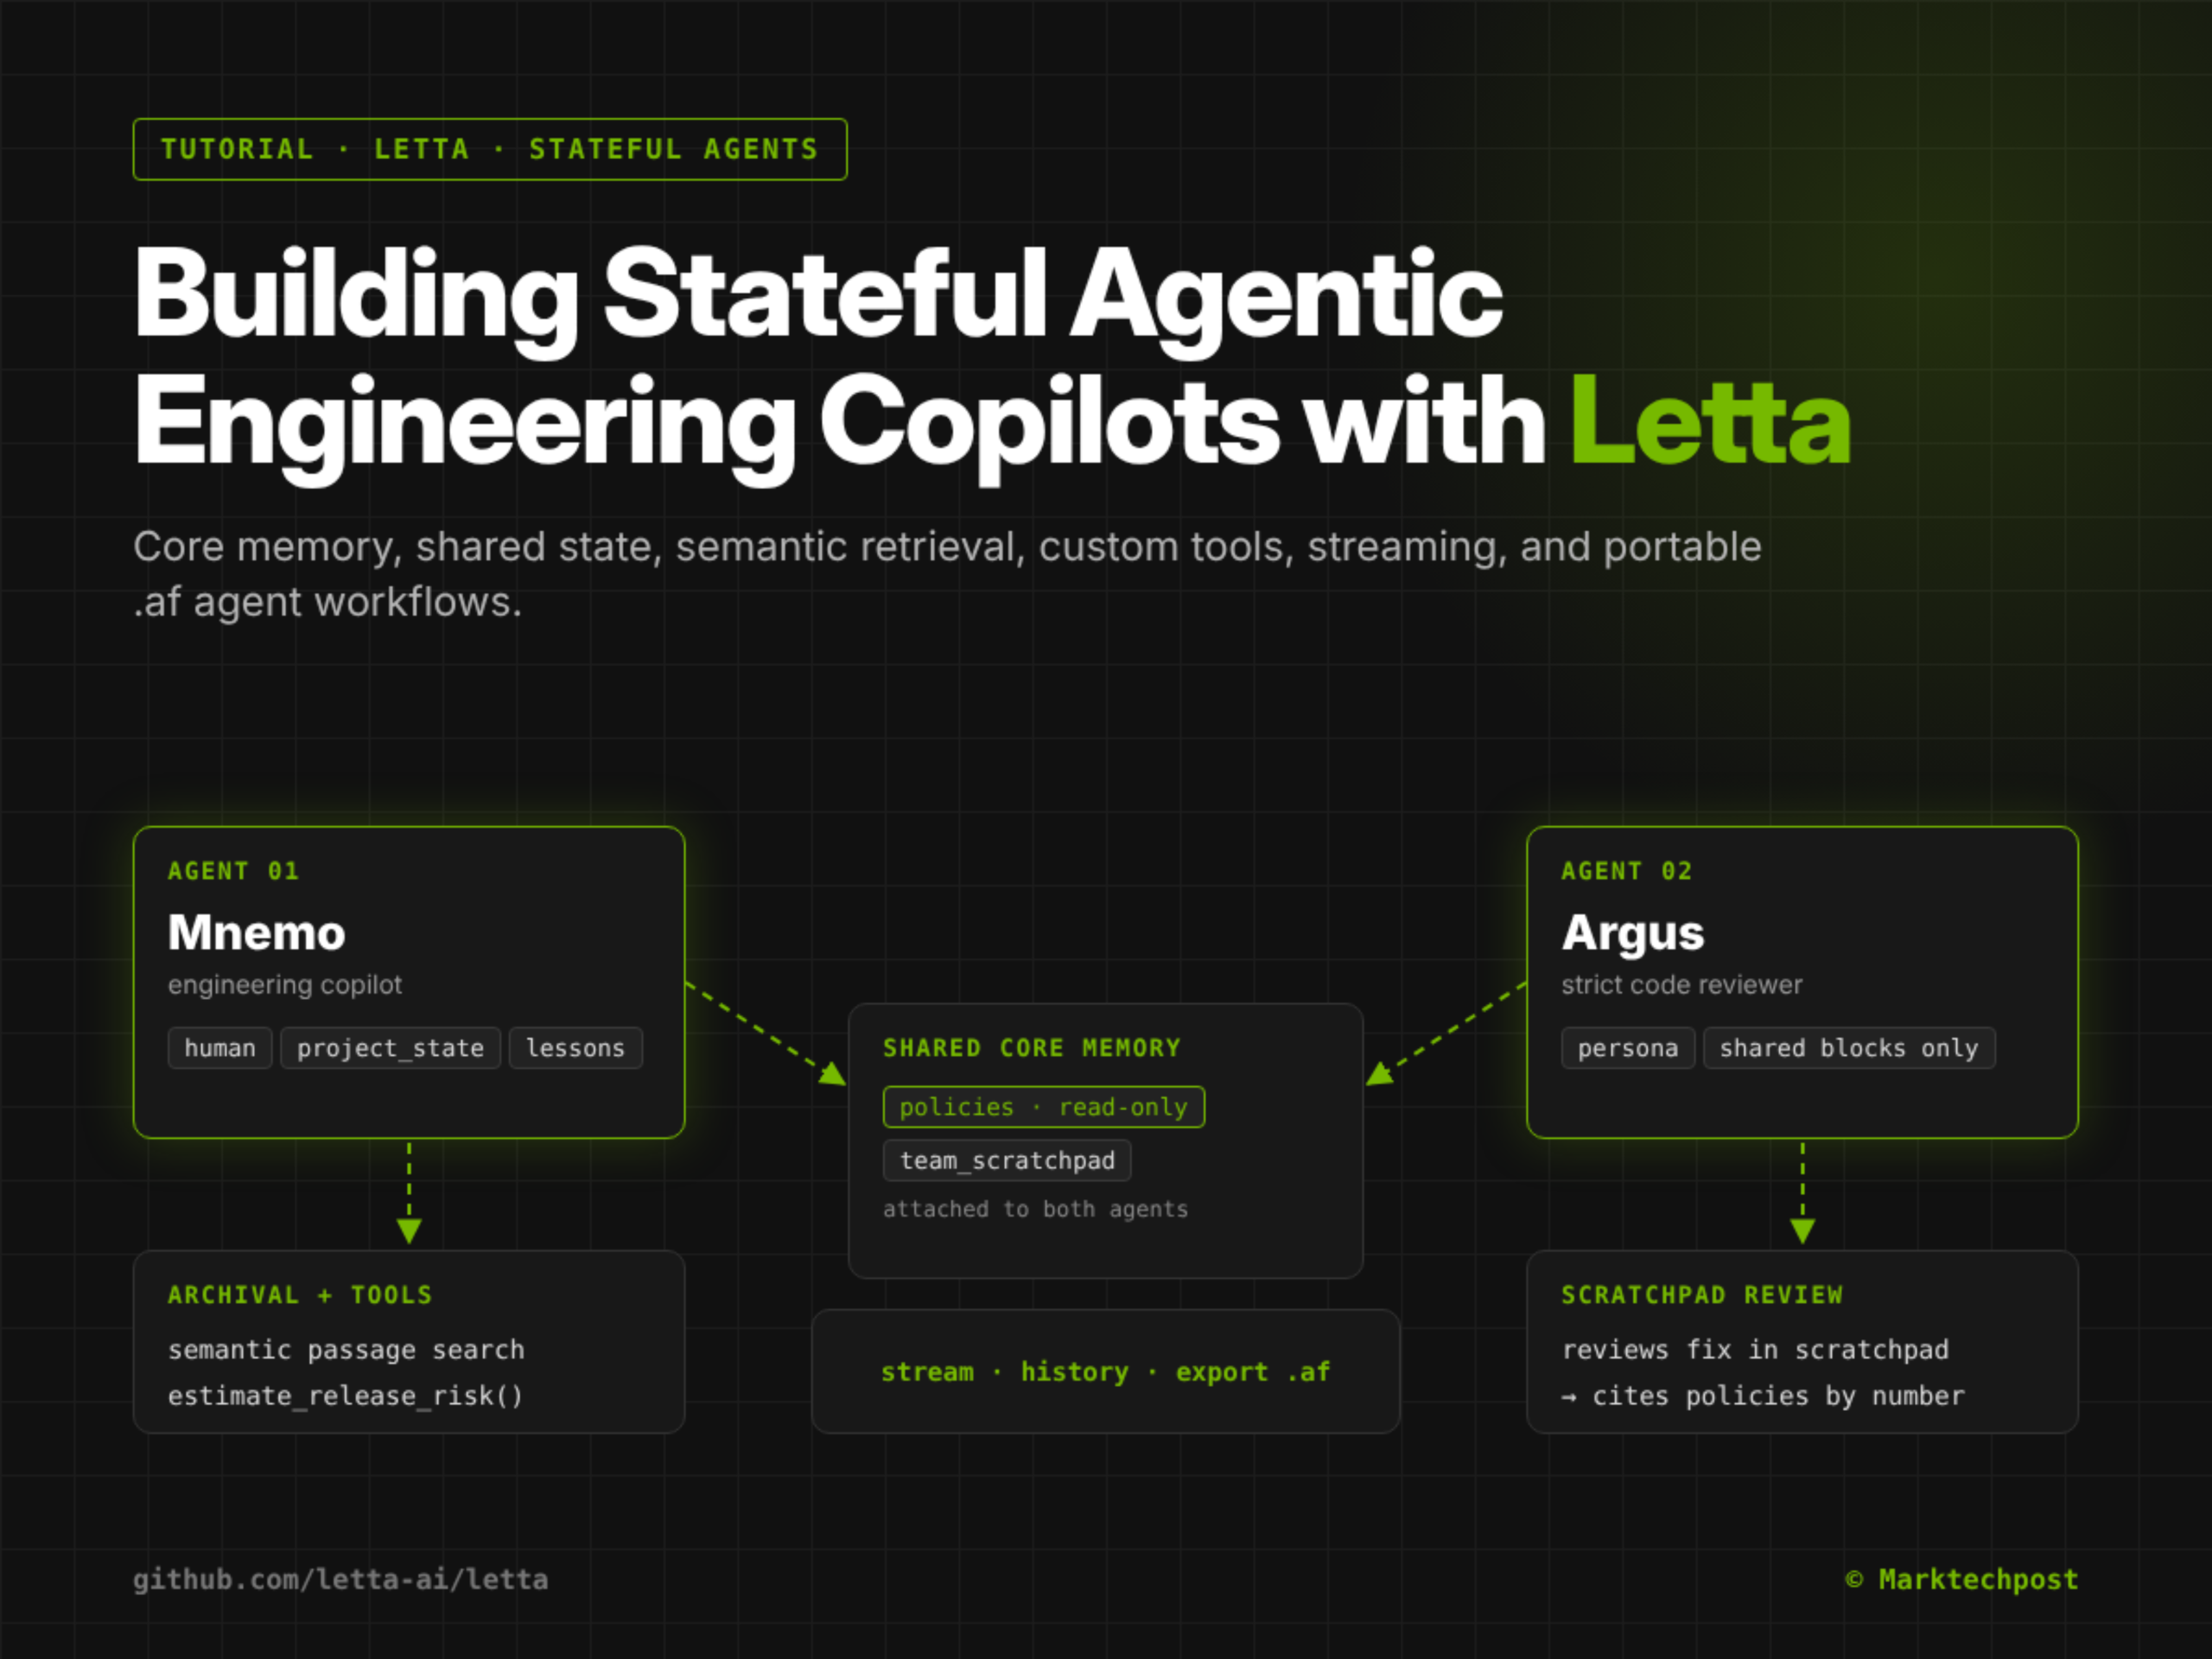
Lettaプラットフォームが、ステートフルなエンジニアリングにおける共同作業者向けの構築チュートリアルを公開:コアメモリ、共有状態、およびポータブルなワークフローをサポート

MarkTechPostは2026年10月24日、Lettaフレームワークを基に永続的状態を備えたエンジニアリング協働者(agentic copilot)を構築する方法を紹介するチュートリアルを公開しました。内容には、検証可能なコアメモリ、マルチエージェント間の共有メモリ、セマンティック検索による知識のアーカイブ、カスタムPythonツールの統合、ストリーミング応答、および .agent形式(.af)でのエクスポートといった機能が含まれます。本稿は技術実践ガイドであり、性能指標やセキュリティ監査、あるいは本番環境での検証については提供されていません。

Stateful Agentic Engineering Copilots with Letta: Core Memory, Shared State, Semantic Retrieval, Custom Tools, Streaming, and Portable Agent Workflows
経緯と関連報道

TRIADが発表:全モーダルな曖昧さ解消に特化した初の多モーダル大規模モデル評価基準

2026年10月24日、研究者はarXivに論文arXiv:2610.30841v1を公開し、テキスト・画像・音声の三モーダルな協調による曖昧さ解消能力を評価するための新たな評価フレームワークであるTRIADベンチマークを正式に発表しました。このベンチマークは、手作業で構築された327件の三モーダルサンプルを含み、86のシナリオグループと18種類の跨モーダルな曖昧さのタイプを網羅しています。

TRIAD: Benchmarking Omni-Modal Ambiguity in Multimodal Large Language Models

注目する理由:この成果は、現在の多モーダル大規模モデル評価における核心的な盲点を直接突いています。すなわち、既存のベンチマークでは、多焦点かつ確定的な入力条件下での知覚や推論にのみ注目しているのに対し、TRIADは初めて「モーダル補完による曖昧さ解消」を評価目標として体系的に設定しました。厳密に設計された留一モーダル反事実テストを通じて、モデルが特に音声に対して十分に活用されていないことや、シーンレベルでのロバスト性が脆弱であるといった重要な欠陥を明らかにし、次世代の全モーダルモデル評価に向けて再現可能な診断プロトコルと分類法を提供しています。

経緯と関連報道

TutorCaseBenchが公開:特別支援教育の場面に特化した初のLLM家庭教師評価ベンチマーク

2026年10月24日、研究者はarXiv(ID 2610.30828v1)にTutorCaseBenchを公開しました。これは、教育学・教育心理学・特別支援教育の実際の事例に基づいて構築された、LLMによる家庭教師評価のベンチマークであり、学習や行動に困難を抱える学生を支援する能力に焦点を当てています。このベンチマークは923件の対話から構成され、5種類の問題行動をカバーしています。評価は、オープンエンド生成(1,560問)と多肢選択式(2,537問)の二軌道で行われます。最先端の11の大規模言語モデルのうち、最も優れたモデルであっても、オープンエンド問題のわずか55.8%においてのみ評価基準を満たしました。

TutorCaseBench: A Case-Grounded Benchmark for Evaluating LLM Tutors in Supporting Students with Challenging Behaviors

注目する理由:本研究は、既存のAIによる教育評価が特殊なニーズを有する学生の行動の複雑性を軽視しているという重要な空白を埋めています。方法論としては、エビデンスの追跡を重視し(定性的事例研究+出典に基づく評価基準)、データはすべてオープンソースで公開されており、再現性と教育実践への関連性を備えています。結果は、現在のLLMが文脈に応じた応答生成において顕著な課題を抱えていることを明確に示しており、教育分野におけるAIの実装に対して警鐘を鳴らすとともに、指針としての価値を有しています。

経緯と関連報道

臨床医主導で検証可能な安全ガイドラインを構築:メンタルヘルスチャットボットに追跡可能なセーフガード層を設ける

2026年10月24日、arXivは論文arXiv:2610.30690v1を公開し、2名の臨床医が主導して定義・最終決定・裁定を行う4つの安全チェックルールベースを提案した。このルールベースは形式的検証を経て、メンタルヘルス領域における大規模言語モデル(LLM)の出力に対してガードレイヤーとして適用される。同ガードレイヤーにおけるすべての判定は、1つの命名規則と16の事実再現に基づいて行えるものであり、安全性判断の説明可能性と検証可能性の向上を目的としている。

From Clinical Judgment to Checkable Rules: Clinician-Led Guardrails for Mental-Health Chatbots

注目する理由:本研究は、主流のプロンプトエンジニアリングやLLM-as-a-Judge、あるいはコンスティチューショナルAIとは異なる、安全性を強化する新たなアプローチを提示している。その核心的な革新点は、臨床意思決定を構造化・形式化し、全過程にわたって記録を残すことにあり、すべての重要な主張(たとえば規則の数、検証手法、事実の基数、対照実験データ、およびコスト測定など)が原文において明示的に述べられており、さらに公開日時(2026年10月24日)が現在のUTC日付(2026年10月25日)と一致しているため、時宜性と信頼性の基盤を備えている。

経緯と関連報道

研究では、自己評価強化学習フレームワークSARLを提案し、検索拡張型大規模モデルの探索状態認識能力を向上させました。

2026年10月24日、arXivは論文arXiv:2610.30435v1を公開し、既存の検索強化型大規模言語モデルにおいて、検索エージェントが検索状態を認識する能力を欠いているという問題を解決することを目的とした、自己評価強化学習(SARL)フレームワークを提案しました。

Self-Assessment Reinforcement Learning for Search-State Awareness in Retrieval-Augmented Large Language Models

注目する理由:本研究は、検索強化型大規模言語モデルが複雑なタスクにおいて、既知または欠落した情報を認識できないことから生じるハルシネーションによる推論や探索の早期終了という重要な課題に対し、テスト時の追加評価を必要としないエンドツーエンドの強化学習手法を提案し、マルチジャンプ推論および深層研究のベンチマークにおいて顕著な性能向上を実現しました。

経緯と関連報道

RIFTは、動的なKVキャッシュ圧縮戦略を提案し、デコードの古さによる問題を緩和して、推測デコードの品質を向上させます。

2026年10月24日、arXivは論文arXiv:2610.31098v1を公開し、RIFT——推測デコードにおけるドラフトモデル(drafter)向けの動的KVキャッシュ圧縮手法——を提案しました。この手法は、事前埋め込み情報と新規生成トークンのバランスを取るとともに、圧縮可能性を考慮した訓練を組み合わせることで、8KトークンのKVキャッシュ予算のもと、Qwen3.5-4BのドラフトモデルがQwen3.5-122Bに対して長文コンテキスト生成を実行する際に、全キャッシュの受け入れ可能な長さを98%超に維持することを可能にします。

RIFT: KV Cache Compression for Draft Models with Complementary Compressibility Training

注目する理由:本研究は、長文出力生成においてKVキャッシュの膨張がもたらすハードウェアコストの増大と精度低下という矛盾に正面から取り組み、『デコードの陳腐化』(decode staleness)現象を初めて明確に定義・定量化するとともに、実装可能な更新メカニズムと学習との協調手法を提案している。実験条件は具体的で(入力32K/出力4K/キャッシュ8K)、得られた結果は工学的な参考価値が高い。出典はarXivのプレプリントであり、公開日時(2026年10月24日)はシステムの現在日付(2026年10月25日)と一致しており、高いタイムリー性を有している。

経緯と関連報道

新たな研究は、言語間貧刺激(CPOS)実験パラダイムを提案し、言語モデルの階層的汎化能力における条件付き移行を明らかにした

2026年10月24日、arXivは論文2610.30960v1を公開し、言語モデルが多言語間の継続的学習において、源言語(L1)の階層構造に関する証拠を目標言語(L2)へ移行する能力を定量化するための、跨言語貧刺激(CPOS)実験デザインを提案した。実験の結果、この移行は部分的には成立するものの完全ではなく、しかも言語ペアおよび語彙の重複度に大きく依存することが示された。

Once a Tree, Always a Tree? Cross-lingual Transfer of Hierarchical Generalization in Language Models

注目する理由:本研究は、制御可能な言語間の貧刺激フレームワークを初めて構築し、『言語の普遍的構造』が非言語的要因(例えば位置エンコーディングの初期化など)のみによって駆動されるのではなく、言語間移行の認知的基盤を形成しているかどうかを直接検証した。その結論は、大規模言語モデルにおける文法習得メカニズムおよび多言語間のアライメント戦略を理解するうえで、方法論的・理論的な両面において重要な価値を有している。

経緯と関連報道

新たな研究でReflectPOフレームワークが提案され、大規模言語モデルエージェントの長期間タスクにおける自律的誤り訂正能力が向上しました

2026年10月24日、arXivは「ReflectPO:長周期LLMエージェント向けの反省誘導型戦略最適化」と題する研究論文(ID 2610.30933v1)を公開し、ツール強化型大規模言語モデルエージェントが複雑で多段階かつ状態依存型のタスクにおいて自律的に誤りを回復する能力を向上させるための、ReflectPOと名付けられた強化学習フレームワークを提案した。

ReflectPO: Reflection-Guided Policy Optimization for Long-Horizon LLM Agents

注目する理由:本論文は、最近発表された最先端のAI研究であり、現在のLLMエージェントの実用化における重要な課題である、長期間にわたるタスクにおける初期段階での誤りの累積効果に焦点を当てています。著者が提案する「Reflection-Guided Sampling」と「Tree-Structured Credit Assignment」の二重構成による設計は、方法論的に革新的であり、二つのツール利用ベンチマークにおいて複数のベースラインを実証的に上回っており、技術的な参考価値を有しています。

経緯と関連報道

新たな研究により、オープンブックの評価は主に読書行動を測定するものであり、知識の蓄積を測るものではないことが明らかになった

2026年10月24日に公開されたarXiv論文(2610.31017v1)は、文書レベルのLoRAアダプター評価において、オープンブックスコアリングはアダプターが対象文書の知識を実際に符号化しているかどうかよりも、モデルの即時読解能力に強く依存していることを示していると指摘している。ランダムなアダプターは、オープンブックタスクにおいて専門家向けアダプターの優位性の82%を再現できるが、ソーステキストを持たないクローズタスクではわずか2%しか再現できず、統計的にゼロと区別できないという結果となった。

Mostly Reading: What Open-Book Scores Measure in Document-Level LoRA Adapters

注目する理由:本研究は、系統的な制御実験(Wikipedia記事150件、Llama-3.1-8B-Instructモデル、二重タスク比較)を通じて、現在のオープン書評価パラダイムの根本的な限界を明らかにした。すなわち、この手法では「読むこと」と「記憶すること」を効果的に区別できず、知識編集型および検索型アダプターの実際の有用性に対して方法論上の課題をもたらしている。さらに、論文では「一見きれいだが誤った結果」を招く静かなエラーが4つ報告されており、再現性に関するリスクが浮き彫りになっている。

経緯と関連報道

研究によると、語の長さは普通話の同音異義語の識別を直接示唆することが明らかになった。arXivの新論文が、語頻と発音時間の認知的関連性を解明した

2026年10月24日、arXivは「語長による直接的なプロンプトのアイデンティティ:標準中国語の同音異義語からの証拠」と題する新論文(arXiv:2610.30682v1)を公開し、実験結果として、他の音声的手がかりが欠如している場合や高ノイズ環境下においても、標準中国語の母語話者は二音節の同音異義語間の発音時間の差に基づいてその語頻度の高低を判断できることを報告した。短い発音は高頻度語として認識される傾向があり、語長は音声の細部として心理辞書に記憶され、口頭での単語認識に寄与している可能性が示唆されている。

Direct cueing of word identity through word duration: evidence from Mandarin homophones

注目する理由:本研究は、中国語に豊富に存在する二音節同音語を切り口として、同音語の並び替え課題を用い、語頻度変数を統制したうえで、厳格な聴覚条件下において語長の機能的役割を検証した。その結果は、「語頻度効果」に関する言語間比較による音声実現メカニズムの新たな証拠を提供するとともに、語長は副言語的現象にすぎないという従来の見解に異を唱えるものであり、心理言語学および言語知覚理論の両面において重要な意義を有している。

経緯と関連報道