본문으로 건너뛰기
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI 뉴스 검색

제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.

발행 시간순

2026년 가장 주목받는 AI 웨어러블 기기 종합: Bee, Friend, Limitless 등 10여 종의 신제품이 한자리에 공개

테크크런치는 2026년 10월 25일, Bee, Friend, Limitless, Muse Charm, Nirva, Omi, Plaud NotePin, Rabbit R1, Stream 링 등 10여 종의 AI 웨어러블 기기를 종합한 리뷰를 발표하며, 가격, 기능 포지셔닝, 출시 상태 및 개인정보 관련 논란을 다뤘다.

The hottest AI wearables and gadgets you should know about

추천 이유:이 보도는 권위 있는 기술 매체인 TechCrunch가 2026년 10월 25일에 발표한 연례 신제품 종합 리뷰로, 현재 주요 AI 하드웨어 제조사와 스타트업을 포괄하며, 가격, 형태, 핵심 기능, 출시 일정, 논란 등 정보의 측면에서 완전성을 갖추고 있습니다. 또한 모든 진술은 자료에 명시된 사실에 근거한 것이며, 추측이나 확대 해석은 포함되지 않습니다.
진행 상황 및 관련 보도

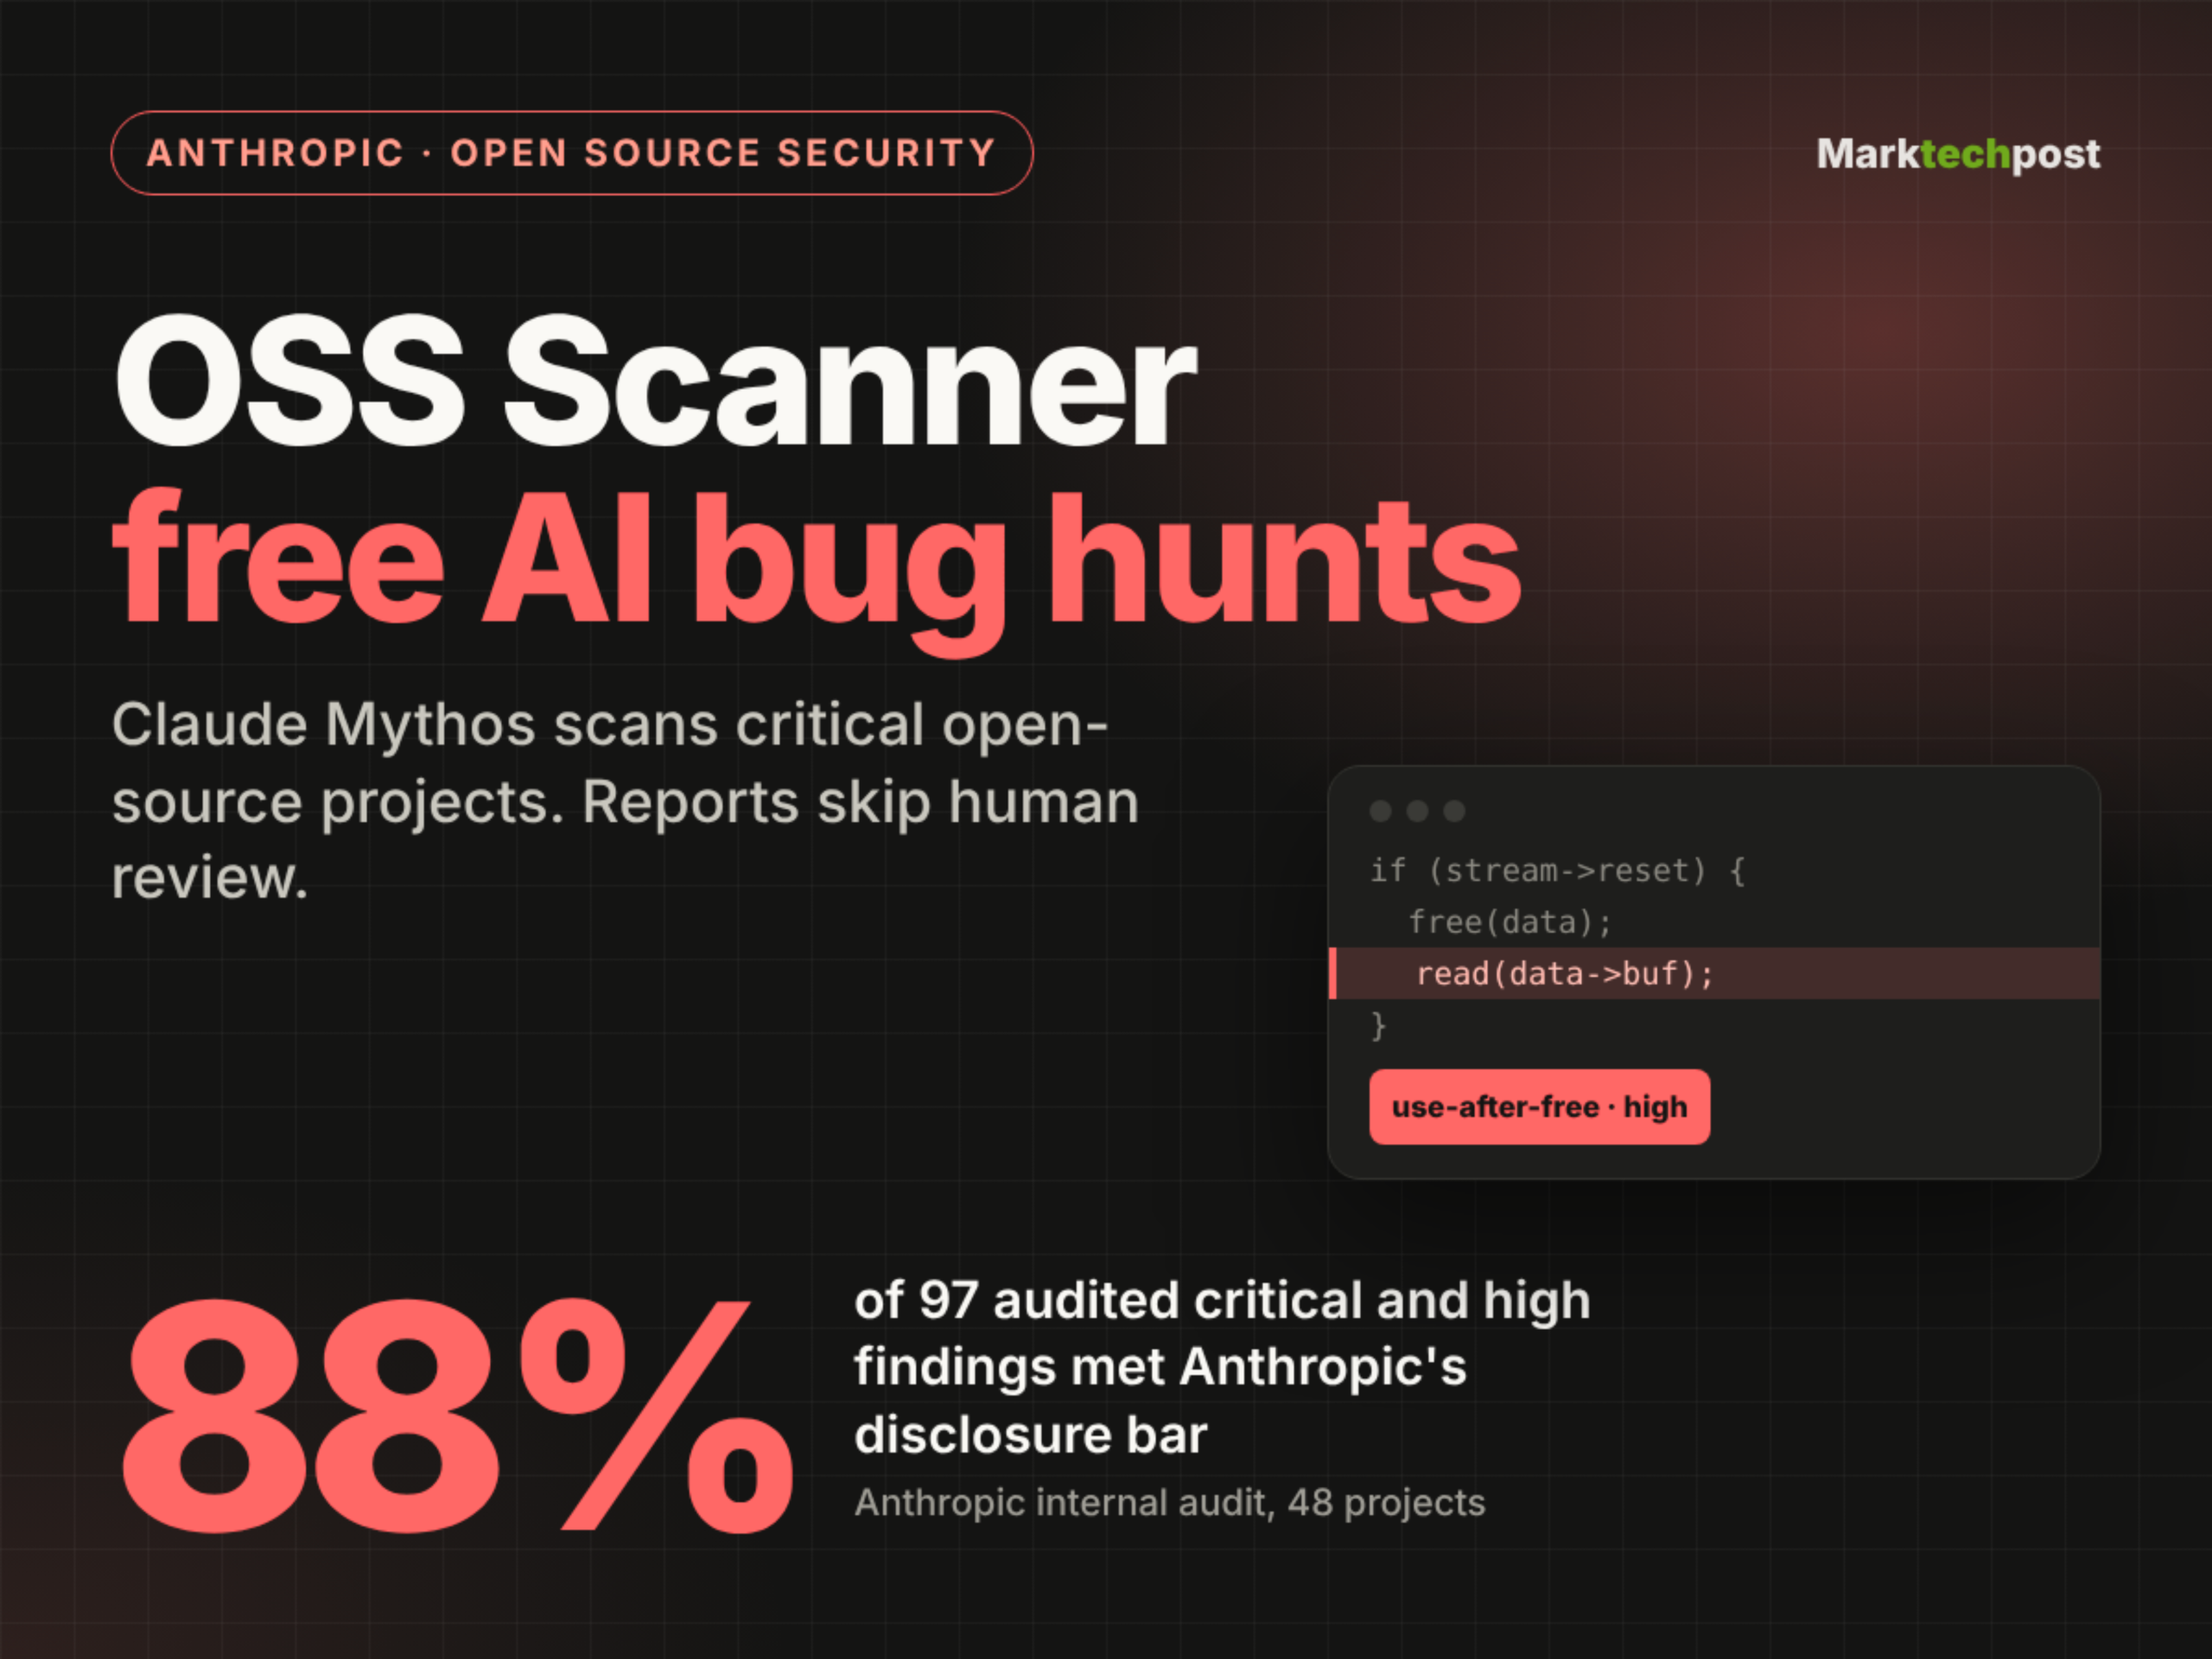
Anthropic이 주요 오픈소스 프로젝트를 대상으로 하는 무료 AI 취약점 스캐너 OSS Scanner를 출시했습니다.

Anthropic은 2026년 10월 8일, Claude Mythos 등 강력한 모델을 기반으로 한 무료이며 선택적 가입형 AI 취약점 스캐너인 OSS Scanner를 출시했으며, 이는 핵심 오픈소스 프로젝트를 위해 특별히 설계되었습니다. 10월 19일 현재, 총 114개의 프로젝트가 접수되었고, 11일 만에 심각 등급 취약점 77건과 고위험 등급 취약점 803건(모델 평가 기준)이 보고되었으며, 표본 검사 결과의 88%가 자사의 공개 기준을 충족했습니다.

Anthropic Launches OSS Scanner, a Free AI Vulnerability Scanner

추천 이유:이 도구는 오픈소스 보안 분야에서 LLM의 대규모 적용 사례를 대표하며, 무비용·전자동·오프라인 감사를 특징으로 하지만, 인력 검토 단계를 생략함으로써 오보와 중복 문제 발생 위험을 초래합니다. 그 정확도 데이터(유효율 88%, 거짓양성률 1%)와 실제 프로젝트 피드백(예: wolfSSL, curl)은 현재 AI 기반 취약점 탐지 능력에 대한 실증적 기준을 제공합니다.

진행 상황 및 관련 보도

Kimi, K3.1 Pro 출시: 엔드포인트 작업 능력이 최고 수준으로 도약했으며, 시뮬레이션 디버깅과 다중 모달 프로그래밍을 통해 몸을 가진 지능의 초기 모습을 보여줍니다

Kimi는 2026년 10월 25일 K3.1 Pro 모델을 출시했으며, Terminal-Bench 4.0 터미널 작업 테스트에서 67.2%의 성공률로 1위를 차지했습니다. 또한 자체적으로 에뮬레이터 오류를 복구하고 물리 시뮬레이션, 오디오 분석, 3D 장면 구축 및 영상 편집 등 다중 작업을 수행하는 능력을 갖추고 있어, 신체 기반 지능 기술의 발전 경로를 탐구하고 있음을 보여줍니다.

根据报道中的虚拟人行走训练和模拟器调试制作的编辑示意,非软件实拍截图

추천 이유:본 자료는 티미디어의 공식 라이선스를 받아 발표된 실측 보고서를 기반으로 하며, Artificial Analysis, Terminal-Bench 4.0 등 권위 있는 제3자 평가 데이터와 공식 자체 테스트 결과, 그리고 필자의 다중 시나리오 기능 검증을 포괄합니다. 특히 K3.1 Pro의 실행 성능, 시뮬레이션 클로즈드 루프, 다중 모달 프로그래밍 분야에서의 실질적 진전에 초점을 맞추고 있으며, 동시에 Flash/Ultra가 아직 출시되지 않았다는 점 등 성능상의 한계와 미공개 정보를 명확히 표기하여 사실 확인과 출처 표기 요건을 준수하고 있습니다.

진행 상황 및 관련 보도

패널 제조사들이 AI로 인한 상류 원자재 비용 압박에 대응하기 위해 일제히 가격을 인상했지만, 하류 수요처의 수용도가 낮고 최종 제품의 품질 관리에도 부담이 가중되고 있다.

2026년 9월부터 TCL 화싱, BOE, 혜커 등 패널 제조사들이 잇따라 가격 인상 공지를 발표했는데, 주요 원인은 AI 대규모 모델의 발전으로 HBM 수요가 급증하면서 기성 공정 칩의 생산 용량을 압도하고, 드라이버 IC, PCB, 유리 기판 등 핵심 소재의 가격을 상승시켰기 때문이다. 코닝 등 상류 공급업체들도 동시에 가격을 인상했다. 비용 부담이 분명히 존재함에도 불구하고, 하위 단계의 TV·디스플레이 브랜드들의 구매 가격은 아직 전반적으로 오르지 않았으며, 최종 사용자들 사이에서는 과열, 블랙 스폿 등 품질 관리 관련 문제가 빈번히 발생해, 가격 인상이 실제 거래와 체험 개선으로 이어지지는 못한 상황이다.

AI大模型狂飙,面板行业也扛不住了

추천 이유:재료 시스템은 AI 산업이 직접적으로 연관되지 않은 하드웨어 업계에 미치는 크로스체인 전파 메커니즘을 규명한다—AI가 패널 수요를 직접적으로 견인하는 것이 아니라, 웨이퍼 생산능력의 재배분을 통해 전 체인에 걸친 비용 재정립을 촉발한다는 점이다. 동시에 가격 인상 행태와 시장의 실제 반응(가격 정체, 출하량 감소, 사용자 불만) 간의 뚜렷한 괴리를 보여주며, 이는 산업의 협상력과 제품 경쟁력 간의 불일치라는 근본적인 모순을 부각한다.

진행 상황 및 관련 보도

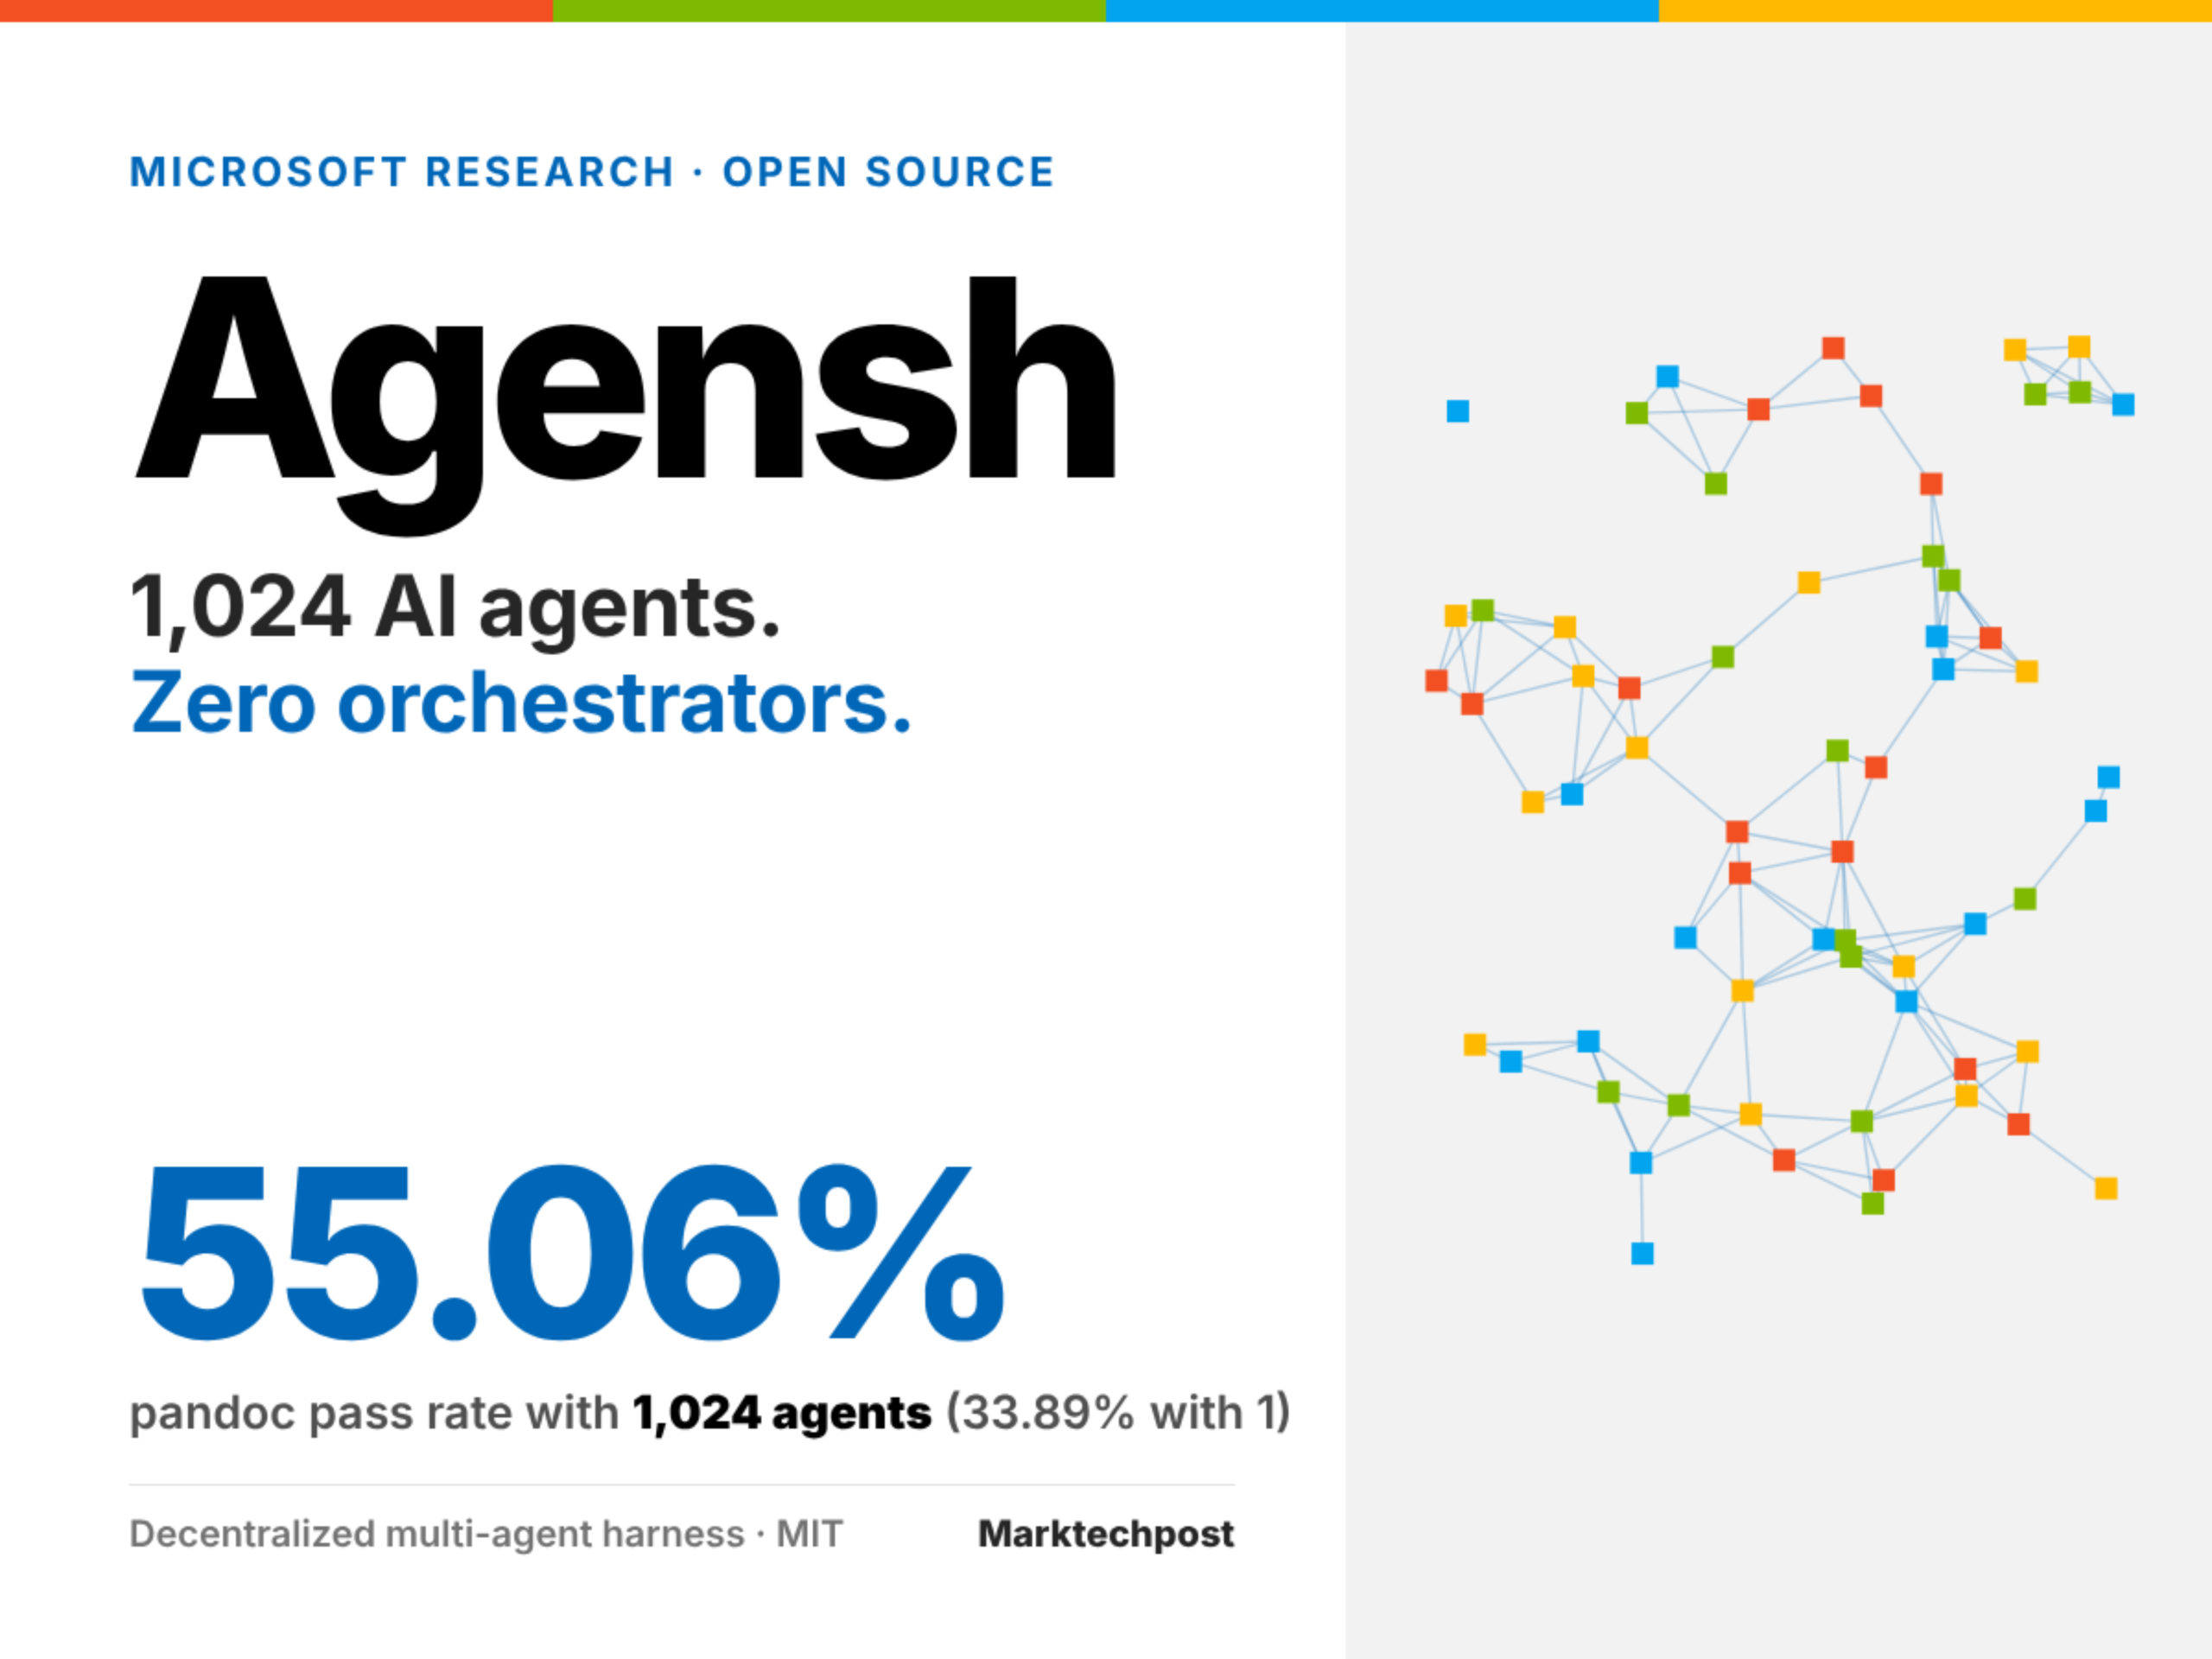
마이크로소프트가 Agensh를 오픈소스로 공개: 1024개의 자율 협업 AI 코딩 에이전트를 지원하는 분산형 프레임워크

마이크로소프트 연구소는 2026년 10월 25일, 중앙 조정자를 필요로 하지 않는 다중 에이전트 런타임 프레임워크인 Agensh를 오픈소스로 공개했습니다. 이 프레임워크는 ProgramBench에서 1개부터 1,024개까지의 LLM 기반 코딩 에이전트가 자율적으로 협업하도록 지원합니다. 시스템은 Gitea, Mattermost 및 DeLM 스타일의 공유 보드를 기반으로 탈중앙화된 조정을 구현하며, 모든 에이전트는 동일한 프롬프트 기반 5단계 순환을 실행합니다. 또한 Linux와 Docker 환경에서 확장성을 검증했습니다.

Microsoft Open-Sources Agensh: A Multi-Agent Harness for 1,024 Agents

추천 이유:이 성과는 다중 에이전트 시스템 아키텍처의 중요한 발전을 나타냅니다—전통적인 ‘주제어 에이전트’ 패러다임을 탈피하고, 프롬프트 엔지니어링과 경량 서비스의 조합을 통해 대규모 자조직화를 구현합니다. ProgramBench에서 확보한 실증 데이터(예: 128개의 에이전트를 사용할 때 5개의 작업에 대한 평균 성능 향상이 49%에 달함)는 분산형 AI 엔지니어링의 새로운 기준점을 제시합니다. MIT 라이선스로 오픈소스화되어 있으며 Copilot CLI 등 주요 단일 에이전트 도구와도 호환되므로, 실제 개발에서의 참고 가치를 갖습니다.

진행 상황 및 관련 보도

엔비디아를 앞세워 애플에 정면으로 맞서는, 마이크로소프트의 고급 AI PC 승부

마이크로소프트는 NVIDIA RTX 스파크를 탑재한 서피스 랩톱 울트라로 로컬 AI 개발자와 고급 크리에이터를 공략하고 있다. 하드웨어는 대용량 통합 메모리, CUDA 및 RTX 그래픽 성능을 휴대형 기기에 도입했지만, 맥과의 지속적인 경쟁을 이끌어낼 수 있을지는 여전히 애플리케이션 호환성, 인공지능 에이전트 경험, 실제 워크플로우에 달려 있다.

추천 이유:이 경쟁이 궁극적으로 답해야 할 질문은, 로컬 AI가 창작과 개발의 효율성을 실질적으로 향상시킬 수 있는지와, 이를 위해 사용자가 부담하는 하드웨어·소프트웨어 및 이전 비용이 과연 그만한 가치가 있는지 여부입니다. 하드웨어는 새로운 가능성을 제공하지만, 이러한 가능성이 얼마나 많은 사용자에게까지 확장될 수 있는지는 생태계와 실제 사용 경험에 달려 있습니다.

진행 상황 및 관련 보도

애플의 첫 번째 폴더블 iPhone 듀오가 판매 시작과 동시에 집중적인 화면 균열 문제가 발생했다.

여러 사용자가 애플의 첫 번째 폴더블 스마트폰인 iPhone Duo를 개봉한 직후, 힌지 바로 위쪽 화면에서 금이 가거나 파손되는 문제가 짧은 시간 내에 발생했다고 보고했으며, 해당 결함이 매우 집중적으로 나타나고 있습니다. 호주와 중국에서도 유사 사례가 보고되어, 이는 힌지 조립 시 공차 문제로 인한 것으로 추정됩니다. 애플 측은 아직 공식 입장을 밝히지 않았으며, AS 처리 결과에 따라 무상 교체 여부 또는 고액의 자비 수리 여부가 결정될 예정입니다.

추천 이유:이 사건은 신형 제품의 대규모 초기 품질 이상과 관련되어 있어 소비자의 권익과 기업의 책임 경계를 정면으로 부딪히고 있으며, 여기에 3包 규정의 적용 여부와 AppleCare+ 서비스의 정체성 등 공공적 쟁점까지 겹쳐 전형적인 경고적 의미와 권리 보호의 참고 가치를 지니고 있다.

진행 상황 및 관련 보도

llama.cpp 发布 b11867 版本:服务端入口重构,全面支持多平台与异构加速后端

llama.cpp 于 GitHub 正式发布 b11867 版本,核心变更包括服务端(server)入口点重构(PR #31113),新增 server_role 机制;同时提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的 40+ 预编译二进制包,支持 CPU、CUDA(12.4/12.8/13.4)、Vulkan、ROCm 10.0、OpenVINO、SYCL(FP16/FP32)、Snapdragon(Adreno+Hexagon)等多元硬件后端。

추천 이유:按信源设置仅收录,不参与自动精选

진행 상황 및 관련 보도

세바스티안 라슈카가 8개의 비디오 강좌 ‘제로부터 추론 모델 구축하기’를 발표했습니다.

세바스티안 라슈카는 2026년 10월 24일, Ahead of AI 매거진(magazine.sebastianraschka.com)에서 총 8강으로 구성된 11시간이 넘는 파이썬 및 파이토치 실습 동영상 강좌를 공개했으며, 추론 모델의 평가, 추론 시 확장, 강화학습(RLVR)과 지식 증류를 체계적으로 다루고, 모든 방법을 사전 훈련된 Qwen3-0.6B 모델을 기반으로 구현했습니다.

추천 이유:이 강좌는 저자가 ‘0부터 구축하는 대규모 언어 모델’에 이어 선보이는 심화 기술 교육 콘텐츠로, 현재 주류 LLM의 핵심 발전 방향인 추론 능력 강화에 초점을 맞추고 있습니다. 기초 환경 구축부터 GRPO 강화학습, 자기 증류 등까지 포괄하는 완전한 기술 체인을 다루며, 모든 구현은 ‘0부터 수작업으로 작성’되어 재현 가능하다는 점을 명시하고 있어 높은 교육적 가치와 엔지니어링 참고 가치를 갖습니다.

진행 상황 및 관련 보도

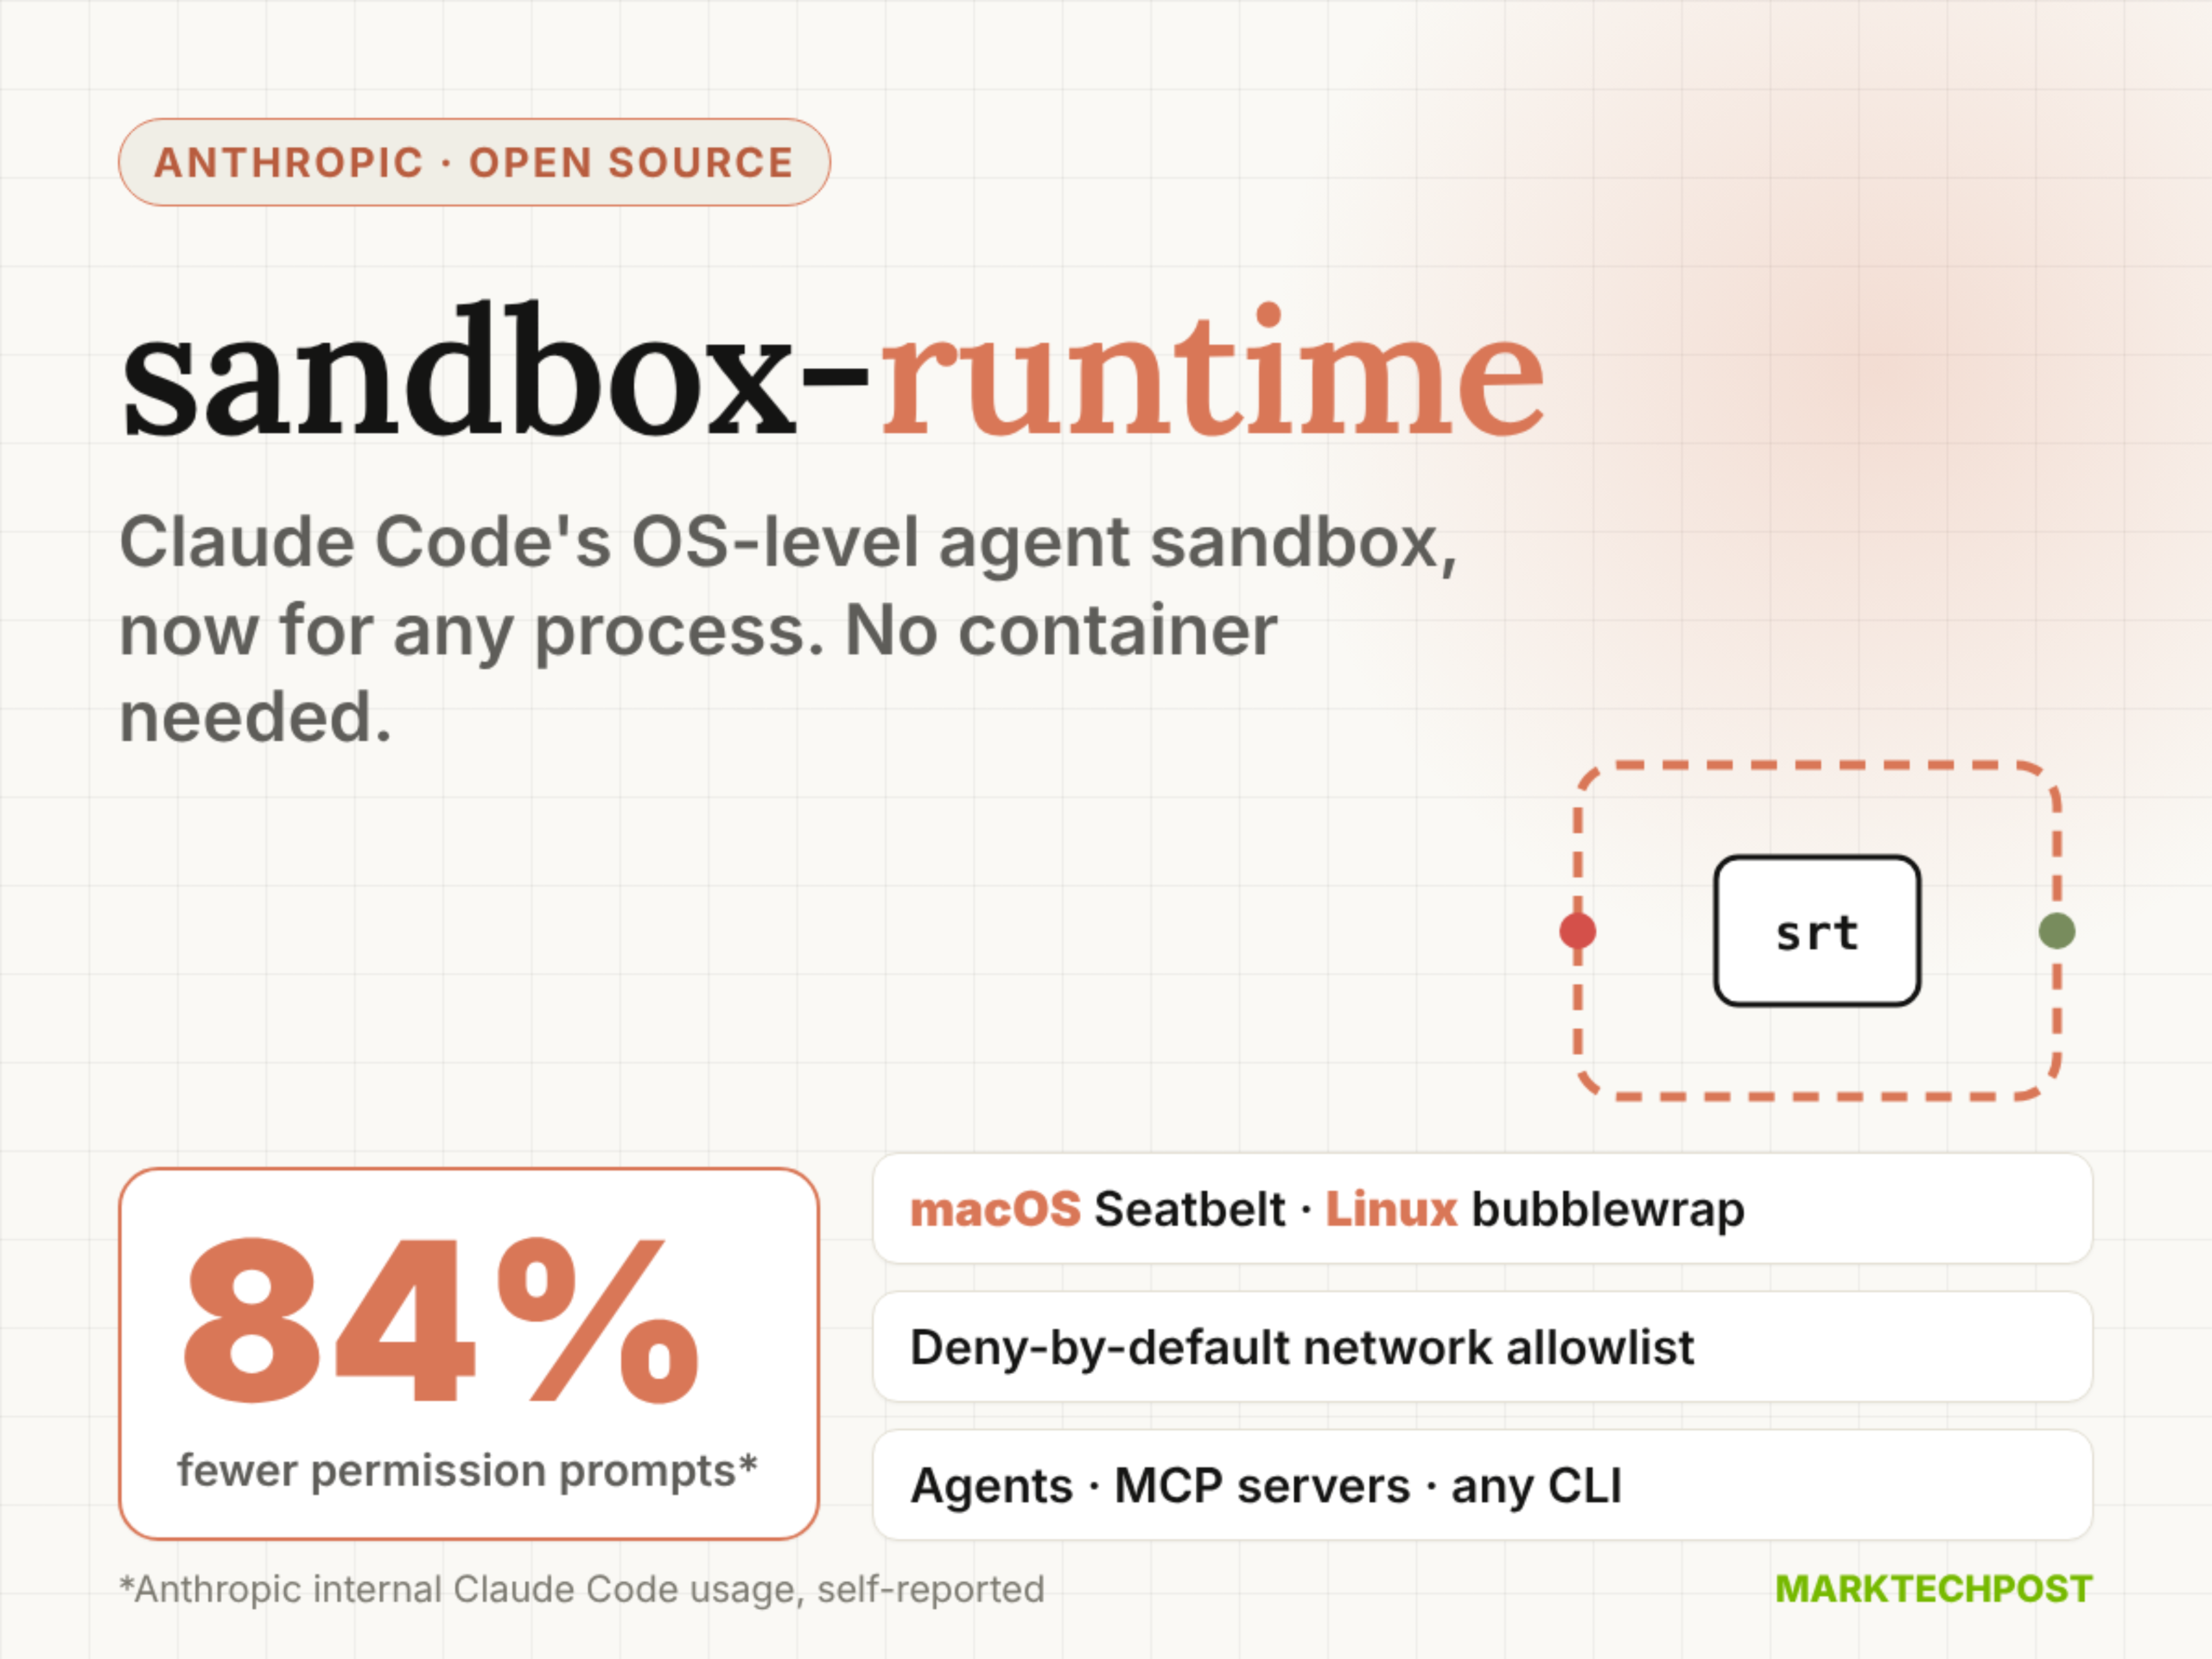
Anthropic의 오픈소스 OS 수준 샌드박스 sandbox-runtime: AI 에이전트에게 컨테이너 없는 파일 및 네트워크 격리를 제공합니다

Anthropic은 2026년 10월 24일에 컨테이너에 의존하지 않는 OS 수준의 샌드박스 도구인 sandbox-runtime(srt)을 오픈소스로 공개했으며, 이는 AI 에이전트, MCP 서버 및 CLI 도구의 파일 읽기·쓰기와 네트워크 접근 권한을 제한하는 데 사용됩니다. macOS(Seatbelt), Linux(bubblewrap) 및 Windows(alpha)를 지원하며, npm 패키지 버전 v0.0.81이고 Apache-2.0 라이선스를 적용합니다.

Meet Anthropic’s sandbox-runtime: OS-Level Sandboxing for AI Agents, No Containers

추천 이유:이 도구는 AI 보안 인프라의 중요한 발전을 의미합니다—운영체제의 기본 제공 격리 메커니즘을 통해 세분화된 수준의 프로세스 트리 전면 커버리지 샌드박스 제어를 구현함으로써, 프롬프트 주입 및 권한 남용 위험에 직접 대응하며, 이미 Claude Code 내부에서 사용되어 그 효과가 검증되었습니다.

진행 상황 및 관련 보도

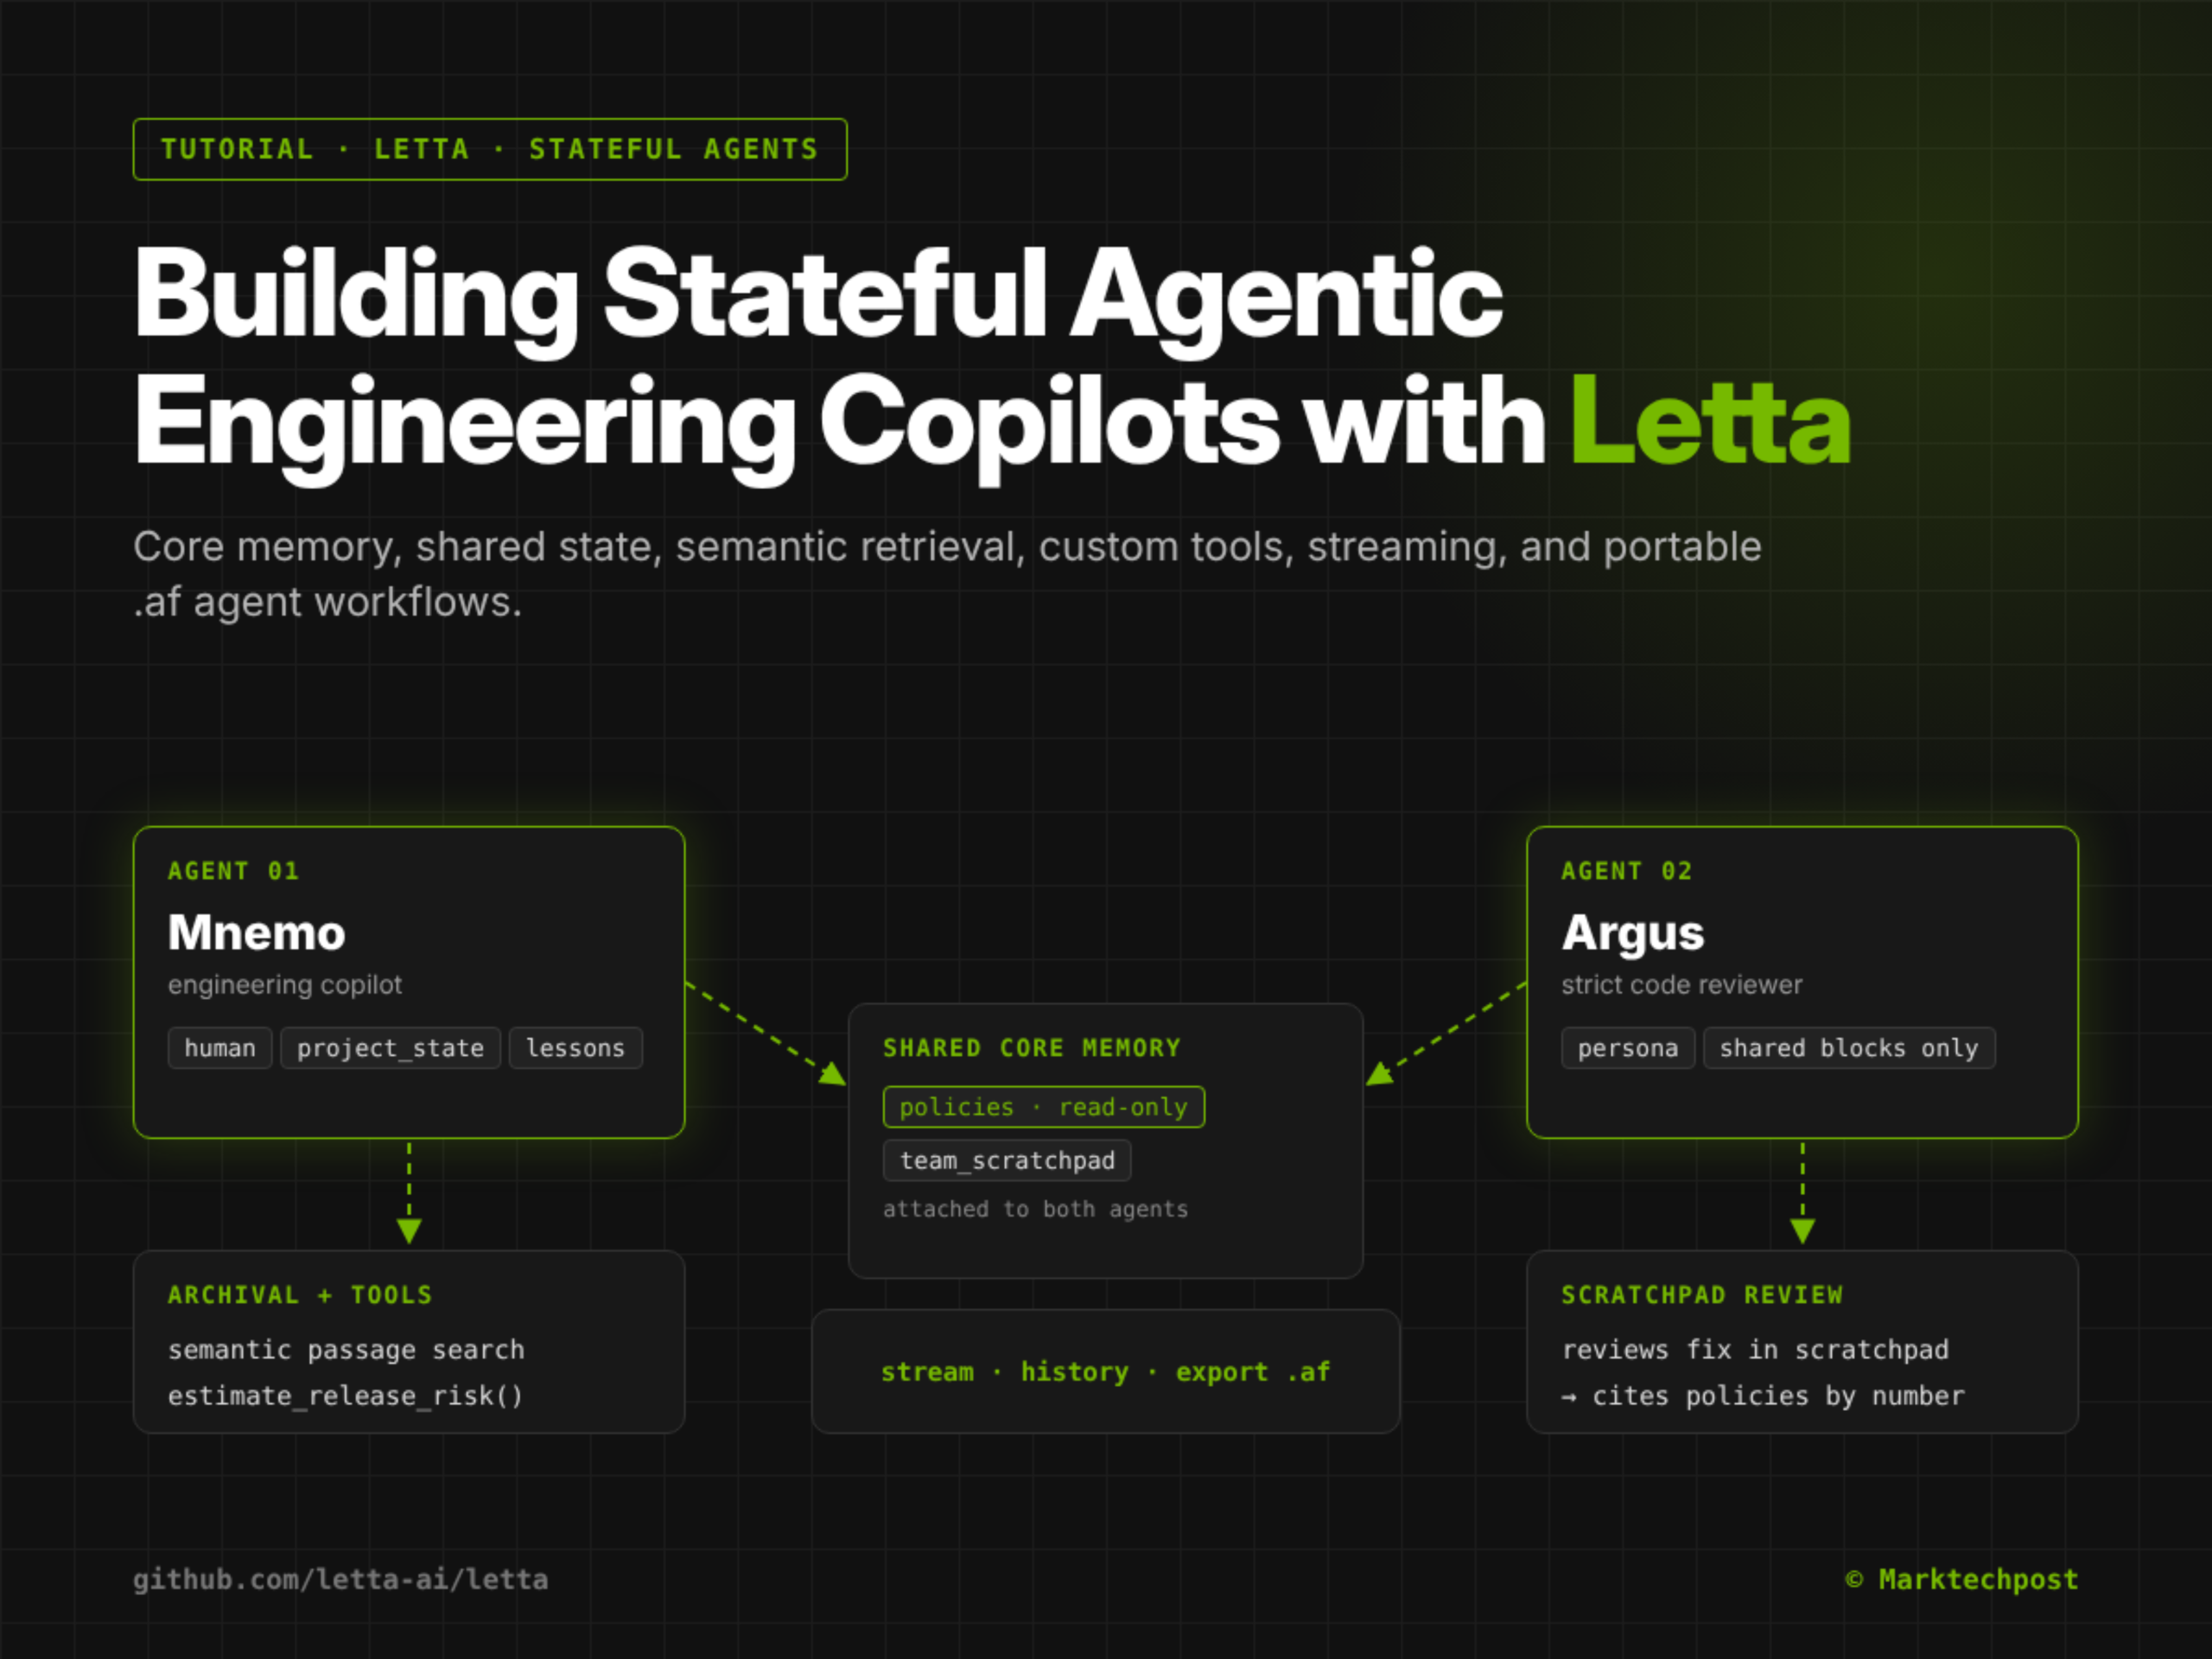
Letta 플랫폼에서 상태 기반 엔지니어링 협업자 구축 튜토리얼을 공개했습니다: 핵심 메모리, 공유 상태 및 이식 가능한 워크플로우를 지원합니다.

MarkTechPost는 2026년 10월 24일, Letta 프레임워크를 기반으로 지속적 상태를 갖춘 엔지니어링 협업자(agentic copilot)를 구축하는 방법을 소개하는 튜토리얼을 발표했습니다. 이 튜토리얼은 검증 가능한 핵심 메모리, 다중 에이전트 간 공유 메모리, 의미 기반 검색을 통한 지식 아카이브, 맞춤형 Python 도구 통합, 스트리밍 응답 및 .agent 형식(.af) 내보내기 등의 기능을 포괄합니다. 해당 내용은 기술 실무 가이드로, 성능 지표, 보안 감사 또는 생산 환경에서의 검증은 제공되지 않습니다.

Stateful Agentic Engineering Copilots with Letta: Core Memory, Shared State, Semantic Retrieval, Custom Tools, Streaming, and Portable Agent Workflows
진행 상황 및 관련 보도

TRIAD 발표: 전모달 모호성 해소를 위한 최초의 다중모달 대규모 모델 평가 벤치마크

2026년 10월 24일, 연구자들은 arXiv에 논문 arXiv:2610.30841v1을 발표하여, 텍스트·이미지·오디오의 삼모달 협력적 모호성 해소 능력을 평가하기 위한 새로운 벤치마크인 TRIAD를 공식적으로 출시했습니다. 이 벤치마크는 327개의 수작업으로 구성된 삼모달 샘플을 포함하며, 86개의 시나리오 그룹과 18종의 교차모달 모호성 유형을 포괄합니다.

TRIAD: Benchmarking Omni-Modal Ambiguity in Multimodal Large Language Models

추천 이유:이 성과는 현재 다중모달 대규모 모델 평가의 핵심적 맹점을 정면으로 지적한다. 기존 벤치마크는 대부분 단일한 확정적 입력에 초점을 맞추어 인지 또는 추론을 평가해 왔으나, TRIAD는 최초로 ‘모달 상호보완에 의한 오류 해소’를 평가 목표로 체계적으로 접근했다. 엄격히 설계된 ‘남은 하나의 모달’ 반사실 시험을 통해, 특히 음성 데이터에 대한 모델의 활용 부족과 장면 수준에서의 취약한 로버스트성 등 핵심적인 결함을 드러내며, 차세대 전모달 모델 평가를 위한 재현 가능한 진단 프로토콜과 분류법을 제공한다.

진행 상황 및 관련 보도

TutorCaseBench 발표: 특수교육 환경을 위한 최초의 LLM 과외 평가 벤치마크

2026년 10월 24일, 연구자들은 arXiv(번호 2610.30828v1)에 TutorCaseBench를 발표했습니다. 이는 교육학, 교육심리학 및 특수교육의 실제 사례를 바탕으로 구축된 LLM 가정교사 평가 벤치마크로, 학습 및 행동상 어려움을 겪는 학생들을 지원하는 능력에 중점을 두고 있습니다. 해당 벤치마크는 총 923개의 대화 문단을 포함하며, 5가지 유형의 도전적 행동을 포괄합니다. 또한 개방형 생성 문제(1,560문제)와 객관식 다중선택 문제(2,537문제)를 결합한 이중 트랙 평가 방식을 채택하고 있습니다. 11개의 최첨단 대규모 모델 중 가장 우수한 성과를 보인 모델조차 개방형 문제의 55.8%에서만 평가 기준을 충족했습니다.

TutorCaseBench: A Case-Grounded Benchmark for Evaluating LLM Tutors in Supporting Students with Challenging Behaviors

추천 이유:이 연구는 기존 AI 교육 평가가 특수 필요 학생의 행동 복잡성을 간과해 온 중요한 공백을 메우며, 방법론적으로는 증거 추적성(질적 사례 연구 + 출처 기반 평가 척도)을 강조하고, 데이터를 전면 오픈 소스로 제공하여 재현 가능성과 교육 실무와의 관련성을 확보했습니다. 연구 결과는 현재 LLM이 맥락에 맞는 응답 생성에서 상당한 한계를 보이고 있음을 명확히 드러내며, 교육용 AI의 실제 적용에 있어 경고와 지침으로서의 가치를 지닙니다.

진행 상황 및 관련 보도

임상의사 주도로 검증 가능한 안전 수칙 구축: 정신건강 챗봇을 위한 추적 가능한 보호 계층 설정

2026년 10월 24일, arXiv는 논문 arXiv:2610.30690v1을 발표하여, 두 명의 임상의사가 주도적으로 정의하고 최종 확정하며 판단을 내리는 네 가지 안전 검사 규칙 집합을 제안하였다. 이 규칙 집합은 형식적 검증을 거친 뒤, 정신건강 분야에서 사용되는 대규모 언어모델(LLM)의 출력에 대한 보호 계층으로 적용된다. 해당 보호 계층의 모든 판단은 하나의 명명 규칙과 열여섯 개의 사실 재현으로 구성되며, 이를 통해 안전성 판단의 해석 가능성과 검증 가능성을 높이는 것을 목표로 한다.

From Clinical Judgment to Checkable Rules: Clinician-Led Guardrails for Mental-Health Chatbots

추천 이유:이 연구는 주류 프롬프트 엔지니어링, LLM-as-a-Judge 또는 헌법적 AI와는 차별화된 안전성 강화 방안을 제시하며, 핵심 혁신은 임상 의사결정을 구조화하고 형식화한 뒤 전 과정에 걸쳐 흔적을 남기는 데 있다. 모든 핵심 주장(예: 규칙 수, 검증 방법, 사실 기반의 규모, 대조 실험 데이터 및 비용 측정 등)은 원문에서 명확히 제시되었으며, 게시일자(2026-10-24)와 현재 UTC 날짜(2026-10-25)가 일치하여 시의성과 신뢰할 수 있는 근거를 갖추고 있다.

진행 상황 및 관련 보도

연구에서는 자가평가 강화학습 프레임워크 SARL을 제안하여 검색 증강형 대규모 모델의 검색 상태 인식 능력을 향상시켰다.

2026년 10월 24일, arXiv은 논문 arXiv:2610.30435v1을 발표하여, 기존 검색 증강형 대규모 언어 모델에서 검색 에이전트가 검색 상태에 대한 인식 능력을 갖추지 못하는 문제를 해결하기 위한 Self-Assessment Reinforcement Learning(SARL) 프레임워크를 제안했습니다.

Self-Assessment Reinforcement Learning for Search-State Awareness in Retrieval-Augmented Large Language Models

추천 이유:이 연구는 검색 강화형 대규모 언어 모델이 복잡한 과제에서 이미 획득된 정보나 누락된 정보를 인식하지 못해 환각 추론과 조기 탐색 종료라는 핵심적 결함을 겪는 문제를 해결하기 위해, 테스트 시 추가적인 평가 없이도 작동하는 엔드투엔드 강화학습 방안을 제안하고, 다중 점프 추론 및 심층 연구 벤치마크에서 상당한 성능 향상을 달성했습니다.

진행 상황 및 관련 보도

RIFT는 동적 KV 캐시 압축 전략을 제안하여 디코딩의 구식화 문제를 완화하고, 추론 디코딩의 품질을 향상시킨다.

2026년 10월 24일, arXiv는 논문 arXiv:2610.31098v1을 발표하여 RIFT—추론 디코딩에서 초안 모델(drafter)을 위한 동적 KV 캐시 압축 방법—을 제안했습니다. 이 방법은 사전 채워진 정보와 새로 생성된 토큰 간의 균형을 맞추고, 압축 가능성을 고려한 학습을 결합함으로써, 8K토큰의 KV 캐시 예산 하에서 Qwen3.5-4B 초안 모델이 Qwen3.5-122B로 장문맥 생성을 수행할 때 전체 캐시 수용 길이의 98% 이상을 유지하도록 합니다.

RIFT: KV Cache Compression for Draft Models with Complementary Compressibility Training

추천 이유:이 연구는 긴 출력 생성 시 KV 캐시의 팽창으로 인한 하드웨어 비용 증가와 정확도 저하 간의 상충 문제에 대해 직접적으로 접근하며, ‘디코딩 노후화’(decode staleness) 현상을 최초로 명확히 정의하고 정량화한 뒤, 실현 가능한 리프레시 메커니즘과 학습 협업 방안을 제안합니다. 실험 설정은 구체적(입력 32K/출력 4K/캐시 8K)이며, 결과는 엔지니어링 차원에서의 참고 가치를 지닙니다. 출처는 arXiv 사전인쇄본으로, 게시일(2026-10-24)이 시스템의 현재 날짜(2026-10-25)와 일치하여 시의성이 강합니다.

진행 상황 및 관련 보도

새로운 연구는 언어 간 빈 자극(CPOS) 실험 패러다임을 제안하여, 언어 모델의 계층적 일반화 능력의 조건부 이전을 규명하였다.

2026년 10월 24일, arXiv는 논문 2610.30960v1을 발표하여, 언어 모델이 다국어 지속 학습 과정에서 원본 언어(L1)의 계층적 구조에 대한 증거를 대상 언어(L2)로 이전하는 능력을 정량화하기 위한 다국어 빈 자극(CPOS) 실험 설계를 제안했다. 실험 결과에 따르면 이러한 이전은 부분적으로 성립하지만 완벽하지 않으며, 특히 언어 쌍과 어휘 중복 정도에 크게 의존하는 것으로 나타났다.

Once a Tree, Always a Tree? Cross-lingual Transfer of Hierarchical Generalization in Language Models

추천 이유:이 연구는 최초로 제어 가능한 다국어 저자극 프레임워크를 구축하여, ‘언어의 보편적 구조’가 비언어적 요인(예: 위치 인코딩 초기화)에 의해만 유도되는 것이 아니라 다국어 간 전이의 인지적 기반이 되는지를 직접 검증하였다. 이와 같은 결론은 대규모 언어 모델의 문법 습득 메커니즘과 다국어 정렬 전략을 이해하는 데 있어 방법론적·이론적 측면에서 모두 중요한 가치를 지닌다.

진행 상황 및 관련 보도

새로운 연구에서 ReflectPO 프레임워크를 제안하여, 대규모 언어 모델 에이전트의 장기적 작업에서의 자율적 오류 수정 능력을 향상시켰다.

2026년 10월 24일, arXiv는 “ReflectPO: 장기 주기 LLM 에이전트를 위한 반성 유도 전략 최적화”라는 제목의 연구 논문(번호 2610.30933v1)을 발표했으며, 복잡하고 다단계이며 상태에 의존하는 작업에서 도구 기반 대규모 언어 모델 에이전트의 자율적 오류 복구 능력을 강화하기 위해 ReflectPO라는 강화학습 프레임워크를 제안했습니다.

ReflectPO: Reflection-Guided Policy Optimization for Long-Horizon LLM Agents

추천 이유:이 논문은 최근 발표된 최첨단 AI 연구로, 현재 LLM 에이전트의 실용화에서 핵심적인 한계인 장기 작업에서 발생하는 초기 오류의 누적 효과에 초점을 맞추고 있다. 본 연구에서 제안한 Reflection-Guided Sampling과 Tree-Structured Credit Assignment의 이중 구성 설계는 방법론적 혁신성을 갖추고 있으며, 두 가지 도구 사용 벤치마크에서 여러 기준선을 상회하는 실증적 성과를 보여 기술적 참고 가치를 지닌다.

진행 상황 및 관련 보도

새로운 연구는 오픈북 평가가 주로 지식 저장보다는 읽기 행동을 측정한다는 점을 밝혀냈다.

2026년 10월 24일에 발표된 arXiv 논문(2610.31017v1)은 문서 수준의 LoRA 어댑터 평가에서 오픈북 스코어링이 어댑터가 해당 문서의 지식을 실제로 인코딩했는지 여부보다는 모델의 즉각적 읽기 능력에 크게 의존한다고 지적했다. 무작위 어댑터는 오픈북 과제에서 전문가용 어댑터의 우위를 82%까지 재현할 수 있었지만, 비소스 텍스트를 대상으로 한 클로즈 과제에서는 단 2%만 재현되었으며, 이는 통계적으로 영과 구별되지 않았다.

Mostly Reading: What Open-Book Scores Measure in Document-Level LoRA Adapters

추천 이유:이 연구는 체계적인 제어 실험(위키백과 문서 150편, Llama-3.1-8B-Instruct 모델, 이중 작업 비교)을 통해 현재의 오픈북 평가 패러다임의 근본적 한계를 밝혀냈다. 즉, 이 패러다임은 ‘읽기’와 ‘암기’를 효과적으로 구분하지 못하며, 지식 편집 및 검색형 어댑터의 실제 효용성에 대한 방법론적 도전 과제를 제기한다. 또한 논문에서는 ‘깨끗하지만 잘못된 결과’를 초래하는 네 가지 침묵 오류를 보고하여 재현성 위험을 부각시켰다.

진행 상황 및 관련 보도

연구에 따르면 어휘 길이는 표준어 동음이의어의 정체를 직접적으로 암시할 수 있다: arXiv의 새로운 논문이 어휘 빈도와 발음 지속 시간 간의 인지적 연관성을 밝혀냈다.

2026년 10월 24일, arXiv는 “단어 길이를 통한 직접적 단어 제시가 단어 정체성에 미치는 영향: 만다린 동음이의어로부터의 증거”라는 제목의 새로운 논문(arXiv:2610.30682v1)을 발표했으며, 실험 결과 다른 음성 단서가 없거나 높은 노이즈 환경에서도 만다린 원어민들이 두 음절로 구성된 동음이의어의 발음 지속 시간 차이를 기반으로 그 단어의 빈도 높낮이를 판단할 수 있음을 보여주었다. 짧은 발음은 고빈도 단어로 인식되는 경향을 보였으며, 이는 단어 길이가 음성적 세부사항으로 심리적 사전에 저장되어 구어에서의 단어 인식에 관여할 수 있음을 시사한다.

Direct cueing of word identity through word duration: evidence from Mandarin homophones

추천 이유:이 연구는 중국어의 풍부한 이음절 동음이의어를 출발점으로 삼아, 동음이의어 정렬 과제를 활용하고 어휘 빈도 변수를 통제함으로써 엄격한 청각 조건 하에서 어휘 길이의 기능적 역할을 검증하였다. 그 결과는 ‘어휘 빈도 효과’에 대한 언어 간 음성 구현 메커니즘에 관한 새로운 증거를 제시하며, 어휘 길이는 단지 부언적 현상에 불과하다는 기존 관점을 도전하는 것으로, 심리언어학과 말소리 지각 이론 양측 모두에 중요한 함의를 갖는다.

진행 상황 및 관련 보도