本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

スタンフォード大学とカリフォルニア大学バークレー校の研究者らがTokenGateを発表:トークンゲート型アテンションにより、長文コンテキストのプリフィル処理が最大11.3倍高速化

スタンフォード大学とカリフォルニア大学バークレー校の研究者らは、既存の大規模言語モデル(LLM)に適用可能なプラグアンドプレイ型の学習ベースのトークン剪枝モジュール「TokenGate」を提案しました。この手法は、精度を損なうことなく、長文コンテキストに対する初期文字生成時間(TTFT)を1.4倍から11.3倍に加速し、ピークメモリ使用量を1.5倍から3.4倍削減します。関連コードおよびチェックポイントはオープンソースとして公開されています。

Researchers from Stanford and UC Berkeley Introduce TokenGate: Token-Gated Attention Makes Long-Context Prefill Up to 11.3x Faster
経緯と関連報道

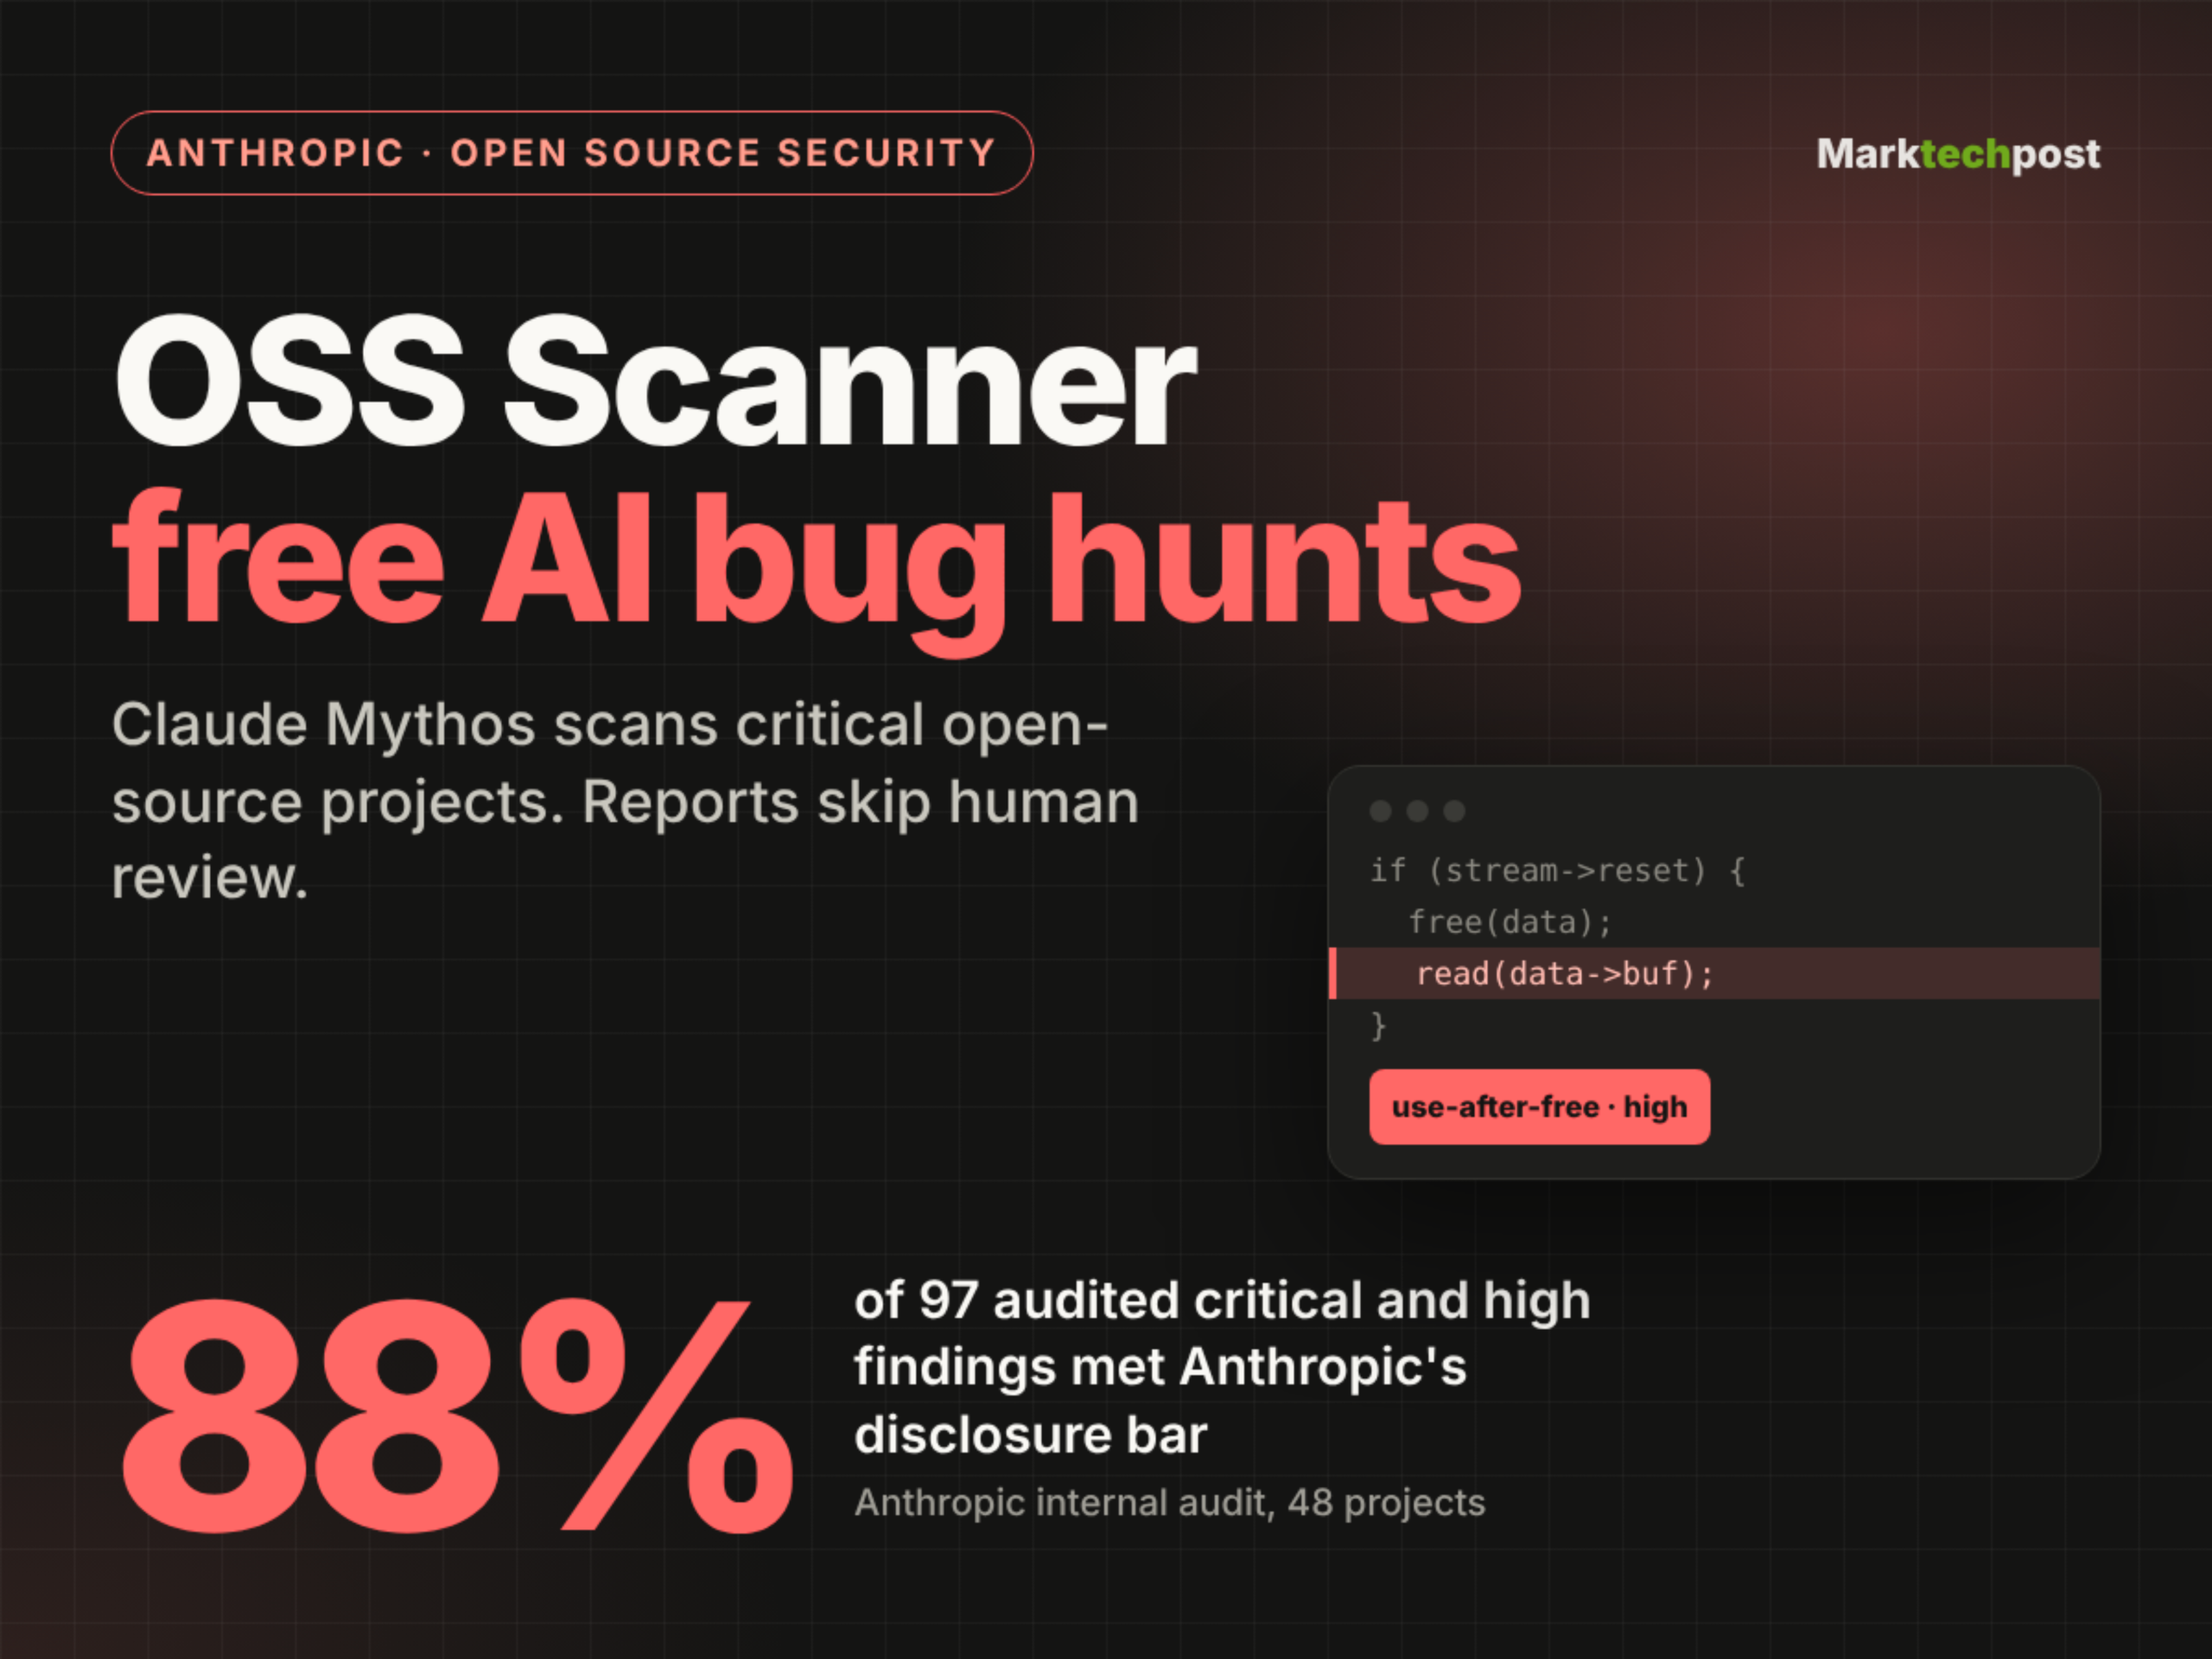
Anthropicが、主要なオープンソースプロジェクト向けの無料AI脆弱性スキャナー「OSS Scanner」を発表しました

Anthropicは2026年10月8日、Claude Mythosなどの強力なモデルを基にした無料でオプトイン型のAI脆弱性スキャンツール「OSS Scanner」をリリースし、重要なオープンソースプロジェクト向けに設計しました。10月19日時点で、114のプロジェクトが受け入れられ、11日間で深刻度レベル77件および高リスクレベル803件の脆弱性(モデルによる評価)が報告され、サンプリングされた監査結果の88%が同社の開示基準に適合していることが確認されました。

Anthropic Launches OSS Scanner, a Free AI Vulnerability Scanner

注目する理由:このツールは、オープンソースセキュリティ分野におけるLLMの大規模な実装事例を示しており、無償・完全自動・オフラインでの監査を特徴としています。ただし、人手によるレビュー工程を省略することで、誤検知や重複する問題が生じるリスクも伴います。その精度データ(有効率88%、偽陽性率1%)および実際のプロジェクトからのフィードバック(wolfSSLやcurlなど)は、現在のAI主導型脆弱性発見能力に関する実証的なベンチマークを提供しています。

経緯と関連報道

KimiがK3.1 Proを発表:エンドポイントタスク能力がトップに躍進、シミュレーションによるデバッグとマルチモーダルプログラミングにより具現知能の原型を示す

Kimiは2026年10月25日にK3.1 Proモデルを発表し、Terminal-Bench 4.0のタスクテストにおいて成功率67.2%で首位に立った。また、エミュレーターのバグを自律的に修正し、物理シミュレーション、音声解析、3Dシーン構築、動画編集といった多様なタスクをこなす能力を備えており、身体拡張型知能技術の道筋を探る方向性を示している。

根据报道中的虚拟人行走训练和模拟器调试制作的编辑示意,非软件实拍截图

注目する理由:本資料は、钛媒体が許諾して公開した実測レポートに基づいており、Artificial Analysis、Terminal-Bench 4.0 などの権威ある第三者評価データ、公式による自主テスト結果、ならびに著者による多様なシーンにおける機能検証を網羅しています。K3.1 Pro の実行性能、シミュレーションのクローズドループ、マルチモーダルプログラミングにおける実質的な進歩に焦点を当てるとともに、性能上の限界や未公表の情報(例:Flash/Ultra はまだリリースされていない)についても明示しており、事実確認および出典表示の要件に準拠しています。

経緯と関連報道

四分の一PRは「AIゴミ」だ!Linux財団が新たな報告書を発表:AIによるコード生成は52%速くなったが、オープンソースのメンテナーはかえって疲れている

Linux財団は10月20日に発表した報告書で、生成型AIによりコード作成にかかる時間は平均52%短縮された一方で、オープンソースプロジェクトのメンテナーらは、プルリクエストの約25%が低品質な「AIスロップ」に該当すると推定していると指摘しました。大規模プロジェクトではその割合が31%にまで上昇しています。報告書は、効率向上による恩恵が審査やガバナンスのコスト削減には必ずしも反映されておらず、正式なAI貢献ポリシーを策定しているプロジェクトは全体の35%にとどまっていることを明らかにしています。さらに、メンテナーの疲弊と信頼不足が顕在化している状況も浮き彫りにされています。

経緯と関連報道

マイクロソフトがAgenshをオープンソース化:1024個の自律協調型AIコーディングエージェントをサポートする分散型フレームワーク

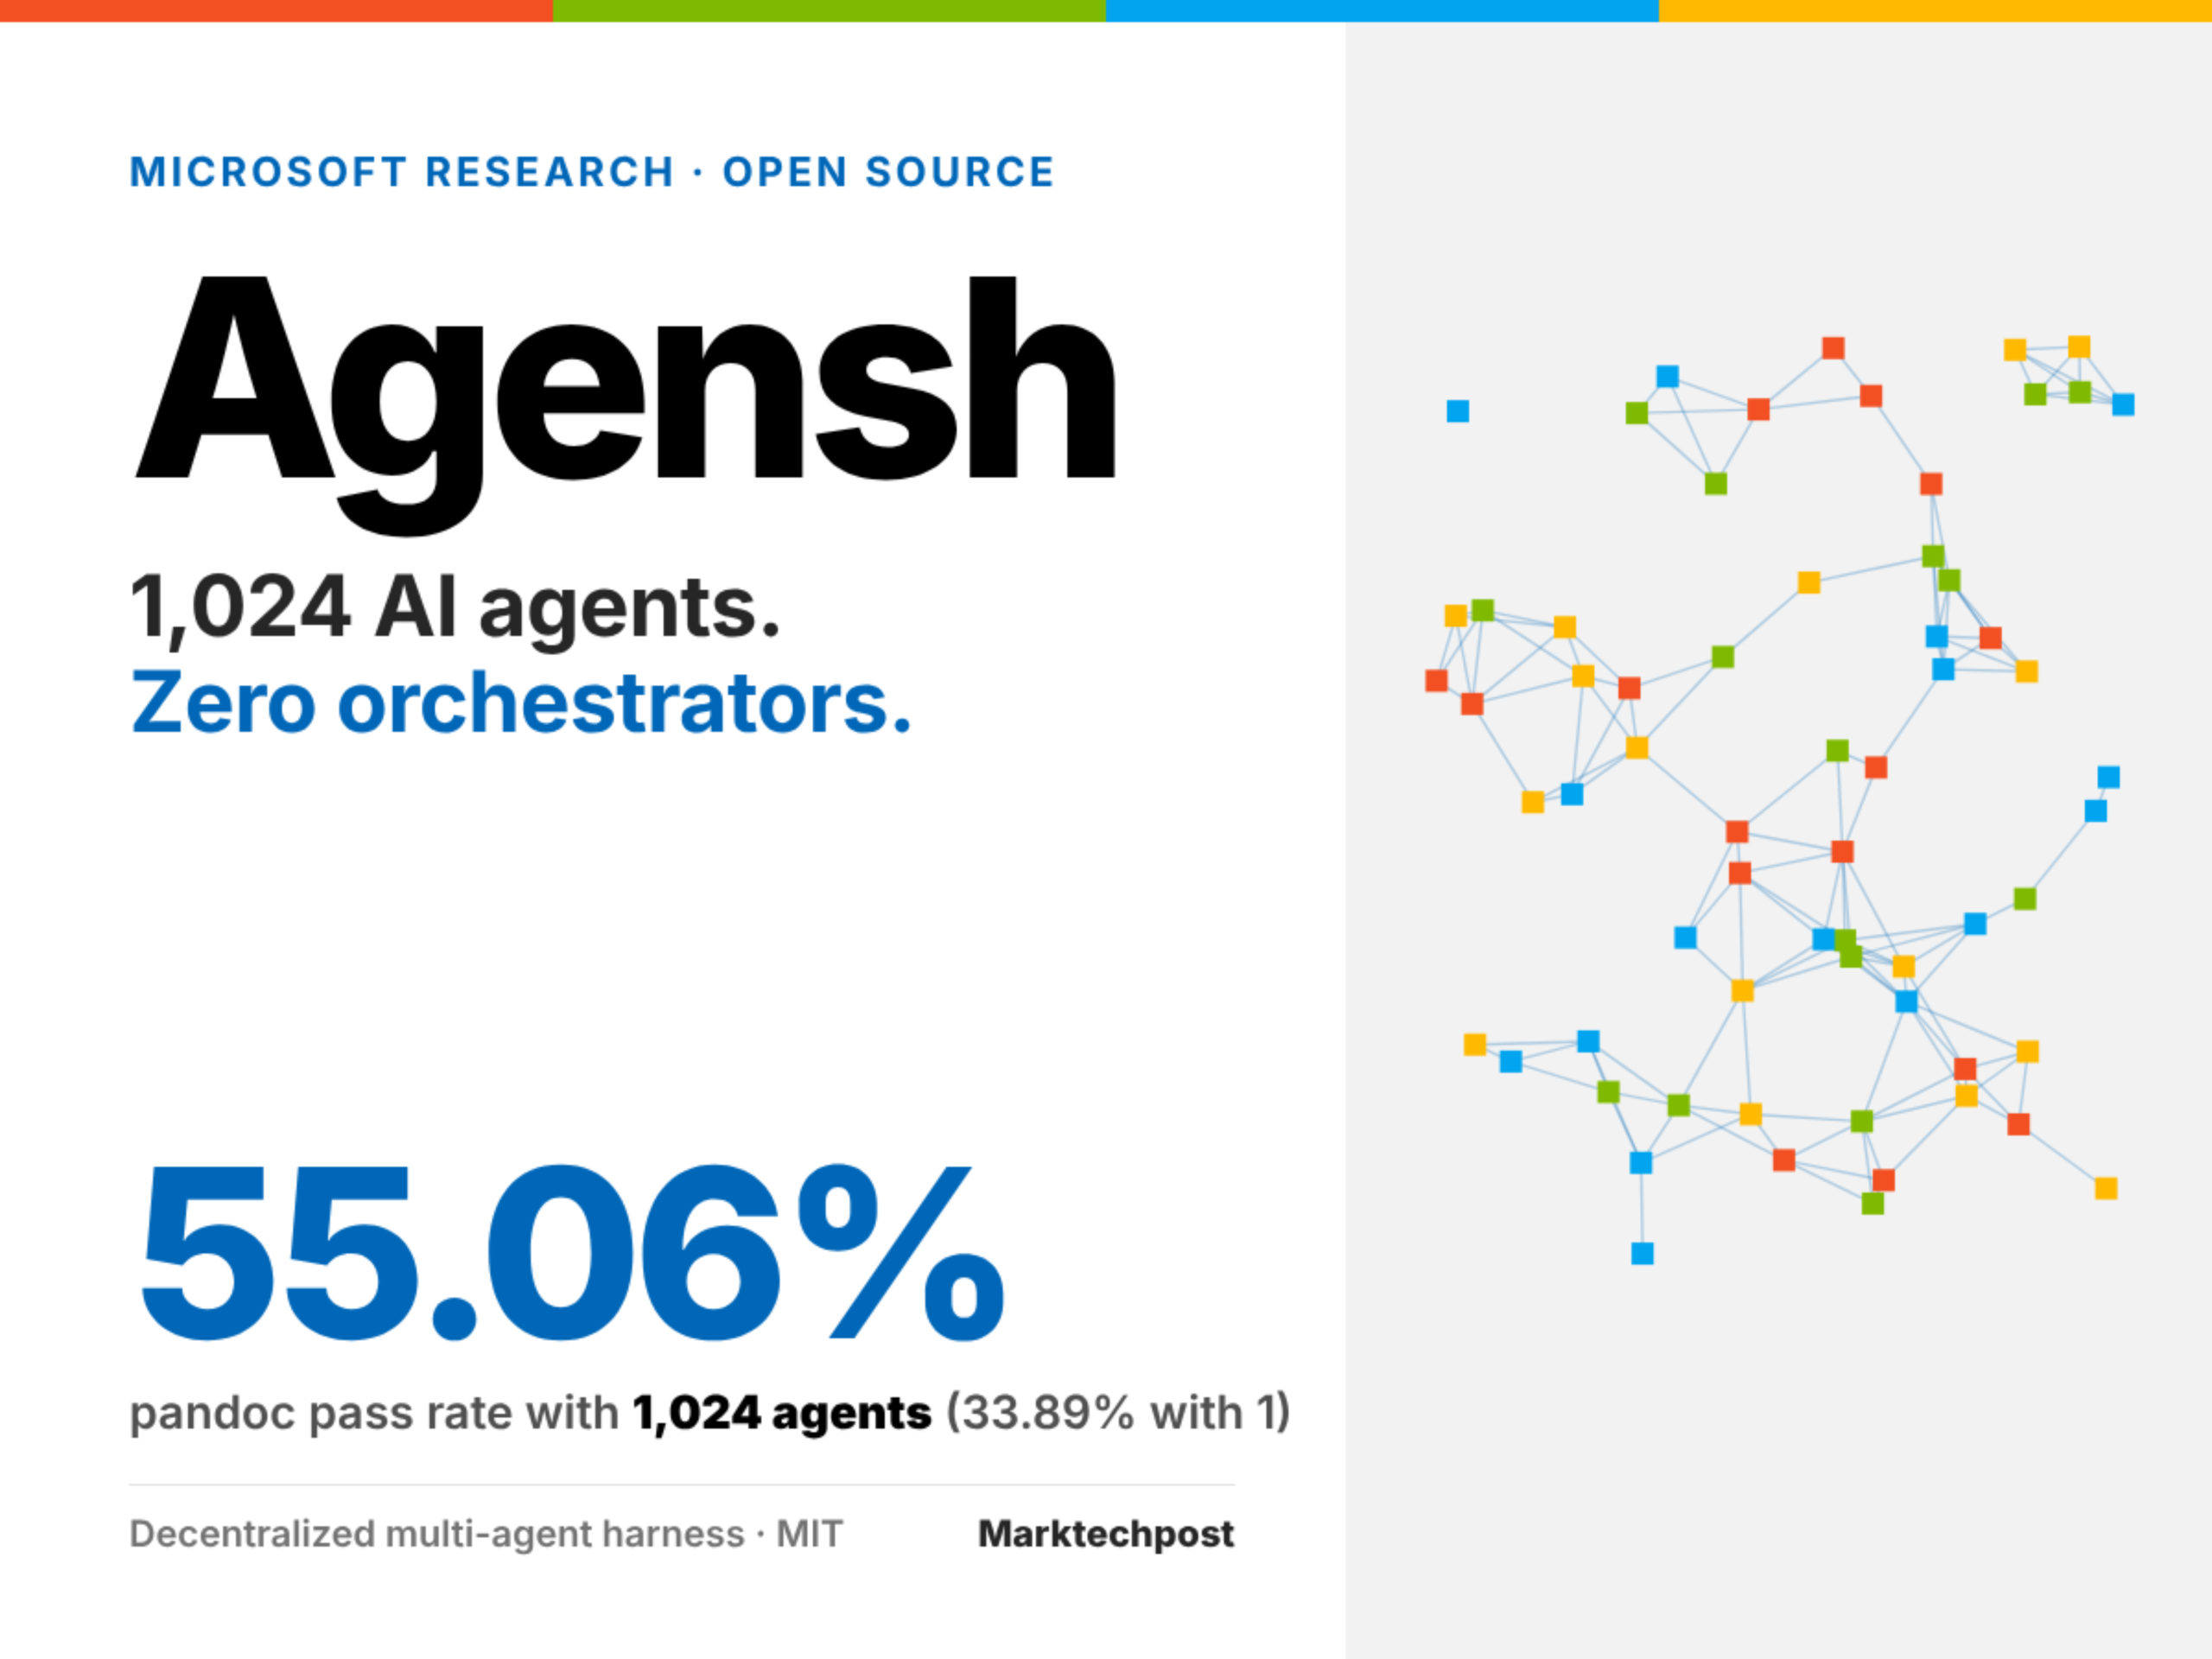
マイクロソフト研究院は2026年10月25日、中央調整者を必要としないマルチエージェント実行時フレームワークであるAgenshをオープンソース化しました。Agenshは、ProgramBench上で1~1024のLLMベースのコーディングエージェントが自己組織的に協調して動作することを支援します。システムはGitea、Mattermost、DeLMスタイルの共有ボードに基づいて分散型の調整を実現しており、すべてのエージェントが同一のプロンプト駆動型五段階ループを実行します。また、Linux+Docker環境下でスケーラビリティが検証されています。

Microsoft Open-Sources Agensh: A Multi-Agent Harness for 1,024 Agents

注目する理由:この成果は、マルチエージェントシステムアーキテクチャの重要な進化を示しており、従来の「マスターエージェント」型パラダイムを廃し、プロンプトエンジニアリングと軽量なサービスの組み合わせによって大規模な自己組織化を実現しています。ProgramBenchにおける実証データ(たとえば、128個のエージェントによる5つのタスクの均等分配において49%の性能向上)は、分散型AIの設計・実装に新たなベンチマークを提供しています。また、MITライセンスでオープンソース化されており、Copilot CLIなどの主流な単一エージェントツールとも互換性があるため、実際の開発における参考価値も備えています。

経緯と関連報道

アンダードッグ・サルキ27B:GSQ-RCOをベースとした2ビットQwen3.8-27Bのツール呼び出しモデルに関する技術解説

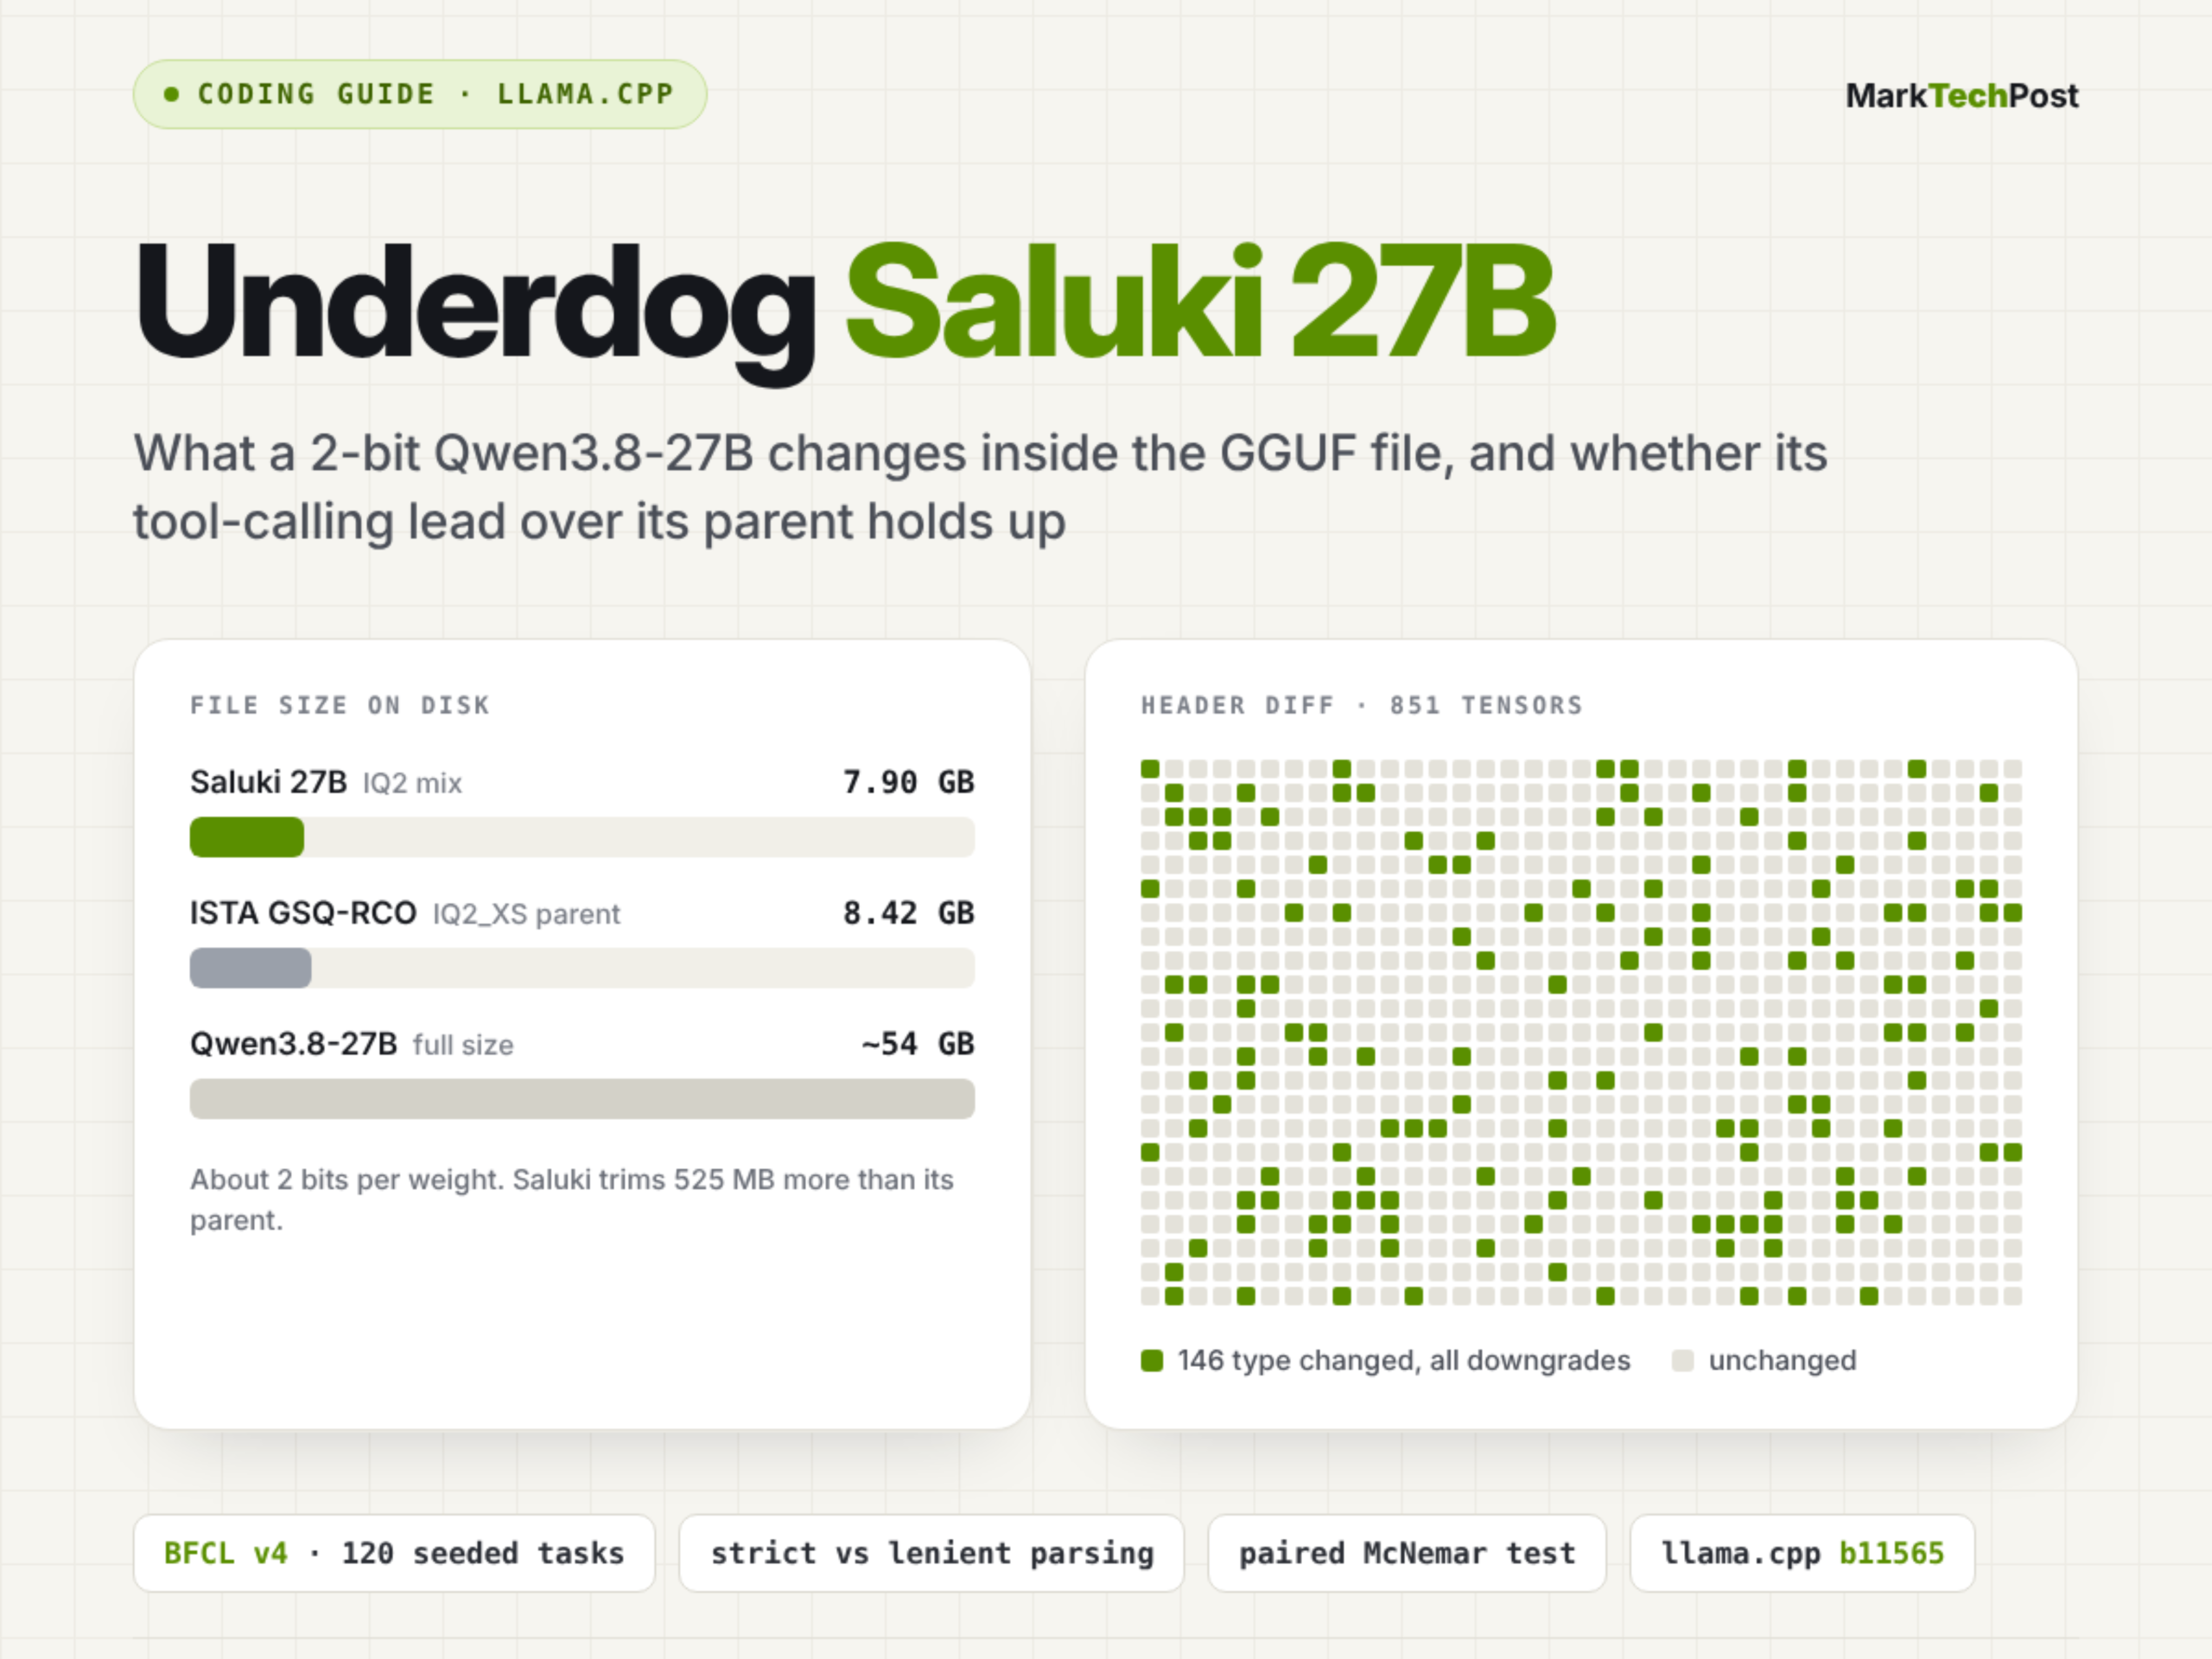
本記事では、Underdogが公開したSaluki 27Bモデル——7.9 GBの2ビット量子化を採用したQwen3.8-27Bの変種——について紹介します。同モデルはISTA-DASLabのGSQ-RCO手法を用いて構築されており、120タスクにおけるBFCL v4ツール呼び出しベンチマークにおいて、元の54 GBのフル精度モデルを上回るとされています。ただし、すべての性能に関する結論は開発者による声明に基づくものであり、独立した検証は行われていません。

How to Run Underdog Saluki 27B: 2-Bit Qwen3.8-27B Tool-Calling Guide
経緯と関連報道

llama.cpp 发布 b11865 版本:新增 RDMA 接收边界检查,支持 CUDA 13.4、ROCm 10.0、Snapdragon NPU 等多平台后端

llama.cpp 项目发布构建版本 b11865,核心变更包括在 RDMA 接收逻辑中增加内存边界检查(PR #30399),并显著扩展硬件加速支持,覆盖 CUDA 13.4、ROCm 10.0、Vulkan、OpenVINO、SYCL 及高通 Snapdragon(CPU+Adreno+Hexagon)全栈异构计算后端;macOS KleidiAI 支持与 openEuler 构建被明确标记为 DISABLED。

注目する理由:按信源设置仅收录,不参与自动精选

経緯と関連報道

PHPの「メルトダウン」問題は、AIが古い脆弱性の脅威をいかに拡大するかを明らかにする

セキュリティ研究者はAIツールを活用し、長年存在し、かつ利用が困難だとされてきたPHPの脆弱性(総称してPHP2Shell)を、実際に悪用可能な攻撃面へと変換しました。この脆弱性は公開後数時間以内に数百万回もの悪用試行が行われましたが、これまでのところ成功した侵入事例は報告されていません。

注目する理由:この事件は、AIが新たな脆弱性を無から生み出すのではなく、既存の脆弱性の悪用に対する障壁を大幅に低減していることを初めて明確に示し、攻撃と防御の両面において既存のセキュリティ状況を加速させるAIの二重の役割を浮き彫りにしています。また、有効な発見のすべては、人間とAIの協調に依存しています。

経緯と関連報道

セバスチャン・ラシュカが8本のビデオコース「ゼロから推論モデルを構築する」を公開しました

セバスティアン・ラシュカは2026年10月24日、Ahead of AI誌(magazine.sebastianraschka.com)において、全8回・総計11時間超のPythonおよびPyTorchに関する実践型ビデオ講座を公開しました。同講座では、推論モデルの評価、推論時のスケーリング、強化学習(RLVR)、知識蒸留について体系的に解説し、すべての手法を事前学習済みQwen3-0.6Bモデルを基に実装しています。

注目する理由:本コースは、著者が『ゼロから大規模言語モデルを構築する』に続いて提供する高度な技術教育コンテンツであり、現在の主流LLMの核心的な進化方向である推論能力の強化に焦点を当てています。基礎環境の構築からGRPO強化学習、自己蒸留に至るまで、一連の技術スタックを網羅しており、すべての実装が「ゼロから手書き」で再現可能であることを明示しています。そのため、高い教育効果と実践的なエンジニアリングリファレンスとしての価値を備えています。

経緯と関連報道

AnthropicがOSレベルのサンドボックスであるsandbox-runtimeをオープンソース化:AIエージェントにコンテナレスなファイルおよびネットワーク隔離を提供

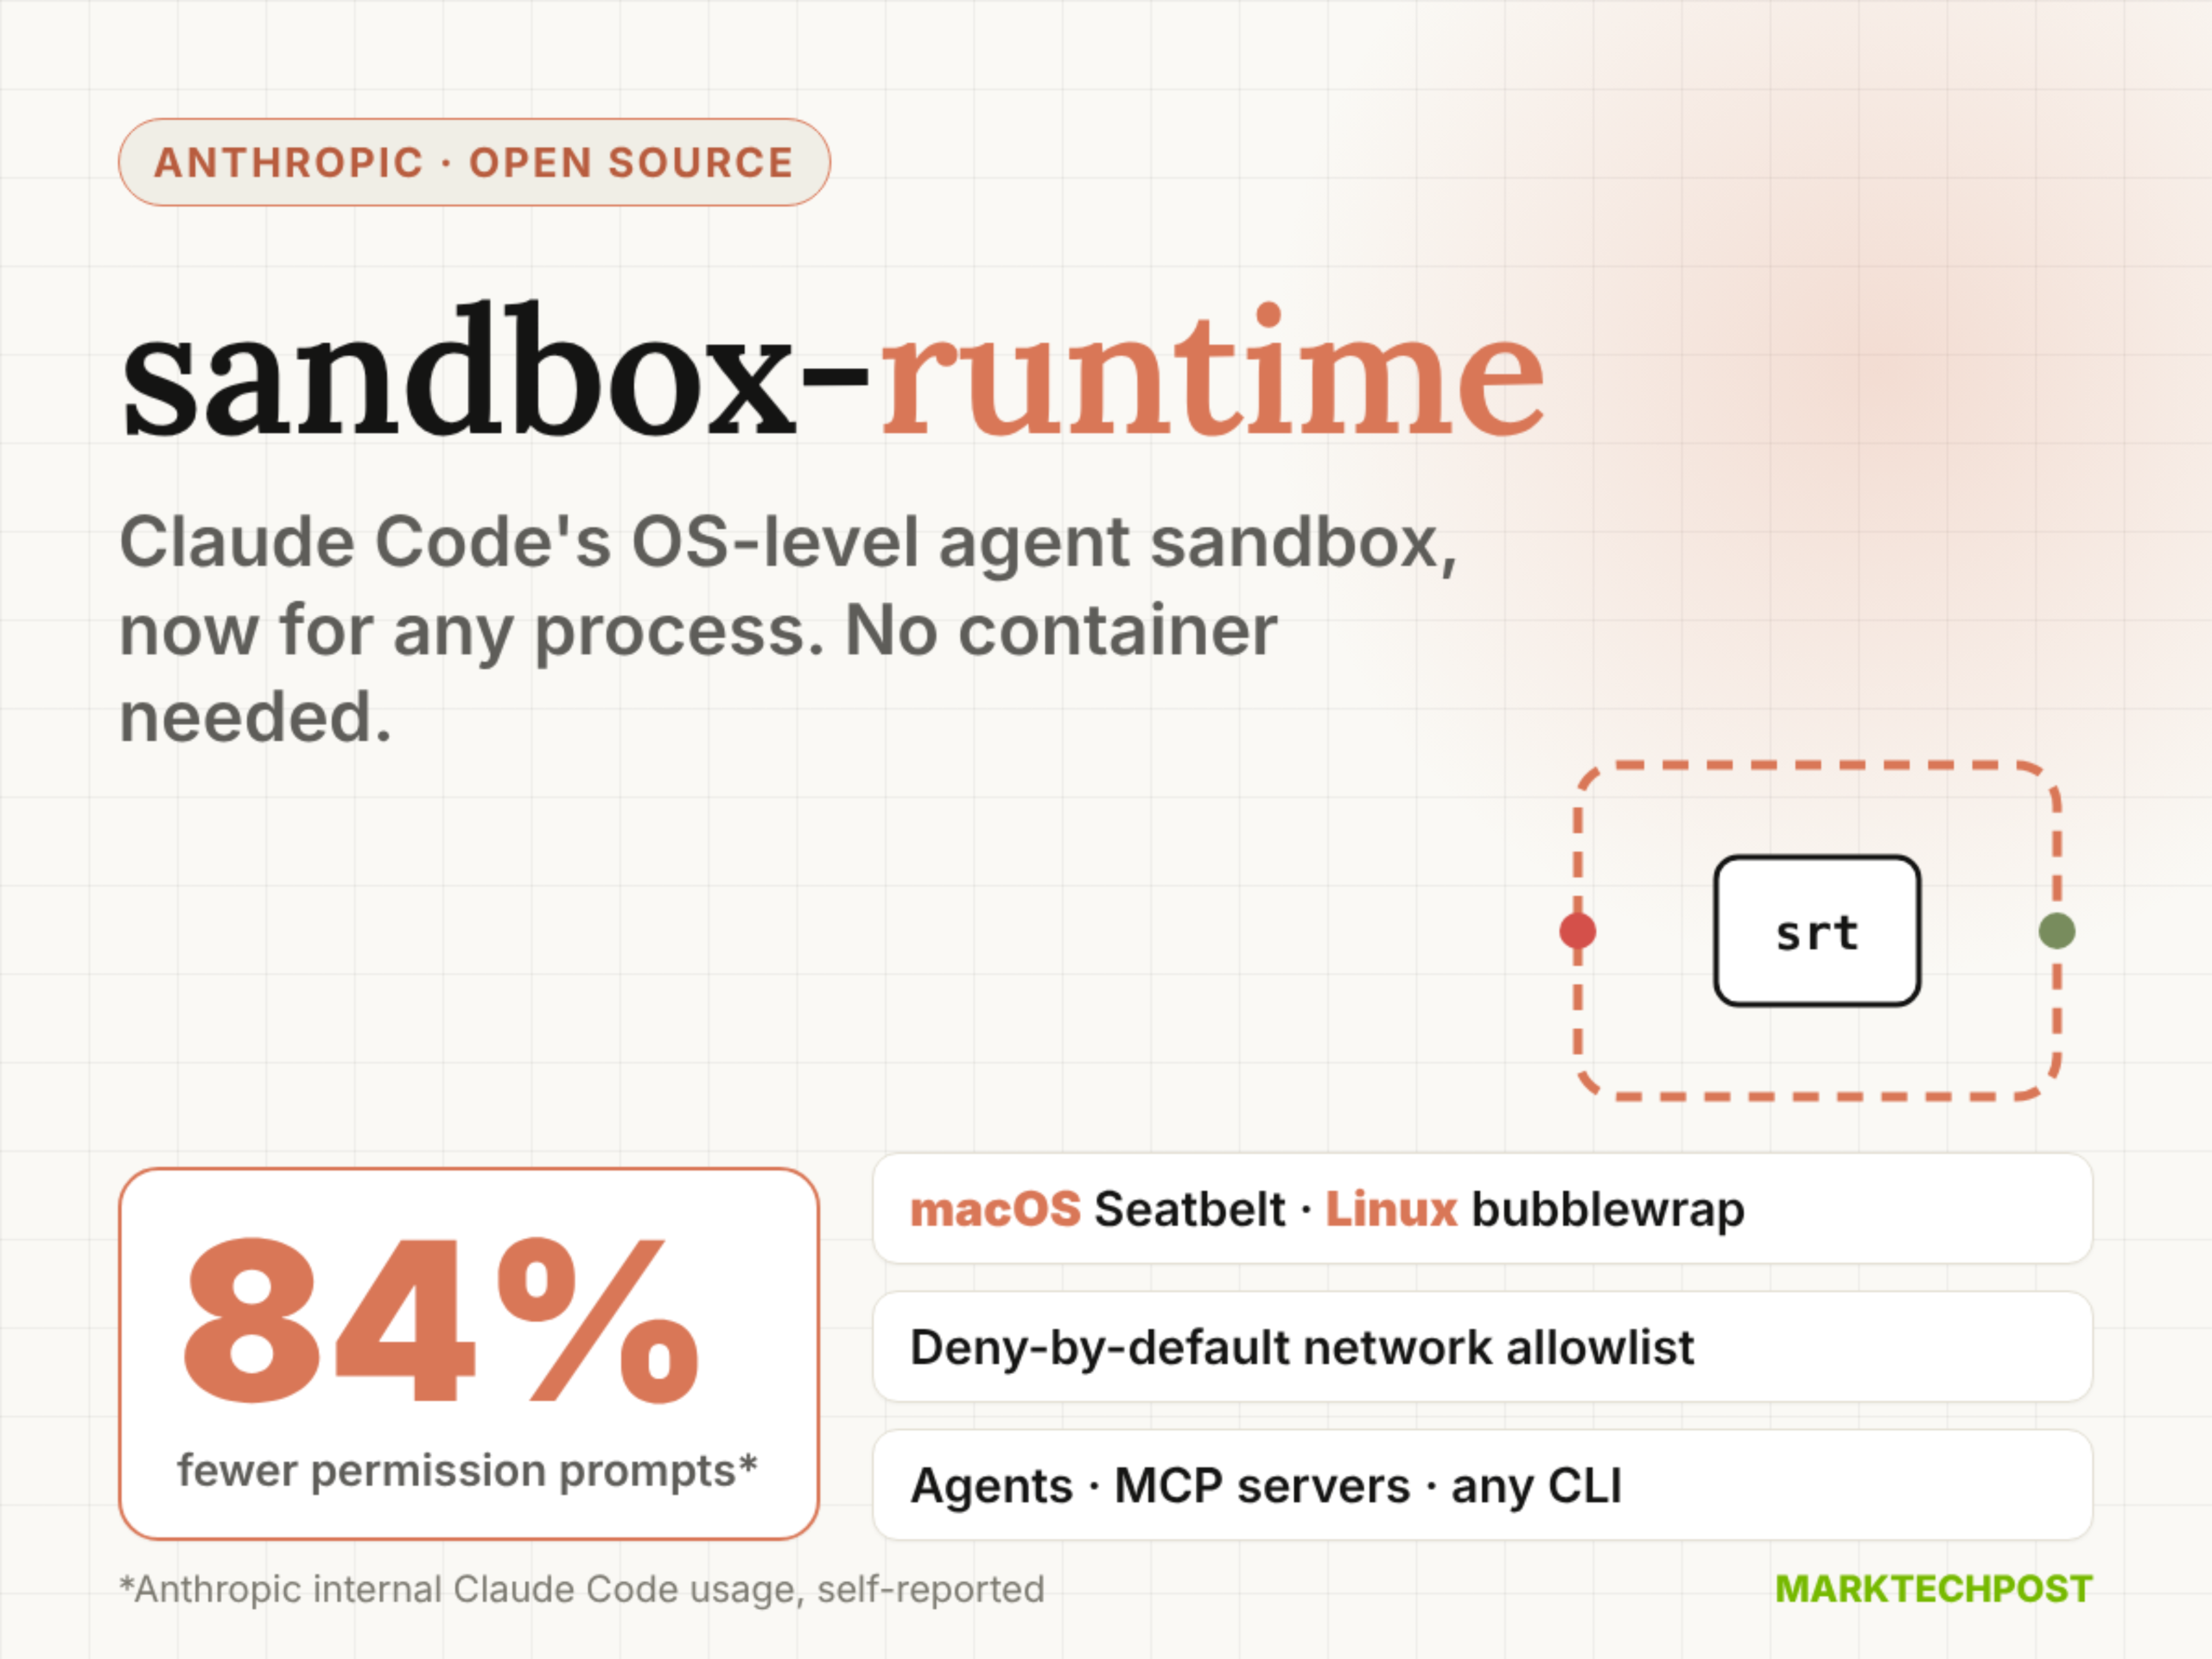
Anthropicは2026年10月24日、AIエージェント、MCPサーバー、CLIツールのファイル読み書きおよびネットワークアクセス権を制限するための、コンテナに依存しないOSレベルのサンドボックスツールであるsandbox-runtime(srt)をオープンソース化しました。macOS(Seatbelt)、Linux(bubblewrap)、Windows(alpha)をサポートしており、npmパッケージのバージョンはv0.0.81で、ライセンスはApache-2.0です。

Meet Anthropic’s sandbox-runtime: OS-Level Sandboxing for AI Agents, No Containers

注目する理由:このツールは、AIセキュリティインフラストラクチャの重要な進化を示しています。OSのネイティブな隔離メカニズムにより、細粒度でプロセスツリー全体を網羅するサンドボックス制御を実現し、プロンプトインジェクションや権限の過剰付与といったリスクに正面から対処しています。また、Claude Code内部での使用においてもその効果が検証されています。

経緯と関連報道

月之暗面发布Kimi K3.1 Pro:2.8万亿参数开源权重模型,11月4日开放权重

月之暗面于2026年10月22日前后发布Kimi K3.1 Pro,一款2.8万亿参数、1040亿激活参数的多模态MoE模型,宣称性能逼近Fable 5.1;官方承诺11月4日发布开源权重,但截至报道时权重尚未公开;独立评测显示其在智能指数、代码与网络安全基准中表现突出,但存在推理成本、本地部署可行性及营销透明度等争议。

[AINews] Kimi 3.1 Pro 104BA-2.8T: Fable-5.1-Class Open Weights narrows Closed-AI lead to 1 month... and Pro Highspeed API with 2-3× speed

注目する理由:该事件标志着当前最接近闭源前沿模型能力的开源权重模型正式进入发布倒计时,是AI开源生态关键进展;材料来源为Latent Space旗下AINews(2026年10月24日发布),内容基于对X平台、Reddit、Arena及Artificial Analysis等多方独立评测的整合,信息密度高且具时效性与交叉验证特征。

経緯と関連報道

MemPlan:部分観測可能なテキスト環境向けの記憶強化型PDDL計画フレームワーク

同論文は2026年10月24日、arXivにて公開され(番号2610.30379v1)、MemPlan——大規模言語モデル(LLM)を言語と記号計画の間の制約付き橋渡しとして用いる、記憶条件付PDDL計画フレームワーク——を提案しており、部分観測可能な対話型テキスト環境に適用可能である。

MemPlan: Memory-Conditioned PDDL Planning for Partially Observable Text Environments

注目する理由:MemPlanは、正のグラフによる記憶と負の記憶メカニズムを用いてPDDL問題を動的に再構築し、タスク完了率と手順数の効率を大幅に向上させるとともに、オンラインでのトークン消費も大きく削減します。また、そのオフライン微調整可能な言語–記号インターフェースはTextWorld系のタスク間で再利用可能で、タスク固有の微調整が不要であるため、本手法の汎用性と実用性が示されています。

経緯と関連報道

IFC-MCQ:建築情報モデル向けのLLMエージェントによる自動多肢選択問題のベンチマーク生成手法

研究者は2026年10月24日、arXivにてIFC-MCQ手法を公開し、建築・エンジニアリング・建設(AEC)分野における大規模言語モデル(LLM)ベースのIndustry Foundation Classes(IFC)データ検索システム向けに、正確な採点が可能な多肢選択式問題のベンチマークを自動生成することを目的としています。

IFC-MCQ: Automatically Generating Multiple-Choice Benchmarks for Evaluating LLM Agents on IFC Data Retrieval

注目する理由:本研究は、IFCなどの専門的な構造化データに対する大規模言語モデル(LLM)の評価が困難でコストが高いという課題に正面から取り組み、IFCファイル向けの自動多肢選択問題生成フレームワークを初めて提案しました。このフレームワークは15カテゴリ36サブカテゴリを網羅し、再現性と拡張性を備えたエージェント能力の評価を支援します。

経緯と関連報道

FusionEvalの公開:大規模言語モデルの統合に向けた新たなベンチマークテスト

2026年10月24日、研究者はarXivに論文arXiv:2610.30162v1を公開し、大規模言語モデルの融合手法の評価に特化した初の統一ベンチマークであるFusionEvalを提案しました。同ベンチマークは、推論チェーンの長さやツール呼び出しといった脆弱な部分を網羅しており、学習型と非学習型の融合手法の比較も可能にしています。

FusionEval: Benchmarking Model Fusion for Large Language Models

注目する理由:このベンチマークは、既存の評価において長鎖推論とツール利用へのカバーが不十分であった点を補完し、平均性能と最悪時の能力保持を明確に区別するとともに、Qwen3/Llamaに基づく再現可能な専門家プール、GPUメモリや実行時間などの多次元指標、およびオープンソースコードを提供しており、高い実践的指導性を備えています。

経緯と関連報道

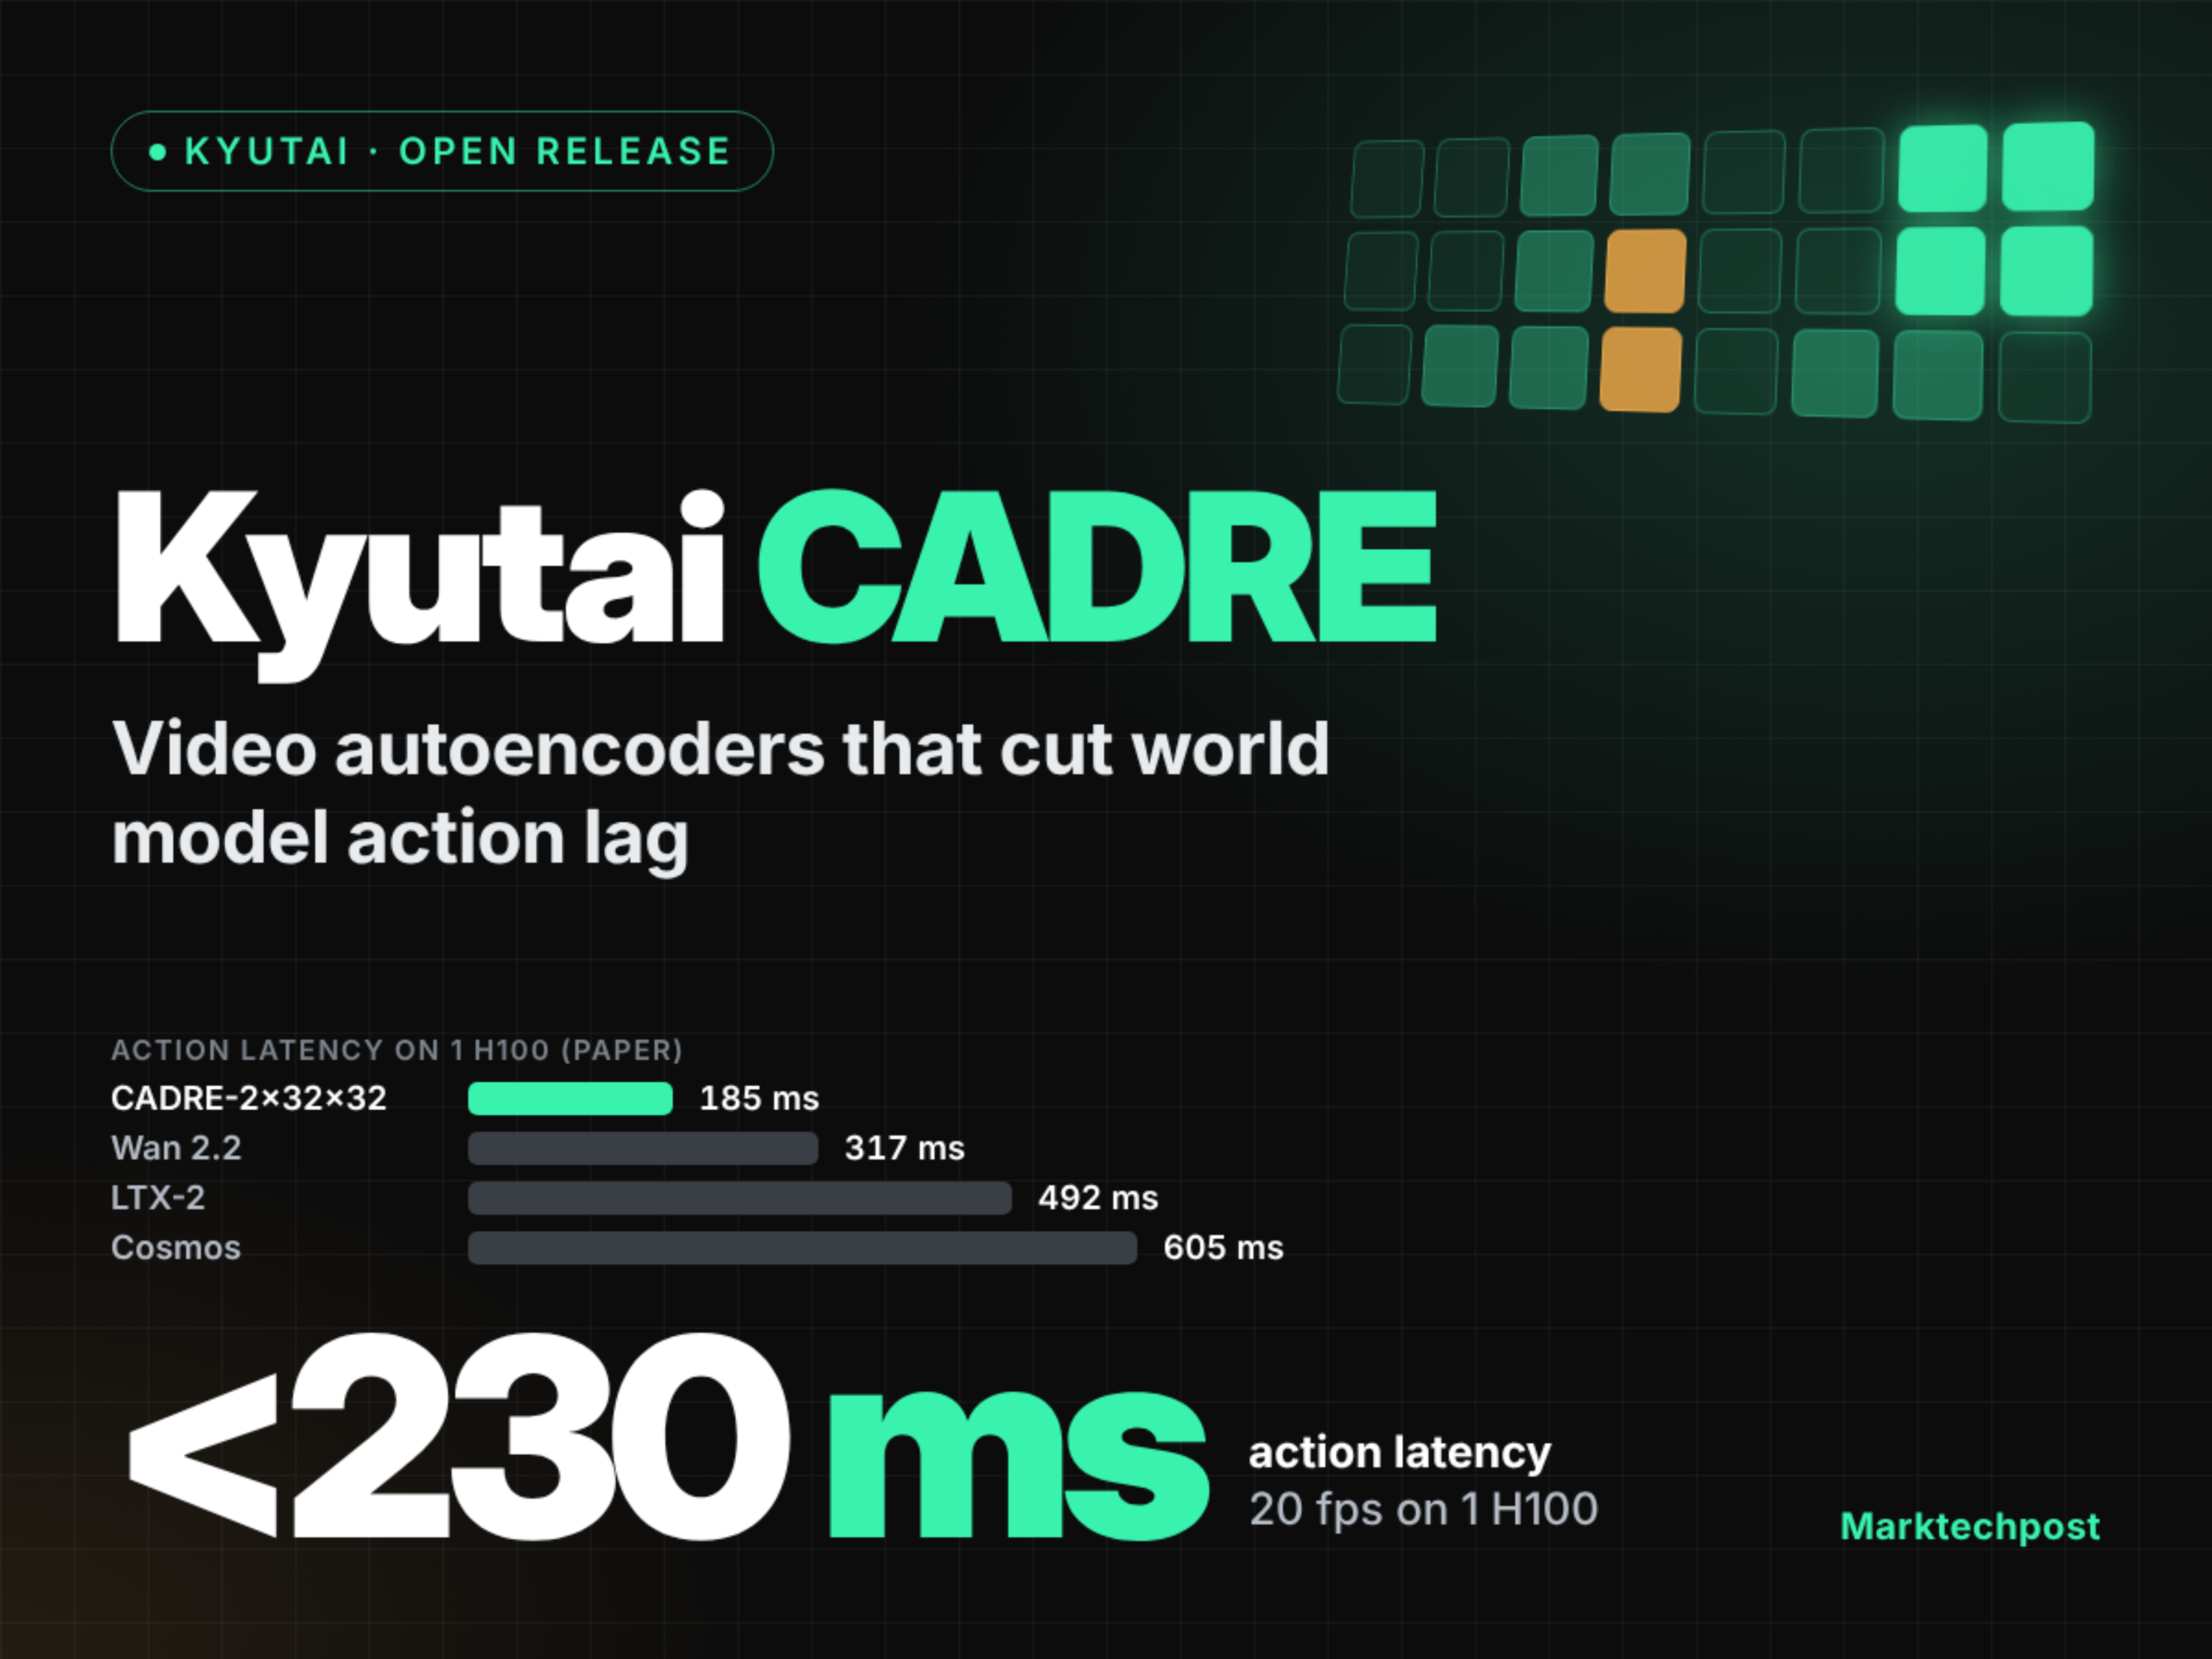
KyutaiがCADREビデオ自己符号化器ファミリーを発表:対話型世界モデル向けで、エンドツーエンドの動作遅延を230ミリ秒以下に抑えます

Kyutaiは2026年10月23日、世界モデルにおける動作遅延の低減を目的とした、7つのオープンソース因果拡散型ビデオ自己符号化器からなるモデルファミリー「CADRE」を公開しました。単一のH100 GPU上で実測した反応遅延は最低185 ms、推論フレームレートは23.4 fpsに達し、シーンFVD指標は162.6まで低下しました(Wan 2.2では599.7)。ただし、ロボット操作タスクにおける動作追従率(ARR)は、Wan 2.2およびCosmosに比べてやや劣る結果となっています。

Kyutai CADRE: Video Autoencoders That Cut World Model Lag Below 230 ms
経緯と関連報道

谷歌I/O 2026发布Gemini for Science、WeatherNext与Antigravity 2.0等AI科研与健康工具

谷歌研究团队在I/O 2026大会上集中发布面向科学发现、气候预测、医疗健康与边缘计算的系列AI系统,包括多模态科研助手Gemini for Science、支持飓风预警的WeatherNext、可自主构建操作系统的Agentic平台Antigravity 2.0,以及开源量子芯片Willow等;所有成果均为实验性演示,尚无独立验证或监管批准。

注目する理由:人工审核

経緯と関連報道