
斯坦福大学与加州大学伯克利分校的研究人员推出 TokenGate:基于令牌的注意力机制使长上下文预填充速度提升高达 11.3 倍
斯坦福大学与加州大学伯克利分校研究人员提出TokenGate——一种可即插即用的学习型令牌剪枝模块,适用于现有大语言模型(LLM)。该方法在不损失准确率的前提下,将长上下文预填充的首字生成时间(TTFT)加速1.4至11.3倍,峰值内存降低1.5至3.4倍。相关代码与检查点已开源。

检索标题、摘要与正文,把分散的信息连起来。
斯坦福大学与加州大学伯克利分校研究人员提出TokenGate——一种可即插即用的学习型令牌剪枝模块,适用于现有大语言模型(LLM)。该方法在不损失准确率的前提下,将长上下文预填充的首字生成时间(TTFT)加速1.4至11.3倍,峰值内存降低1.5至3.4倍。相关代码与检查点已开源。
Anthropic于2026年10月8日推出OSS Scanner——一款基于Claude Mythos等强模型的免费、可选加入式AI漏洞扫描工具,专为关键开源项目设计;截至10月19日,已接收114个项目,11天内报告77个严重级和803个高级别漏洞(模型评级),88%的抽样审计结果符合其披露标准。
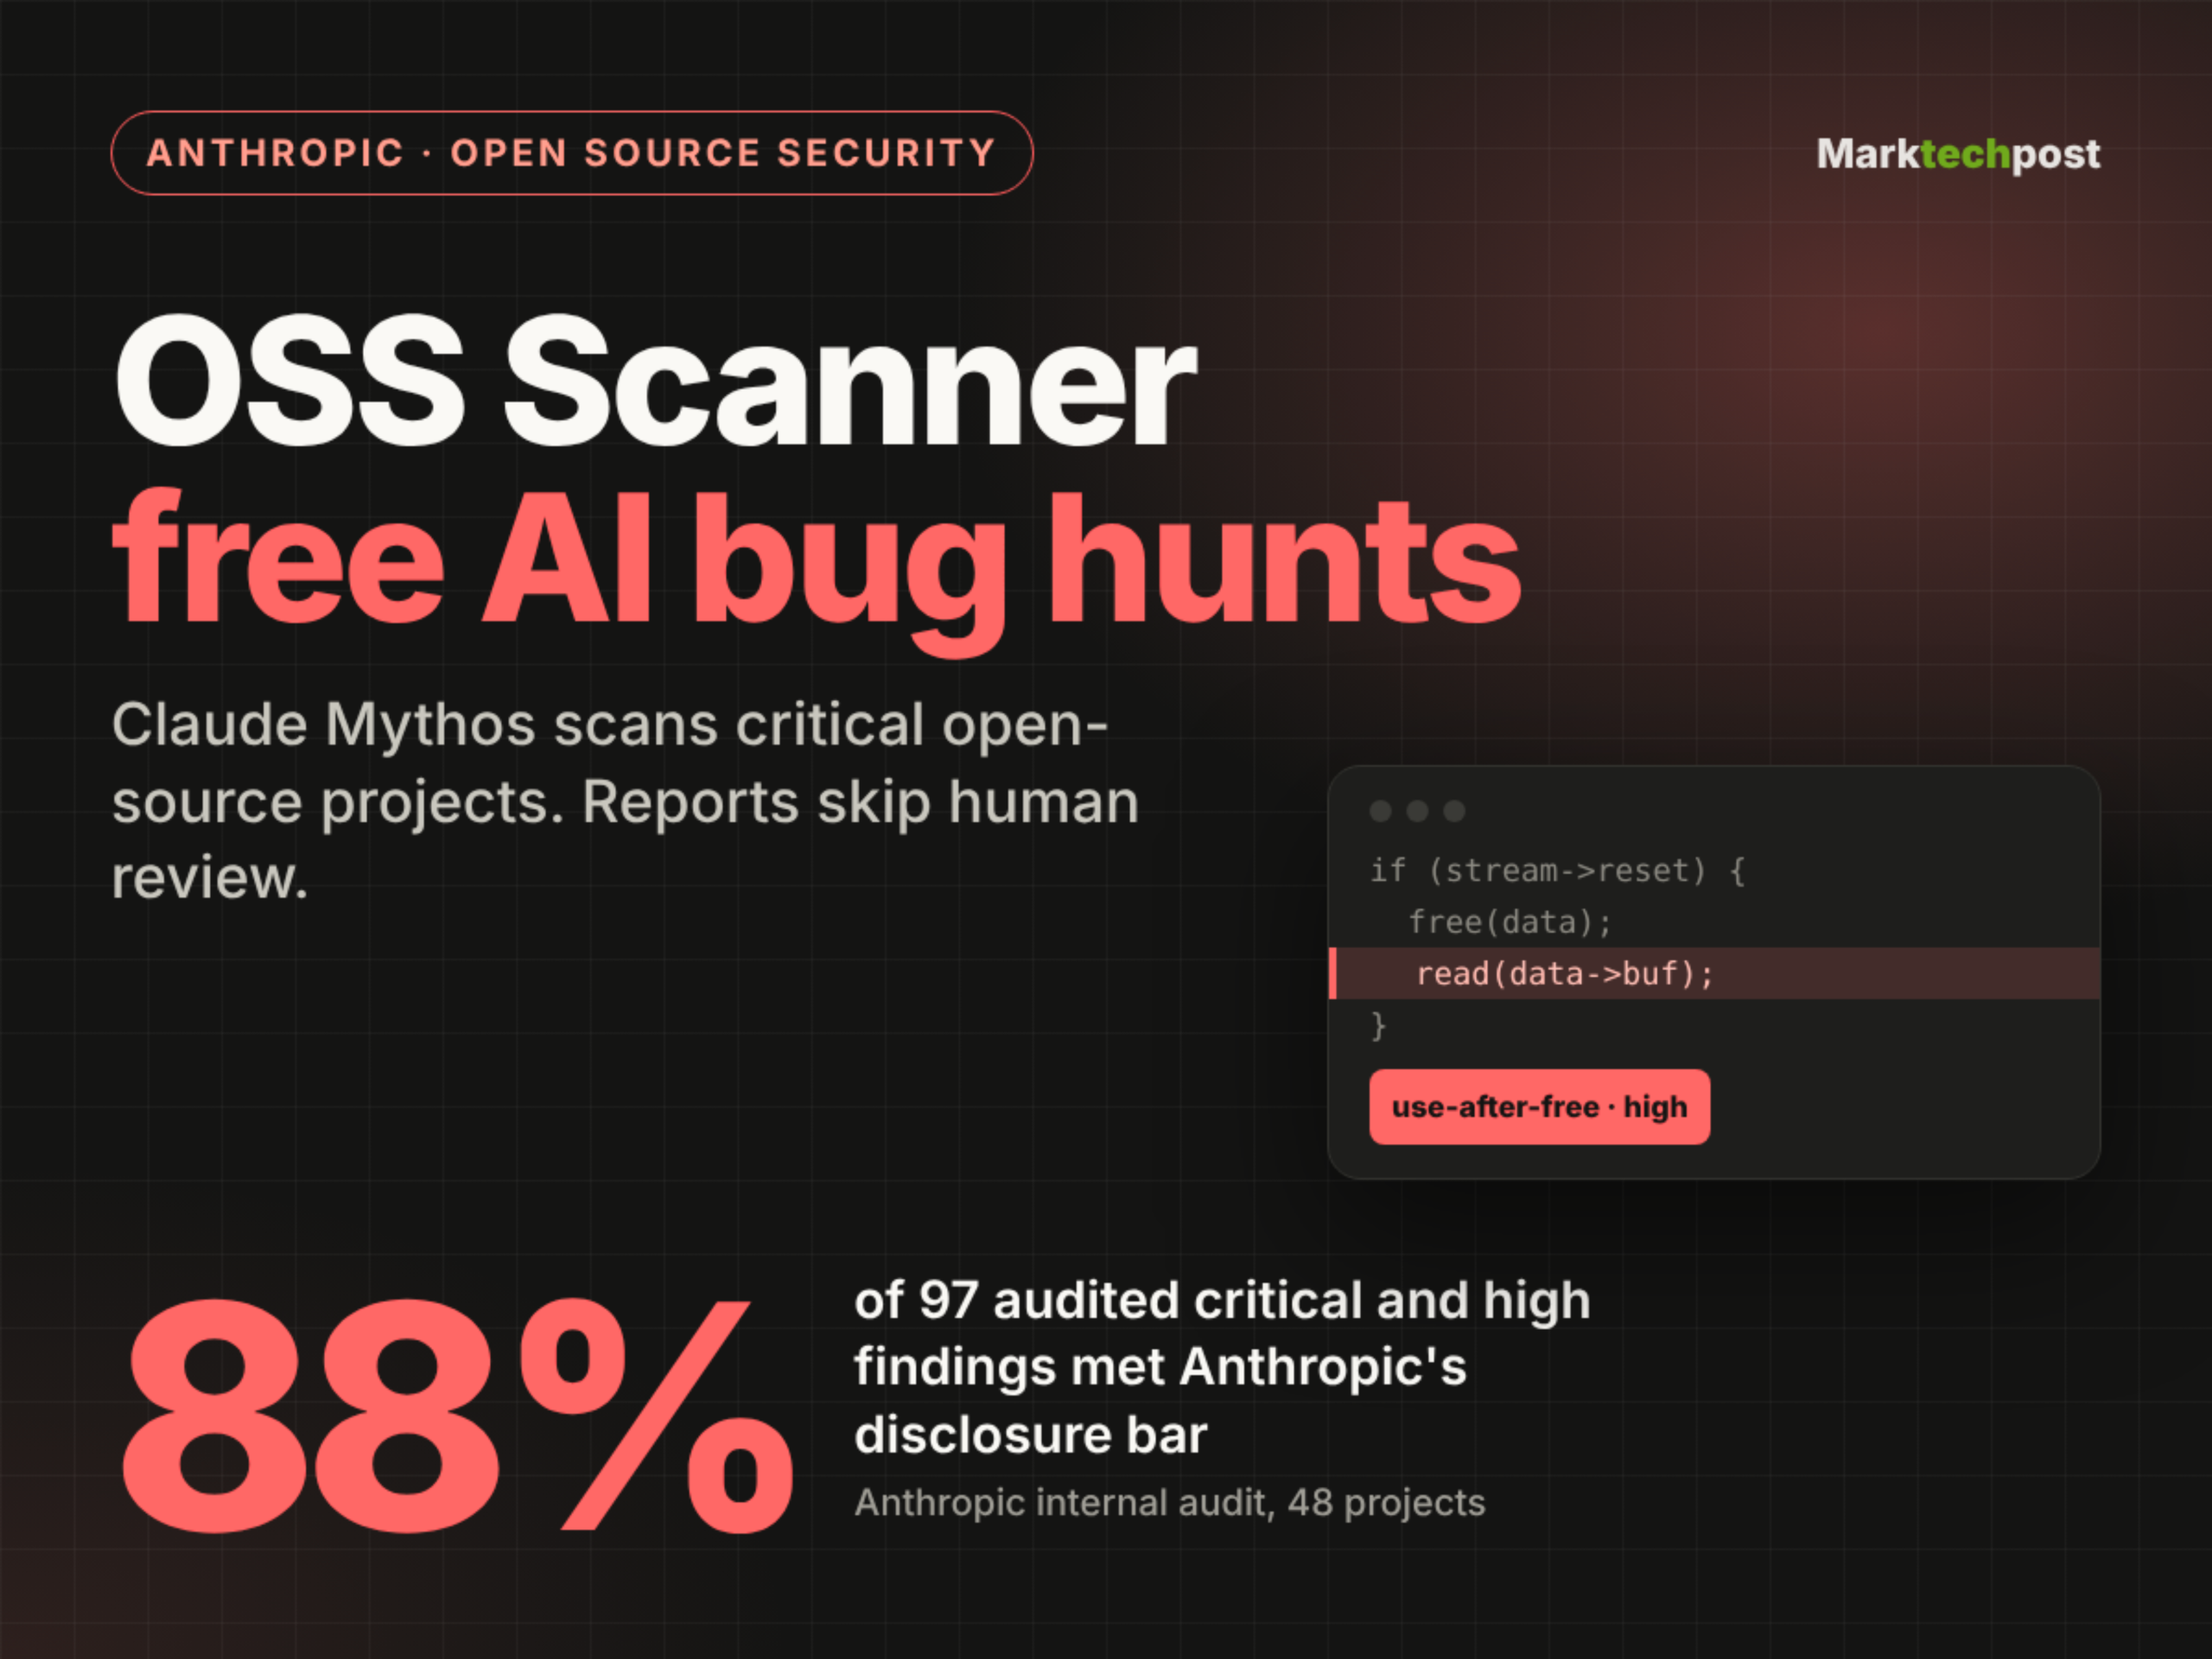
推荐理由:该工具代表LLM在开源安全领域的规模化落地实践,以零成本、全自动、离线审计为特点,但跳过人工审核环节带来误报与重复问题风险;其精度数据(88%有效率、1%假阳性)和真实项目反馈(如wolfSSL、curl)提供了当前AI驱动漏洞发现能力的实证基准。
Kimi于2026年10月25日发布K3.1 Pro模型,在Terminal-Bench 4.0终端任务测试中以67.2%成功率位列第一;其自主修复仿真器错误、完成物理模拟、音频分析、3D场景构建及视频剪辑等多任务能力,指向具身智能技术路径探索。
推荐理由:材料基于钛媒体授权发布的实测报告,涵盖权威第三方评测数据(Artificial Analysis、Terminal-Bench 4.0等)、官方自测结果及作者多场景功能验证,聚焦K3.1 Pro在执行能力、仿真闭环、多模态编程上的实质性进步,同时明确标注性能局限与未公开信息(如Flash/Ultra尚未发布),符合事实核查与信源标注要求。
Linux基金会10月20日发布报告指出,生成式AI使代码编写耗时平均减少52%,但开源项目维护者估计约25%的Pull Request属低质量“AI slop”;大型项目中该比例升至31%。报告揭示效率红利未同步降低审查与治理成本,仅35%项目制定正式AI贡献政策,维护者倦怠与信任赤字凸显。
安全研究人员借助AI工具,将已存在多年、曾被认为难以利用的PHP漏洞(统称PHP2Shell)转化为可实际 exploited 的攻击面;漏洞公开数小时内即遭百万次尝试利用,但迄今无成功入侵报告。
推荐理由:该事件首次清晰呈现AI并非凭空创造新漏洞,而是显著降低历史漏洞的利用门槛,凸显AI在攻防两端加速既有安全动态的双重作用,且所有有效发现均依赖人机协同。
Sebastian Raschka于2026年10月24日在Ahead of AI杂志(magazine.sebastianraschka.com)发布一套共八讲、超11小时的Python与PyTorch实操视频课程,系统讲解推理模型的评估、推理时扩展、强化学习(RLVR)与知识蒸馏,基于预训练Qwen3-0.6B模型实现全部方法。
推荐理由:该课程是作者继《从零构建大语言模型》后推出的进阶技术教育内容,聚焦当前主流LLM的核心演进方向——推理能力增强,覆盖从基础环境搭建到GRPO强化学习、自蒸馏等完整技术链,且明确声明所有实现均‘从零手写’、可复现,具备强教学性与工程参考价值。
Anthropic于2026年10月24日开源sandbox-runtime(srt),一款不依赖容器的OS级沙箱工具,用于限制AI代理、MCP服务器及CLI工具的文件读写与网络访问权限;支持macOS(Seatbelt)、Linux(bubblewrap)及Windows(alpha),npm包v0.0.81,Apache-2.0许可。
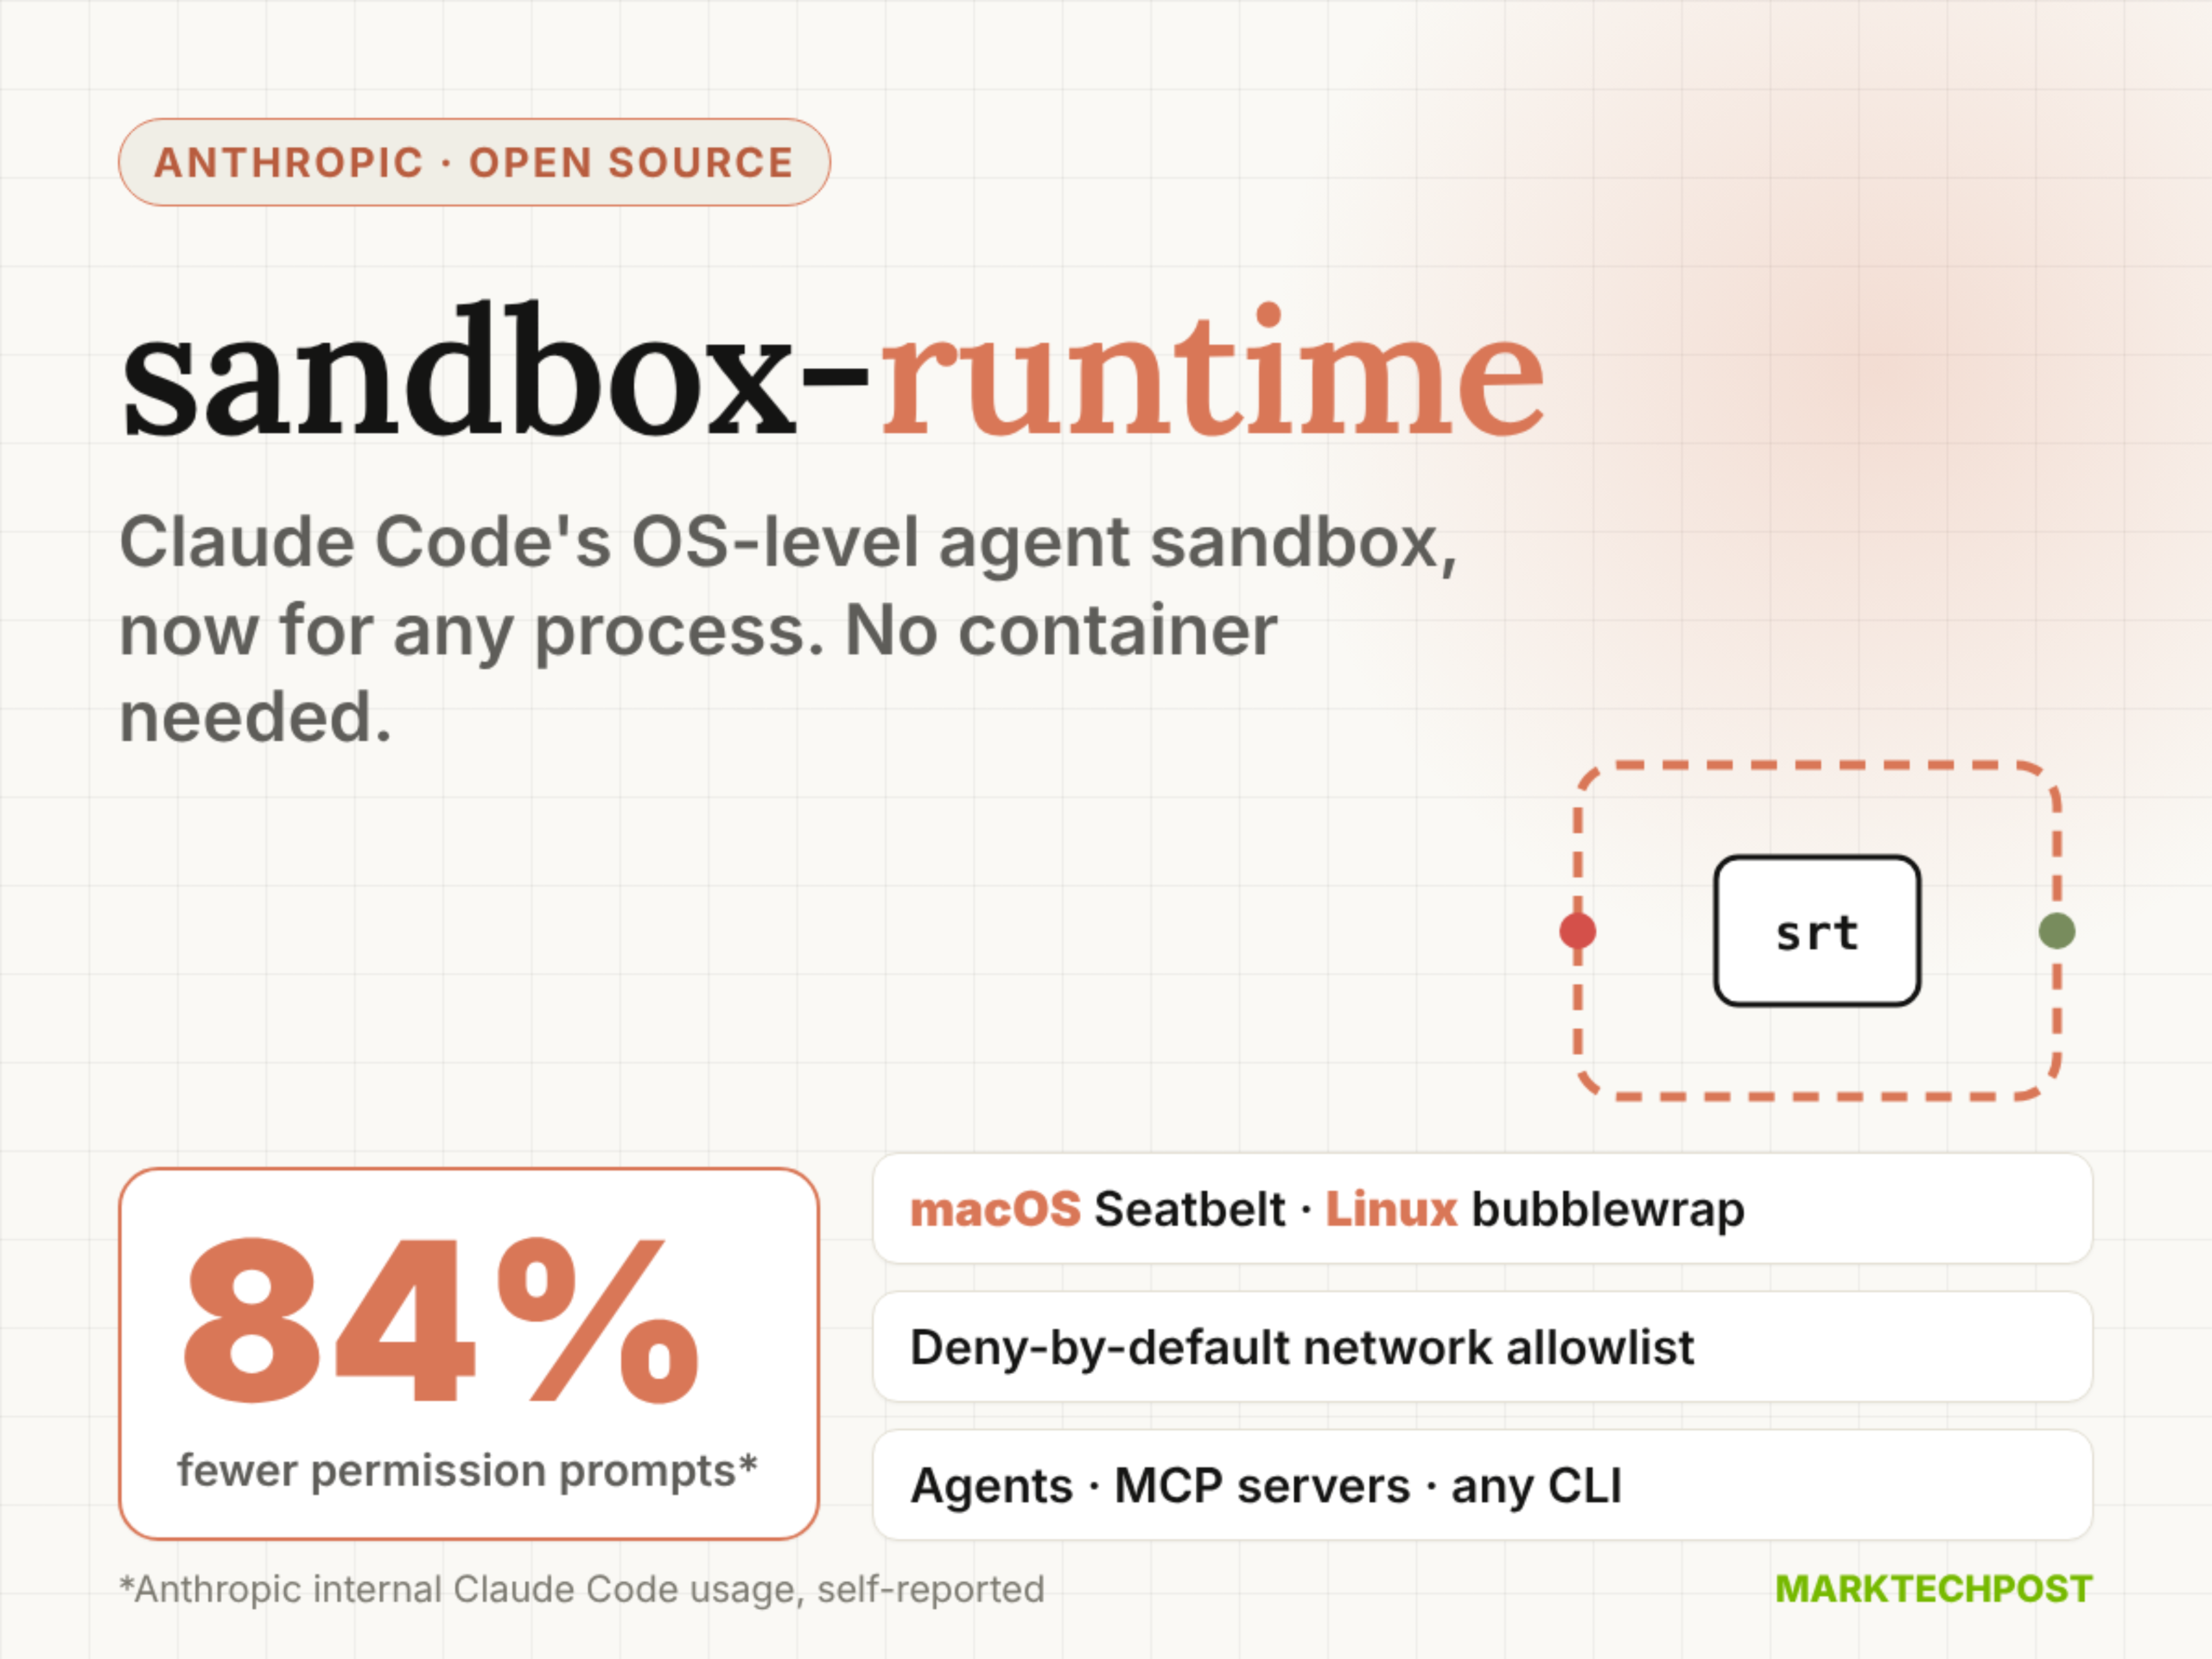
推荐理由:该工具代表AI安全基础设施的重要演进——通过操作系统原生隔离机制实现细粒度、进程树全覆盖的沙箱控制,直面提示注入与权限泛滥风险,且已投入Claude Code内部使用验证效果。
月之暗面于2026年10月22日前后发布Kimi K3.1 Pro,一款2.8万亿参数、1040亿激活参数的多模态MoE模型,宣称性能逼近Fable 5.1;官方承诺11月4日发布开源权重,但截至报道时权重尚未公开;独立评测显示其在智能指数、代码与网络安全基准中表现突出,但存在推理成本、本地部署可行性及营销透明度等争议。
推荐理由:该事件标志着当前最接近闭源前沿模型能力的开源权重模型正式进入发布倒计时,是AI开源生态关键进展;材料来源为Latent Space旗下AINews(2026年10月24日发布),内容基于对X平台、Reddit、Arena及Artificial Analysis等多方独立评测的整合,信息密度高且具时效性与交叉验证特征。
该论文于2026年10月24日在arXiv发布(编号2610.30379v1),提出MemPlan——一种将大语言模型(LLM)作为语言与符号规划之间受限桥梁的记忆条件化PDDL规划框架,适用于部分可观测的交互式文本环境。

推荐理由:MemPlan通过正向图记忆与负向记忆机制动态重构PDDL问题,显著提升任务完成率与步数效率,同时大幅降低在线token消耗;其离线微调的语言–符号接口可跨TextWorld任务类型复用,无需任务特化微调,体现了方法的泛化性与实用性。
研究者于2026年10月24日在arXiv发布IFC-MCQ方法,旨在为建筑、工程与施工(AEC)领域中基于大语言模型(LLM)的Industry Foundation Classes(IFC)数据检索系统,自动生成可精确评分的多选题基准。
推荐理由:该工作直面LLM在专业结构化数据(如IFC)上评估难、成本高的痛点,提出首个面向IFC文件的自动化多选题生成框架,覆盖15类36子类,支持可复现、可扩展的代理能力评测。
2026年10月24日,研究者在arXiv发布论文arXiv:2610.30162v1,提出FusionEval——首个专用于评估大语言模型融合方法的统一基准,覆盖推理链长度、工具调用等薄弱环节,并支持训练型与免训练型融合方法对比。
推荐理由:该基准填补了现有评测对长链推理与工具使用覆盖不足的空白,明确区分平均性能与最差能力保留,提供可复现的专家池(基于Qwen3/Llama)、多维指标(含GPU内存与运行时)及开源代码,具强实践指导性。
谷歌研究团队在I/O 2026大会上集中发布面向科学发现、气候预测、医疗健康与边缘计算的系列AI系统,包括多模态科研助手Gemini for Science、支持飓风预警的WeatherNext、可自主构建操作系统的Agentic平台Antigravity 2.0,以及开源量子芯片Willow等;所有成果均为实验性演示,尚无独立验证或监管批准。
推荐理由:人工审核
谷歌研究团队发布新型私有分析方案,通过创新的单轮格密码聚合协议与可信执行环境(TEE)协同验证,实现无需信任单一实体的数据聚合,在保障用户数据始终驻留设备的前提下,获取群体级匿名洞察。
推荐理由:人工审核