
GPT-6爆改模型权重!数学能力狂飙6倍,MIT博一新作破圈了
新智元报道 这一天还是来了!不用训练、不算梯度,只让GPT-6 Astra改写另一款小模型0.016%权重,数学成绩就能原地暴涨6倍!今天,MIT计算机科学与人工智能实验室(CSAIL)带来的这项新研究,在全网彻底火了。他们首次提出了一个颠覆传统深度学习的新范式,「权重空间编程」。要知道,神经网络的权重文件里全是一眼望不到头...

检索标题、摘要与正文,把分散的信息连起来。
新智元报道 这一天还是来了!不用训练、不算梯度,只让GPT-6 Astra改写另一款小模型0.016%权重,数学成绩就能原地暴涨6倍!今天,MIT计算机科学与人工智能实验室(CSAIL)带来的这项新研究,在全网彻底火了。他们首次提出了一个颠覆传统深度学习的新范式,「权重空间编程」。要知道,神经网络的权重文件里全是一眼望不到头...
arXiv:2610.37867v1 发布类型:新 摘要:食物相似性是检索、推荐、替代等食品计算任务的基础,然而目前对食物表征的评估往往仅着眼于身份的保持。我们探讨在身份之外,食物相似性还会发生怎样的变化:不同的视觉表征如何将食物组织成具有特定关系的邻域,这些邻域又揭示或掩盖了哪些烹饪上的关联,以及这些结构在不同表征之间是否具有一致性。印度菜提供了一个颇具挑战性的场景:在视觉上相似的食物可能拥有不同的烹饪身份,而同一烹饪家族内的食物在外观上却可能存在显著差异。本文基于扩展后的Khana数据集,并使用七种涵盖卷积神经网络、Transformer等架构的预训练视觉表征,
arXiv:2610.38355v1 发布类型:新摘要:KV缓存复用能够加速大语言模型的推理,但现有系统将主机DRAM和NVMe SSD视为分层结构,其中DRAM充当中间缓存。然而,实际的大语言模型工作负载打破了这一分层结构的两个前提。首先,双模态复用使DRAM的时间过滤失效,因为工作负载要么由具有较长复用距离的一次性块主导,要么由超过DRAM容量的数GB级智能体会话主导,从而将SSD置于关键的读取路径上。其次,DRAM的暂存与按驱逐顺序布局导致SSD恢复出现瓶颈。为在途前缀保留主机暂存缓冲区会在负载下引发争用,进而中止预取操作;而增量式驱逐则会将会话的块分散到整个SSD上,阻碍大规模顺序读取。我们 p
arXiv:2610.36178v1 发布类型:新 摘要:我们无需抽样误差,即可测量当被要求生成一个随机数时,语言模型为1至N之间的每个整数所分配的概率。对于固定的提示词,模型会定义一个概率向量;我们通过累加每个整数的得分拼写来计算该向量,而非采用抽样估计,从而消除了限制早期研究[1, 4]的噪声。我们在两个推理栈上,针对多达N=100的五个范围,评估了18条开放权重模型系列,并采用了29种解码配置;其中15个模型同时拥有基础版和指令微调版的检查点,且两者均能给出可用的答案。指令微调使这15对模型中的分布更加不均匀,它引入了一种避免使用整数的启发式方法,并强化了另一种避免接近端点的启发式方法。基础检查点
Google DeepMind 在面向可信测试人员的研究预览中发布了 Genie 4,这是一款具备实时音频、更逼真模拟以及中期模拟文本提示的世界模型。
如今,全球有5700万人患有痴呆症。对于那些致力于帮助他们的研究人员而言,阻碍并非缺乏努力,而是数据过于庞大、能够整合这些数据的专家严重不足,以及研究发现的速度远远跟不上疾病发展的步伐。生物医学研究与人工智能联盟在[…]
Edge Sound Research Inc. 今日宣布已筹集200万美元新融资,用于构建一种音频基础设施,该设施能够分离出有用的声音,并将其与其他传感器数据相结合,以帮助物理人工智能系统实时理解当前发生的情况。本轮融资由 Stormbreaker Ventures 领投,使公司累计融资额达到900万美元。当…… 该文章“Edge Sound 融资200万美元,助力物理人工智能理解音频”首发于 SiliconANGLE。
Crunchbase的数据显示,2026年面向机器人初创企业的风险投资大幅飙升,其中大部分资金流向了位于中国和美国的公司。总体而言,第三季度全球对机器人初创企业的风险投资总额达到99亿美元,较2025年第三季度的43亿美元翻了一倍多。
# [3.0.0](https://github.com/n8n-io/n8n/compare/n8n@2.45.0...n8n@3.0.0)(2026-10-27)### 问题修复 * 在工件下载按钮上添加文件类型提示工具提示([#41490](https://github.com/n8n-io/n8n/issues/41490))([4a74f02](https://github.com/n8n-io/n8n/commit/4a74f027e612f31098b354dd3a77b2c2ab98281c)) * **ai-builder:** 检查执行权限:在 Assistant 执行读取时进行检查([#41863](https://github.com/n8n-io/n8n/issues/41863))([a967486](https://github.com/n8n-io/n8n/commit/a9674866d075e989a5ce896432262c9a7dc8b0c7)) * **ai-builder:** 通过已配置的 AI 传输通道发送 Assistant 模型调用([#41948](https://github.com/n8n-io/n8n/issues/41948))([9b63561](https://github.com/n8n-io/n8n/commit/9b63561cbb48f06d216f27be3b77722d97e4e74a)) * 支持自定义 OAuth2 范围([#41249](https://github.com/n8n-
# [2.46.0](https://github.com/n8n-io/n8n/compare/n8n@2.45.0...n8n@2.46.0)(2026-10-27)### 修复的缺陷 * 在工件下载按钮上添加文件类型提示工具提示([#41490](https://github.com/n8n-io/n8n/issues/41490))([4a74f02](https://github.com/n8n-io/n8n/commit/4a74f027e612f31098b354dd3a77b2c2ab98281c)) * **ai-builder:** 检查执行权限:在 Assistant 执行读取操作时进行检查([#41863](https://github.com/n8n-io/n8n/issues/41863))([a967486](https://github.com/n8n-io/n8n/commit/a9674866d075e989a5ce896432262c9a7dc8b0c7)) * **ai-builder:** 通过已配置的 AI 传输通道发送 Assistant 模型调用([#41948](https://github.com/n8n-io/n8n/issues/41948))([9b63561](https://github.com/n8n-io/n8n/commit/9b63561cbb48f06d216f27be3b77722d97e4e74a)) * 支持自定义 OAuth2 范围([#41249](https://github.com/n8
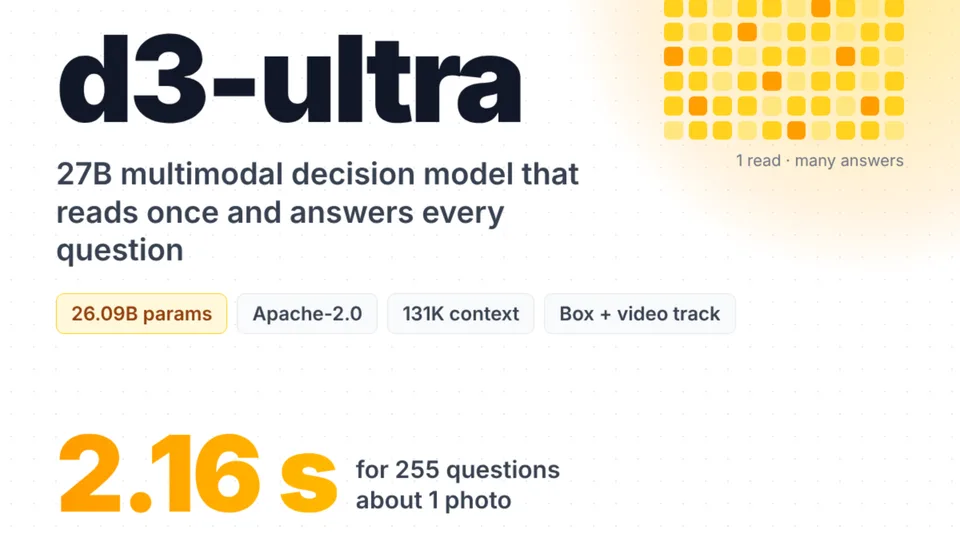
vLLM 语义路由器发布了 d3-ultra,一款拥有 270 亿参数的开源多模态决策模型。它能够一次性读取文本、图像和视频,并为每个可能的答案返回概率,在该团队的 SR-Text 测试中取得了 87.2 分。原文“vLLM 语义路由器发布 d3-ultra:一款 270 亿参数的开源多模态决策模型”首发于 MarkTechPost。
arXiv:2610.33065v1 发布类型:新 摘要:由于头皮记录存在噪声、空间分辨率较低,且在不同试验和受试者之间具有较大差异,脑电图(EEG)的视觉解码仍然十分困难。大多数系统将每次试验与一个密集的图像嵌入对齐,然而该嵌入同时混杂了语义内容以及与具体实例相关的纹理、姿态和背景信息。这种做法往往需要EEG本身并不具备的细节信息,且未能明确说明支持预测的视觉因素。我们提出\textbf{ProtoEEG},一种基于原型的框架,它将EEG与图像的对齐问题重新表述为在共享的可学习视觉码本之上进行软性组合。一个可训练的EEG编码器与一个冻结的视觉教师共同生成针对同一$K=64$个原型的分配分布。它们的加权重构构成了一种结构化的表征
arXiv:2610.33019v1 发布类型:新 摘要:随着多模态智能体开展持续交互,长期记忆发挥着两种既 distinct 又互补的功能:细粒度的证据召回,以及用于全局理解的内化解读。尽管情景记忆与隐式记忆分别通过显式的历史记录和内化的经验来满足这些需求,但由于情景记忆在证据覆盖与整合方面存在局限,而隐式记忆又缺乏扎实的事实基础,单一的范式难以兼顾不同任务间多样化的记忆偏好。为弥合这一鸿沟,我们提出了一种双记忆框架,将模型原生的隐式记忆作为直观的先验,同时结合多索引的情景记忆,通过检索驱动的联合对齐实现精确的证据重建。在 i

arXiv:2610.33062v1 发布类型:新 摘要:统一的大型多模态模型(ULMMs)能够通过交错进行的文本-图像生成来执行视觉推理,但生成显式的中间图像会带来显著的计算开销。尽管视觉潜在推理可以解决这一问题,但现有方法大多依赖于无法进行视觉生成的视觉-语言模型(VLMs)。我们提出了一种名为Oddin的新框架,能够在ULMMs中实现潜在的视觉推理。Oddin用紧凑的潜在标记取代中间图像,这些标记完全由理解分支处理,而生成分支则专门用于生成最终输出图像。我们通过离线自蒸馏训练该模型,包含三项优化目标:最终图像生成损失、文本蒸馏损失以及交叉熵损失,用于
2026年10月26日,arXiv发布论文arXiv:2610.31838v1,提出Sense-Aligned Grounding Evaluation(SAGE)——一个统一的10候选图像选择基准,并配套训练无关的Gloss-Augmented Reasoning(GAR)框架,用于跨名词、动词和实体中心的多模态接地评估。
推荐理由:该研究首次将VWSD、VerSe和WikiDiverse三类任务统一为术语中心的接地评测协议,引入混淆难负样本与上下文交换诊断机制,并通过实证表明定义增强与约束引导推理的协同可显著提升Hits@1指标(65.90→71.22),为多模态语义对齐提供了更细粒度、可解释的评估新范式。
一项发表于arXiv(编号2610.31682v1)的新研究,利用言语运动、面部表情、声学韵律及话轮转换等多模态特征,在三个包含自闭症与非自闭症参与者的自发双人互动数据集上,预测参与者自身对对话成功程度的主观感知。

推荐理由:该研究突破以往聚焦诊断分类或单模态分析的局限,首次系统整合互补性多模态行为指标来建模‘感知到的对话成功’这一社会沟通核心维度,为提升神经多样性人群交流支持技术提供新方法论依据;论文已公开发布,时间戳与当前系统时间一致,属最新学术进展。
arXiv:2610.32022v1 发布类型:新 摘要:在人机交互中,意图识别要求智能体通过推断说话者的潜在目标来化解含糊不清的自然语言指令。近年来,研究日益聚焦于两种颇具代表性的范式来应对这一任务:结构化符号推理与多模态输入增强。然而,在那些歧义源于未明示的人类意图而非缺失可观测场景信息的情形下,基于增强的方法是否确实具有优势,仍不明确。本文开展了一项对比与诊断性研究,将采用结构化社会与具身推理的FISER框架与CEMIR(上下文增强型多模态意图识别)方法进行基准测试——后者是一种实施多模态增强的技术。
arXiv:2610.32389v1 发布类型:新 摘要:在大型语言模型的强化学习(RL)中,从滚动阶段到训练阶段的轨迹迁移既会影响学习质量,也会降低系统效率。强制执行全批训练要求可能会延迟已完成轨迹的准入,从而导致更高的架构陈旧性——即与集中式执行相比,采用分散式流水线所带来的额外参数版本差距。除了准入问题之外,数据访问与训练消耗之间的错配还会在传输大型轨迹负载时引发冗余移动和不必要的等待。我们提出了 KnitTrans 系统,通过三项设计来协调滚动到训练的路径。首先,基于约束保持的迷你批次准入机制能够在早期迷你批次组合方面提供灵活性……
2026年10月26日,arXiv发布预印本论文(编号2610.31685v1),提出一种基于冻结大模型的可追溯多模态情绪推理智能体架构,通过模态专用感知智能体、集成智能体、MLLM批评者及证据验证阶段实现错误归因与提示空间自适应优化,在MER2025数据集上提升多个开源多模态大模型(2B–38B参数)的情绪识别F-score达0.6–2.2分。
推荐理由:该研究针对当前多模态情绪推理系统在指令微调成本高与智能体流水线不可调试之间的矛盾,提出首个融合证据引用、确定性验证、失败归因与靶向提示修补的全流程可解释框架;所有改进均不修改模型权重,且在四个不同规模开源MLLM上实证有效,具备方法论创新性与工程实用性。
arXiv:2610.32069v1 发布类型:新 提要:近期的多模态大型语言模型(MLLMs)能够在单一模型内感知交通场景、进行推理并提出驾驶决策。然而,现有的基于MLLM的自动驾驶系统在每一帧都从零开始推理,并且仅采纳一种解释,从而舍弃此前关于场景的假设。当场景存在歧义时,智能体便会锁定错误的解读,并在证据尚未充分积累之前据此采取行动。本文提出了DriveMind,一个基于MLLM的驾驶框架,它能够同时维持多个关于场景的假设,并随着新帧的到来不断更新这些假设的权重。受粒子滤波的启发,DriveMind通过视觉语言模型(VLM)传播每个假设,根据当前观测对其进行评分,并重新采样以……