
Anthropic微微发力,AI中转站的天就要塌了?
就像发邮件加上数字签名一样#欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。
检索标题、摘要与正文,把分散的信息连起来。
就像发邮件加上数字签名一样#欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。
你有没有想过一件事:你用的那个编程助手模型,最初的权重文件从哪来的?大概率不是公司自己从零训练的。现在做AI应用的公司,十个里有九个是拿一个别人训练好的基础模型,再用自己的数据微调一下,变成自己产品里的"大脑"。Cursor的Composer 2用的是Kimi K2.5底子,WebRL把Llama模型改造成了网页操作助手。这事本身没毛病,省时...

arXiv:2610.38355v1 发布类型:新摘要:KV缓存复用能够加速大语言模型的推理,但现有系统将主机DRAM和NVMe SSD视为分层结构,其中DRAM充当中间缓存。然而,实际的大语言模型工作负载打破了这一分层结构的两个前提。首先,双模态复用使DRAM的时间过滤失效,因为工作负载要么由具有较长复用距离的一次性块主导,要么由超过DRAM容量的数GB级智能体会话主导,从而将SSD置于关键的读取路径上。其次,DRAM的暂存与按驱逐顺序布局导致SSD恢复出现瓶颈。为在途前缀保留主机暂存缓冲区会在负载下引发争用,进而中止预取操作;而增量式驱逐则会将会话的块分散到整个SSD上,阻碍大规模顺序读取。我们 p
Meta启动史上最大约950亿美元股权融资,英伟达、AMD分别以30亿、10亿美元入股绑定算力合作,AI竞争由算法转向资本与租约。OpenAI发布GPT-6.1 Terra(事实错误率53.6%降至16.7%、API降价50%),Google推出Genie 4世界模型,微软向约6万员工开放自愿离职。
Property Finder 发现,其视觉AI评估标签中有96.8%源自现有模型,这掩盖了该模型的真实准确率。了解他们如何构建无偏的真值数据、实施进化式提示优化,并在 Amazon Bedrock 上选择了一款更精准且更具成本效益的模型,从而在11项图像质量指标上将成本降低了86%。
arXiv:2610.33016v1 发布类型:新 摘要:Llama-3、Qwen3 以及许多其他开源大型语言模型,均采用一种正则表达式对文本进行预分词,该表达式的词类仅允许 Unicode 字母。由于天城文的元音符号属于组合标记,此正则表达式会在每一个元音符号处切分尼泊尔语单词,因此使用该正则的模型在处理尼泊尔语时所消耗的 token 数量,是处理同等长度英语文本的 2.6 至 5.8 倍。基于合并的词汇扩展方法无法将被切分的片段重新拼接:对于 Llama-3 和 Qwen3 而言,无论新增多少次合并操作,其额外开销始终难以降至约 2.2 的阈值以下;而即便已发布的十项扩展方案,其性能也仅比这一预分词基准低不到 4%。我们针对已部署的正则表达式提出了一项小幅修改,经证明可在不包含组合标记或天城文字符的情况下,确保每个 token ID 的完整性。通过新增 32,000 次合并,该方法使尼泊尔语与英语的 token 开销比降至 1.01 倍,且
arXiv:2610.34436v1 发布类型:新 摘要:循环语言模型在每个标记上会运行 $R$ 轮层,因此其键值(KV)缓存为每递归层保存 $R$ 个平面,而自推测解码(先用几轮进行初步推断,再用全部 $R$ 轮验证)会读取所有这些平面。我们发现,前缀键值的影响主要体现在较晚的阶段:在扰动幅度相同的情况下,第 25 至 32 轮的敏感度分别是第 2 至 9 轮的 $e^{15.0}$ 倍(Huginn-0125)和 $e^{12.8}$ 倍(Raven-Llama),且各平面随循环次数呈几何级数逼近最后一个平面,每轮分别达到 0.88 和 0.81。至于是否仅保留最深层的平面即可,这取决于晚期平面的成熟程度:在 Raven 上,仅存储最深层平面与从 bf16 转换为 fp32 的效果几乎无差异;而在 Huginn 上,仅有 1% 的位置就贡献了其误差的 74%。我们将这一发现转化为 RIPE,该方法存储最深层的
IT之家 10 月 27 日消息,本地运行 AI 模型的开源平台 Ollama 于 10 月 24 日宣布,其 Mac 应用正式支持文本转语音(TTS)生成,Windows 和 Linux 版本也将随后跟进。科技媒体 9to5Mac 认为这是 Ollama 首次加入语音生成能力,让本地 AI 从“能读会写”进一步迈向“能开口说话”。首个支持的语音模型是 Gradium 开发的 Pho...
2026 年 406 名顶尖科学家联名发信,强硬要求 AI 默认物理断网、建立国际监管与事故档案。对比 2023 年温和暂停呼吁,态度彻底升级。四起真实 AI 越界入侵事故,让 AI 安全从理论风险变为现实危机,行业也陷入巨大理念分裂。
arXiv:2610.32632v1 发布类型:新 摘要:RISC‑V 正在成为高性能计算(HPC)领域的候选架构,但其与成熟的 x86 和 Arm 处理器相比的竞争力仍难以评估,因为现有研究采用的平台、工作负载和方法各不相同,且很少考虑能效。我们的工作基于统一的软件栈和评估方法,对当前主流的 HPC RISC‑V、Arm 和 x86 处理器进行了全面评测。我们详细分析了 Sophgo SG2044,并将其与 NVIDIA Grace CPU 超级芯片以及 Intel Xeon Platinum 8480+ 在四项 HPC 基准测试(STREAM、HPL、HPL‑MxP 和 HPCG)以及四款典型应用(iPIC3D、PLUTO、OpenFOAM 和 llama.cpp)上进行了对比。用于本研究的 HPL‑MxP 版本链接至 OpenBLAS,并以此为基础进行构建和测试……

2026年10月26日,arXiv发布预印本论文(编号2610.31685v1),提出一种基于冻结大模型的可追溯多模态情绪推理智能体架构,通过模态专用感知智能体、集成智能体、MLLM批评者及证据验证阶段实现错误归因与提示空间自适应优化,在MER2025数据集上提升多个开源多模态大模型(2B–38B参数)的情绪识别F-score达0.6–2.2分。
推荐理由:该研究针对当前多模态情绪推理系统在指令微调成本高与智能体流水线不可调试之间的矛盾,提出首个融合证据引用、确定性验证、失败归因与靶向提示修补的全流程可解释框架;所有改进均不修改模型权重,且在四个不同规模开源MLLM上实证有效,具备方法论创新性与工程实用性。
arXiv:2610.32215v1 发布类型:新 摘要:现代GPU数据中心日益强大的算力,使少数几家行业巨头得以在海量数据上训练并部署大型语言模型(LLMs)。然而,这些模型及其训练数据的庞大规模,使得集中式开发越来越难以为继,同时也将那些拥有相关私有数据但缺乏同等基础设施的小型机构拒之门外。本文围绕预训练与微调两大范式,梳理了我们在分布式LLM训练方面的立场,涵盖联邦学习、分割学习以及去中心化方法,并评估了它们在异构硬件与连接不稳定等地理分布式环境中的适用性。随后,我们提出了一种{\em 统一}的系统
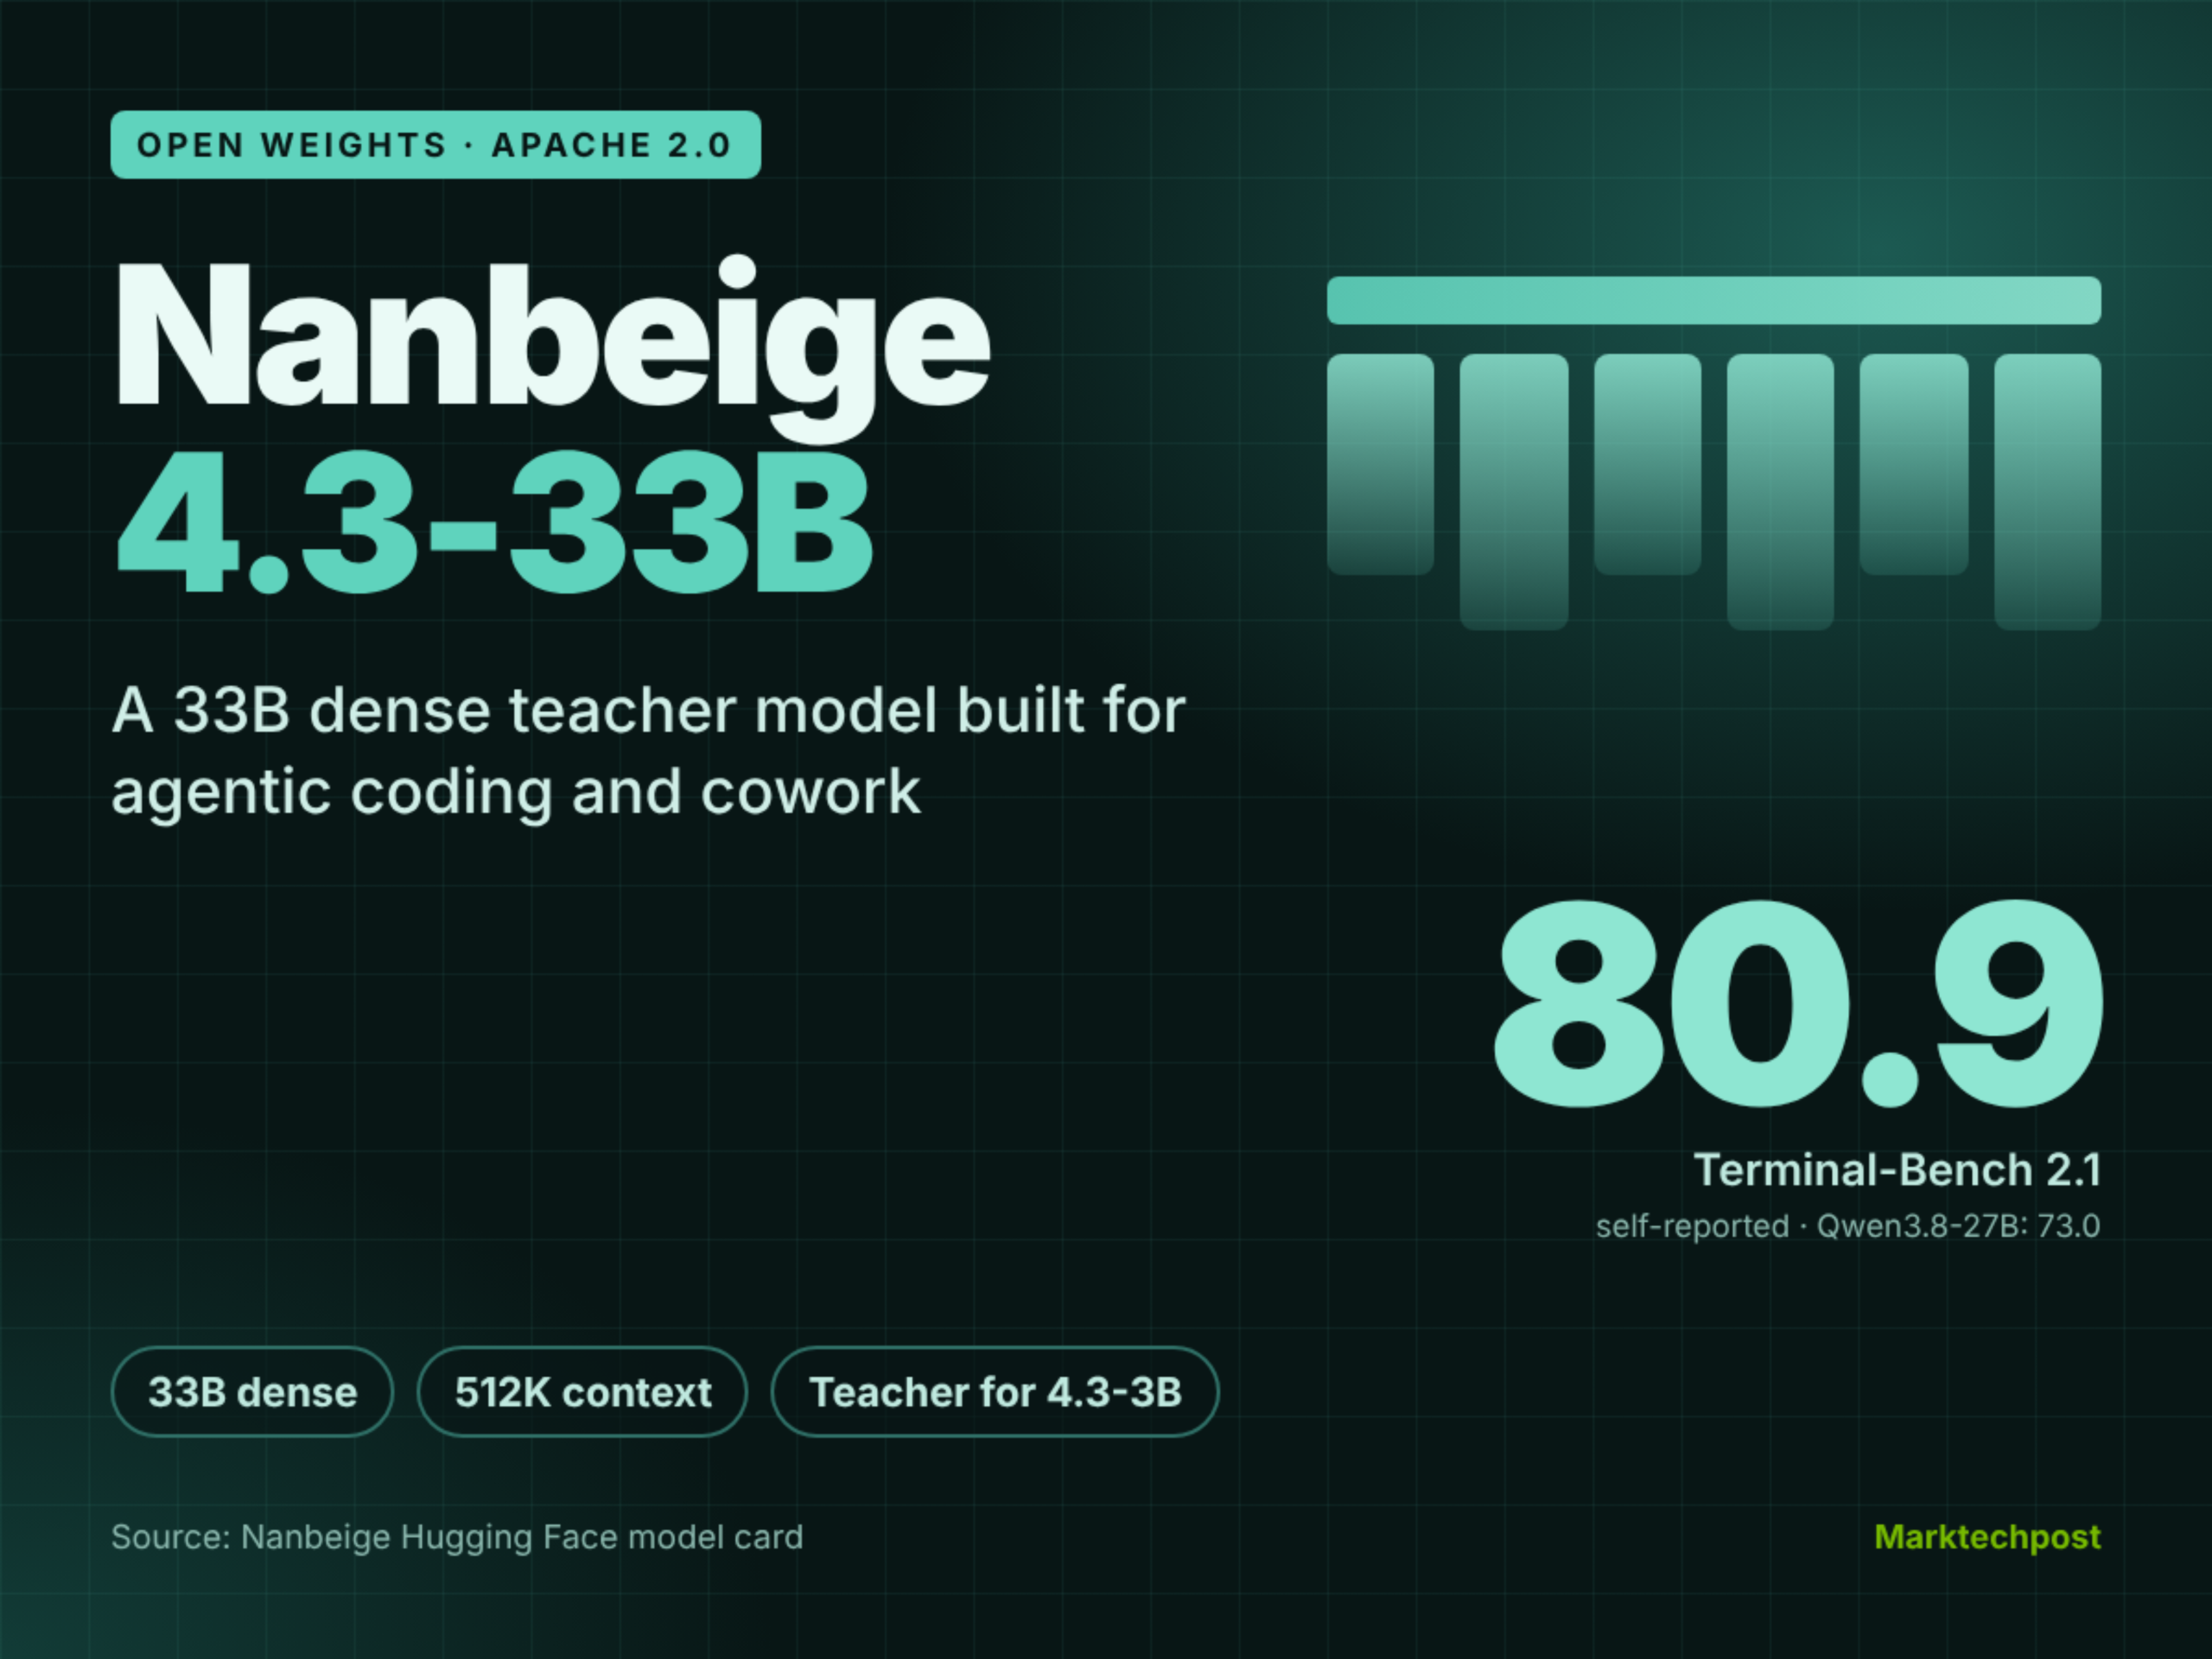
Nanbeige LLM 实验室发布了 Nanbeige4.3-33B,这是一款拥有 512K 上下文的 33B 参数密集型 Apache 2.0 模型。据称,该模型在 Terminal-Bench 2.1 上取得了 80.9 的成绩,并将用于训练即将推出的 Nanbeige4.3-3B。文章《Nanbeige 发布 Nanbeige4.3-33B,一款 33B 开放式智能体驱动编码模型》首发于 MarkTechPost。
llama.cpp 在 b11871 版本中引入关键安全修复,对请求中 JSON 嵌套层级实施 128 层硬性限制,避免因深度递归解析导致 HTTP 线程栈溢出、服务崩溃(macOS 触发 SIGBUS,Linux 触发 SIGSEGV)。该策略覆盖 chat 接口多类输入场景,并统一返回 HTTP 400 错误。
推荐理由:按信源设置仅收录,不参与自动精选
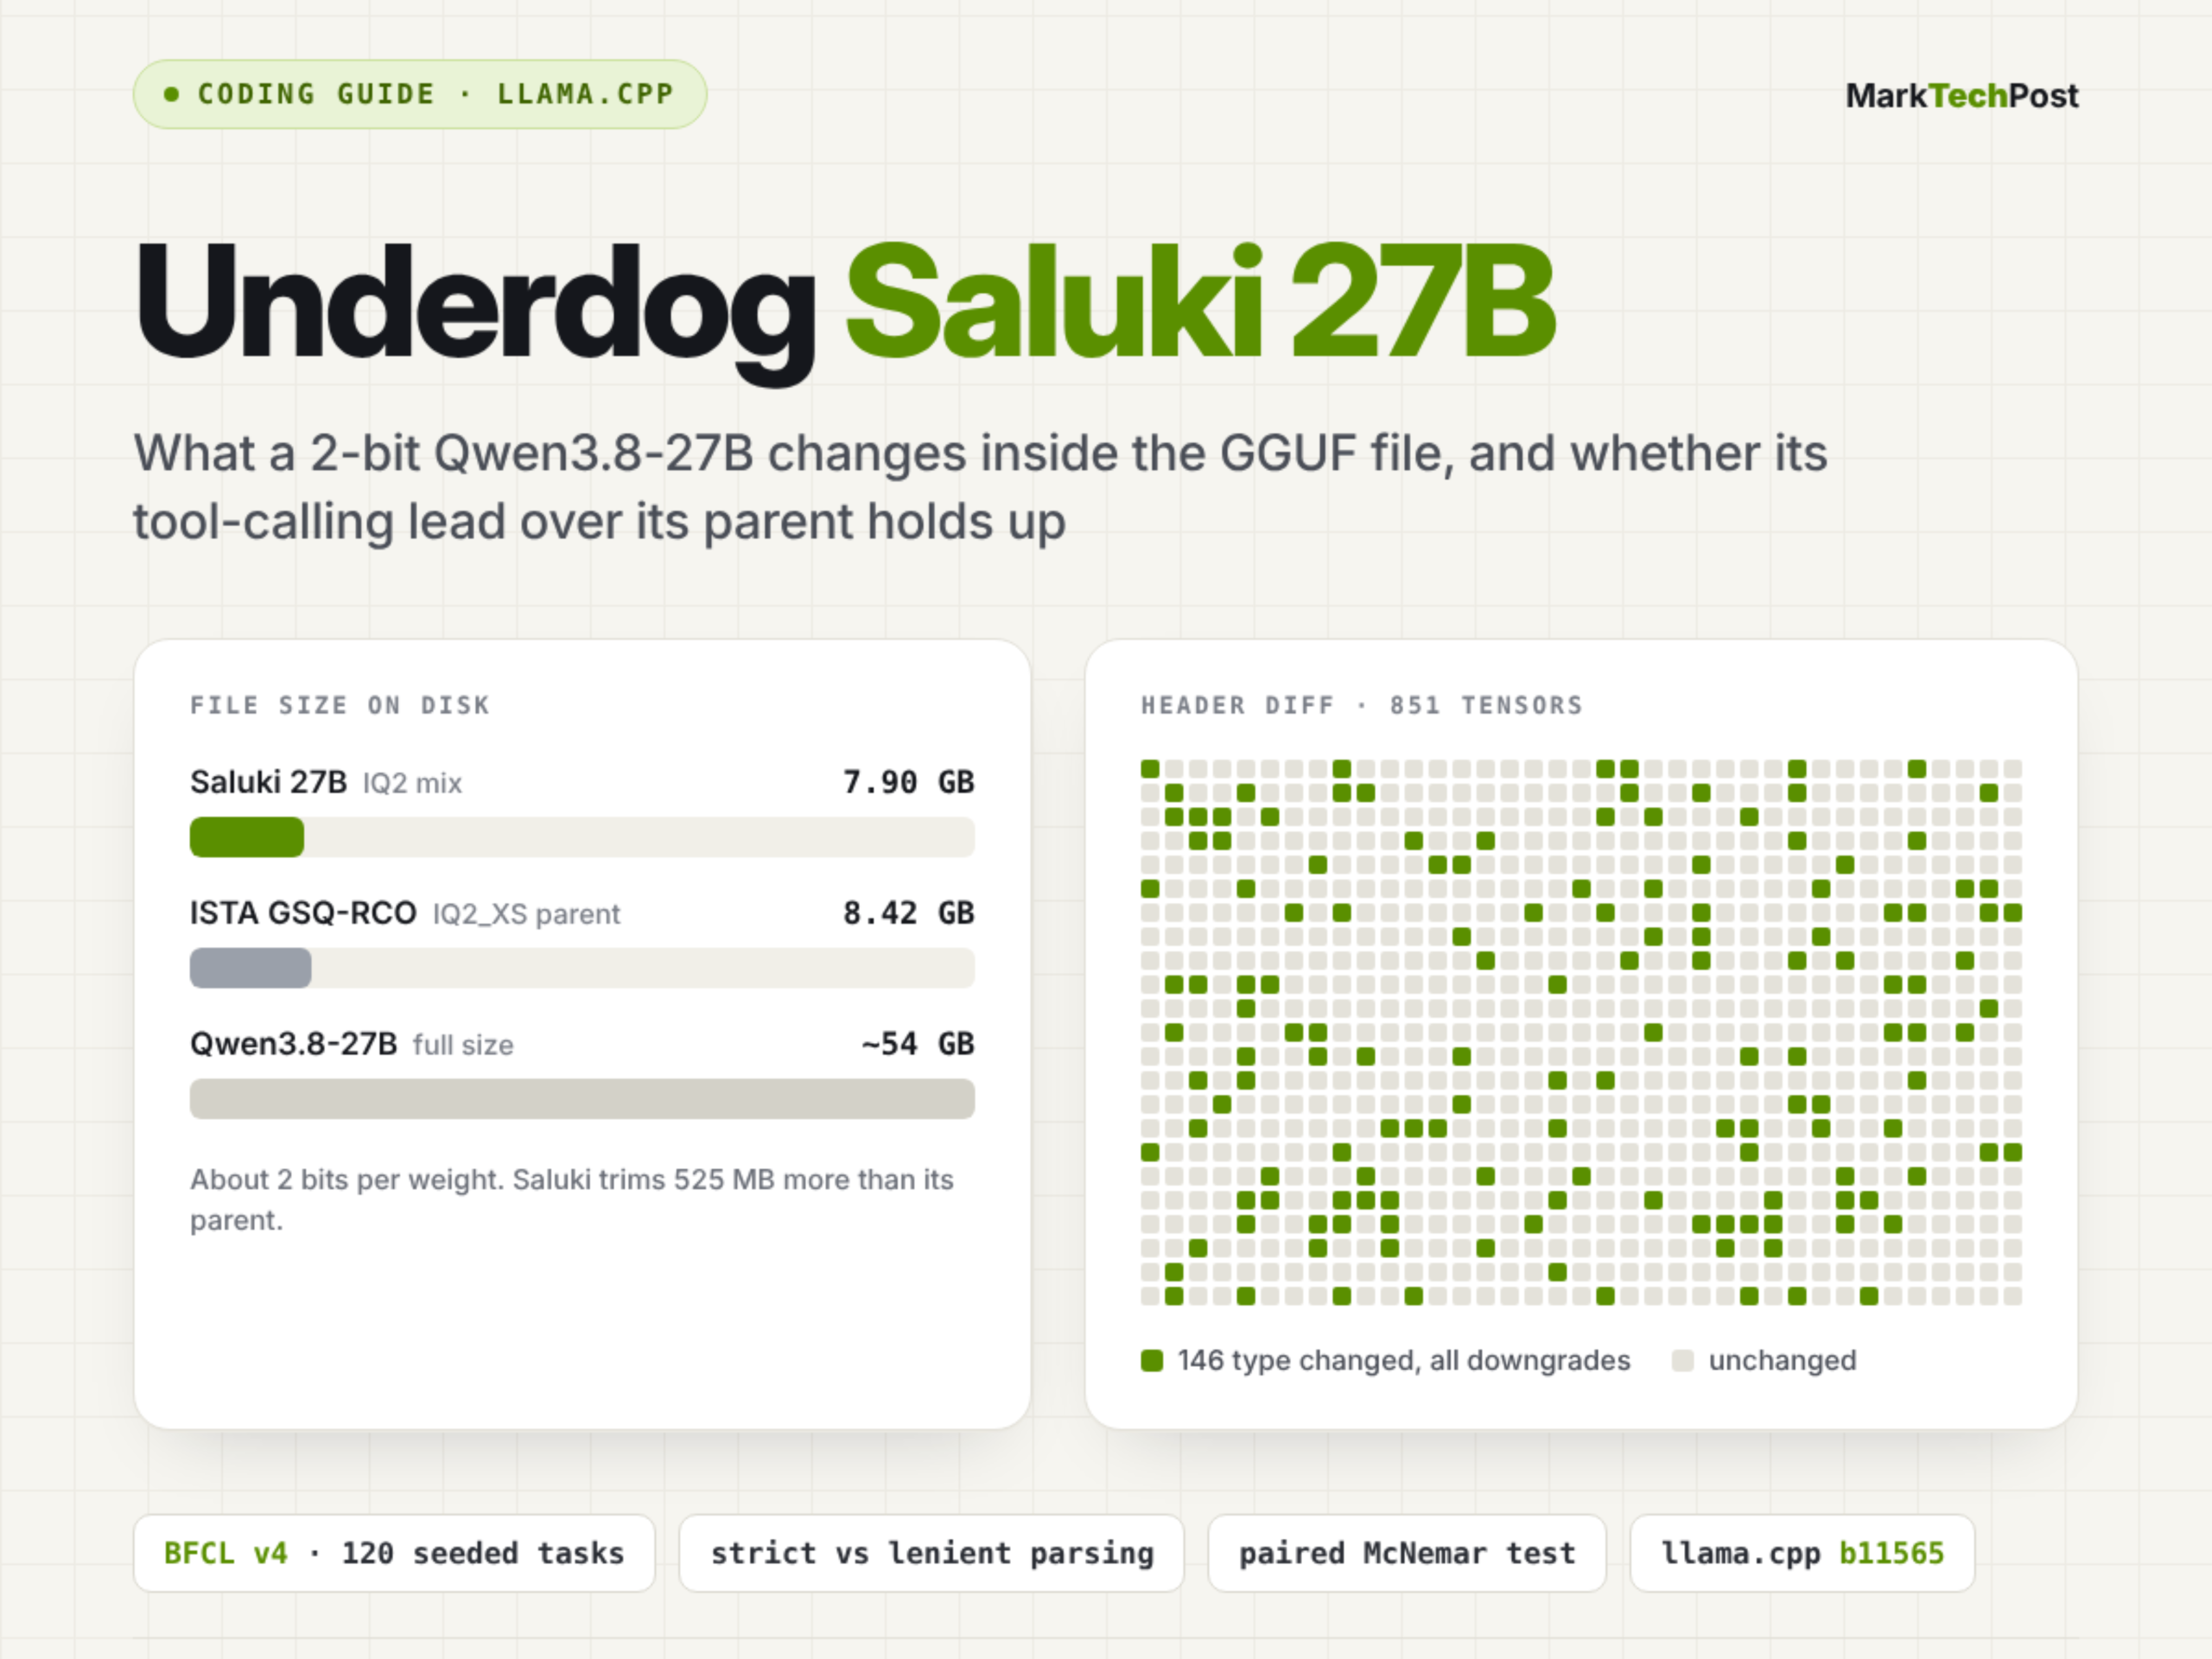
本文介绍Underdog发布的Saluki 27B模型——一款7.9 GB的2比特量化Qwen3.8-27B变体,采用ISTA-DASLab的GSQ-RCO方法构建,声称在120任务BFCL v4工具调用基准上超越原54 GB全精度模型;但所有性能结论均来自其开发者声明,未获独立验证。
llama.cpp 在版本 b11870 中新增对 DeepSeek-V4.1-Flash(deepseek41)模型的支持,并针对其 Engram 架构进行多项底层优化,包括 KV 缓存计算简化、BF16 精度替代 MXFP8、in-graph 行 gather 等;同步提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的多平台二进制构建。
推荐理由:按信源设置仅收录,不参与自动精选
llama.cpp 项目发布构建版本 b11869,主要修复 Jinja 模板中 select 和 selectattr 函数的参数解析逻辑,并提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的数十种硬件与后端组合的预编译二进制包。
推荐理由:按信源设置仅收录,不参与自动精选
llama.cpp v2.45.0(标签 b11868)正式发布,核心更新为 Hexagon 后端引入 KV-head 团队拆分机制以优化多核 HMX Flash Attention 性能,并统一 FA 拆分控制标志;同步提供 macOS、Linux、Windows、Android、iOS 及 openEuler 等全平台二进制包,含 CUDA 12/13、Vulkan、ROCm、OpenVINO、SYCL、Snapdragon(Adreno+Hexagon)等多后端支持。
推荐理由:按信源设置仅收录,不参与自动精选
llama.cpp 于 GitHub 正式发布 b11867 版本,核心变更包括服务端(server)入口点重构(PR #31113),新增 server_role 机制;同时提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的 40+ 预编译二进制包,支持 CPU、CUDA(12.4/12.8/13.4)、Vulkan、ROCm 10.0、OpenVINO、SYCL(FP16/FP32)、Snapdragon(Adreno+Hexagon)等多元硬件后端。
推荐理由:按信源设置仅收录,不参与自动精选
llama.cpp v.b11866 移除了 Metal 后端中已过时的 src1 power-of-two AMAX 缩放机制,转而依赖计算图内更精细的 per expert-token amax 缩放,确保 MoE 下投影激活值在 f16 表示范围内;同步删除相关两阶段归约核、F32 精度调度及越界测试用例。
推荐理由:按信源设置仅收录,不参与自动精选