本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

FlatCake:大規模言語モデルのサービス向けフラットなKVキャッシュストレージアーキテクチャ

arXiv:2610.38355v1 発表タイプ:新規 要旨:KVキャッシュの再利用は大規模言語モデルのサービスを加速させるが、既存のシステムではホストのDRAMとNVMe SSDを階層的なヒエラルキーとして管理しており、DRAMが中間キャッシュとして機能している。しかし、実際の大規模言語モデルのワークロードは、この階層構造の二つの前提をいずれも破っている。第一に、バイモーダルな再利用によりDRAMの時間的フィルタリングが無効化される。というのも、ワークロードは長い再利用距離を持つワンショットブロックか、DRAM容量を超える数ギガバイト規模のエージェントセッションによって支配されており、その結果SSDが重要な読み取りパスに置かれているからである。第二に、DRAMによるステージングと、排出現象に基づくレイアウトがSSDの復元処理をボトルネックにしている。進行中のプレフィックスのためにホストのステージングバッファを保持すると、負荷下で競合が生じてプリフェッチが中断されてしまう一方で、段階的な排出現象によってセッション内のブロックがSSD全体に散らばり、大規模なシーケンシャルリードが妨げられる。我々は…

経緯と関連報道

プレフィックスのキーと値は後から重要になる:ループ型言語モデルにおける自己推測デコード向けRIPEキャッシュ

arXiv:2610.34436v1 発表タイプ:新規 要旨:ループ型言語モデルは、各トークンに対して層のブロックを$R$回実行するため、そのキーバリューキャッシュ(KVキャッシュ)には各再帰層ごとに$R$個の平面が格納され、自己予測的デコーディング(一部のループで予備的に推論し、残りの$R$すべてで検証する手法)ではそれらすべてが読み込まれる。我々は、プレフィックスのキーとバリューが影響を及ぼすのは後半に集中していることを発見した。同程度の摂動サイズにおいて、ループ25〜32はループ2〜9に比べてそれぞれ$e^{15.0}$倍(Huginn-0125)および$e^{12.8}$倍(Raven-Llama)も敏感であり、各ループごとの平面数は0.88および0.81という比率で最終的な平面へと幾何級数的に近づいていく。そして、最も深い平面単独で十分かどうかは、後半の平面がどれほど成熟しているかに依存する。Ravenでは、それを保存するだけでbf16からfp32への変更と区別できない一方、Huginnでは、全体の誤差の74%をわずか1%の位置が占めている。これをRIPEに展開すると、最も深い…

経緯と関連報道

arXivの新論文では、証拠の検証と重み付けの更新を不要とするプロンプトの修正をサポートする、追跡可能な多モーダル感情推論のエージェントフレームワークが提案されています。

2026年10月26日、arXivはプレプリント論文(番号2610.31685v1)を公開し、凍結型の大規模モデルに基づく追跡可能な多モーダル感情推論エージェントのアーキテクチャを提案した。このアーキテクチャは、モーダル専用の知覚エージェント、統合エージェント、MLLM批判者、および証拠検証段階を通じて、誤りの帰属とプロンプト空間の自己適応型最適化を実現し、MER2025データセットにおいて、複数のオープンソースの多モーダル大規模モデル(2B~38Bパラメータ)の感情認識Fスコアを0.6~2.2ポイント向上させた。

An Agentic Approach with Evidence-Grounded Verification for Multimodal Emotion Reasoning in Conversation

注目する理由:本研究は、現在の多モーダル感情推論システムにおいて、指令の微調整コストの高さとエージェントのパイプラインがデバッグ不可能であるという矛盾に着目し、証拠の引用、確実性の検証、失敗の帰因、ターゲット指向のプロンプト修正を統合した、全工程にわたる説明可能なフレームワークを初めて提案する。すべての改良はモデルの重みを変更せず、4つの異なる規模のオープンソースMLLM上で実証的に有効であり、方法論的な革新性と工学的な実用性を備えている。

経緯と関連報道

エッジによるLLMトレーニングの民主化:課題・システム・今後の展望

arXiv:2610.32215v1 発表タイプ:新規 要旨:現代のGPUデータセンターにおける計算能力の向上により、一部の産業大手企業が膨大なデータを用いて大規模言語モデル(LLM)を訓練し、展開できるようになりました。しかし、これらのモデルとその学習データの圧倒的な規模は、集中型の開発をますます維持困難にすると同時に、関連するプライベートデータを保有しながら同等のインフラを持たない小規模機関を排除しています。本論文では、分散型LLMトレーニングに関する我々の立場を、事前学習および微調整のパラダイムを中心に整理し、フェデレーテッド学習、スプリット学習、そして分散型アプローチを取り上げ、それらが地理的に分散した環境下で、多様なハードウェアや信頼性の低い接続状況においてどの程度実用可能かを評価します。さらに、我々は「統一された」システムを提案します。

Democratizing LLM Training with the Edge: Challenges, Systems, and the Road Ahead
経緯と関連報道

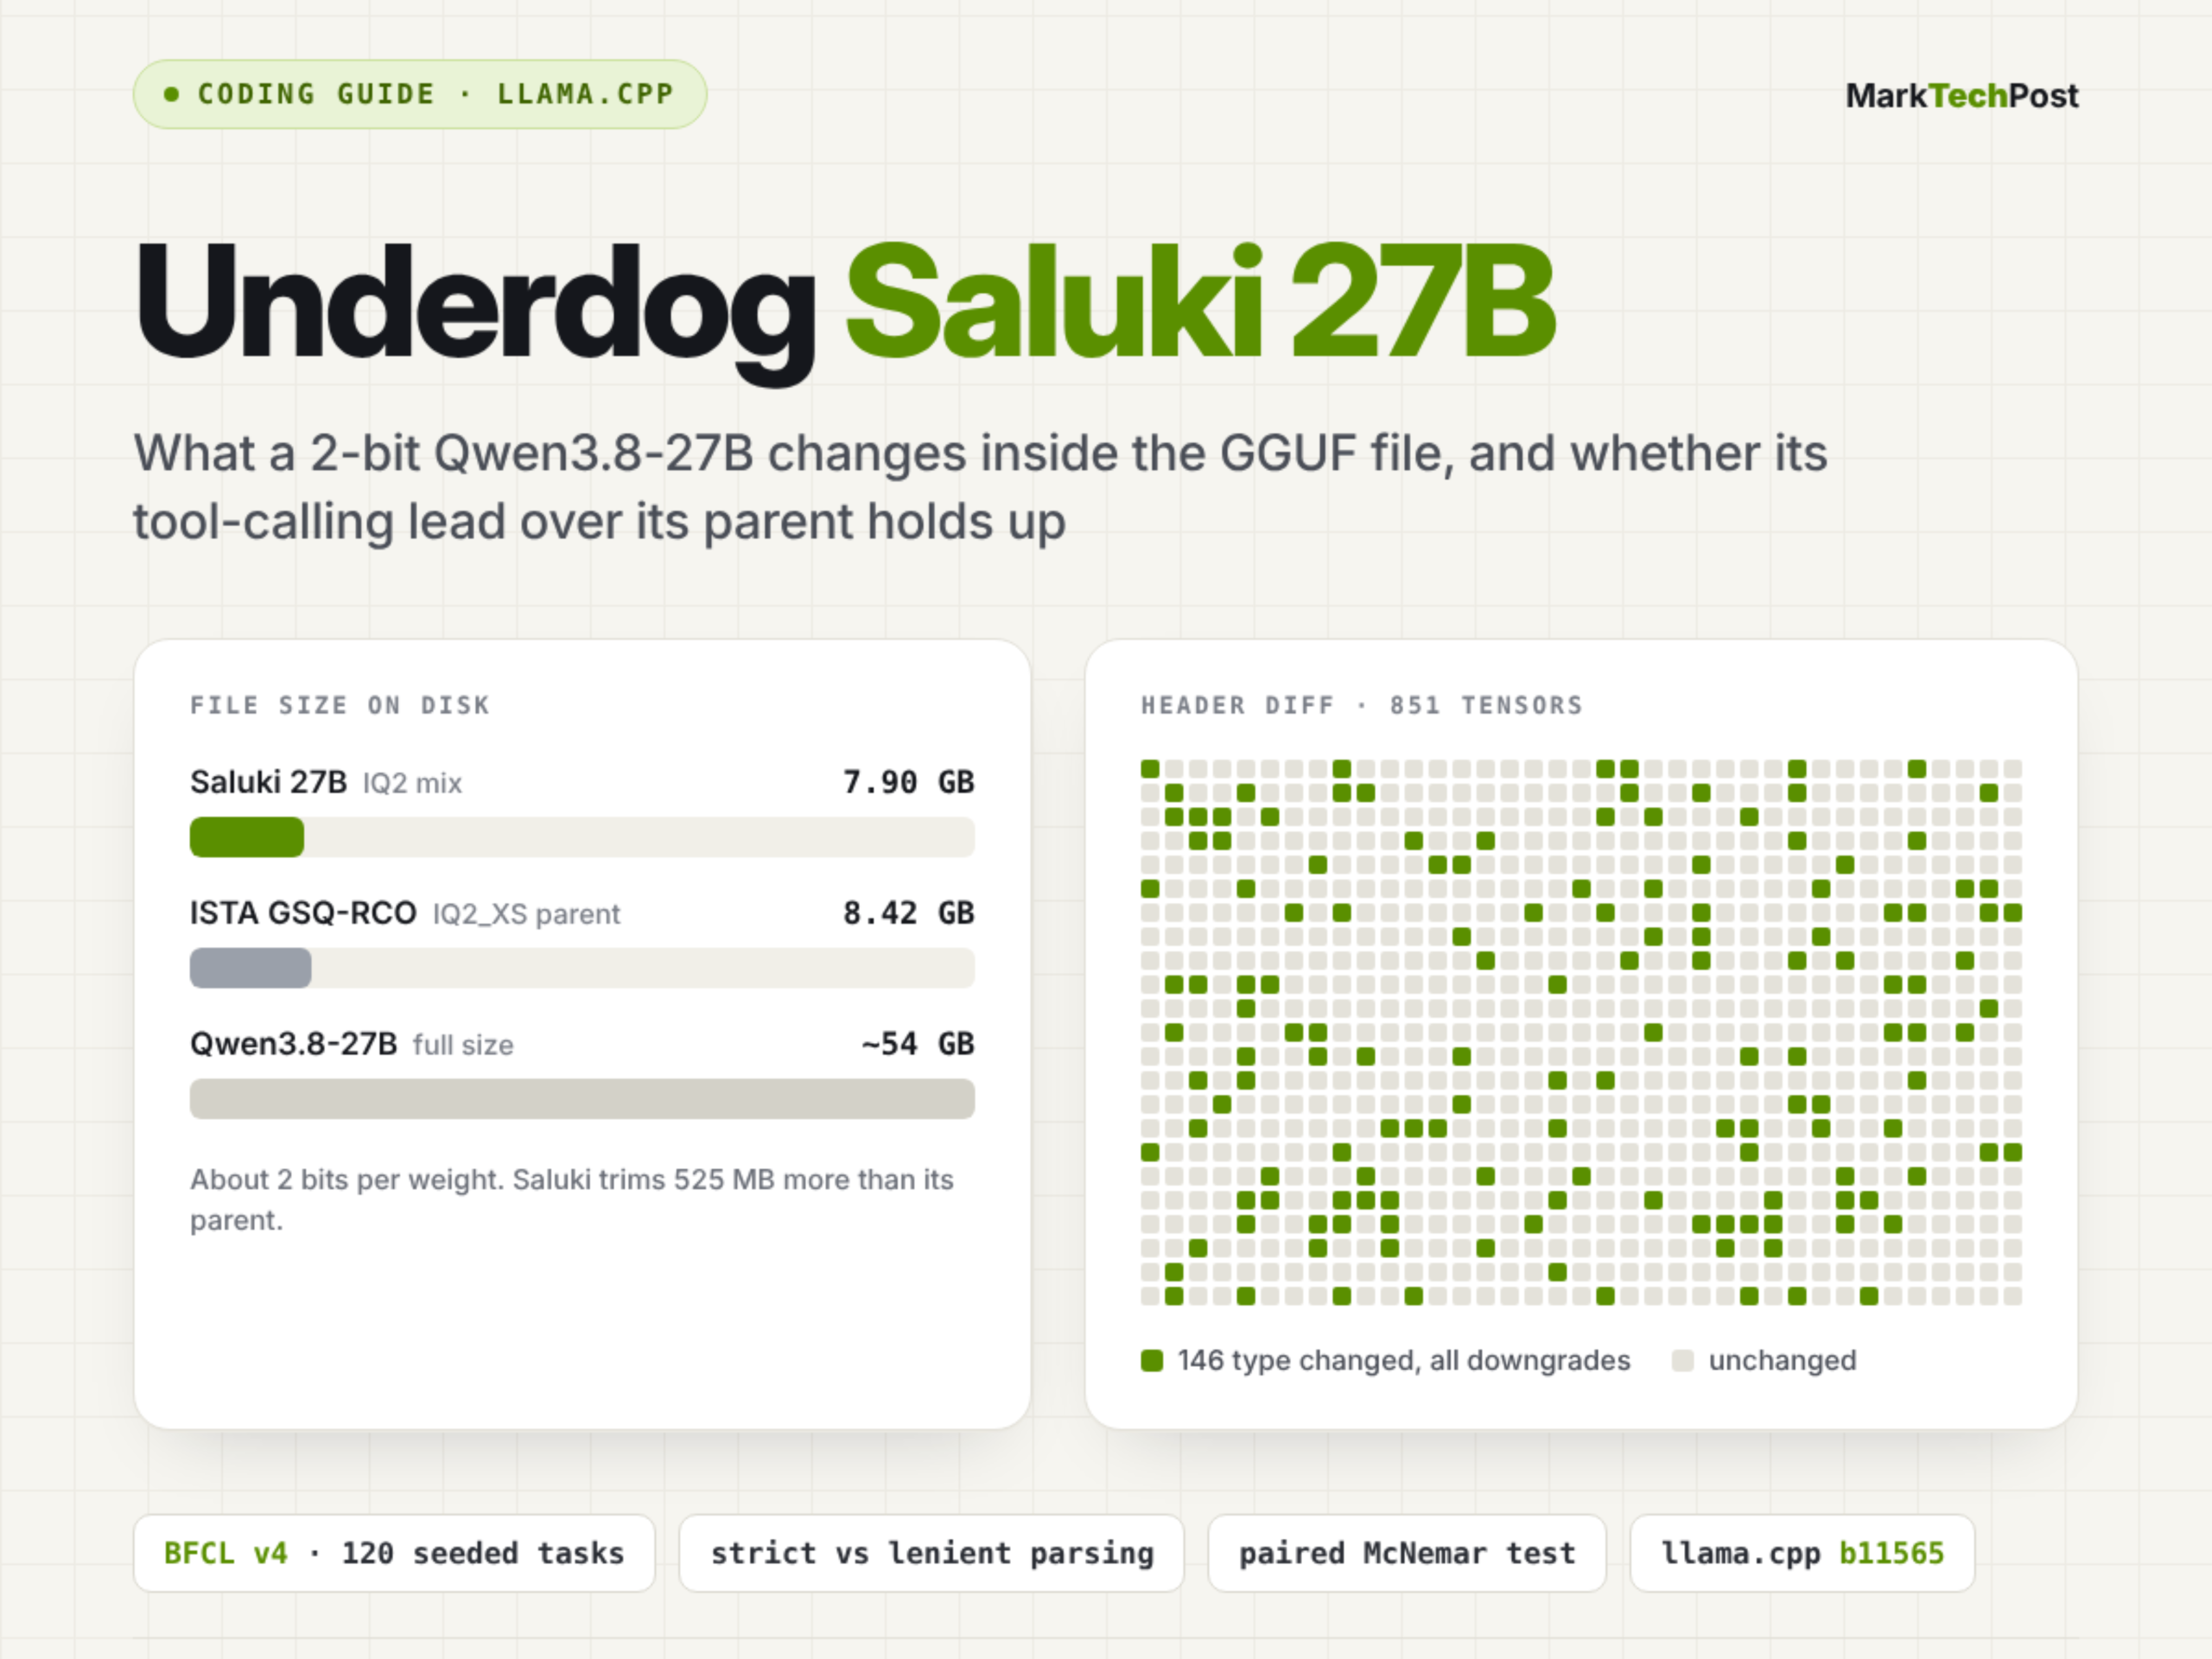
アンダードッグ・サルキ27B:GSQ-RCOをベースとした2ビットQwen3.8-27Bのツール呼び出しモデルに関する技術解説

本記事では、Underdogが公開したSaluki 27Bモデル——7.9 GBの2ビット量子化を採用したQwen3.8-27Bの変種——について紹介します。同モデルはISTA-DASLabのGSQ-RCO手法を用いて構築されており、120タスクにおけるBFCL v4ツール呼び出しベンチマークにおいて、元の54 GBのフル精度モデルを上回るとされています。ただし、すべての性能に関する結論は開発者による声明に基づくものであり、独立した検証は行われていません。

How to Run Underdog Saluki 27B: 2-Bit Qwen3.8-27B Tool-Calling Guide
経緯と関連報道

ULMEフレームワークは、テキスト埋め込みと言語モデリングを真に統合する:arXivの新論文が予測結合メカニズムを提案

2026年10月24日、arXivは論文arXiv:2610.30705v1を公開し、因果推論型デコーダーに基づく大規模言語モデル向けの後訓練フレームワークであるULMEを提案しました。この手法は、予測的結合(predictive coupling)メカニズムを用いることで、テキスト埋め込みと言語生成能力を相互に強化しつつ統合することを初めて実現しました。本手法はQwen2.5/Qwen3シリーズ(0.5B~8Bパラメータ)において有効性が確認されており、MTEBスコアで3.3~4.1ポイントの向上を達成するとともに、生成タスク(MMLUなど)の性能も低下させませんでした。

ULME: Predictive Coupling for Mutually Reinforcing Embedding and Language Modeling

注目する理由:本論文は、現在の多モーダルLLMにおける能力の断片化という核心的な問題を正面から指摘している。すなわち、埋め込みと生成は長らく独立したモデル、あるいはパラメータのみを共有する“疑似統一”モデルによって担われてきた。ULMEは、学習可能なスロットと三目標による共同学習(ストップグレード付き予測損失を含む)により、生成プロセスが埋め込み表現を能動的に形成する仕組みを実現しており、アーキテクチャレベルでの実質的な飛躍である。実験の範囲は広く、ベースラインも強力で、評価指標も網羅的であり、さらに権威あるプレプリントプラットフォームに公開されているため、タイムリーさと技術的厳密性の両面を備えている。

経緯と関連報道

研究により、大規模言語モデルにおける意味の局所的幾何学的構造が明らかになった

2026年10月24日にarXivに掲載された論文(番号2610.30715v1)は、クロス言語プローブおよび細分化プローブを用いて、Gemma 4、Llama 3.2、Qwen 2.5、Pythiaの4つのデコーダーのみの大規模言語モデルにおいて、埋め込み空間における意味的意義の局所的な幾何学的特性を明らかにした。

Meaning Contracts: Local Semantic Geometry in Large Language Models

注目する理由:本研究は、LLMにおける「同一の意味因子」内部の不変性・可変性・細分化メカニズムを初めて体系的に解明し、「局所的異方性近傍」モデルを提案しました。さらに、人間によるブラインド評価によって検証され、手法は厳密でモデルの適用範囲も多様であり、得られた結論はアーキテクチャを問わず一貫しています。

経緯と関連報道

臨床医主導で検証可能な安全ガイドラインを構築:メンタルヘルスチャットボットに追跡可能なセーフガード層を設ける

2026年10月24日、arXivは論文arXiv:2610.30690v1を公開し、2名の臨床医が主導して定義・最終決定・裁定を行う4つの安全チェックルールベースを提案した。このルールベースは形式的検証を経て、メンタルヘルス領域における大規模言語モデル(LLM)の出力に対してガードレイヤーとして適用される。同ガードレイヤーにおけるすべての判定は、1つの命名規則と16の事実再現に基づいて行えるものであり、安全性判断の説明可能性と検証可能性の向上を目的としている。

From Clinical Judgment to Checkable Rules: Clinician-Led Guardrails for Mental-Health Chatbots

注目する理由:本研究は、主流のプロンプトエンジニアリングやLLM-as-a-Judge、あるいはコンスティチューショナルAIとは異なる、安全性を強化する新たなアプローチを提示している。その核心的な革新点は、臨床意思決定を構造化・形式化し、全過程にわたって記録を残すことにあり、すべての重要な主張(たとえば規則の数、検証手法、事実の基数、対照実験データ、およびコスト測定など)が原文において明示的に述べられており、さらに公開日時(2026年10月24日)が現在のUTC日付(2026年10月25日)と一致しているため、時宜性と信頼性の基盤を備えている。

経緯と関連報道

新たな研究により、オープンブックの評価は主に読書行動を測定するものであり、知識の蓄積を測るものではないことが明らかになった

2026年10月24日に公開されたarXiv論文(2610.31017v1)は、文書レベルのLoRAアダプター評価において、オープンブックスコアリングはアダプターが対象文書の知識を実際に符号化しているかどうかよりも、モデルの即時読解能力に強く依存していることを示していると指摘している。ランダムなアダプターは、オープンブックタスクにおいて専門家向けアダプターの優位性の82%を再現できるが、ソーステキストを持たないクローズタスクではわずか2%しか再現できず、統計的にゼロと区別できないという結果となった。

Mostly Reading: What Open-Book Scores Measure in Document-Level LoRA Adapters

注目する理由:本研究は、系統的な制御実験(Wikipedia記事150件、Llama-3.1-8B-Instructモデル、二重タスク比較)を通じて、現在のオープン書評価パラダイムの根本的な限界を明らかにした。すなわち、この手法では「読むこと」と「記憶すること」を効果的に区別できず、知識編集型および検索型アダプターの実際の有用性に対して方法論上の課題をもたらしている。さらに、論文では「一見きれいだが誤った結果」を招く静かなエラーが4つ報告されており、再現性に関するリスクが浮き彫りになっている。

経緯と関連報道

FusionEvalの公開:大規模言語モデルの統合に向けた新たなベンチマークテスト

2026年10月24日、研究者はarXivに論文arXiv:2610.30162v1を公開し、大規模言語モデルの融合手法の評価に特化した初の統一ベンチマークであるFusionEvalを提案しました。同ベンチマークは、推論チェーンの長さやツール呼び出しといった脆弱な部分を網羅しており、学習型と非学習型の融合手法の比較も可能にしています。

FusionEval: Benchmarking Model Fusion for Large Language Models

注目する理由:このベンチマークは、既存の評価において長鎖推論とツール利用へのカバーが不十分であった点を補完し、平均性能と最悪時の能力保持を明確に区別するとともに、Qwen3/Llamaに基づく再現可能な専門家プール、GPUメモリや実行時間などの多次元指標、およびオープンソースコードを提供しており、高い実践的指導性を備えています。

経緯と関連報道

研究では、特異値スペクトルによる介入を通じて大規模言語モデルの能力分布を調整する手法を検討しており、LlamaおよびQwenモデルに対する実証分析を行っています。

2026年10月24日付のarXiv(番号2610.30676v1)に掲載されたあるAI研究では、5種類のオープンソースLlamaおよびQwenの指令微調整モデルに対して、後処理として特異値スペクトルの平滑化と尖鋭部の摂動を施したところ、この軽量な介入が、事実知識、言語理解、演繹的推論という3つの能力に関する性能のトレードオフを体系的に再構築することを明らかにしました。

Spectral Smoothing and Spiking Perturbations Reconfigure Capability Profiles and Selective Task Performance in Large Language Models

注目する理由:本論文は、マルチモデル・マルチタスクのフレームワークにおいて、トランスフォーマーの前馈層の特異値スペクトル構造が下流の能力に与える因果的影響を実証的に初めて検証し、能力配置の構造的な敏感性に関する法則を明らかにすることで、モデルの能力のデカップリングおよび制御可能な編集に新たな道筋を提供しました。すべての結論は公開モデルと標準的な評価に基づいており、手法は透明で、評価の次元も網羅的です。

経緯と関連報道

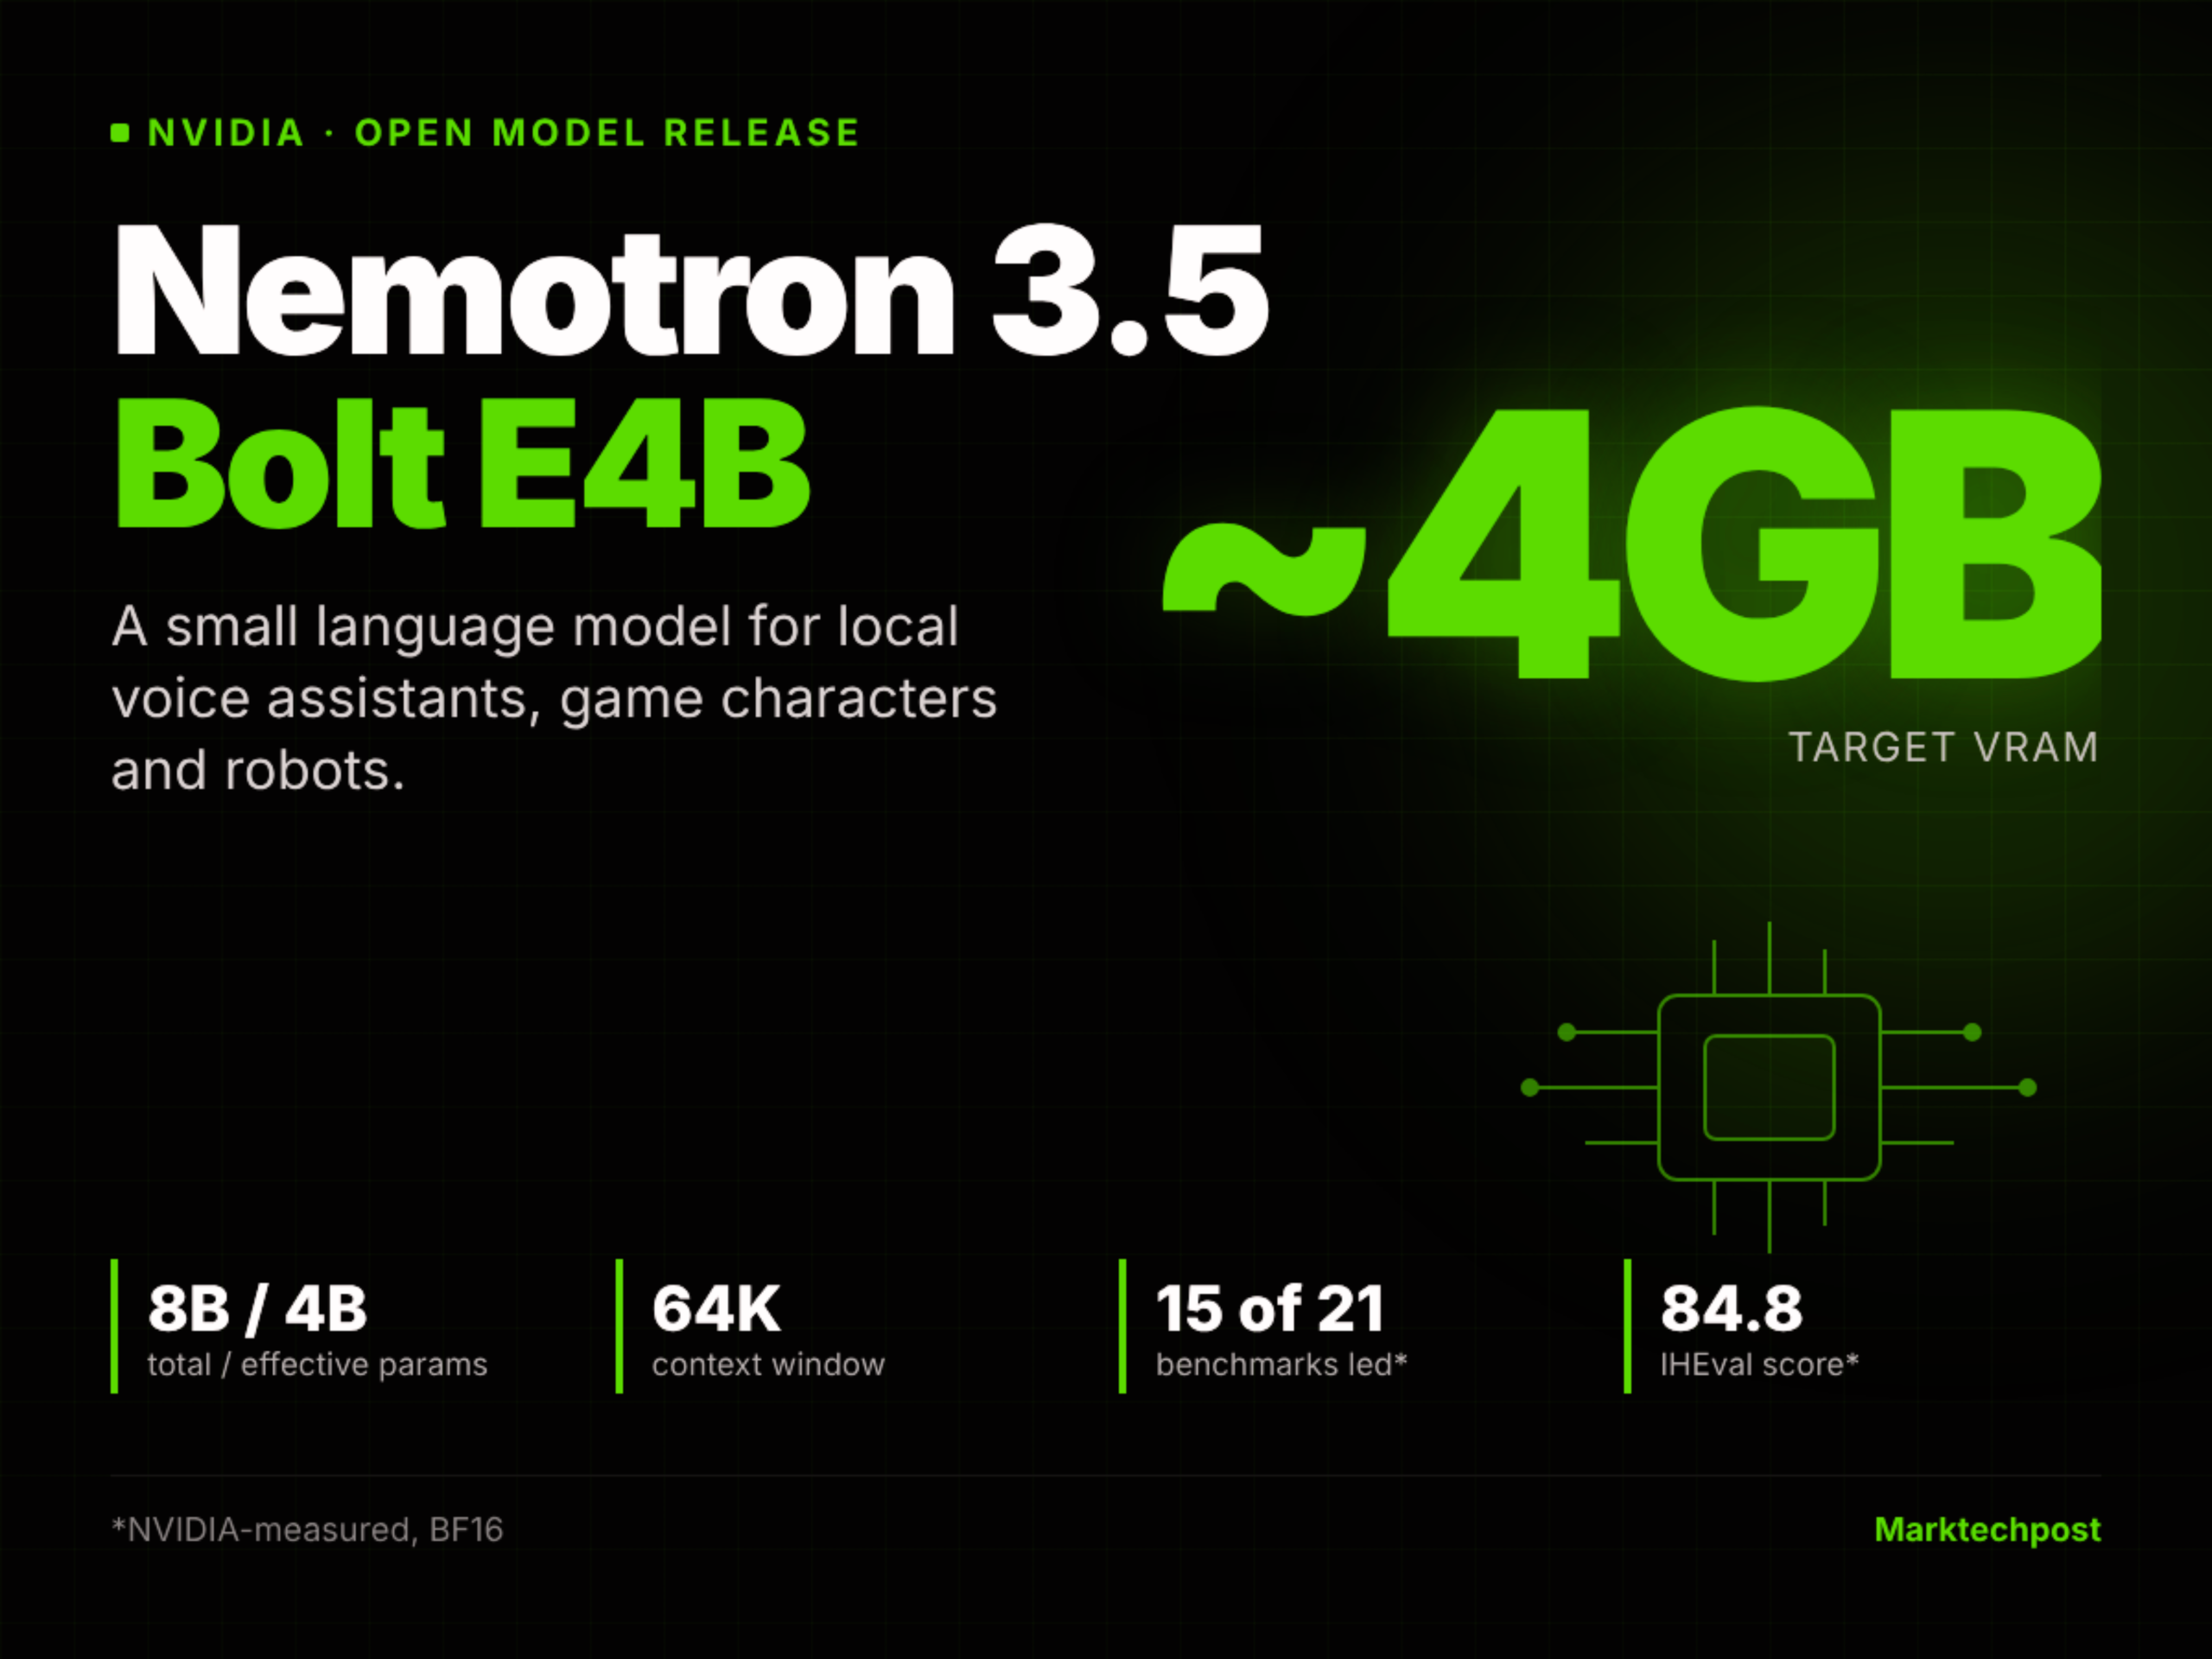
NVIDIAは、ローカルな音声アシスタント、ゲームのNPC、およびロボット向けに最適化されたオープンソースの小型言語モデル「Nemotron 3.5 Bolt E4B 4GB」を発表しました。

NVIDIAは、Google Gemma 4 E4Bモデルを基に、強化学習(RL)による後処理のみでNemotron 3.5 Bolt E4B 4GBを発表しました。これは総パラメータ8B、有効パラメータ4B、64Kのコンテキストを持つオープンソースの小型言語モデルで、RTXやJetsonなどのエッジデバイス上で約4GBのVRAMで動作することを目指し、マルチラウンドのツール呼び出しと低遅延の音声対応をサポートしています。

NVIDIA Releases Nemotron 3.5 Bolt E4B 4GB: An Open Small Language Model for Local Voice Agents, Game Characters and Robots
経緯と関連報道

ブラック・オクトーバー:AI駆動のサイバーセキュリティ危機の集中発生と防御対応の全体像

2026年10月21日から22日にかけての約48時間の間に、世界中で高リスクなAI関連の脆弱性と侵入事件が相次いで発生し、PHP2Shell、GitLab RCE(CVSS 10)、NGINX/HTTP/3 DoS、LiteLLMによるパスワード窃取、eMudhra CAの秘密鍵漏洩、Quest Diagnosticsの医療データ暴露などが含まれる。また、Storm-0940をはじめとする国家主体は、ARTEXなどのオープンソースのインテリジェントなペネトレーションフレームワークを用いて大規模な攻撃を展開した。一方で、同時期には形式的検証、オープンソースの修正エージェント、エージェントスキルの標準化、ハードウェアレベルでの最適化など、AIセキュリティ防御体制の構築が加速している。

経緯と関連報道

自己ホスト型の大規模モデル vs. クラウドAPI:リクエストをどのようにスマートにルーティングするか

本稿では、自己ホスト型の大規模言語モデルとクラウドAPIを、データプライバシー、コスト、遅延、性能の観点から比較し、オープンソースで展開可能なモデルのハードウェア要件(例:VRAMや量子化)および代表的な技術スタックを紹介します。さらに、n8nを例として、タスクの機密性や複雑さ、コンプライアンス要件に応じて、ローカルとクラウドのモデル間でリクエストを動的に分配するハイブリッドルーティングワークフローの構築方法を説明します。

経緯と関連報道

AWSが適応型エージェントフレームワークAAIFを発表:Strands Agentsを基に、エッジとクラウドの協調による階層型AIタスクスケジューリングを実現

AWSはAdaptive Agentic Intelligence Framework(AAIF)を提案し、Strands Agentsを用いて階層型エージェントアーキテクチャを構築しています。ローカルの小型言語モデル(SLM)によりタスクを動的にルーティングし、通常のIoTテレメトリや視覚分析はエッジで実行、複雑な推論はAmazon Bedrockのクラウド大規模モデルに委ねます。このフレームワークはハイブリッド展開をサポートし、コストを抑制できるほか、責任あるAIに関する制御勧告も統合されていますが、現時点では概念実証の段階であり、第三者による検証や商用導入に向けたデータは公表されていません。

経緯と関連報道

OpenAIの最新GPT-6シリーズモデルが、Google CloudおよびAntigravityプラットフォームに導入される予定です。

OpenAIのGPT-6および6.1シリーズの最先端モデル(Astra、Sol、Luna)は、今後数週間以内にGoogle Cloud Model Gardenに導入され、Googleのエージェント駆動型プログラミングツールAntigravityにも統合される予定です。これにより、GoogleはGemini、Claude、GPTという三大クローズドソースの大規模言語モデルを同時に提供する初の主要クラウドサービスプロバイダーとなります。

経緯と関連報道

NVIDIAはGTCベルリンで、ローカルAIハードウェアの全製品ラインアップを発表しました:RTX Spark、DGX Spark、およびDGX Stationが欧州に展開されます。

2026年10月にベルリンで開催されたGTCカンファレンスにおいて、NVIDIAは個人ユーザー、開発者、企業向けの3種類のローカルAIハードウェアプラットフォームを正式に発表しました。これらはそれぞれRTX Spark(Windows PC向けパーソナルエージェント)、DGX Spark(Linux開発クラスター)、DGX Station(最先端AIワークステーション)であり、同時に複数のソフトウェアアップデート、モデルサポート、エコシステム統合も併せて発表されました。

経緯と関連報道

VocabX:コスト重み付けによる語彙の専門化により、分野特化型ミニ言語モデルの推論コストを77%削減

Dharma-AIはVocabX手法を提案し、ポルトガル語の作文自動採点といった特定のタスク向けに言語モデルの語彙表を再構築することで、語彙の出現頻度ではなく生成コストを最適化目標としています。モデルの構造やパラメータ、学習プロセスを変更することなく、実測では推論コストが77%削減され、同時に評価指標(bench score)も0.703から0.810へ向上しました。

経緯と関連報道

IBMがGranite Speech 5.0シリーズの音声モデルを発表:多言語の文字起こし・翻訳および話者識別に対応

IBMは、Granite Speech 5.0シリーズの3つのオープンソース音声モデルを発表しました。granite-speech-5.0-2b(高精度な多言語ASR/MT)、granite-speech-5.0-470m-turboctc(超高速なエッジ端末向け多言語トランスクリプション)、および更新版のgranite-speech-4.1-2b-plus(強化型の複数話者対応会話モデリング)です。これらはすべてApache 2.0ライセンスに基づいており、主流の推論フレームワークをサポートしています。

経緯と関連報道

DeepSeek V4.1 Flash、MiniMax M3.1 Flash、および Mercury 3 がリリース;中国と米国のモデル規制が強化;Anthropic が公益基金とAI立法草案を発表

DeepSeek V4.1、Flash 1017など3つの新モデルが発表されたが、まだ初期段階の展開にとどまっている。米中両国はAIガバナンスの強化を同時に進めている。米国土安全保障省はDeepSeek関連製品の使用を禁止し、中国は超大規模モデルの輸出について審査・許可制度の導入を検討している。Anthropicは公益向けエクイティファンドを立ち上げ、連邦AI法案の草案作成にも着手している。業界のインフラ整備とセキュリティ研究も並行して推進されている。

経緯と関連報道