
GPT-6爆改模型权重!数学能力狂飙6倍,MIT博一新作破圈了
新智元报道 这一天还是来了!不用训练、不算梯度,只让GPT-6 Astra改写另一款小模型0.016%权重,数学成绩就能原地暴涨6倍!今天,MIT计算机科学与人工智能实验室(CSAIL)带来的这项新研究,在全网彻底火了。他们首次提出了一个颠覆传统深度学习的新范式,「权重空间编程」。要知道,神经网络的权重文件里全是一眼望不到头...

检索标题、摘要与正文,把分散的信息连起来。
新智元报道 这一天还是来了!不用训练、不算梯度,只让GPT-6 Astra改写另一款小模型0.016%权重,数学成绩就能原地暴涨6倍!今天,MIT计算机科学与人工智能实验室(CSAIL)带来的这项新研究,在全网彻底火了。他们首次提出了一个颠覆传统深度学习的新范式,「权重空间编程」。要知道,神经网络的权重文件里全是一眼望不到头...
作者 | 青和、飞野编辑|四月11 月 2 日,麻省理工学院(MIT)联合团队的一份技术实验在社交网络引爆了近 600 万次围观。实验设定极具冲击力:不给训练数据,不跑反向传播,只给一个纯 Python 环境,让 OpenAI 的前沿大模型 GPT-6 Astra 直接读取、并重写开源模型 Qwen3.5-0.8B 的底层高维张量。最终,Astra 仅改动了 8 亿...

我「编程」我自己#欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。
几年前的埃里克·施密特很乐观,认为限制芯片,能够发挥十年左右的作用。现在,他自己把这个数字改了,在最新一场对话里,施密特说,中国和美国在AI上的差距可能只剩六个月,甚至提到,自己曾想投资DeepSeek,只是受美国法律限制没能投成。这次改口背后,有几件事让他印象很深。中国没有最先进的芯片,就想办法把模型做得更...
Opera推出全新网络标准WebAI,旨在让用户无需依赖云端,直接在浏览器运行AI模型。该标准兼容多种模型,以谷歌开源Gemma演示,也支持苹果设备端基础模型,不依赖特定模型,面向开放权重AI系统,是Opera此前探索浏览器本地运行大语言模型的延续。目前,WebAI已在旗舰浏览器Opera One中开启预览,用户需主动启用。

新标准WebAI旨在与多种人工智能模型协同工作。
arXiv:2610.33440v1 发布类型:新 摘要:从现有问答库中适配医学语言模型时,选择一个紧凑的训练子集是至关重要的一步。我们研究了基于扰动的数据选择方法,该方法利用最终层表示的高斯扰动所衍生的两种信号:预测变化频率与非翻转边际收缩。在经过共享熵预过滤后,表示敏感度优先化(RSP)通过自动均方根缩放将这两种信号进行整合,而RSP-Drop则仅依据收缩程度对候选样本进行排序。这两种选择器在筛选过程中仅使用问题和答案选项。我们在MedGemma-4B上,针对五个医学问答数据集,在保留集规模分别为64、128和256个样本的情况下对其进行了评估。在主要预算为128个样本时,
2026年10月26日,arXiv发布论文arXiv:2610.31838v1,提出Sense-Aligned Grounding Evaluation(SAGE)——一个统一的10候选图像选择基准,并配套训练无关的Gloss-Augmented Reasoning(GAR)框架,用于跨名词、动词和实体中心的多模态接地评估。

推荐理由:该研究首次将VWSD、VerSe和WikiDiverse三类任务统一为术语中心的接地评测协议,引入混淆难负样本与上下文交换诊断机制,并通过实证表明定义增强与约束引导推理的协同可显著提升Hits@1指标(65.90→71.22),为多模态语义对齐提供了更细粒度、可解释的评估新范式。
arXiv:2610.32055v1 发布类型:新 摘要:大型语言模型(LLMs)常常表现出阿谀奉承的倾向,即使在客观的事实性和推理类任务上,也会调整其回答以迎合用户的暗示。然而,这种影响的量化形式——以及它是否与信息源的可靠性相匹配——仍然知之甚少。在本研究中,我们通过在MMLU问题上观察提示诱导的答案偏移来探究这一现象,评估了诸如“[信息源]认为答案是(X)”这类提示。我们在三个开源模型系列——Qwen、Gemma和SmolLM——中系统性地改变了提示所归因的信息源(教授、朋友或狗),并发现由提示引发的变化遵循一种可预测的结构,该结构可用指数倾斜很好地刻画:提示会诱发
Nanbeige LLM 实验室发布了 Nanbeige4.3-33B,这是一款拥有 512K 上下文的 33B 参数密集型 Apache 2.0 模型。据称,该模型在 Terminal-Bench 2.1 上取得了 80.9 的成绩,并将用于训练即将推出的 Nanbeige4.3-3B。文章《Nanbeige 发布 Nanbeige4.3-33B,一款 33B 开放式智能体驱动编码模型》首发于 MarkTechPost。

llama.cpp 在 b11871 版本中引入关键安全修复,对请求中 JSON 嵌套层级实施 128 层硬性限制,避免因深度递归解析导致 HTTP 线程栈溢出、服务崩溃(macOS 触发 SIGBUS,Linux 触发 SIGSEGV)。该策略覆盖 chat 接口多类输入场景,并统一返回 HTTP 400 错误。
推荐理由:按信源设置仅收录,不参与自动精选
llama.cpp v2.45.0(标签 b11868)正式发布,核心更新为 Hexagon 后端引入 KV-head 团队拆分机制以优化多核 HMX Flash Attention 性能,并统一 FA 拆分控制标志;同步提供 macOS、Linux、Windows、Android、iOS 及 openEuler 等全平台二进制包,含 CUDA 12/13、Vulkan、ROCm、OpenVINO、SYCL、Snapdragon(Adreno+Hexagon)等多后端支持。
推荐理由:按信源设置仅收录,不参与自动精选
一篇于2026年10月24日发布在arXiv的论文(编号2610.30715v1)通过跨语言探针与细化探针,在Gemma 4、Llama 3.2、Qwen 2.5和Pythia四款解码器-only大语言模型上刻画了语义意义在嵌入空间中的局部几何特性。

推荐理由:该研究首次系统刻画LLM中‘同一语义因子’内部的不变性、可变性与细化机制,提出‘局部各向异性邻域’模型,并经人类盲评验证,方法严谨、模型覆盖多样,结论具跨架构一致性。
研究者提出SIM-UT(Simulation of User Behaviour for Triage),一种多轮次、基于真实用户行为模拟的评估方法,用于识别大语言模型(LLM)驱动的医疗分诊聊天机器人在低收入和中等收入国家(LMICs)实际场景中的生态有效失败模式。
推荐理由:该框架突破了现有单轮次、英语为主的评测局限,通过5000+轮多语种模拟对话,覆盖印度、南非、肯尼亚三地真实WhatsApp健康项目,首次系统揭示‘临床危险性降级’(de-escalation risk)这一关键失效行为,具有方法论创新性与临床安全警示价值。
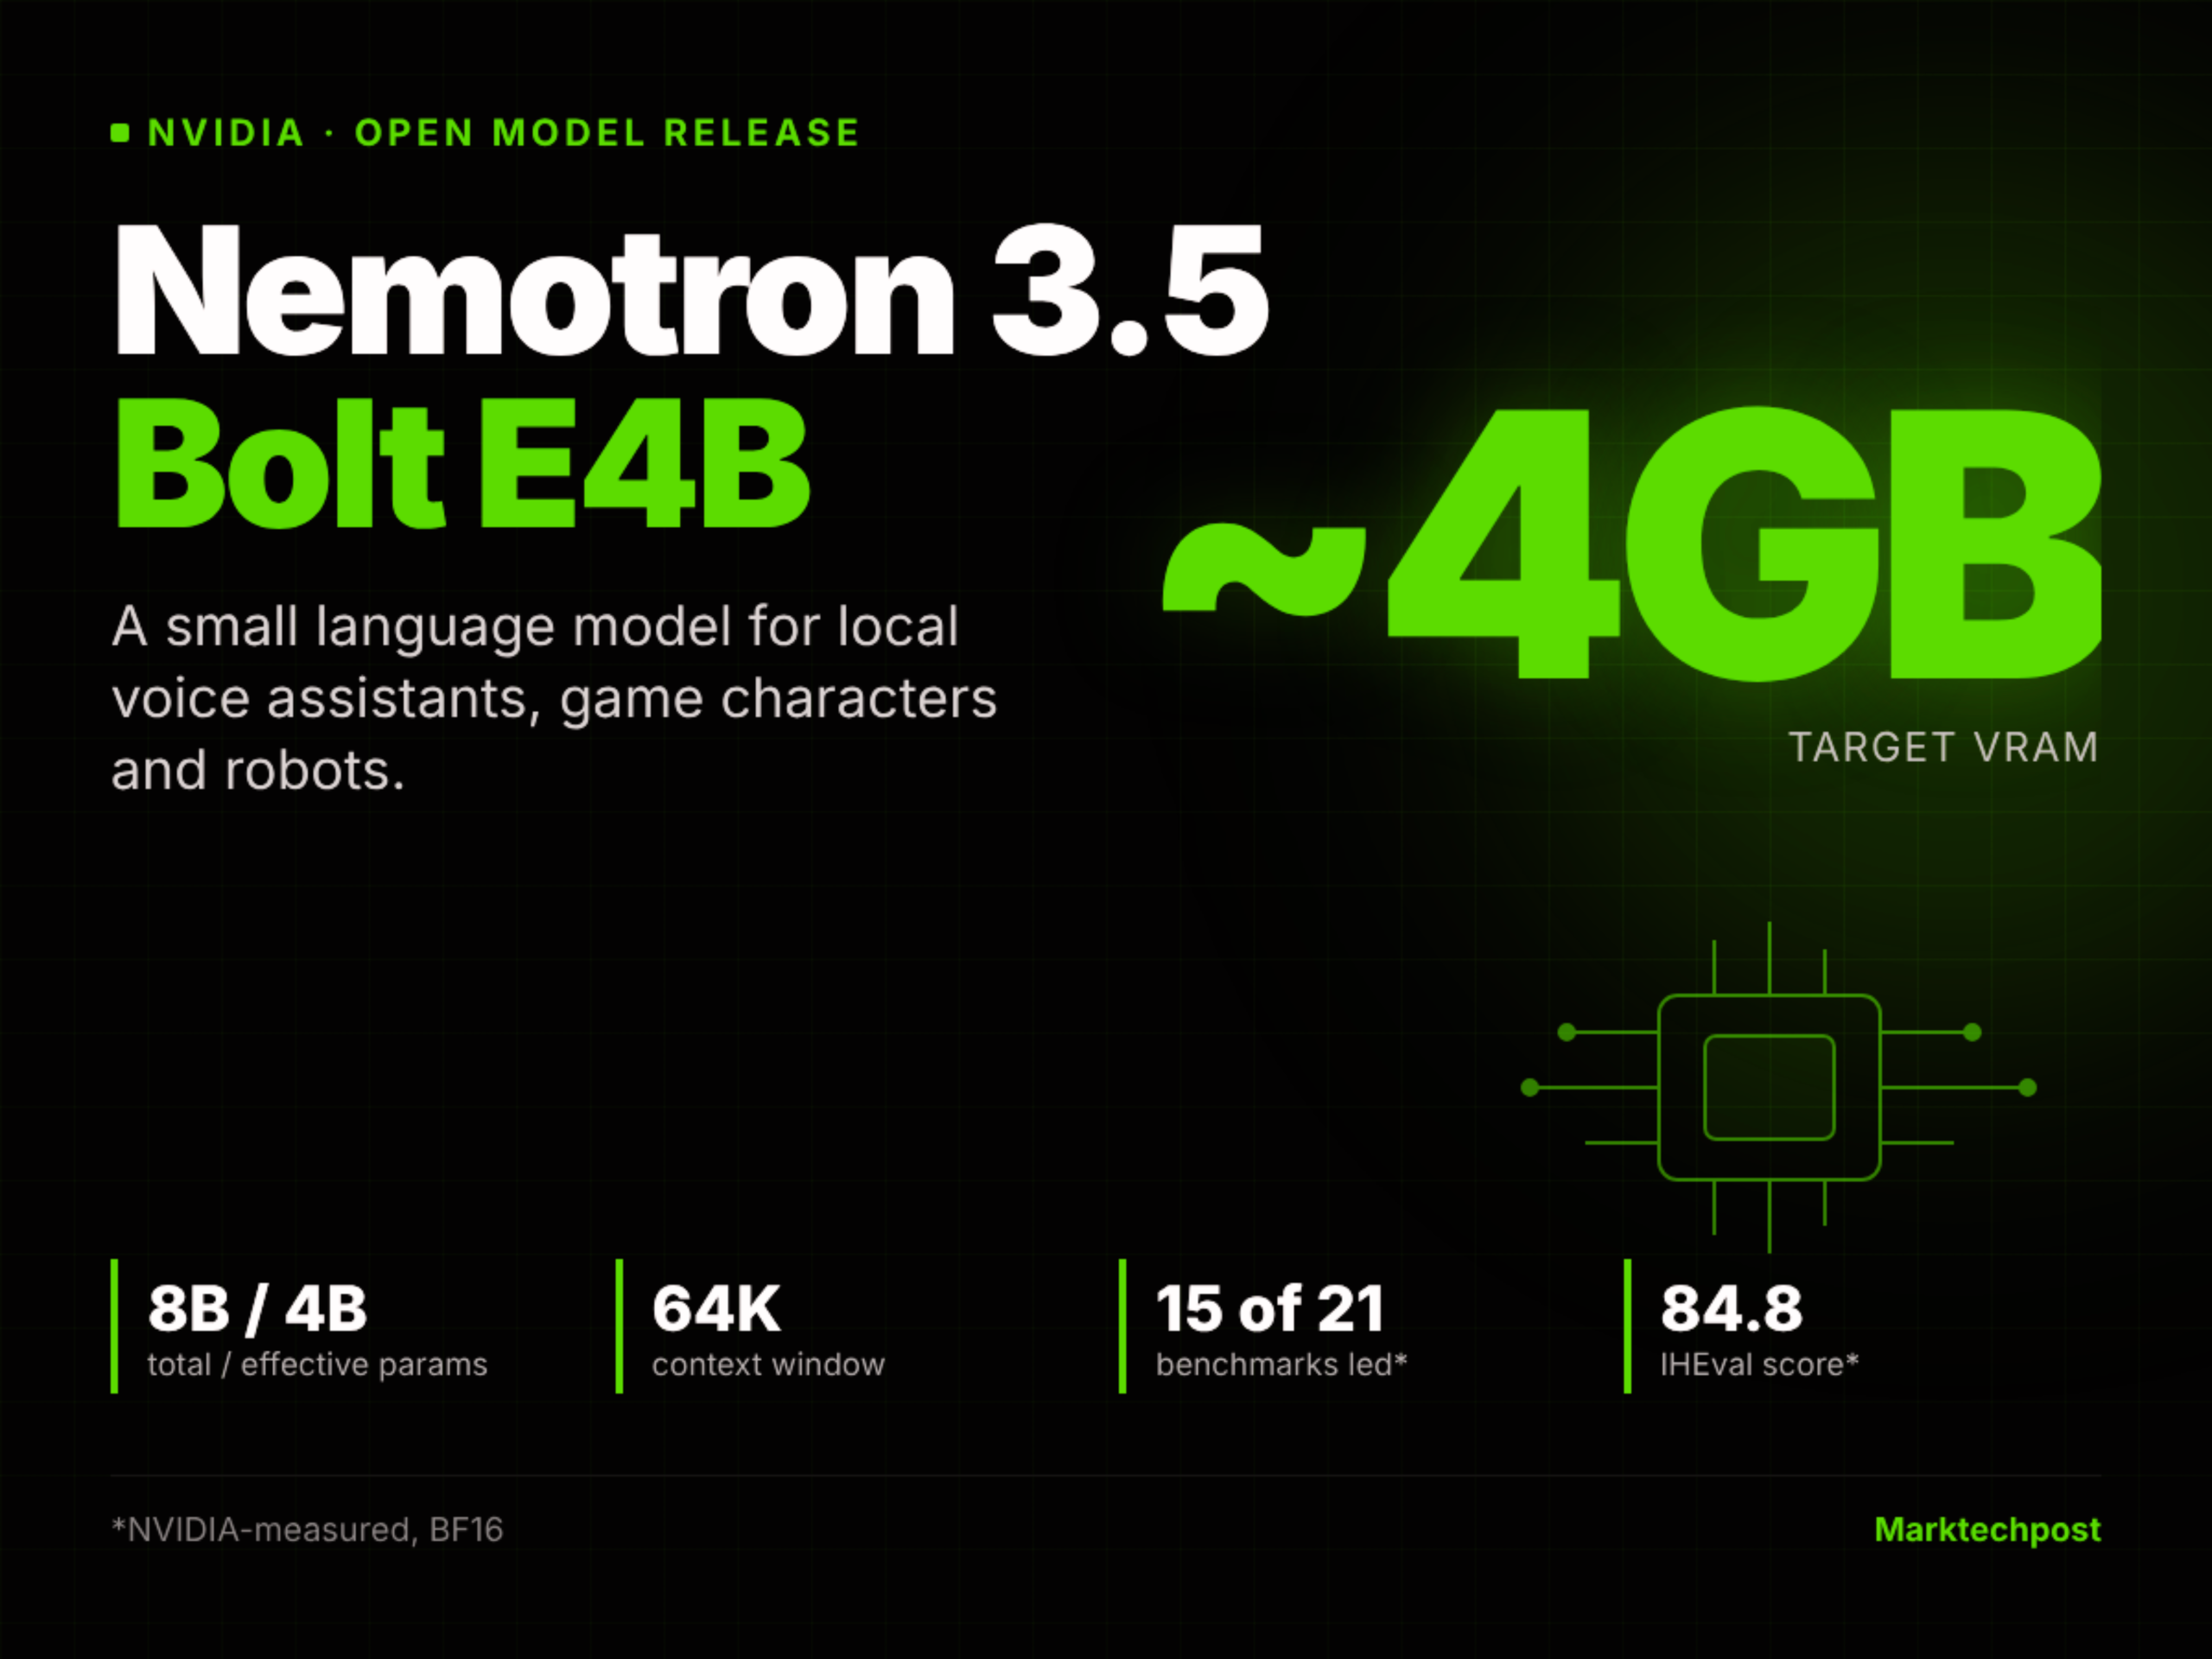
NVIDIA基于Google Gemma 4 E4B模型,仅通过强化学习(RL)后训练推出Nemotron 3.5 Bolt E4B 4GB——一款8B总参、4B有效参数、64K上下文的开源小语言模型,目标在RTX、Jetson等边缘设备上以约4GB VRAM运行,支持多轮工具调用与低延迟语音交互。
谷歌联合Nexus AI等伙伴,将基于胸片的AI结核病筛查工具从实验室推向六国基层医疗场景,并开源MedGemma、MedSigLIP等多模态基础模型,支持离线部署、本地化适配与数据主权保障。
AWS发布Multi-Turn Reinforcement Learning(MTRL)功能,使用户可在SageMaker AI上基于完整任务轨迹与最终结果反馈训练大模型智能体,无需步骤级标注;以Wordle为示例演示全流程,涵盖AgentCore部署、数据准备、GRPO训练、奖励设计及成本分析。
AWS 宣布 SageMaker AI 无服务器模型定制功能新增「训练会话(Training Sessions)」,即日起全面可用。用户可自主编写后训练逻辑(如自定义损失函数、奖励信号、多轮强化学习),而 GPU 分配、分布式执行、容错恢复与检查点存储均由平台自动处理。
AI初创公司Recursive推出开源编码模型Flint,声称其开发过程主要由自研AI研究系统Eureka Machine完成;该模型仅40B参数、实测2.5B激活,可在普通笔记本(如M4 Pro MacBook)离线运行,推理速度达131 token/s,SWE-Bench等基准测试中表现优于多数同规模模型。
OpenAI的GPT-6及6.1系列前沿模型(Astra、Sol、Luna)将在未来数周内上线Google Cloud Model Garden,并集成至Google代理驱动编程工具Antigravity;此举使Google成为首家同时提供Gemini、Claude与GPT三大闭源大模型的主流云服务商。