
NVIDIA发布开源小语言模型Nemotron 3.5 Bolt E4B 4GB,专为本地语音代理、游戏NPC与机器人优化
NVIDIA基于Google Gemma 4 E4B模型,仅通过强化学习(RL)后训练推出Nemotron 3.5 Bolt E4B 4GB——一款8B总参、4B有效参数、64K上下文的开源小语言模型,目标在RTX、Jetson等边缘设备上以约4GB VRAM运行,支持多轮工具调用与低延迟语音交互。
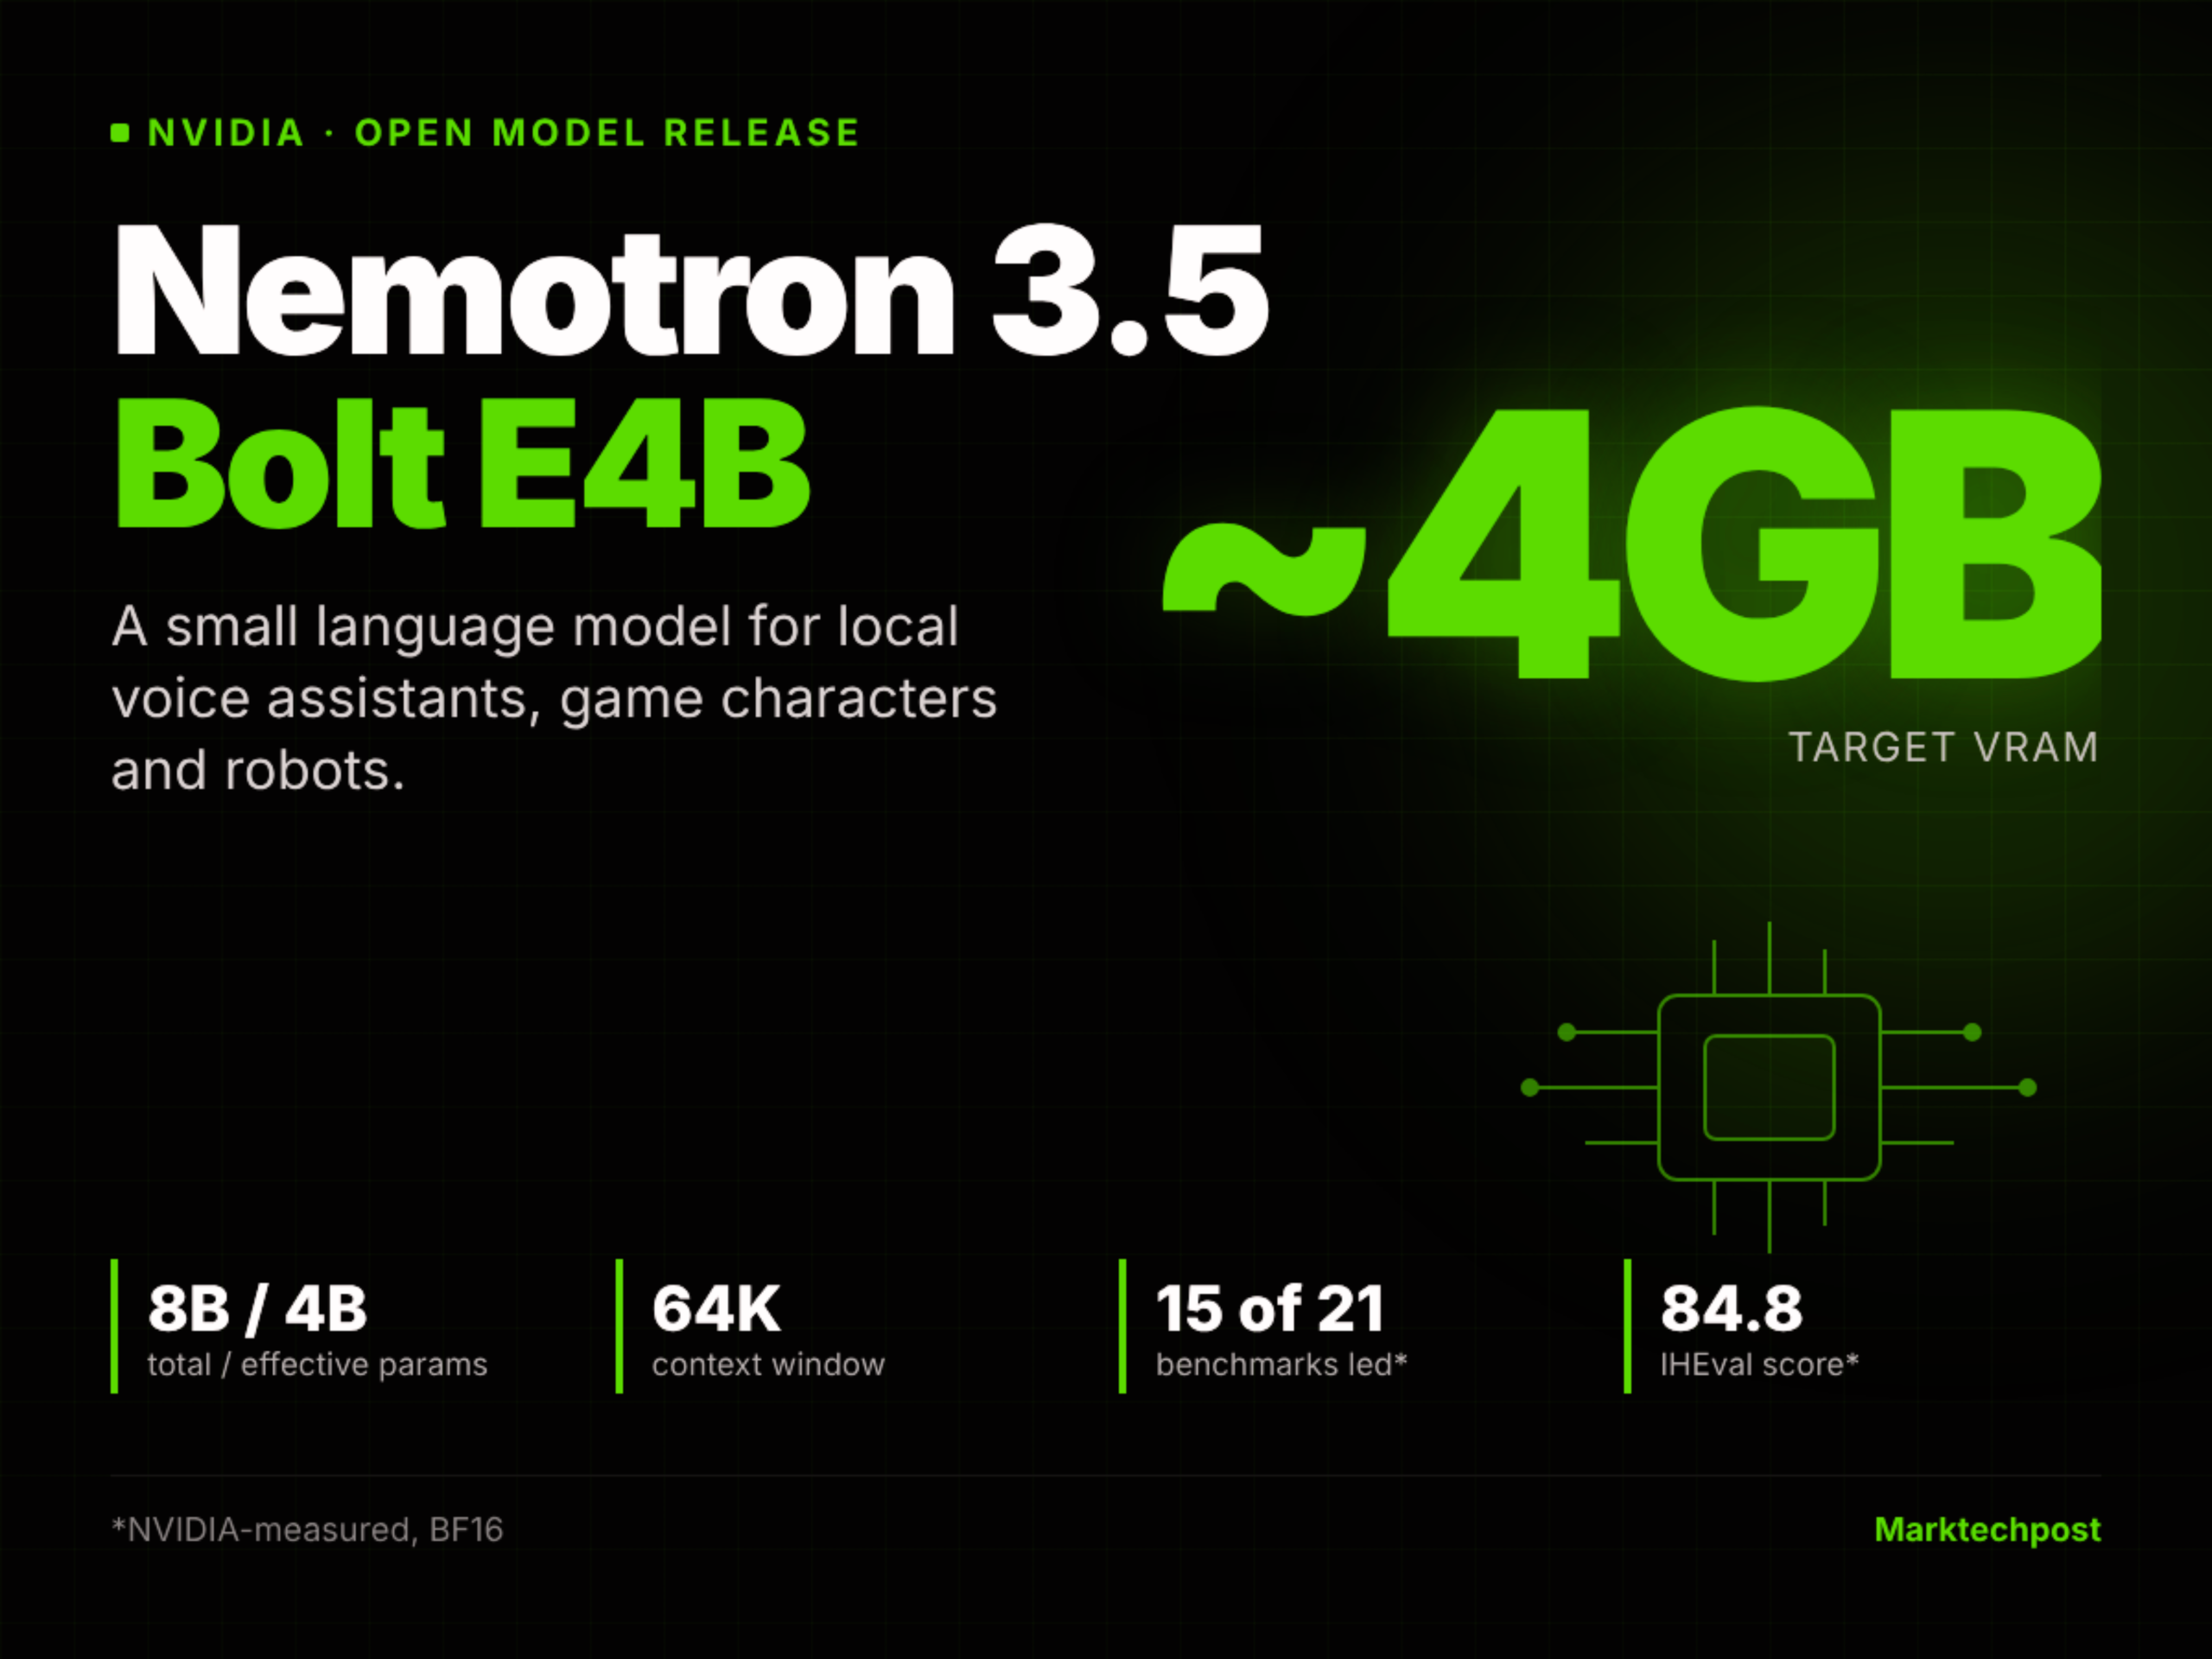
NVIDIA基于Google Gemma 4 E4B模型,仅通过强化学习(RL)后训练推出Nemotron 3.5 Bolt E4B 4GB——一款8B总参、4B有效参数、64K上下文的开源小语言模型,目标在RTX、Jetson等边缘设备上以约4GB VRAM运行,支持多轮工具调用与低延迟语音交互。
NVIDIA基于Google Gemma 4 E4B模型,仅通过强化学习(RL)后训练推出Nemotron 3.5 Bolt E4B 4GB——一款8B总参、4B有效参数、64K上下文的开源小语言模型,目标在RTX、Jetson等边缘设备上以约4GB VRAM运行,支持多轮工具调用与低延迟语音交互。