
等不及了!日本开发者手搓“Qwen4”,Prefill速度提升近3倍
智猩猩AI整理 编辑:没方 前天,日本开发者Ryu在X平台宣布,自己基于阿里通义的Qwen3.8-27B模型,开发出了一个名为Qwen3.8-27B-QSA的改造版本。 ....
检索标题、摘要与正文,把分散的信息连起来。
智猩猩AI整理 编辑:没方 前天,日本开发者Ryu在X平台宣布,自己基于阿里通义的Qwen3.8-27B模型,开发出了一个名为Qwen3.8-27B-QSA的改造版本。 ....
智猩猩AI整理 编辑:没方 前天,日本开发者Ryu在X平台宣布,自己基于阿里通义的Qwen3.8-27B模型,开发出了一个名为Qwen3.8-27B-QSA的改造版本。 ....
万万没想到,二十年前我真情实感追过的【飞雪】CP,居然会在二十年后,以这样一种谁都预料不到的方式突然爆火…… 这段时间《后会友期》里那句“我画地为牢,厉娜”已经在我的生活中无孔不入。 ....
面壁RSI:AI自研算子,重塑算 力底层。
Rivian并未透露,这笔价值58亿美元的合资项目是否会因此而进一步扩容。

金磊 发自 上海 量子位 | 公众号 QbitAI 我愿称之为,国产芯片界的真勇士。 事情是这样的。 一家国产芯片公司,竟敢把自家的GPU和英伟达H200,直....
2026 年 9 月 4 日,又一年柏林国际消费电子展 IFA 大会开幕,会展中心的创新舞台座无虚席。IFA 2026 的开幕主题演讲题目是《个人 AI 时代:想象力的未来》,主讲人是 AMD 高级副总裁、计算与图形事业部总经理 Jack Huynh。作为消费电子圈每年最重要的场合之一,台下所有人都在等 AMD 拿出年度最重磅的内容。Huynh 的前半段...
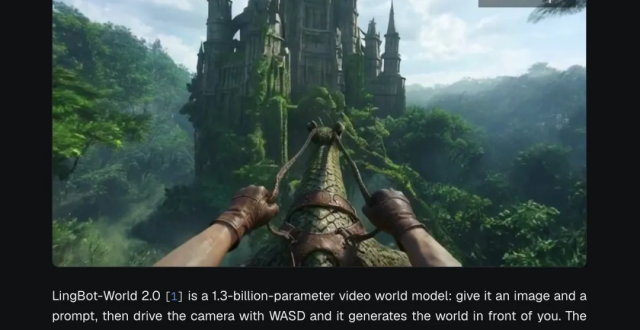
2026 年 9 月 4 日,又一年柏林国际消费电子展 IFA 大会开幕,会展中心的创新舞台座无虚席。 IFA 2026 的开幕主题演讲题目是《个人 AI 时代:想象力的未来》,主讲人是 AMD 高级副总裁、计算与图形事业部总经理 Jack Huynh。 作为消费电子圈每年最重要的场合之一,台下所有人都在等 AMD 拿出年度最重磅的内容。Huynh 的前半段演讲照例讲硬件:新一代 Ryzen AI Max PRO 处理器,AMD 历经多年打磨、专为个人 AI 设计的笔记本「Sundance」。 到演示环节,他话锋一转:「如果说,用一句 prompt 就创造一整个世界呢?」 他双手托着笔记本,屏幕上没有播放键,镜头平稳地向前推进,穿过中国小镇的街巷,又走上欧洲乡村的小路,光影随着视角移动自然变化,世界一路向前铺展,仿佛没有尽头。 这不是一段提前渲染好的视频,而是一个正在实时生成、可以交互的三维世界。 过去一段时间,这类能力更多出现在实验室和论文演示里,能以这么高的完成度,出现在消费电子展的主舞台上,还是行业第一次。 演示结束时,Huynh 对着话筒说了句:「This is the future of Personal AI。」 很多人不知道的是,驱动这个演示的世界模型 LingBot-World 2.0,正来自蚂蚁集团旗下的具身智能团队灵波科技(Robbyant)。 三个月后回看,那场演示只是一个开始。从高校实验室到芯片厂商的开发套件,从独立开发者的工具到垂直行业的工作流,LingBot(灵波)系列模型正在进入全球具身智能的技术底层,成为很多团队创新的起点,甚至还进入了红海珊瑚礁的研究现场。 01 成为学术研究的参考基准 能被 AMD 选上舞台,不是运气。在此之前,灵波已经在全球具身智能的学术圈成了一把隐形标尺。 世界模型赛道有个公认的难题:物体恒存。简单说就是镜头离开一个物
arXiv:2610.36668v1 发布类型:新 摘要:阿希服从实验近来作为衡量大型语言模型(LLMs)中从众行为的一种手段而备受关注。尽管先前的研究主要致力于证明大型语言模型中的从众现象,但我们的工作在此基础上进一步引入了定量分析维度。我们并未针对一系列问题对前沿大型语言模型进行抽样,而是通过反复采样同一个问题,利用大型语言模型的概率特性生成答案分布。由此,我们可以比较模型在被呈现人为制造的共识前后答案分布的变化。实验结果证实,前沿大型语言模型确实存在从众现象,这与先前文献的结论相一致;同时,借助我们提出的分布间对比方法,还提供了更多……
随着智能体逐渐走向主流,一些出版商希望用户为专为AI而非人类量身定制的内容付费。
闫德利 腾讯公司资深专家LLM是概率模型,不知因果大语言模型(LLM)并不理解语言,只是在预测下一个token(Next Token Prediction)。它是一个枯燥的“文字接龙”机器,走一步,算一步,不走回头路。LLM在本质上是概率模型,在统计共现结构里学习“什么经常和什么一起出现”,输出的是“通常如此”,不理解“为什么如此”,...
vLLM 语义路由器发布了 d3-ultra,一款拥有 270 亿参数的开源多模态决策模型。它能够一次性读取文本、图像和视频,并为每个可能的答案返回概率,在该团队的 SR-Text 测试中取得了 87.2 分。原文“vLLM 语义路由器发布 d3-ultra:一款 270 亿参数的开源多模态决策模型”首发于 MarkTechPost。

百度发布了 Unlimited OCR 2,这是一款采用 MIT 许可证的 3B 参数规模的 OCR 模型,能够在一次请求中解析百页文档。其 SR-SWA 注意力机制使每步解码开销几乎保持不变,在 MarathonDocBench 上取得了 77.1 的得分。该文章《百度开源 Unlimited OCR 2,用于百页文档解析》首发于 MarkTechPost。

在其30年的历史中,思科合作伙伴峰会大多聚焦于合作伙伴如何销售思科系统公司的技术。而今年在温哥华举行的这场盛会则着眼于一个全新的议题:在交易已不再是核心环节的当下,合作伙伴该如何实现盈利。思科携强劲势头亮相此次盛会,其股价正处于[…]。文章《思科合作伙伴峰会:五大洞见将定义AI时代的渠道生态》首发于SiliconANGLE。
arXiv:2610.34907v1 发布类型:新 摘要:在NVIDIA Hopper架构中推出的张量内存加速器(TMA),已在生产环境中的GPU内核中得到广泛应用,但其使用却表现出明显的选择性:CUTLASS、FlashAttention-3和FlashInfer等领域的资深内核开发者仅对内核中的部分张量操作数采用TMA,而对其余操作数则退回到cp.async、直接全局加载或分布式共享内存(DSM)等方式。厂商文档虽已说明了该API,近期的微基准测试也单独刻画了TMA的吞吐性能,但这些研究均未能解答从业者实际面临的疑问:在内核中遇到某个内存操作数时,究竟是否应使用TMA?若使用,又该搭配还是不搭配集群多播?我们通过一项基于工作负载的实证研究,在H100平台上填补了这一空白。我们系统地梳理了TMA、多
arXiv:2610.32104v1 发布类型:新 摘要:为刻画Transformer架构的能力与局限性,人们已发展出若干形式化理论,这些理论分别采用不同的抽象方法,以捕捉该架构的不同特性。由于其底层假设与概念框架存在差异,这些理论在预测Transformer对哪些任务感到容易或困难时往往意见不一。我们梳理了七种关于Transformer能力的理论(Star-free、$\mathsf{AC}^0$、$\mathsf{TC}^0$、C-RASP、MPC、BAPO以及敏感性),并将其研究结果转化为一张通用的预测矩阵,覆盖一系列涉及不同计算结构的任务。我们还提供了新的理论成果,以完善这一矩阵。随后,我们对这些理论进行评估
网络安全行业发现,强大的前沿人工智能模型是一把双刃剑。企业可以利用这些模型,以前所未有的速度识别源代码和系统配置中的漏洞。然而,事实证明,恶意行为者同样也能做到这一点。一个典型的例子表明,人工智能模型已将网络安全推向了一个全新的[…] 该文章“双刃齐发:人工智能在强化系统防护的同时也为恶意行为者打开了新的漏洞入口”首发于SiliconANGLE。
麻省理工学院社区的各界代表齐聚一堂,就数据中心、超级污染物、农业与教育等议题展开了讨论。
今天,我采访了记者兼新书《AGI编年史》的作者凯文·鲁斯。这本书详细记录了人工智能行业近期发生的剧烈变革。凯文曾长期担任《纽约时报》记者,并主持过热门播客节目“Hard Fork”,但他与节目好友凯西·牛顿刚刚离开了[…]


Coyotec 既会说双语,又爱骂人,还教听众如何防范美国移民及海关执法局(ICE)。它的走红正值越来越多的广播机构开始尝试打造人工智能虚拟人格之际。