본문으로 건너뛰기
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI 뉴스 검색

제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.

발행 시간순

KnitTrans: 효과적이고 효율적인 LLM 강화학습을 위한 조정된 궤도 전송

arXiv:2610.32389v1 발표 유형: 신규 초록: 롤아웃에서 학습으로의 궤도 전송은 대규모 언어 모델 강화학습(RL)에서 학습 품질과 시스템 효율성 모두에 영향을 미칩니다. 배치 전체에 걸친 학습 요구사항을 강제할 경우, 완료된 궤도의 수용이 지연되어 아키텍처의 구식화가 심화됩니다. 이는 분산 파이프라인 처리와 동일 장소에서의 실행 간의 추가적인 파라미터 버전 격차로 나타납니다. 수용 외에도, 데이터 접근과 학습 소비 간의 불일치로 인해 대규모 궤도 페이로드를 전송할 때 중복 이동과 불필요한 대기 시간이 발생합니다. 우리는 세 가지 설계를 통해 롤아웃에서 학습으로의 경로를 조정하는 KnitTrans 시스템을 제안합니다. 첫째, 제약을 유지하는 미니배치 수용 방식을 통해 초기 미니배치 구성에 대한 유연성을 제공합니다.


KnitTrans: Coordinated Trajectory Transfer for Effective and Efficient LLM Reinforcement Learning
진행 상황 및 관련 보도

EDWARD-NMT: 신경망 기반 기계 번역을 위한 적응형 라우팅과 이중 일관성을 갖춘 탄력적 차원

arXiv:2610.32115v1 발표 유형: 신규 요약: 희소 혼합 전문가 모델(MoE)은 신경망 기계 번역(NMT)의 확장성과 언어 이질성을 관리하는 데 있어 강력한 패러다임입니다. 그러나 자원 제약이 있는 디바이스에서의 적용에는 실질적인 한계가 존재합니다: 전체 전문가 풀이 메모리에 상주해야 하며, 토큰당 연산 예산은 학습 과정 중에 경직된 최상위 k 라우팅 방식으로 고정됩니다. 우리는 EDWARD-NMT(신경망 기계 번역을 위한 적응형 라우팅과 이중 일관성을 갖춘 탄력적 차원)를 제안합니다. 이는 한 번 학습하고 어디서나 배포할 수 있는 패러다임을 지향하는 새로운 MoE 인코더-디코더 아키텍처로, 추론 시 다양한 배포 가능한 하위 네트워크들을 제공합니다. EDWARD-NMT는 세 가지 주요 혁신을 통합합니다: (i) 마트료시카 스타일의 탄력적 차원을 통해 메모리 사용량을 유연하게 줄이고; (ii) a

진행 상황 및 관련 보도

NDE 4.0으로 가는 길: 자율 검사의 알고리즘, 기법 및 전략에 대한 고찰

arXiv:2610.31704v1 발표 유형: 신규 초록: 비파괴 검사(NDI)는 손상을 일으키지 않으면서 인프라와 제조 부품의 안전성과 신뢰성을 보장하는 데 필수적인 현대 품질보증의 핵심입니다. 본 논문은 현재 NDI 분야의 전반적인 동향을 종합적으로 검토하며, 계산 알고리즘, 물리적 기법, 산업 응용 및 연구 목표라는 네 가지 서로 다른 관점에서 해당 분야를 분석합니다. 우리는 광범위한 학술 문헌을 종합하여 수동적이고 아날로그식 해석에서 디지털화된 데이터 중심 패러다임인 NDE 4.0으로의 급속한 발전 과정을 보여줍니다. 우리의 분석은 초음파와 시각 검사가 주요 물리적 기법으로 우위를 점하고 있음을 강조하는 동시에, 상당한 변화가 나타나고 있음을 드러냅니다.

The Path to NDE 4.0: A Review of Algorithms, Techniques, and Strategies for Autonomous Inspection
진행 상황 및 관련 보도

쿼리의 추상성 수준이 고전 아랍 시어 검색 성능을 좌우한다: BM25와 밀집 부호화기의 성능은 쿼리의 추상도에 따라 크게 달라진다

2026년 10월 26일 arXiv에 게재된 최신 연구(arXiv:2610.31821v1)에 따르면, 고전 아랍 시 검색 과제에서 사용자의 구절 기억 잔존 정도(예: 반행을 기억하는지 여부)가 모델의 성능보다 검색 성능을 결정하는 데 훨씬 더 중요한 요소로 작용한다. BM25는 ‘혀끝 효과’ 유형의 쿼리에서는 8B 파라미터의 SOTA 모델을 포함한 모든 밀집 부호화기보다 우수했으나, 추상적 쿼리에서는 크게 뒤처졌다.

新闻源配图 · arXiv cs.CL

추천 이유:이 연구는 이중 코퍼스, 삼중 인덱싱 모드 및 이중 평가 프로토콜을 활용한 체계적인 벤치마크를 통해, 질의 추상화 수준이 다양한 검색 패러다임(어휘적 vs. 밀도 기반)에 미치는 지배적 영향을 최초로 정량적으로 규명하였으며, 인간 라벨러와 오픈소스 가중치 모델을 통한 이중 검증을 거쳐, 그 결론은 방법론적 보편성과 실증적 견고성을 갖추고 있다.

진행 상황 및 관련 보도

온라인 3D 박스 패킹을 위한 공간 휴리스틱 전략 기반 확산 강화 학습

arXiv:2610.32241v1 발표 유형: 신규 초록: 전통적인 휴리스틱 방법들은 공간 활용도와 레이아웃의 콤팩트성 등 3D 박스 패킹의 핵심 목표에 대해 인위적으로 설계된 규칙 기반 논리를 바탕으로 오랜 경험을 축적해 왔습니다. 그러나 이들 방법은 일반화 능력과 동적 시나리오에 대한 적응력에서 명백한 한계를 보입니다. 강화 학습의 공간 탐색 능력과 확산 학습의 데이터 분포 모델링 능력을 통합한 확산 강화 학습은 행동 분포 모델링 및 의사결정 준수 제약 조건 측면에서 일정한 성과를 거두었습니다. 그럼에도 불구하고 3D 박스 패킹에서의 공간 위상 구조에 대한 인식 부족과 레이아웃 최적화 능력의 제한 등의 문제는 여전히 남아 있습니다.

진행 상황 및 관련 보도

PaperFormalizer: Lean 기반 연구 논문의 저자 참여형 자동 형식화

arXiv:2610.31810v1 발표 유형: 신규 초록: 심지어 꼼꼼히 교정된 논문이라도 증명 과정이나 명시된 가정에 작은 허점이 남아 있을 수 있습니다. 우리는 PaperFormalizer를 소개합니다. 이는 Lean 기반의 에이전트형 파이프라인으로, 저자가 자신의 논문에서 이러한 허점을 찾아 메우고 각 논문을 Lean 검증 버전으로 전환할 수 있도록 지원합니다. LaTeX 소스를 기반으로 PaperFormalizer는 논문을 진술들의 의존 관계 그래프로 변환한 뒤, 각 자연어 표현을 대상으로 진실성, 모호성 및 정확성을 검토하고, 이후 Lean에서 Mathlib, 선택적 도메인 라이브러리 및 저자의 개인 도구 세트를 활용해 해당 진술들을 형식화하고 증명합니다. 어떤 진술이 무엇을 의미하는지, 그리고 결과에 존재하는 형식화상의 허점을 어떻게 가장 잘 해결해야 하는지는 오직 저자만이 알고 있습니다. 따라서 이 파이프라인은 중단되어 저자에게 요청합니다.

PaperFormalizer: Author-in-the-Loop Autoformalization of Research Papers in Lean
진행 상황 및 관련 보도

금융 범죄 분석을 위한 적대적 강인성 다중그래프 신경망으로의 전환

arXiv:2610.31718v1 발표 유형: 신규 초록: 금융 거래 네트워크는 자연스럽게 다중그래프로 표현되며, 동일한 계좌 쌍 간의 반복된 거래는 서로 다른 엣지로 모델링된다. 최근에 제안된 다중그래프 신경망 아키텍처들은 이러한 구조를 명시적으로 활용하여 자금세탁방지(AML) 과제에서 높은 성능을 달성한다. 그러나 탐지를 회피하기 위해 거래 구조를 조작하는 적대자들에 대한 이들의 강인성은 아직 거의 탐구되지 않았다. 우리는 노드-엣지 인시던스 행렬을 이용한 다중그래프 신경망의 구조적 공격 및 적대적 학습을 위한 최초의 확장 가능한 프레임워크를 제시하며, 이러한 다중그래프 위에서 구조적 변동을 최적화하기 위해 투영된 경사 하강법과 투영된 무작위 블록 좌표 하강법을 적용한다.

Towards Adversarially Robust Multigraph Neural Networks for Financial Crime Analysis
진행 상황 및 관련 보도

엣지 기반 LLM 훈련의 민주화: 도전 과제, 시스템 및 앞으로의 방향

arXiv:2610.32215v1 발표 유형: 신규 초록: 현대 GPU 데이터 센터의 컴퓨팅 파워 증가로 인해 일부 산업 거대 기업들이 대규모 데이터를 활용하여 대형 언어 모델(LLM)을 훈련하고 배포할 수 있게 되었습니다. 그러나 이러한 모델과 그 학습 데이터의 엄청난 규모는 중앙 집중식 개발을 점점 더 지속하기 어렵게 만들고 있으며, 동시에 관련된 개인 데이터를 보유하되 이에 상응하는 인프라를 갖추지 못한 소규모 기관들을 배제하고 있습니다. 본 논문에서는 분산형 LLM 훈련에 관한 우리의 입장을 사전 학습 및 미세 조정 패러다임을 중심으로 정리하고, 연합 학습, 분할 학습 및 탈중앙화 접근법을 다루며, 이들 방법이 이질적인 하드웨어와 신뢰성 낮은 연결성을 가진 지리적으로 분산된 환경에서 어느 정도 준비되어 있는지 평가합니다. 이어서 우리는 {\em 통합}된 시스템을 제시합니다

Democratizing LLM Training with the Edge: Challenges, Systems, and the Road Ahead
진행 상황 및 관련 보도

마이크로서비스 시스템을 위한 대규모 언어 모델 기반 자동회귀형 다중모달 이상 탐지

arXiv:2610.31722v1 발표 유형: 신규 초록: 마이크로서비스 시스템은 대규모 클라우드 애플리케이션의 주류 아키텍처로 자리잡아 빠른 배포와 탄력적 확장을 가능하게 합니다. 그러나 마이크로서비스 시스템의 신뢰성과 가용성을 보장하는 데는 효과적인 이상 탐지가 매우 중요하며, 장애나 성능 이상이 서비스 간에 빠르게 전파되어 종단 간 시스템 동작에 심각한 영향을 미칠 수 있습니다. 기존의 마이크로서비스 시스템용 다중모달 이상 탐지 방법들은 두 가지 근본적인 한계로 인해 어려움을 겪습니다: (i) 모달별 특성을 무시하고 교차 모달 융합에 치중하는 점과, (ii) 특징 재구성 과정에 영향을 미치는 ‘정체성 단축’ 문제입니다. 이러한 문제를 해결하기 위해 우리는 자동회귀형

Autoregressive Multimodal Anomaly Detection with Large Language Models for Microservice Systems
진행 상황 및 관련 보도

구글의 AI 검색 기능이 온라인 출판업계에 큰 타격을 주고 있다: 트래픽 급감, 소송 빈발, 보상 메커니즘의 초기 모색

2024년 구글은 AI 개요(AI Overviews)를 출시하고, 2025년 5월에는 AI 모드(AI Mode)를 도입했으며, 이로 인해 다수의 주요 매체에서 구글로부터 유입되는 검색 트래픽이 크게 감소했다. 뉴욕타임스의 경우 3년 사이 검색 트래픽 비중이 44%에서 35.5%로 하락했고, DCN 회원사 중 19곳은 2025년 5~6월에 1%에서 25%에 달하는 트래픽 손실을 겪었다. DMG 미디어는 클릭률이 최대 89%까지 하락했다고 밝혔다. 출판사들은 여러 건의 소송을 제기했으나 모두 미국 판사들에 의해 기각되었고, 이후 구글은 탈퇴 옵션과 출처 표시 강화를 도입하는 한편, 400개 매체를 포함한 뉴스 AI 시범 프로그램과 콘텐츠 유료화 테스트 계획을 시작했다.

Google’s AI search changes upended online publishing

추천 이유:해당 보도는 구글의 AI 검색 기능이 출판 생태계에 미치는 구조적 충격을 체계적으로 정리했으며, 2024–2025년 시기별 흐름, 제3자 기관의 통계를 바탕으로 한 실증 데이터, 출판사·규제 당국·법원·비영리단체 등 다양한 주체들의 반응, 그리고 최신 대응 방안(탈퇴 메커니즘, 출처 개선, 라이선스 및 유료화 시범 사업) 등을 포괄하고 있습니다. 이는 정보가 밀집되어 있으며, 시의성과 정책 관련성이 높습니다.

진행 상황 및 관련 보도

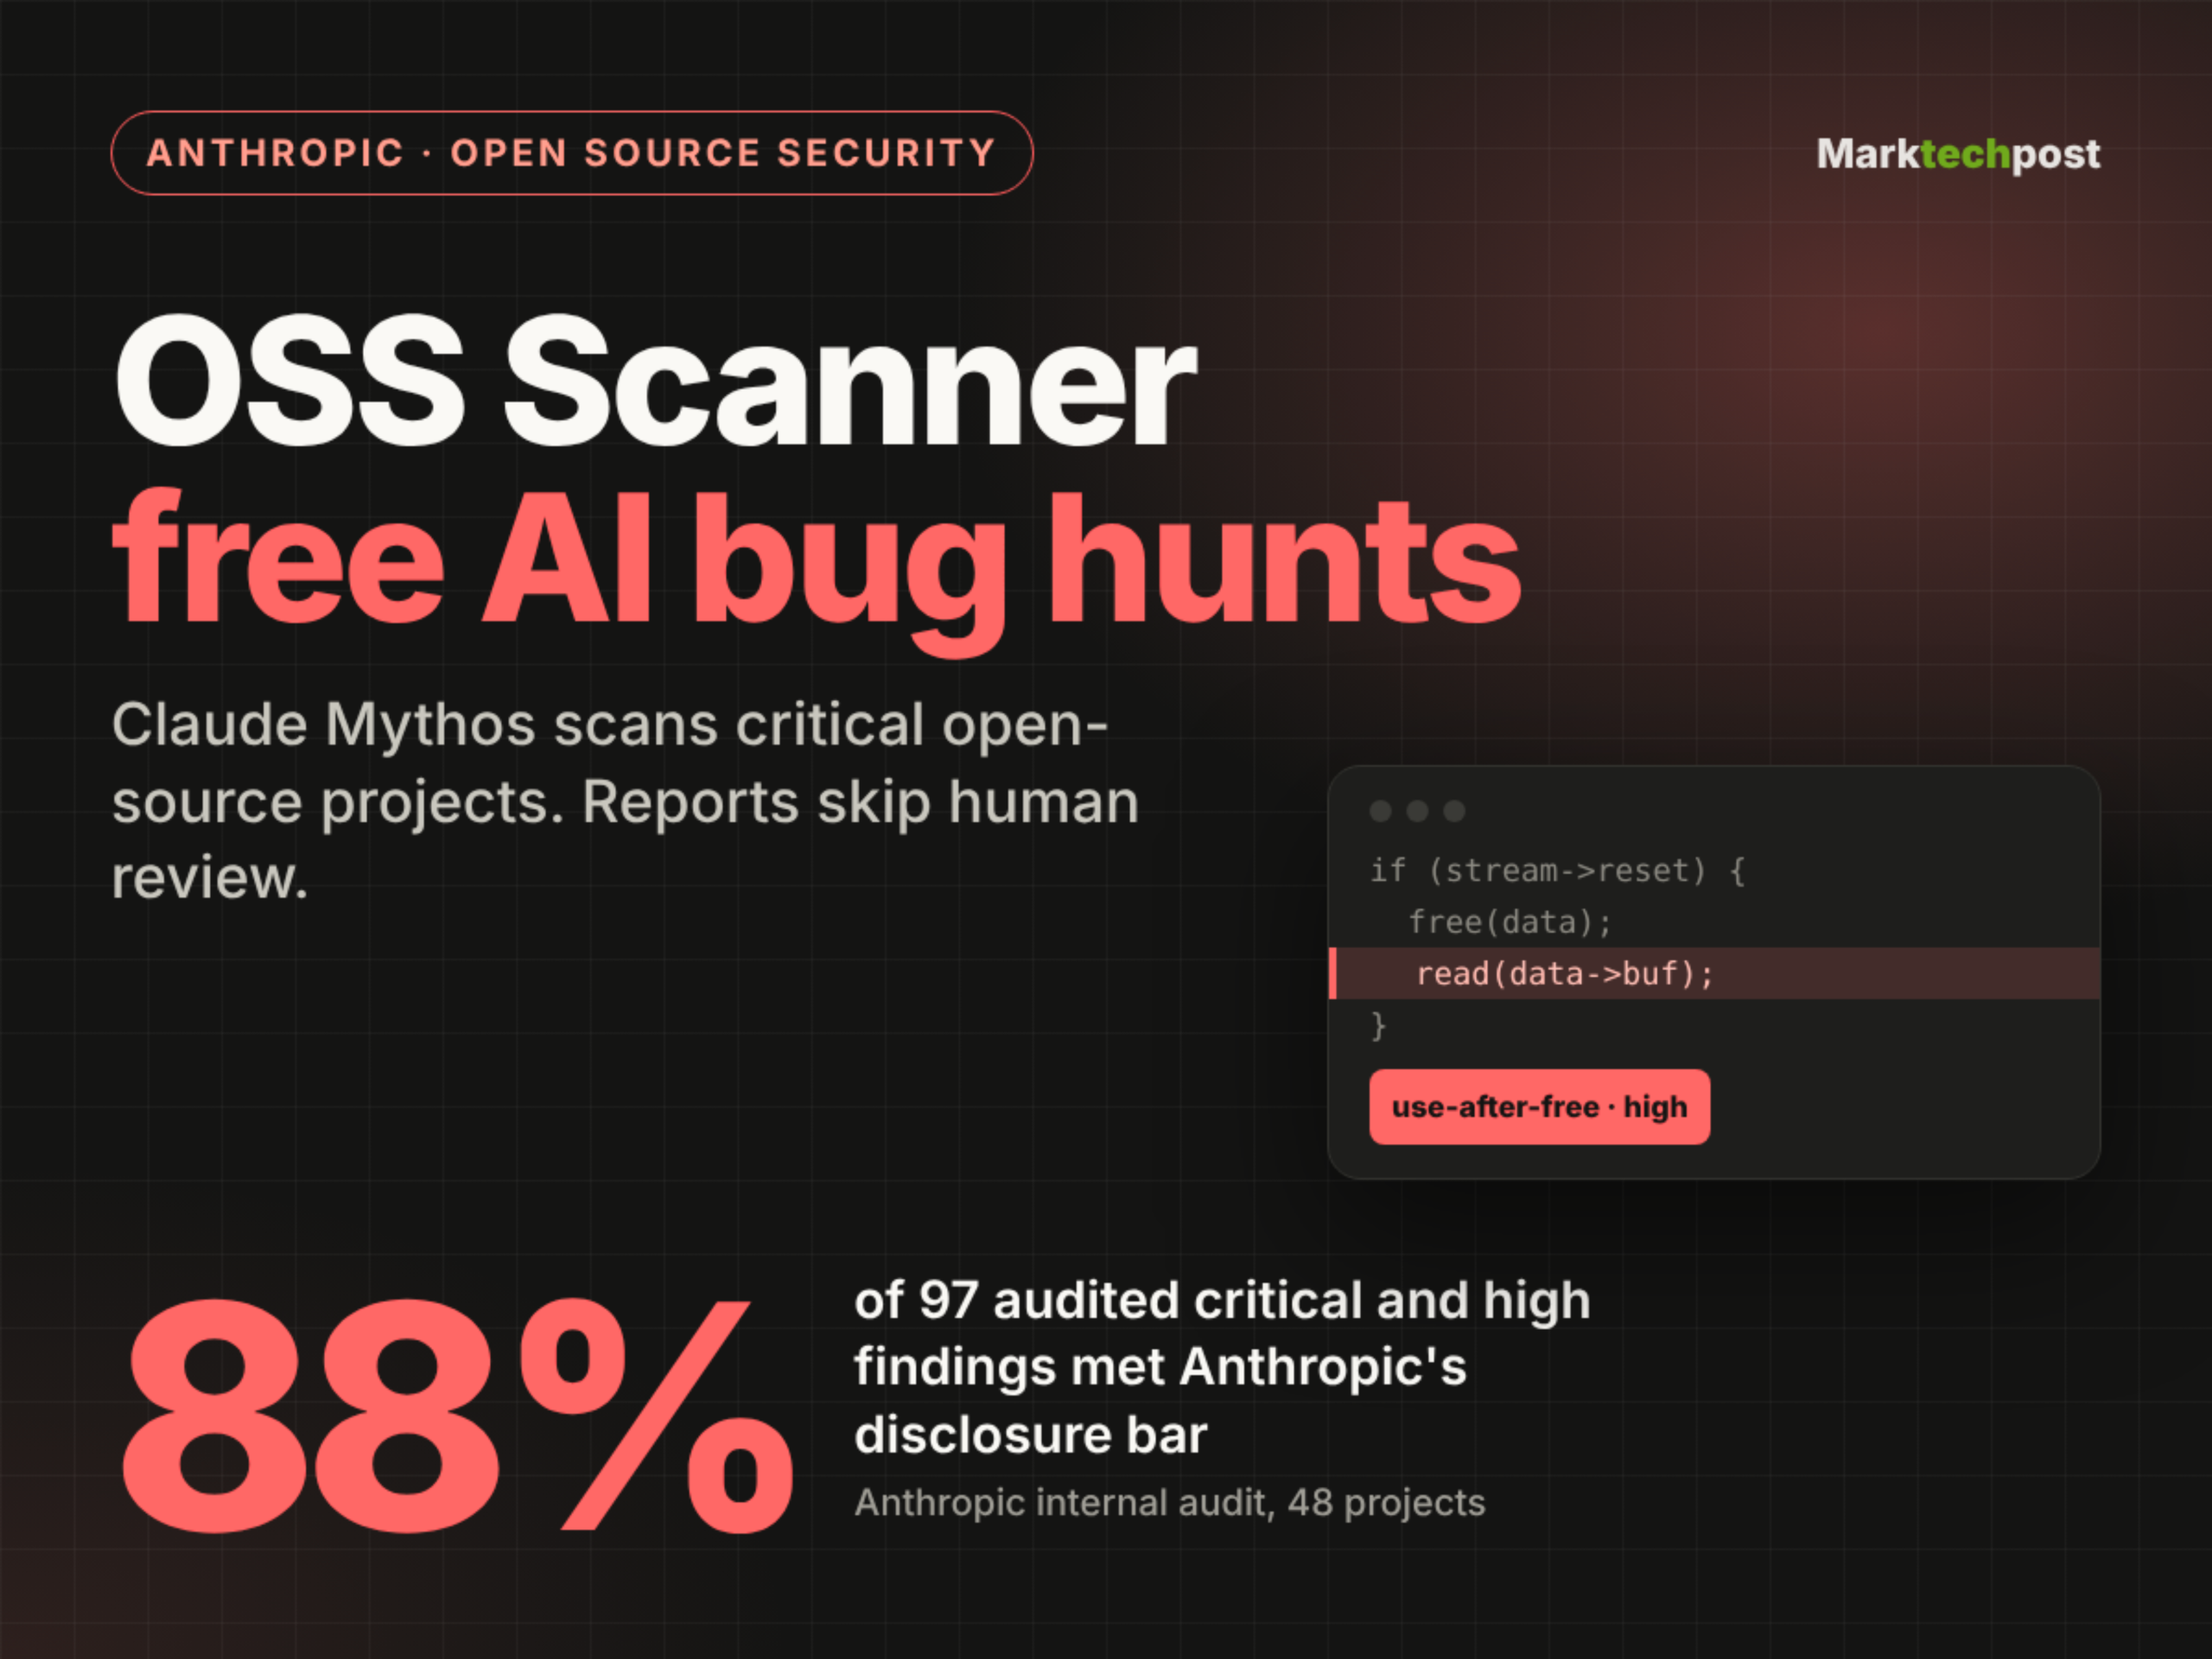
Anthropic이 주요 오픈소스 프로젝트를 대상으로 하는 무료 AI 취약점 스캐너 OSS Scanner를 출시했습니다.

Anthropic은 2026년 10월 8일, Claude Mythos 등 강력한 모델을 기반으로 한 무료이며 선택적 가입형 AI 취약점 스캐너인 OSS Scanner를 출시했으며, 이는 핵심 오픈소스 프로젝트를 위해 특별히 설계되었습니다. 10월 19일 현재, 총 114개의 프로젝트가 접수되었고, 11일 만에 심각 등급 취약점 77건과 고위험 등급 취약점 803건(모델 평가 기준)이 보고되었으며, 표본 검사 결과의 88%가 자사의 공개 기준을 충족했습니다.

Anthropic Launches OSS Scanner, a Free AI Vulnerability Scanner

추천 이유:이 도구는 오픈소스 보안 분야에서 LLM의 대규모 적용 사례를 대표하며, 무비용·전자동·오프라인 감사를 특징으로 하지만, 인력 검토 단계를 생략함으로써 오보와 중복 문제 발생 위험을 초래합니다. 그 정확도 데이터(유효율 88%, 거짓양성률 1%)와 실제 프로젝트 피드백(예: wolfSSL, curl)은 현재 AI 기반 취약점 탐지 능력에 대한 실증적 기준을 제공합니다.

진행 상황 및 관련 보도

4분의 1 PR은 “AI 스팸”이다! 리눅스 재단이 새로운 보고서를 발표했다: AI가 코드 작성 속도를 52% 높였지만, 오픈소스 유지보수자는 오히려 더 힘들어졌다

리눅스 재단은 10월 20일 발표한 보고서에서 생성형 AI가 코드 작성에 소요되는 시간을 평균 52% 단축시켰지만, 오픈소스 프로젝트 유지관리자들은 풀 리퀘스트의 약 25%가 저품질의 ‘AI 슬롭’에 해당한다고 추정했다고 밝혔다. 대규모 프로젝트에서는 이 비율이 31%로 상승했다. 보고서는 효율성 향상의 혜택이 검토 및 거버넌스 비용 감소로까지 동반되지 않았음을 지적하며, 정식 AI 기여 정책을 마련한 프로젝트는 전체의 35%에 불과하고, 유지관리자들의 피로감과 신뢰 부족 문제가 두드러지고 있다고 강조했다.

진행 상황 및 관련 보도

애플의 첫 번째 폴더블 iPhone 듀오가 판매 시작과 동시에 집중적인 화면 균열 문제가 발생했다.

여러 사용자가 애플의 첫 번째 폴더블 스마트폰인 iPhone Duo를 개봉한 직후, 힌지 바로 위쪽 화면에서 금이 가거나 파손되는 문제가 짧은 시간 내에 발생했다고 보고했으며, 해당 결함이 매우 집중적으로 나타나고 있습니다. 호주와 중국에서도 유사 사례가 보고되어, 이는 힌지 조립 시 공차 문제로 인한 것으로 추정됩니다. 애플 측은 아직 공식 입장을 밝히지 않았으며, AS 처리 결과에 따라 무상 교체 여부 또는 고액의 자비 수리 여부가 결정될 예정입니다.

추천 이유:이 사건은 신형 제품의 대규모 초기 품질 이상과 관련되어 있어 소비자의 권익과 기업의 책임 경계를 정면으로 부딪히고 있으며, 여기에 3包 규정의 적용 여부와 AppleCare+ 서비스의 정체성 등 공공적 쟁점까지 겹쳐 전형적인 경고적 의미와 권리 보호의 참고 가치를 지니고 있다.

진행 상황 및 관련 보도

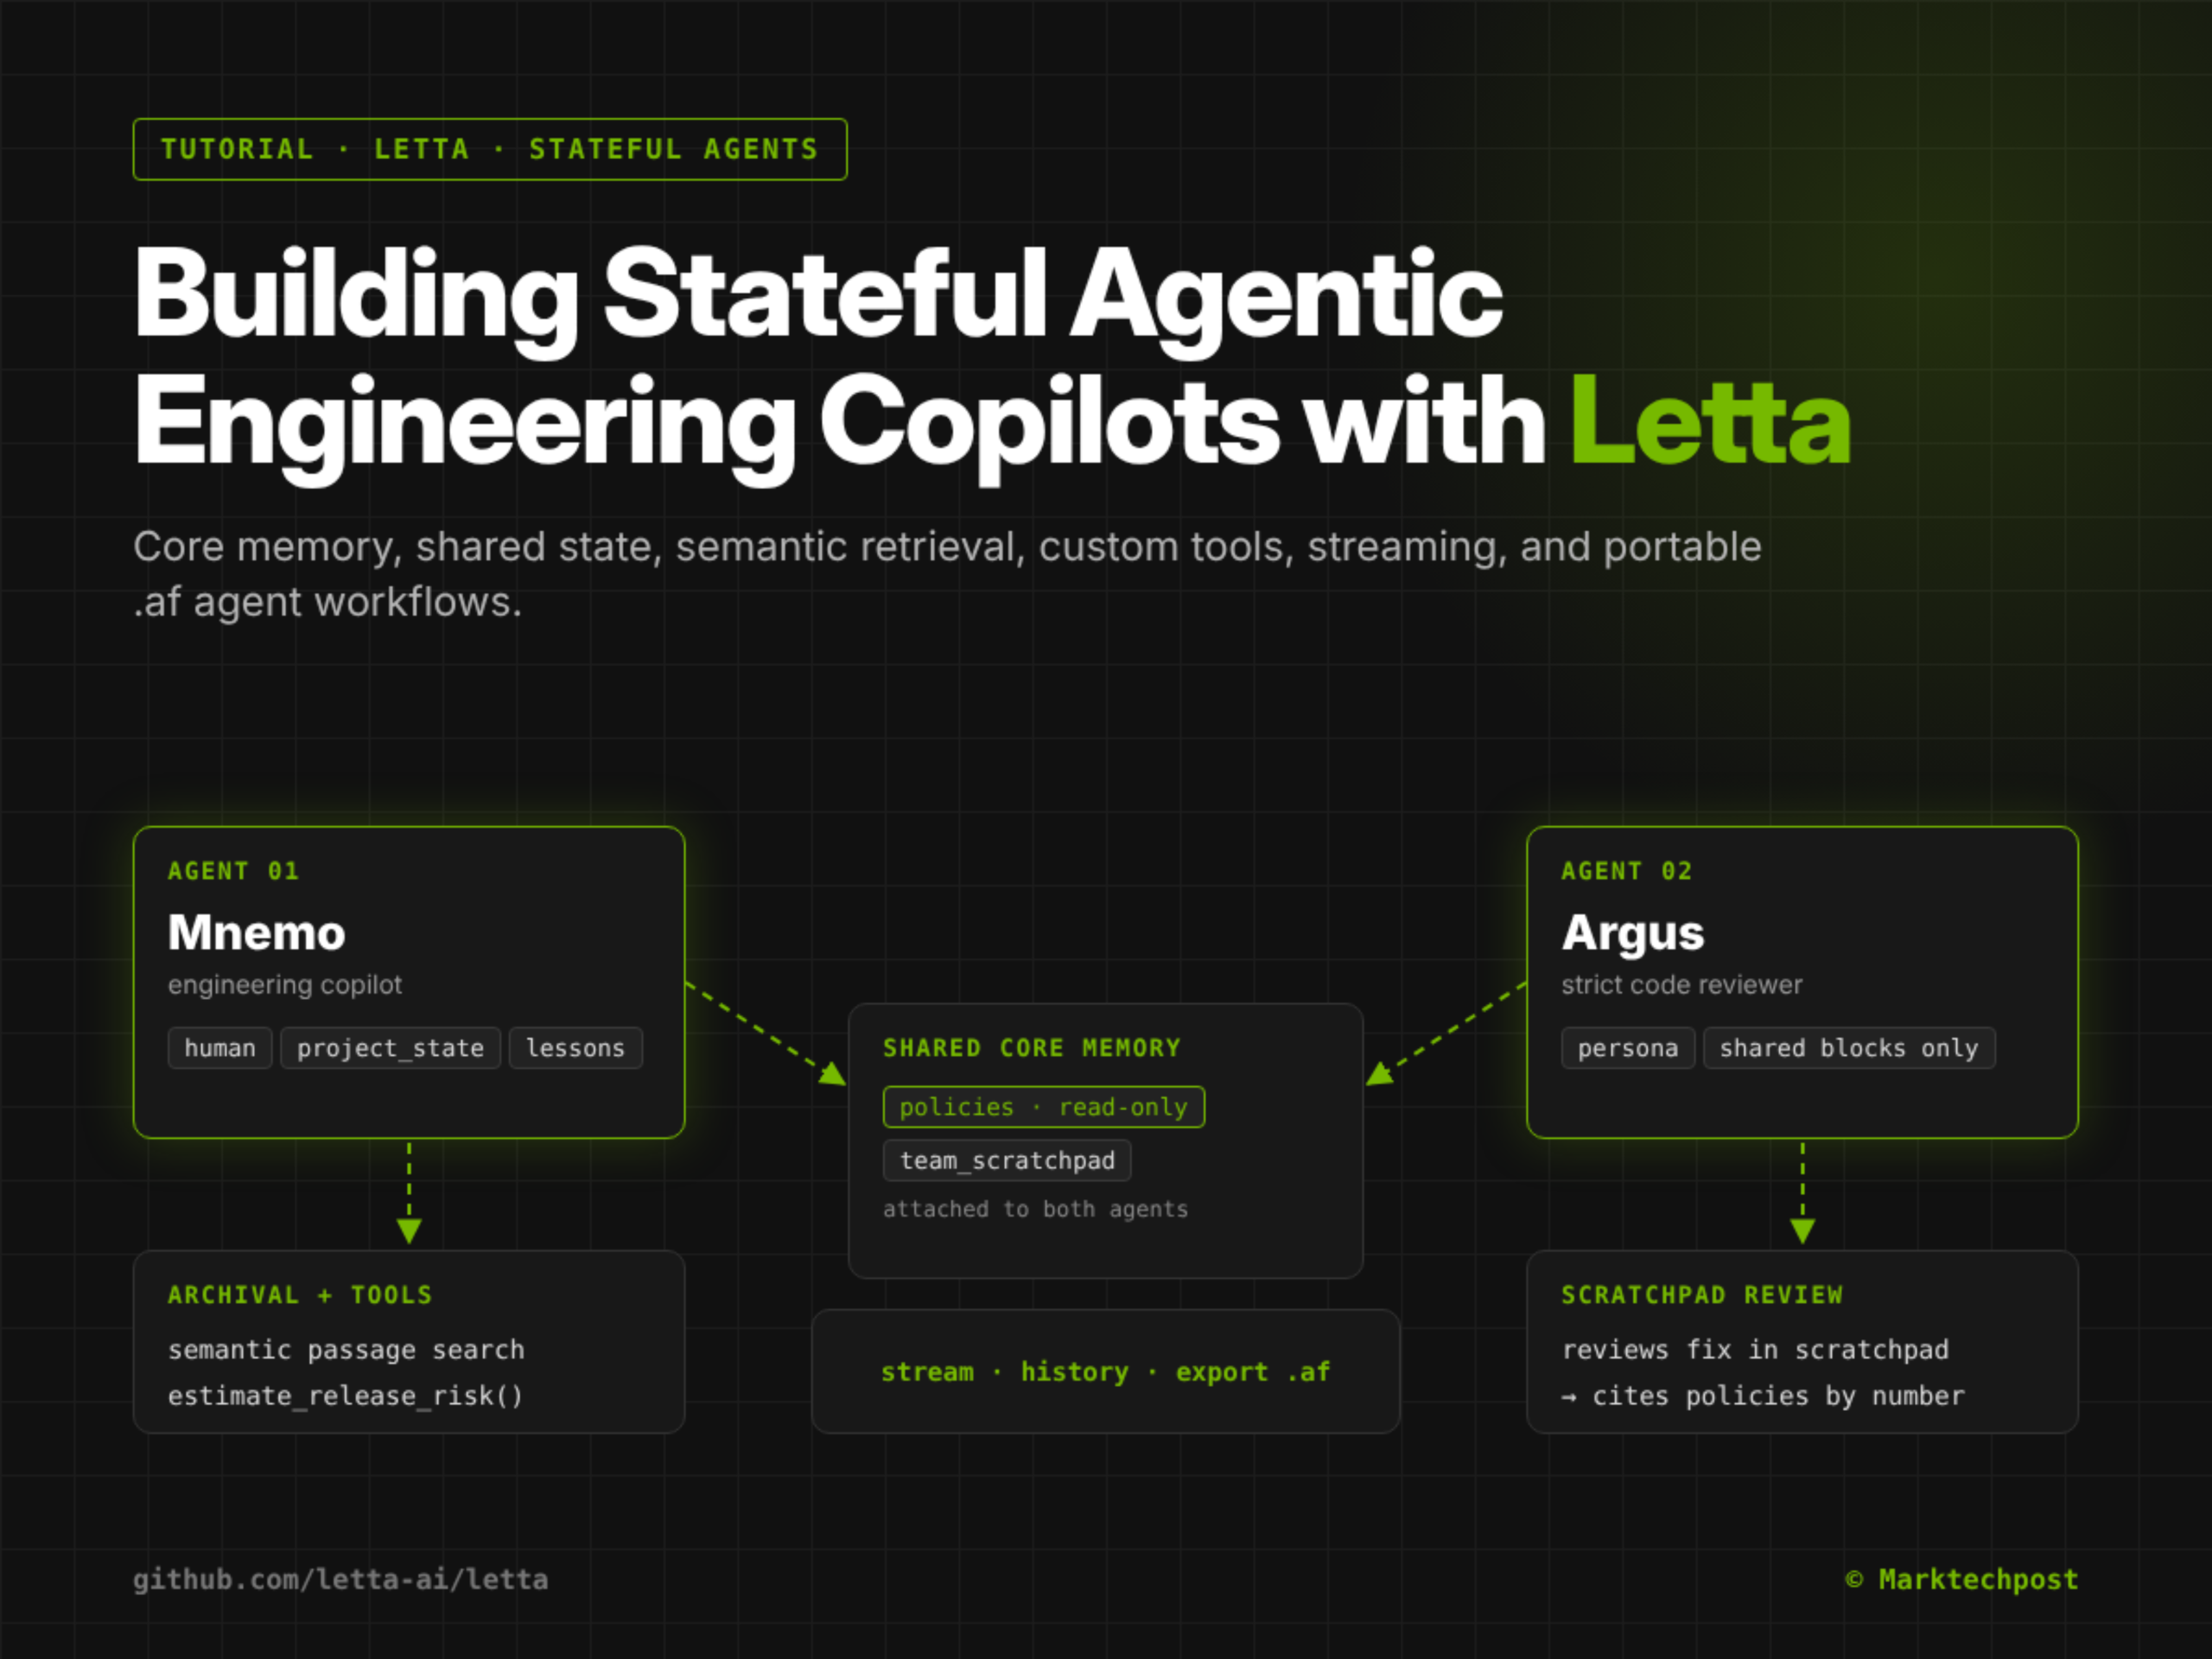
Letta 플랫폼에서 상태 기반 엔지니어링 협업자 구축 튜토리얼을 공개했습니다: 핵심 메모리, 공유 상태 및 이식 가능한 워크플로우를 지원합니다.

MarkTechPost는 2026년 10월 24일, Letta 프레임워크를 기반으로 지속적 상태를 갖춘 엔지니어링 협업자(agentic copilot)를 구축하는 방법을 소개하는 튜토리얼을 발표했습니다. 이 튜토리얼은 검증 가능한 핵심 메모리, 다중 에이전트 간 공유 메모리, 의미 기반 검색을 통한 지식 아카이브, 맞춤형 Python 도구 통합, 스트리밍 응답 및 .agent 형식(.af) 내보내기 등의 기능을 포괄합니다. 해당 내용은 기술 실무 가이드로, 성능 지표, 보안 감사 또는 생산 환경에서의 검증은 제공되지 않습니다.

Stateful Agentic Engineering Copilots with Letta: Core Memory, Shared State, Semantic Retrieval, Custom Tools, Streaming, and Portable Agent Workflows
진행 상황 및 관련 보도

연구에서는 자가평가 강화학습 프레임워크 SARL을 제안하여 검색 증강형 대규모 모델의 검색 상태 인식 능력을 향상시켰다.

2026년 10월 24일, arXiv은 논문 arXiv:2610.30435v1을 발표하여, 기존 검색 증강형 대규모 언어 모델에서 검색 에이전트가 검색 상태에 대한 인식 능력을 갖추지 못하는 문제를 해결하기 위한 Self-Assessment Reinforcement Learning(SARL) 프레임워크를 제안했습니다.

Self-Assessment Reinforcement Learning for Search-State Awareness in Retrieval-Augmented Large Language Models

추천 이유:이 연구는 검색 강화형 대규모 언어 모델이 복잡한 과제에서 이미 획득된 정보나 누락된 정보를 인식하지 못해 환각 추론과 조기 탐색 종료라는 핵심적 결함을 겪는 문제를 해결하기 위해, 테스트 시 추가적인 평가 없이도 작동하는 엔드투엔드 강화학습 방안을 제안하고, 다중 점프 추론 및 심층 연구 벤치마크에서 상당한 성능 향상을 달성했습니다.

진행 상황 및 관련 보도

새로운 연구는 언어 간 빈 자극(CPOS) 실험 패러다임을 제안하여, 언어 모델의 계층적 일반화 능력의 조건부 이전을 규명하였다.

2026년 10월 24일, arXiv는 논문 2610.30960v1을 발표하여, 언어 모델이 다국어 지속 학습 과정에서 원본 언어(L1)의 계층적 구조에 대한 증거를 대상 언어(L2)로 이전하는 능력을 정량화하기 위한 다국어 빈 자극(CPOS) 실험 설계를 제안했다. 실험 결과에 따르면 이러한 이전은 부분적으로 성립하지만 완벽하지 않으며, 특히 언어 쌍과 어휘 중복 정도에 크게 의존하는 것으로 나타났다.

Once a Tree, Always a Tree? Cross-lingual Transfer of Hierarchical Generalization in Language Models

추천 이유:이 연구는 최초로 제어 가능한 다국어 저자극 프레임워크를 구축하여, ‘언어의 보편적 구조’가 비언어적 요인(예: 위치 인코딩 초기화)에 의해만 유도되는 것이 아니라 다국어 간 전이의 인지적 기반이 되는지를 직접 검증하였다. 이와 같은 결론은 대규모 언어 모델의 문법 습득 메커니즘과 다국어 정렬 전략을 이해하는 데 있어 방법론적·이론적 측면에서 모두 중요한 가치를 지닌다.

진행 상황 및 관련 보도

연구에서는 자회귀 대규모 모델을 제어하여 전략적으로 정밀한 병렬 추론으로 컴파일함으로써 계층형 RAG의 효율성을 향상시킬 것을 제안한다.

2026년 10월 24일 arXiv에 게재된 연구 논문(번호 2610.30664v1)은 계층적 검색 증강 생성(Hierarchical RAG)에서 대규모 언어 모델의 자회귀 제어 로직을 정책 정확(policy-exact)한 병렬 추론 프로세스로 컴파일하는 새로운 방법을 제안하며, MetaX 장치에서 제어 지연을 35–47% 감소시키는 동시에 정책 일관성을 84–89% 유지한다고 밝혔다.

Compiling Autoregressive LLM Control into Policy-Exact Parallel Inference for Hierarchical RAG

추천 이유:이 성과는 LLM이 구조화된 의사결정 제어기로 활용될 때 일반적으로 직렬 텍스트 디코딩에 의존하는 병목 현상을 해결하기 위해, 이론적으로 입증 가능한 병렬 컴파일 방안을 제시한다. 실험은 실제 하드웨어(MetaX, H800)와 다중 데이터 분할을 기반으로 검증되었으며, 처리 속도가 뛰어나고 기술적 세부사항이 명확하여 최첨단 신뢰성 있는 AI 시스템 최적화 연구에 해당한다.

진행 상황 및 관련 보도

라이트하우스: 미국 민권운동사를 위한 최초의 신뢰할 수 있는 디지털 비서 출시

논문 arXiv:2610.30158v1은 2026년 10월 24일에 발표되었으며, 사우스캐롤라이나주 아카이브 데이터를 기반으로 미국 민권운동 시기의 역사를 탐구하는 데 특화된 최초의 디지털 어시스턴트인 Lighthouse를 소개합니다. 이 프로젝트의 핵심 혁신은 신뢰할 수 있는 콘텐츠와 사용자 피해 완화를 설계 원칙으로 삼고, 대규모 언어 모델과 규칙 기반의 기호적 해결 방식을 결합한 신경-기호 하이브리드 아키텍처를 채택한 점입니다.

Lighthouse: On Building a Trustworthy Digital Assistant for Exploring History with Civil Rights Archives

추천 이유:이 연구는 AI를 활용한 역사 탐구를 민권운동이라는 민감하고도 핵심적인 역사적 시기로 처음으로 집중시켰으며, 일반형 챗봇과 구별되는 ‘신뢰성’과 ‘피해 모델링’의 이중 제약을 명확히 제시했다. 또한 그 방법론(신경-기호 통합), 평가 방식(전문가 합의를 바탕으로 구성된 주관식 문항의 골드 스탠다드 포함) 및 데이터 규모(원본 기록 1만 8천여 건 이상) 모두 학술적 모범 사례로서의 가치를 지닌다.

진행 상황 및 관련 보도

IQuest-Q1: 에이전트형 CLI 시스템을 위한 기반 모델 역량 강화

arXiv:2610.30949v1 발표 유형: 신규 요약: 우리는 총 320B 파라미터(활성화된 파라미터는 15B)를 갖춘 희소 혼합전문가(MoE) 기반의 에이전트형 기반 모델인 IQuest-Q1을 제시합니다. IQuest-Q1은 세 단계의 프로세스를 통해 개발되었습니다: (1) 안정적이고 효율적인 사전 학습으로, 스테이블 스플릿노름, Muon 및 muP를 두 단계 커리큘럼과 결합하며, 두 번째 단계에서는 코딩 데이터 혼합 비율을 높여 안전한 학습률과 최적 학습률 간의 넓은 안정성 여유를 유지합니다; (2) 세밀한 중간 학습 단계에서는 도메인과 형식 전반에 걸쳐 데이터 혼합을 확대하고 문맥 범위를 점진적으로 확장합니다; 그리고 (3) 다중 스캐폴드와 다중 버전 사후 학습을 통해 SFT, 도메인 특화 RL, MOPD 등을 다양한 스캐폴드에서 결합하여 상호 보완적인 학습 신호를 통합하고 에이전트형 코딩 역량을 강화합니다.

IQuest-Q1: Advancing Foundation Capabilities for Agentic CLI Systems
진행 상황 및 관련 보도

CTC와 신경 전사 모델의 탐색 공간 복잡도 및 효율성을 비교하는 연구

이 논문은 2026년 10월 24일에 arXiv(번호 2610.31259v1)에 게재되었으며, 시스템은 연결형 시계열 분류(CTC)와 신경 트랜스포터 두 가지 종류의 엔드투엔드 음성인식(ASR) 모델을 대상으로, 서로 다른 가지치기 전략과 언어 모델 구성 하에서의 탐색 공간 복잡도와 추론 효율성을 비교하였다.

A Systematic Comparison of Search Space Complexity and Efficiency for Time-Synchronous End-to-End ASR Models

추천 이유:논문은 실증 분석을 바탕으로, 엔드투엔드 ASR 모델이 대부분의 시간 동안 비교적 작은 검색 공간을 유지하더라도 음성의 불확실성이 높은 구간에서는 가설 수가 현저히 급격히 증가하는 순간적인 피크가 발생함을 지적한다. 또한, 점수 기반 동적 가지치기는 모델의 불확실성에 적응하여 실시간 계수(RTF)를 크게 낮추며, 효율적인 검색을 위한 실질적인 지침을 제공한다.

진행 상황 및 관련 보도