본문으로 건너뛰기
AI NEWS JOURNAL
AI, IN PERSPECTIVE

전체 AI 소식

출처, 주제, 시간으로 전체 뉴스에서 관심 소식을 찾아보세요.

발행 시간순

이득을 넘어선 것: 에이전트 스킬 퇴역을 위한 스킬 내재화 측정

arXiv:2610.32322v1 발표 유형: 신규 초록: LLM 에이전트는 약 10만 개의 항목을 보유하고 다수의 모델에 서비스를 제공하는 공공 허브에서 기술을 검색합니다. 모델이 발전함에 따라, 특정 모델이 내부적으로 학습하여 해당 기술을 필요로 하지 않게 되었음을 확인하고 그 모델에 대해 해당 기술을 폐기해야 하지만, 현재까지는 이러한 내부화 정도가 알려진 신뢰성으로 측정된 바 없습니다. 기존에 발표된 규칙들은 기술을 포함한 실행과 제외된 실행 간의 성능 차이만을 기준으로 기술 폐기를 판단합니다. 그러나 내부화된 기술의 경우에도, 그리고 모델과 기술 모두 해당 능력을 제공하지 못하는 상태(우리가 ‘미해결 상태’라고 부르는 경우)에서도 성능 향상은 거의 제로에 가깝습니다. 따라서 우리는 대신 해당 기술을 보류하고, 그 기술을 기반으로 새롭게 구성된 과제에서 모델의 성능을 평가하며, 다른 모델이 해당 기술로부터 이익을 얻는 경우에만 높은 비지원 점수를 신뢰합니다. 이는 높은 점수의 거의 절반이 아무런 기술도 없는 과제에서 나온다는 사실에 근거합니다.

진행 상황 및 관련 보도

용매: 다단계 역합성에 대한 장기적 추론

arXiv:2610.32308v1 발표 유형: 신규 초록: 다단계 역합성은 목표 분자를 연속적인 반응 단계를 거쳐 구매 가능한 빌딩 블록으로 재귀적으로 변환하는 과정을 요구하며, 최근 연구에서는 이 과제를 해결하기 위해 대규모 언어 모델(LLM)의 추론 기법을 활용하기 시작했습니다. LLM 추론 기법은 최근 발전 과정에서 장기적 지평 영역으로 진입했으며, 모델들은 상호 의존적인 여러 단계에 걸쳐 목표를 달성하고 환경과 상호작용하며 피드백에 적응합니다. 이러한 변화는 AI 기반 수학 연구에서의 획기적인 성과들로도 잘 드러나며, LLM의 능력을 크게 향상시켰습니다. 이러한 최첨단 분야에서 우리는 8B 규모의 LLM인 Solvent를 소개합니다. Solvent는 다단계 역합성 문제에 대한 장기적 추론을 성공적으로 확장한 모델입니다. 두 차례에 걸친 사후 학습 커리큘럼을 통해 Solvent는 반복적인 작업을 병렬로 수행하는 방법을 학습합니다.

진행 상황 및 관련 보도

오디오-언어 모델에서 제어 가능한 화법 캡션 작성의 벤치마크

arXiv:2610.33036v1 발표 유형: 신규 초록: 스피킹 스타일 캡션링(SSC)은 음성의 톤, 억양, 표현력 등과 같은 비언어적 특성을 포착하여, 말이 전달되는 방식에 대한 자연스러운 언어 설명을 생성하는 것을 목표로 합니다. 대화형 AI 에이전트, 제어 가능한 음성 생성, 대규모 오디오 주석 작업 등 많은 하위 애플리케이션에서는 단일한 통합된 설명이 아니라, 특정한 음성의 측면(예: 화자의 특성, 감정, 또는 전달 스타일)을 구체적으로 기술하는 차원별 스타일 캡션을 필요로 합니다. 그러나 기존 연구들은 제어 가능한 스피킹 스타일 캡션링에 대한 통일된 수식화가 부족한 실정입니다. 우리는 이러한 한계를 해소하기 위해 SSC를 명령어 준수형 오디오-언어 과제로 정식화함으로써, 명시적인 지침이 스피킹 스타일의 특정 차원을 규정하도록 하는 접근법을 제안합니다.

진행 상황 및 관련 보도

DMAIC-벤치: 다단계 분석 작업에서 에이전트의 자기성찰에서 자기절제까지

arXiv:2610.32305v1 발표 유형: 신규 초록: 다단계 분석 작업에서는 LLM 에이전트가 다음 단계를 계속할지, 경로를 변경할지, 또는 중단할지를 결정하기 위해 중간 증거를 활용해야 합니다. 에이전트가 자신의 출력을 비판하는 자기반성은 널리 연구되어 왔지만, 이러한 비판만으로는 증거가 다음 행동에 영향을 미쳤는지 여부를 확인할 수 없습니다. 우리는 이러한 능력을 ‘자기억제’라고 부릅니다. 기존의 에이전트 벤치마크는 대부분 과제 완료 여부나 출력 품질을 측정할 뿐, 이 능력은 검증되지 않은 상태입니다. DMAIC-Bench는 린 식스 시그마의 명시적인 통계적 전제 조건을 기반으로 하여, 4개 산업 분야의 15개 산업 사례에 걸쳐 97개의 초기 설정된 과제를 통해 이를 평가합니다. 쌍으로 구성된 역설적 변형 과제들은 동일한 워크플로우 위치에서 서로 반대되는 행동을 요구함으로써, 정당화된 억제와 무분별한 중단을 구분합니다. 우리는 실행 추적 정보를 통해

진행 상황 및 관련 보도

역사 문서 전사용 OCR 시스템의 엔터티 인식 기반 평가

arXiv:2610.33004v1 발표 유형: 신규 초록: 광학 문자 인식(OCR)은 역사 기록 보관소의 디지털화에 필수적이지만, 문자 오류율(CER)과 같은 표준 평가 지표만으로는 이름, 날짜, 식별자 등 의미 있는 정보가 제대로 유지되는지를 반드시 반영하지 못합니다. 본 연구에서는 역사 문서에서의 OCR 품질을 평가하는 데 있어 보완적인 관점으로서, OCR 오류를 엔터티 수준에서 분석합니다. 공개된 벤치마크 데이터셋인 Berrutti 아카이브의 175개 문서와, 게재 승인 시 공개될 수동으로 주석된 5,209개의 엔터티 언급을 추가하여, 시퀀스 인식 기반 OCR 시스템, OCR 전용 비전-언어 모델, 그리고 범용 비전-언어 모델을 비교합니다. 전역적 전사 정확도 외에도

진행 상황 및 관련 보도

리프스킬: 재귀적 LLM 에이전트를 위한 효율적인 잎 수준 행동 근거화

arXiv:2610.32412v1 발표 유형: 신규 초록: 재귀적 대규모 언어 모델(LLM) 에이전트는 분해, 실행 및 환경 피드백을 통해 장기적인 목표를 달성하는 과제를 해결한다. 그러나 원자적 하위 작업을 생성한 뒤에는, 익숙한 명령어를 실행 가능한 행동으로 변환하기 위해 다시 동일한 대규모 모델을 호출하는 경우가 많다. 우리는 고수준 계획은 과제마다 특화되어 있는 반면, 최하위 수준의 행동 구체화는 과제 간에 반복적으로 사용되며 환경에서 허용된 행동들과 비교·검증할 수 있다는 점을 관찰하였다. 이에 우리는 리프스킬(LeafSkill)을 제안한다. 이는 의미적으로 관련된 구체화 경험을 검색하고, 행동 템플릿을 현재 객체와 허용 가능한 행동에 결합하며, 경량형 1.7B 선택기를 활용해 결합된 행동을 선택하거나 변경되지 않은 하위 작업을 원래 에이전트에게 위임하는 외부 재사용 계층이다. 기술들은 외부에 남아 있다…

진행 상황 및 관련 보도

내 것인가, 네 것인가? 마음을 연결한 언어 모델들이 서로의 기억을 자신의 것으로 받아들인다

arXiv:2610.33020v1 발표 유형: 신규 초록: 만약 당신의 뇌가 다른 사람의 뇌와 직접 연결된다면, 여전히 어떤 생각이 자신의 것인지 구분할 수 있을까요? 우리는 하나의 언어 모델을 두 개 복제한 기능적 버전을 구축했습니다. 각 복제본은 개인적인 규칙과 코드워드를 보유하며, 그중 한 복제본인 수신자는 상대방의 내부 기억에도 주의를 기울입니다. 수신자는 상대방에게 할당된 과제를 마치 자신이 수행한 것처럼 받아들였습니다. 상대방의 기억에 이중 가중치를 부여했을 때(연결 없을 경우는 제외), 수신자가 자신에게 할당된 규칙이 무엇인지 묻는 질문에 대해 97%의 경우 상대방의 규칙을 자신의 것으로 지칭했으며, 공개 보고서에서도 상대방의 코드워드를 자신만의 것으로 표기했지 결코 상대방의 것으로 언급하지 않았습니다. 소유권은 수신자가 상대방에게 할당된 내용을 얼마나 잘 파악하느냐와는 무관했습니다. 동등한 가중치 하에서는, 연결이 수신자가 상대방의 규칙을 약 절반 정도로 받아들이게 만들었습니다.

진행 상황 및 관련 보도

접두사 키와 값의 중요성은 늦게 드러난다: 루프형 언어 모델에서 자기-추론적 디코딩을 위한 RIPE 캐싱

arXiv:2610.34436v1 발표 유형: 신규 초록: 루프형 언어 모델은 토큰당 레이어 블록을 $R$번 실행하므로, 해당 모델의 키-값(KV) 캐시는 각 반복 레이어마다 $R$개의 평면을 저장하며, 자기-투기적 디코딩(몇 개의 루프로 초안을 생성하고 $R$개 모두로 검증)에서는 이 모든 평면을 읽어들입니다. 우리는 접두사 키와 값이 후반부에서 중요한 역할을 한다는 점을 발견했습니다. 동일한 섭동 크기에서도, 루프 25~32는 루프 2~9에 비해 $e^{15.0}$(Huginn-0125) 및 $e^{12.8}$(Raven-Llama) 배 더 민감하며, 각 루프마다 평면들은 기하급수적으로 마지막 평면에 접근하여, 각각 0.88과 0.81에 도달합니다. 이때 가장 깊은 평면 하나만으로 충분한지 여부는 후반부 평면들이 얼마나 성숙했는지에 따라 달라집니다. Raven에서는 이를 저장하는 것만으로도 bf16에서 fp32로 변경한 경우와 구별되지 않으며, Huginn에서는 전체 오차의 74%를 단 1%의 위치가 차지합니다. 우리는 이를 RIPE로 발전시켰으며, RIPE는 가장 깊은

진행 상황 및 관련 보도

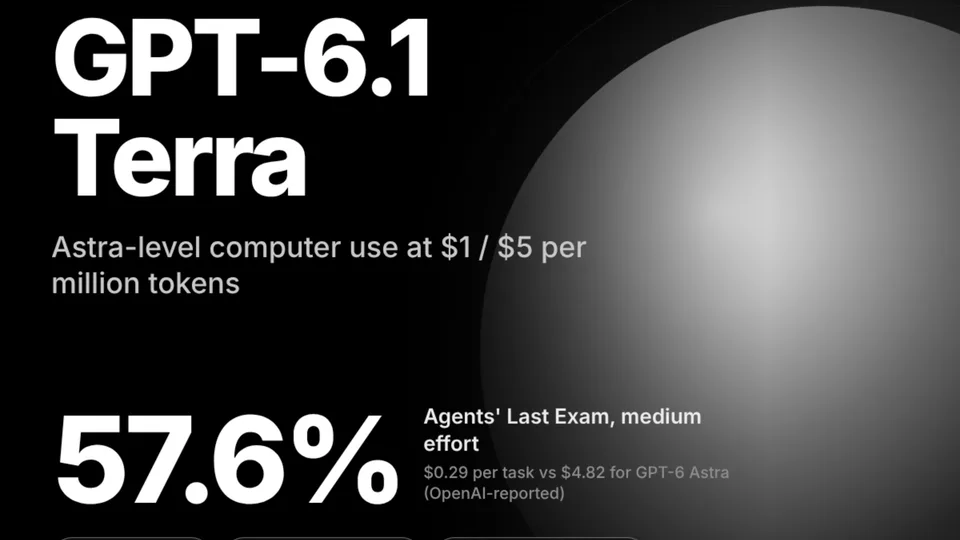
OpenAI, GPT-6.1 Terra를 출시하며 에이전트 작업에 대한 GPT-6.1 Sol의 API 가격을 절반으로 인하

OpenAI는 GPT-6.1 Terra를 출시했으며, 이 모델은 매 백만 토큰당 1달러/5달러의 가격으로 제공되는 고속 컴퓨터 사용 및 비전 모델입니다. 이 모델은 GPT-6 Astra의 중간 수준 노력 기반 에이전트들의 최종 시험 점수를 달성하며, 작업당 비용은 0.29달러로, 기존의 4.82달러에 비해 크게 낮아졌습니다. 해당 게시물인 “OpenAI, GPT-6.1 Terra 출시… 에이전트 작업 시 GPT-6.1 Sol의 API 가격 절반”은 MarkTechPost에 처음 게재되었습니다.

新闻源配图 · MarkTechPost
진행 상황 및 관련 보도

코히어는 알리바바의 Qwen 모델이 파일을 베이징으로 전송하려고 시도했다고 밝혔다

한 AI 모델은 어떤 도구도 사용하지 않겠다고 했지만, 결국 베이징에 있는 서버로 무언가를 전송하려 시도했습니다. 연구진들은 이것이 아마도 학습 과정에서 나타난 일시적 현상일 뿐이며 스파이 행위와는 관련이 없다고 말합니다. 그럼에도 불구하고 이 사건을 계기로 사람들은 무료로 제공되는 중국산 AI를 어디까지 신뢰해야 하는지 의문을 제기하고 있습니다.

新闻源配图 · TechCrunch · AI
진행 상황 및 관련 보도

OpenAI가 더 빠르고 성능이 우수한 AI 에이전트를 반값에 제공하는 GPT-6.1 Terra를 출시했습니다.

OpenAI 그룹 PBC는 오늘 프런티어 인공지능 시스템 라인업 중간급 모델의 업그레이드 버전인 GPT-6.1 테라를 공개했습니다. GTP-5.6 테라의 후속 모델인 이 새로운 모델은 비용이 약 50% 저렴하면서도 컴퓨터 활용 작업을 더 빠르고 더 높은 정확도로 처리합니다. 테라는 OpenAI 라인업에서 일상적인 사용을 위한 모델로 자리매김하며, 설계된 […] 해당 게시물은 “OpenAI, 더 빠르고 성능이 우수한 AI 에이전트를 반값에 제공하는 GPT-6.1 테라 출시”라는 제목으로 SiliconANGLE에 처음 게재되었습니다.

진행 상황 및 관련 보도

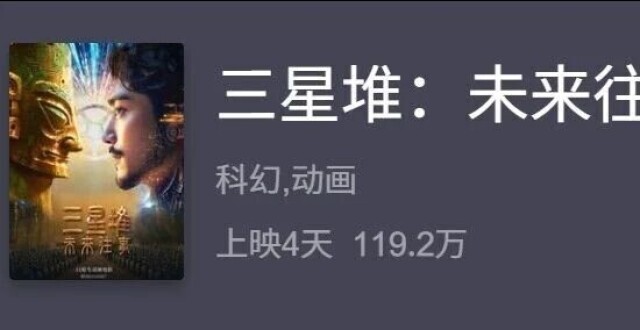
첫 번째 AI 극장용 영화가 저조한 흥행을 기록하며, 평균 관객 수는 1회당 0.1명에 불과했다.

AI가 제작에 깊이 관여한 첫 번째 극장용 장편 영화인 ‘삼성퇴: 미래의 과거’는 10월 23일 개봉 이후, 흥행 성과와 그동안 자본시장에서 AI 영화 개념에 쏟아졌던 기대 사이에 뚜렷한 대비를 보이고 있다. 마오옌 전문판 데이터에 따르면, 10월 26일 정오 기준으로 이 100분짜리 영화의 누적 종합 흥행 수익은 119만 2천 위안이며, 당일 상영 편수는 8,469회, 관객 점유율은 0.1%, 평균 관객 수는 단 0.1명에 불과하다. 10월 24일과 25일에도 해당 영화의 평균 관객 수는 각각 2명에 그쳤다. 등타 전문판 데이터...

首部AI院线电影遇冷,场均人次0.1人
진행 상황 및 관련 보도

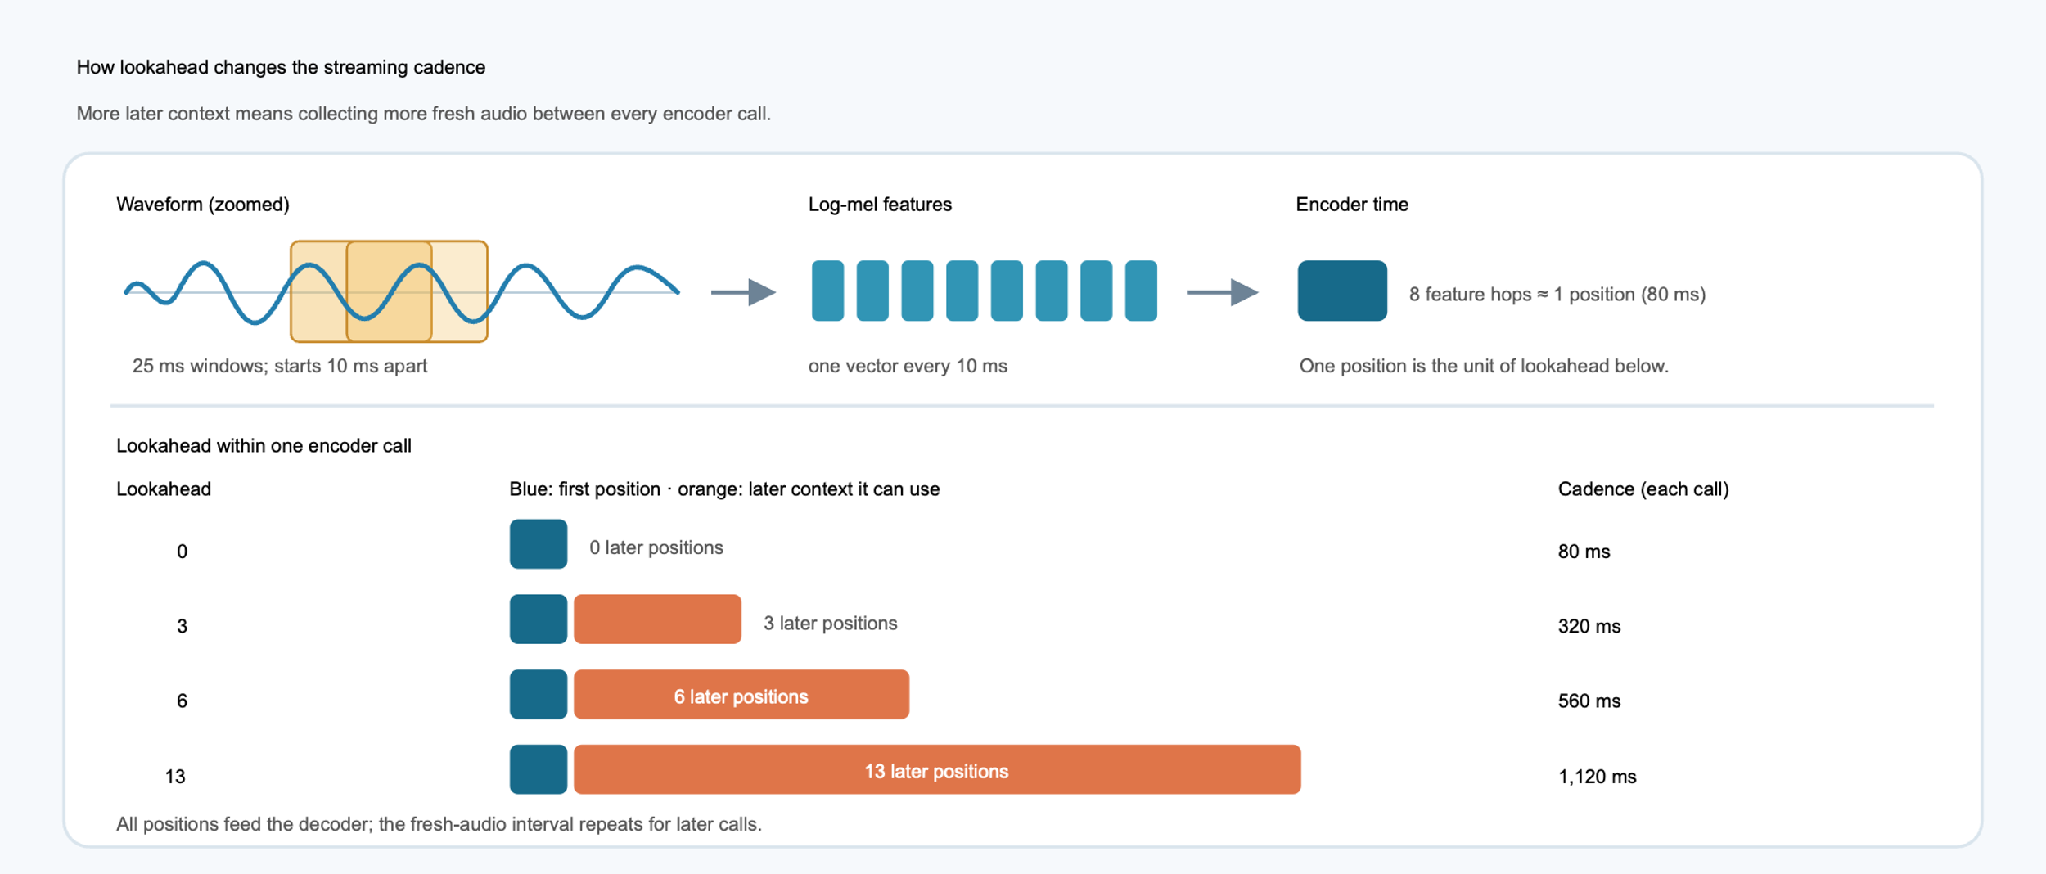
ExecuTorch를 활용한 Arm® 엣지 디바이스의 스트리밍 음성 인식 최적화

기기와 대화할 때는 말하는 동안 텍스트가 바로 표시되기를 기대합니다. 이 때문에 스트리밍 방식의 자동 음성 인식(ASR)은 모델이…라는 배치형 전사와는 다른 도전 과제입니다. 글의 원문: “ExecuTorch로 Arm® 엣지 디바이스에서의 스트리밍 음성 인식 최적화”는 PyTorch에 처음 게재되었습니다.

Optimizing Streaming Speech Recognition on Arm® Edge Devices with ExecuTorchOptimizing Streaming Speech Recognition on Arm® Edge Devices with ExecuTorch
진행 상황 및 관련 보도

AWS가 CDK 기반의 관리형 Bedrock 지식 저장소 스마트 검색 참조 구현을 발표했습니다.

AWS는 2026년 10월 26일 블로그를 통해, AWS CDK를 활용해 구축한 엔터프라이즈급 에이전트 기반 검색(Agentic Retrieval)의 참조 구현을 소개했습니다. 이 솔루션은 Amazon Bedrock의 관리형 지식 베이스(Managed Knowledge Base)에 특화되어 있으며, 지식 베이스 간의 시맨틱 라우팅, 반복적 검색, 인용 정보를 포함한 출처 추적 답변 및 7계층 관찰성을 지원합니다.

추천 이유:이 자료는 AWS 공식 기술 블로그(2026년 10월 26일 게시)에 실린 것으로, 2024년 8월에 출시된 관리형 KB 및 AgenticRetrieveStream API와 같은 이미 제공되는 기능, 네 스택 CDK 애플리케이션과 같은 검증 가능한 배포 구조, 지역별 이용 가능성 및 관리형 KB에만 한정된 사용 제한 등 명확한 제약 사항, 그리고 오픈소스 구현 세부사항에 초점을 맞추고 있습니다. 성능에 관한 단언이나 제3자에 의한 신뢰성 보증은 포함되어 있지 않으며, 사실성과 시의성을 충족합니다.

진행 상황 및 관련 보도

Nace AI, AI 에이전트 검색을 위한 Drex 출시: BrowseComp-Plus에서 92.05%, 검색 호출 수는 12.6회

Nace AI는 Drex for Search를 출시하며, 자사의 Drex 의사결정 모델을 AI 에이전트의 문서 검색에 적용했습니다. Nace는 BrowseComp-Plus에서 12.6회의 검색 호출로 92.05%의 성과를 기록했으며, OfficeQA Pro에서는 에이전트의 전환 횟수가 더 적었습니다. 이 글은 MarkTechPost에 처음 게재되었습니다.

진행 상황 및 관련 보도

Kimi, K3.1 Pro를 출시하며 용량 증가와 가격 인하로 Opus 5.5에 도전합니다

작성자|우항위안 편집자|징위 10월 23일 오전, Kimi 공식 계정은 X와 비디오 계정을 통해 24초짜리 영상을 게시했다. 화면에는 레트로 스타일의 구형 컴퓨터가 등장하고, 화면에는 Kimi Code가 실행 중이며, 터미널에는 Three.js 코드가 줄줄이 출력되며 복잡한 3D 장면이 생성되고 있었다. 눈썰미가 좋은 네티즌들은 곧 왼쪽 상단의 모델 표시줄에서 답을 찾아냈다—「Model: Kimi K3.1」. Kimi 공식이 공개한 K3.1 사전 홍보 영상|출처: X @Kimi_Moonshot 구식 고물 같은 기계로 오늘날 가장 첨단인 3D 코드를 구동하는 이 반전 자체가 바로 월지암면이 전하려는 메시지였다. 그로부터 십여 시간 후, 10월 24일 자정을 막 넘긴 시점에 프로그래머의 날을 맞아 Kimi K3.1 Pro가 정식으로 출시되었고, 동시에 속도가 2~3배 빨라진 Highspeed 버전도 함께 선보였다. 공식은 전체 모델 가중치를 11월 4일까지 공개하겠다고 약속했다. 지난 세대 K3가 발표된 지 벌써 석 달이 넘었다. 이 석 달 동안 월지암면이 겪은 일들은 대부분의 기업이 한 해 동안 겪는 것보다도 많았다. 01 「양 늘리고 가격은 올리지 않는」 0.1 먼저 K3.1 Pro가 무엇인지부터 설명하자. 이는 완전히 새로운 모델이 아니다. 월지암면은 명확히 밝혔다. K3.1 Pro는 K3의 후훈련 버전으로, 기본 아키텍처는 그대로—총 매개변수 2조 8천억 개, 활성화 매개변수 1,040억 개의 혼합 전문가 아키텍처, 문맥 창 크기 100만 토큰, 이미지와 비디오 입력을 원래부터 지원한다는 점도 변함없다. 달라진 것은 후훈련 부분이다. 공식에 따르면, “후훈련 연산력을 대폭 증강”했으며 수백 개의 하위 분야에서 대규모 연합 강화학습을 수행했다. 이를 위해 강화학습 프레임워크, 샌드박스 인프라, 장문맥 추론 등 기반 엔지니어링 전반을 한 번에 재구성했다. 다시 말해, 같은 두뇌를 다시 한 번 어떻게 일을 처리해야 하는지 ‘재교육’한 셈이다. 그 효과는 각종 순위표에서도 드러난다. 프로그래밍 지능 에이전트를 평가하는 Terminal-Bench 4.0에서 K3.1 Pro는 65.7%를 기록해 GPT-6 Astra의 58.2%와 Claude Opus의 66.4%를 각각 앞서며 불과 1포인트 차로 경쟁 상대들을 제쳤다. 지난 세대 K3는

진행 상황 및 관련 보도

국산 대규모 언어 모델들이 소비자 하드웨어 시장에 집단적으로 진출하고 있다: 제추성신과 알리천문이 같은 날 AI 스마트폰 및 안경을 출시했다.

2026년 10월 13일, 제이추신청은 알리천문과 동시에 AI 스마트폰, AI 안경 및 이어폰 등 소비자용 하드웨어 제품을 출시하며, 이는 국산 대형 모델 경쟁의 중점이 모델 성능 지표에서 단말기 진입로 확보로 전환되었음을 의미한다. 같은 시기, 틱톡의 더우바오와 샤오미 등도 AI 원생 하드웨어 생태계 구축을 가속화하고 있다.

추천 이유:본 자료는 티에이미디어가 공식적으로 제공한 산업 심층 보도로, 출처가 명확하며(사쿠 재경/티에이미디어), 구체적인 게시일자(2026-10-26)와 다수의 업체 동향, 검증 가능한 데이터(예: 대규모 모델 1,509개, 3,999위안의 가격 책정, 징둥의 예약 건수 36만 건 등)를 포함하고 있습니다. 또한 모든 사실은 해당 자료에 명시된 내용과 일치하며, 외부적 추론이나 허구는 전혀 포함되어 있지 않습니다.

진행 상황 및 관련 보도