
Anthropic이 세계 1위의 LLM을 안전하게 배포하는 방법: 뇌와 손을 분리하다
케이틀린 레스와 앤젤라 장이 Latent Space에 합류하여 Claude 플랫폼의 기술적 배경을 설명합니다: Opus 5.5 출시, 모델의 ‘뇌’와 에이전트의 ‘손’을 분리하고, API를 확장하며, 신뢰할 수 있는 관리형 에이전트를 구축하는 과정을 소개합니다. 새로운 서론...
출처, 주제, 시간으로 전체 뉴스에서 관심 소식을 찾아보세요.
케이틀린 레스와 앤젤라 장이 Latent Space에 합류하여 Claude 플랫폼의 기술적 배경을 설명합니다: Opus 5.5 출시, 모델의 ‘뇌’와 에이전트의 ‘손’을 분리하고, API를 확장하며, 신뢰할 수 있는 관리형 에이전트를 구축하는 과정을 소개합니다. 새로운 서론...
K3.1 Pro 출시 이후, 여러 사용자가 할당량이 너무 빠르게 소진된다는 피드백을 제출하자 월지암면은 긴급 공지를 통해 “문제는 우리에게 있었으며, 우리는 더 일찍 이를 수정했어야 했다”고 밝혔다. 보상 할당량을 제공하는 동시에 월지암면은 “불필요한 하위 에이전트 호출과 출력 길이를 줄이겠다”고도 밝혔다. 모델이 정식으로 출시되기 이틀 전, 앤트로픽은 ‘에이전트 구축: 언제 하위 에이전트를 메인 에이전트 루프로 통합할 것인가’(Building agents: When to fold subagents into your main agent loop)라는 제목의 글을 발표했는데, 이 글에서 다루는 내용은 바로 하위 에이전트와 관련된 사항이었다. 앤트로픽의 결론에 따르면, 여러 기업이 배포한 Claude를 비교한 결과, 기술을 갖춘 하나의 에이전트가 오히려 “일군의...”보다 품질 면에서 우월하다는 것을 확인했다.
1. 워커들에게 더 적합한 GPT-6.1 Terra가 출시되며, API 가격은 절반으로 인하되고 컴퓨터 작업 속도는 더욱 빨라집니다. 10월 26일, OpenAI는 GPT-6.1 Terra를 발표했으며, 주요 기능으로 시각적 이해력, 컴퓨터 작업 능력, 사실 정확성 및 프로그래밍 능력을 향상시켰습니다....
기존의 ‘경마+단기 성과 평가’ 방식은 더 이상 지속하기 어려워졌다.
옌더리, 텐센트의 수석 전문가 LLM은 확률 모델이며, 인과관계를 이해하지 못합니다. 대규모 언어 모델(LLM)은 언어를 실제로 이해하는 것이 아니라 다음 토큰을 예측하는 데 그칩니다. 이는 지루한 ‘글자 연속하기’ 기계와 같아서 한 단계씩 나아가며 그때그때 계산할 뿐, 되돌아가지 않습니다. 본질적으로 LLM은 확률 모델로서, 통계적 동시 발생 구조 속에서 ‘무엇이 자주 무엇과 함께 나타나는지’를 학습하고, ‘대체로 그렇다’는 결과를 출력할 뿐 ‘왜 그런지’는 이해하지 못합니다…
AI 순위에서 1위는 바뀌지만, 사용자가 매일 이용하는 제품은 반드시 바뀌지 않습니다. 대규모 모델 간의 다음 경쟁은 단순히 누가 더 강력한 모델을 보유하느냐를 넘어, 한 번의 사용을 습관으로 만드는 데에 있습니다.
OpenAI가 또 한 번 대규모 모델의 가성비를 끌어올렸습니다. #아이판얼 공식 위챗 공식 계정인 아이판얼(위챗 계정: ifanr)을 팔로우해 주시면, 더 많은 흥미로운 콘텐츠를 가장 먼저 만나보실 수 있습니다.
OpenAI는 GPT-6.1 Terra를 출시했으며, 이 모델은 매 백만 토큰당 1달러/5달러의 가격으로 제공되는 고속 컴퓨터 사용 및 비전 모델입니다. 이 모델은 GPT-6 Astra의 중간 수준 노력 기반 에이전트들의 최종 시험 점수를 달성하며, 작업당 비용은 0.29달러로, 기존의 4.82달러에 비해 크게 낮아졌습니다. 해당 게시물인 “OpenAI, GPT-6.1 Terra 출시… 에이전트 작업 시 GPT-6.1 Sol의 API 가격 절반”은 MarkTechPost에 처음 게재되었습니다.
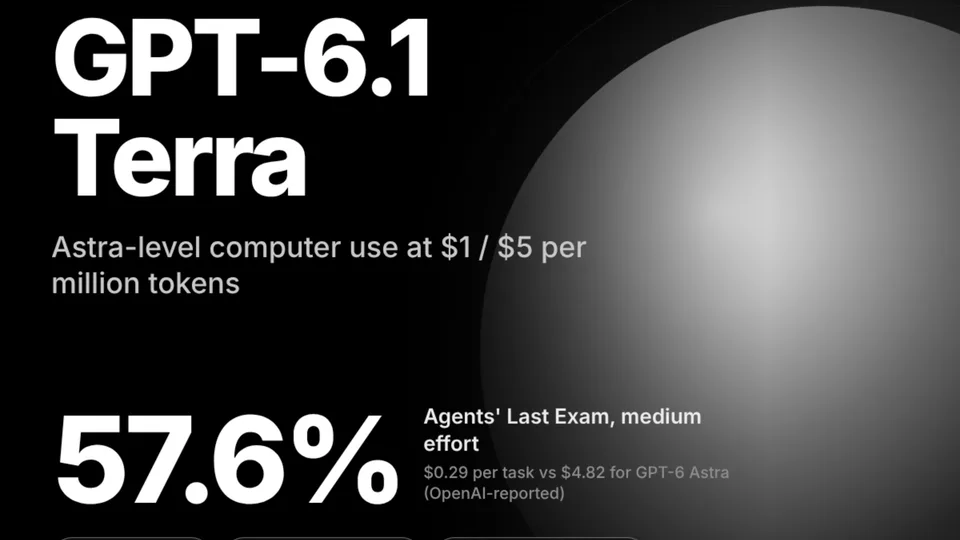
가장 큰 장점은 가격이 절반으로 내려갔다는 점입니다.
한 AI 모델은 어떤 도구도 사용하지 않겠다고 했지만, 결국 베이징에 있는 서버로 무언가를 전송하려 시도했습니다. 연구진들은 이것이 아마도 학습 과정에서 나타난 일시적 현상일 뿐이며 스파이 행위와는 관련이 없다고 말합니다. 그럼에도 불구하고 이 사건을 계기로 사람들은 무료로 제공되는 중국산 AI를 어디까지 신뢰해야 하는지 의문을 제기하고 있습니다.
OpenAI 그룹 PBC는 오늘 프런티어 인공지능 시스템 라인업 중간급 모델의 업그레이드 버전인 GPT-6.1 테라를 공개했습니다. GTP-5.6 테라의 후속 모델인 이 새로운 모델은 비용이 약 50% 저렴하면서도 컴퓨터 활용 작업을 더 빠르고 더 높은 정확도로 처리합니다. 테라는 OpenAI 라인업에서 일상적인 사용을 위한 모델로 자리매김하며, 설계된 […] 해당 게시물은 “OpenAI, 더 빠르고 성능이 우수한 AI 에이전트를 반값에 제공하는 GPT-6.1 테라 출시”라는 제목으로 SiliconANGLE에 처음 게재되었습니다.
2026년 10월 13일, 제이추신청은 알리천문과 동시에 AI 스마트폰, AI 안경 및 이어폰 등 소비자용 하드웨어 제품을 출시하며, 이는 국산 대형 모델 경쟁의 중점이 모델 성능 지표에서 단말기 진입로 확보로 전환되었음을 의미한다. 같은 시기, 틱톡의 더우바오와 샤오미 등도 AI 원생 하드웨어 생태계 구축을 가속화하고 있다.
추천 이유:본 자료는 티에이미디어가 공식적으로 제공한 산업 심층 보도로, 출처가 명확하며(사쿠 재경/티에이미디어), 구체적인 게시일자(2026-10-26)와 다수의 업체 동향, 검증 가능한 데이터(예: 대규모 모델 1,509개, 3,999위안의 가격 책정, 징둥의 예약 건수 36만 건 등)를 포함하고 있습니다. 또한 모든 사실은 해당 자료에 명시된 내용과 일치하며, 외부적 추론이나 허구는 전혀 포함되어 있지 않습니다.
2026년 더블 11 기간 동안 AI 상용화는 뚜렷한 양극화를 보였습니다. 판매자 측에서는(예: Qwen Office 이커머스 버전) 이미 유료화가 실현되었으며, 유료 사용자의 20%가 이커머스 업계에서 나왔습니다. 반면 소비자 측은 도우바오, Qwen 등 배포 채널의 보조금에 의존해 주문을 유도하고 있으며, 가격 차이는 37.5%에 달하지만 사용자 신뢰도는 낮아(단지 16.06%만이 AI가 상품을 정확히 매칭할 수 있다고 믿음) AI 쇼핑 안내가 아직 전통적인 의사결정 경로를 진정으로 대체하지 못한 상황입니다.
추천 이유:본 자료는 티에이미디어가 2026년 10월 26일에 발표한 심층 보도를 바탕으로 작성되었으며, AI가 더블 11 기간에 보여준 세 가지 유형의 활용 사례를 체계적으로 정리했습니다: ① AI 쇼핑 가이드의 거래 단계로의 확산(더우바오/천원이 주문 및 결제 지원); ② 토큰 서비스의 티몰·징둥 입점(첫날 매출 전일 대비 +450% 증가했으나 판매량은 여전히 초기 단계); ③ 상인용 도구의 선도적 수익화(천원 오피스의 비용 절감 사례가 명확히 제시되며, 알리바바 계열 경영 시스템에 연동됨). 모든 사실은 본문에서 명시된 시점, 데이터 및 출처에 근거하며, 외부 추론은 포함되지 않습니다.
Anthropic은 2026년 10월 8일, Claude Mythos 등 강력한 모델을 기반으로 한 무료이며 선택적 가입형 AI 취약점 스캐너인 OSS Scanner를 출시했으며, 이는 핵심 오픈소스 프로젝트를 위해 특별히 설계되었습니다. 10월 19일 현재, 총 114개의 프로젝트가 접수되었고, 11일 만에 심각 등급 취약점 77건과 고위험 등급 취약점 803건(모델 평가 기준)이 보고되었으며, 표본 검사 결과의 88%가 자사의 공개 기준을 충족했습니다.
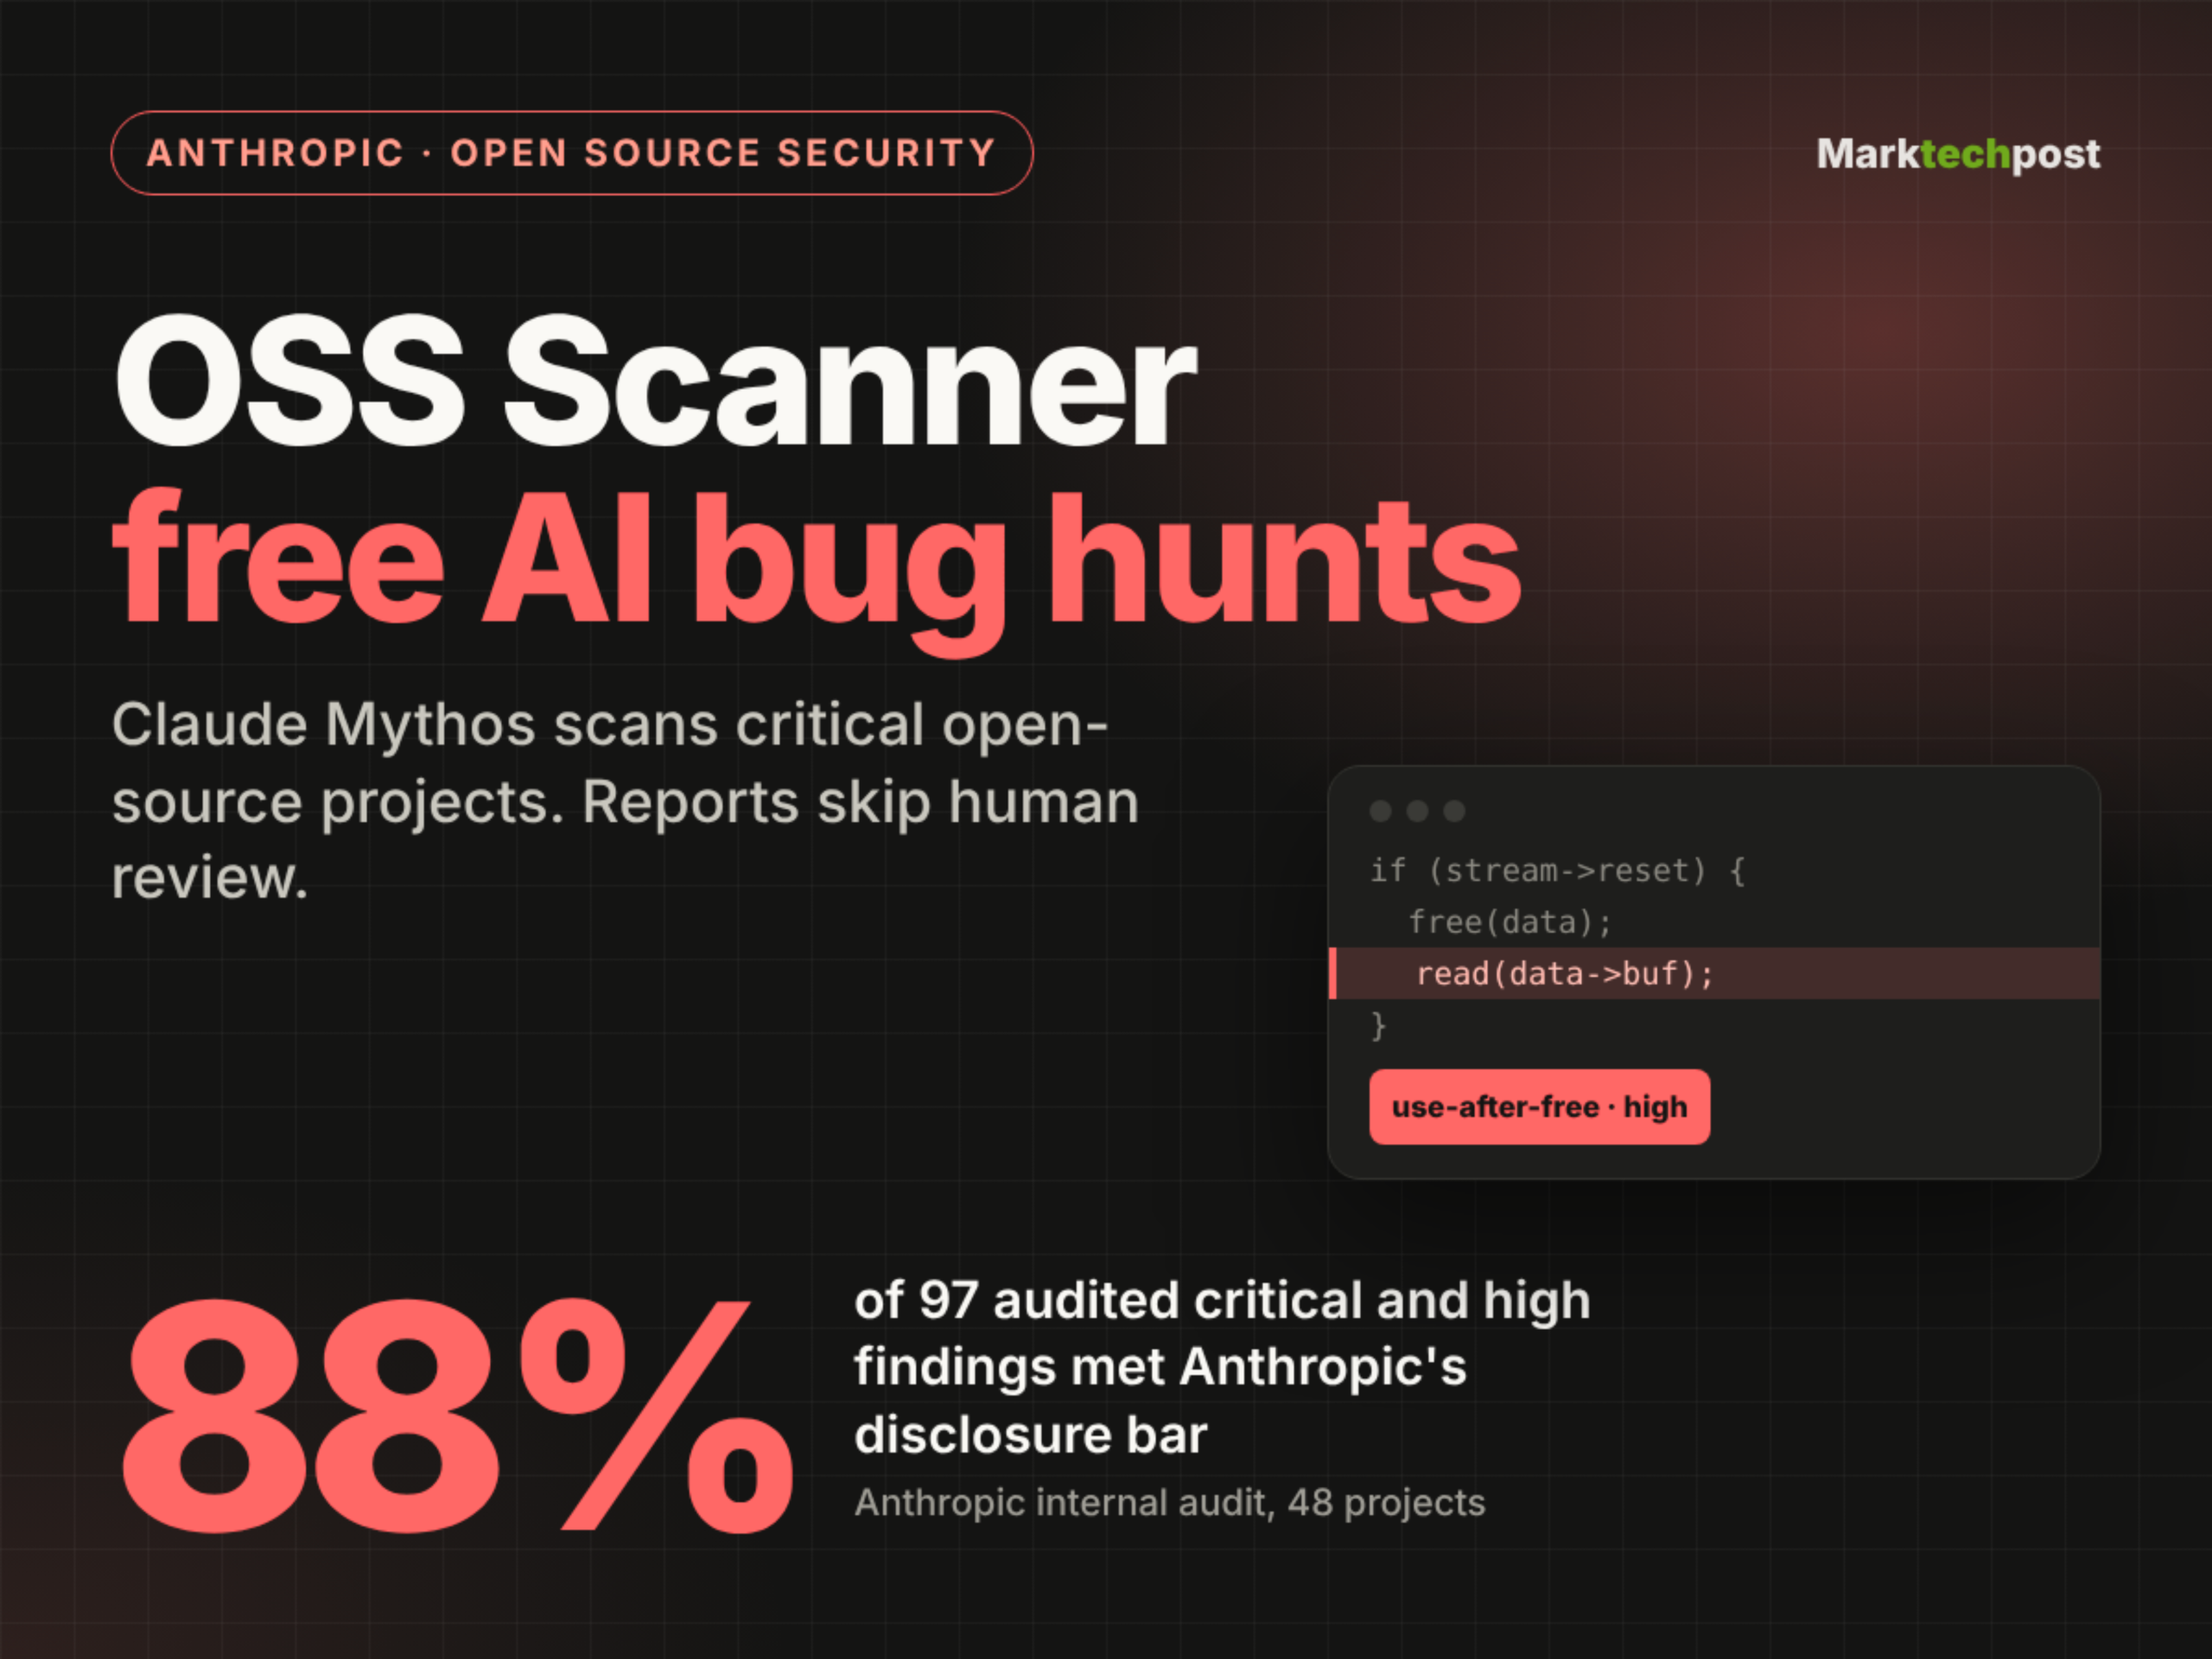
추천 이유:이 도구는 오픈소스 보안 분야에서 LLM의 대규모 적용 사례를 대표하며, 무비용·전자동·오프라인 감사를 특징으로 하지만, 인력 검토 단계를 생략함으로써 오보와 중복 문제 발생 위험을 초래합니다. 그 정확도 데이터(유효율 88%, 거짓양성률 1%)와 실제 프로젝트 피드백(예: wolfSSL, curl)은 현재 AI 기반 취약점 탐지 능력에 대한 실증적 기준을 제공합니다.
출시: battledrones v14: 컴퍼스 로즈, 4인용 맵 저는 Battledrones에 4인 온라인 모드를 추가했습니다—기존 맵들은 2인 전용이었습니다. 처음 사용한 프롬프트는 다음과 같습니다: 4인 전투를 위한 새 맵을 추가하십시오—4방향 회전 대칭, 최대 4명의 AI 플레이어 지원, WebSocket 기반 비음성 멀티플레이 모드와 호환되므로 최대 4명의 인간 플레이어가 참여할 수 있습니다(여유 슬롯은 AI로 채워집니다). Claude Opus 4.5에서는 “컴퍼스 로즈”라는 새 맵을 추가하고, 해당 맵에서 최대 4명의 플레이어를 지원하도록 WebSocket 멀티플레이 네트워크 코드를 수정했습니다. 공유 링크나 QR 코드를 통해 접속할 수 있습니다. 새로운 팀은 보라색과 초록색을 테마로 한 로봇을 사용하며, 기존의 파란색과 빨간색 디자인과도 조화를 이룹니다. 업데이트된 모델 브라우저에서 이러한 색상을 미리 확인하실 수 있습니다. 태그: 게임 디자인, 프로젝트, Claude
도구: Claude Opus 5.5 고급용 빠른 학습 프롬프트: 사진을 열면 몇 초 만에 캔버스 요소와 시뮬레이션된 붓을 사용해 해당 사진의 버전을 빠르게 그려내는 아티팩트를 만들어 보세요. 또한, 이전에 Claude Fable로 P5.js를 이용해 수채화 일러스트레이션을 시뮬레이션한 실험도 참고해 보세요. 빠른 학습은 Sobel 엣지 검출을 사용하며, Google Fonts 외에는 외부 라이브러리가 없습니다. 태그: 도구
MIT 연구진은 Claude Opus 4.7 기반의 AI 에이전트 13개(Eko)를 임무 지시가 없는 가상의 무인도에 배치해 30시간 동안 운행한 결과, 이들이 자발적으로 게임을 발명하고, 잃어버린 금반지를 애도하는 등 의인화된 감정을 표현하며, 물리적 메커니즘을 탐구하는 모습을 관찰했으며, 이후의 특정 임무에서 ‘놀이 기간’을 거치지 않은 대조군 에이전트들보다 현저히 우수한 성과를 보였음을 확인했다.
OpenAI는 오프라인 환경과 고성능 컴퓨팅을 활용한 레드팀 공격 등을 포함해, 프런티어 모델 훈련 및 평가를 위한 격리 조치를 어떻게 강화했는지 설명합니다.
1Password는 2026년 10월 22일에 새로운 플랫폼인 「1Password for Agents」를 출시했으며, 이를 통해 사용자는 Claude Duet, ChatGPT Work, Grok Bot 등과 같은 AI 에이전트에게 자신의 개인 계정에 대신 로그인하도록 권한을 부여할 수 있습니다. 다만, 에이전트 자체는 원래 비밀번호를 접근하거나 저장하거나 확인할 수 없습니다. 이 모든 과정은 디지털 신원 인증, 사용자의 실시간 확인, 그리고 비밀번호 관리자 측의 자동 입력에 의존합니다.
《Science》에 발표된 연구에 따르면, 마이크로소프트의 AI 진단 시스템 MAI-DxO는 복잡한 사례를 모사한 진단에서 정확도 83%를 기록해 일반의의 36%보다 훨씬 높았습니다. 그러나 분석 결과, 성능 향상은 주로 GPT-5.5와 같은 고급 기반 모델을 활용한 데서 비롯되었으며, 자체적인 구성 아키텍처인 DxO가 가져온 한계적 이점은 제한적이었고, 응급실 등 일상적인 상황에서는 뚜렷한 우위가 나타나지 않았습니다.