本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

推論を行う大規模言語モデルのための教師あり微調整:サーベイ

arXiv:2610.37681v1 公表タイプ:新規 要旨:近年、大規模な推論モデルは複雑なタスクの解決において顕著な能力を示しており、長文の思考過程データに対する教師あり微調整(SFT)が、その推論能力を引き出し、さらに向上させるための重要な基盤となっています。推論に特化したSFTの改善と分析の両面で急速な進展が見られるにもかかわらず、この分野には依然として、急成長する文献を統合した体系的なサーベイが存在しません。このギャップを埋めるために、私たちは推論向けSFTに関する最近の進展を包括的にレビューし、方法論的設計と分析的検討という二つの視点から文献を考察します。まず、SFTパイプライン全体にわたる方法論上の改良を概観し、それらをデータ中心のアプローチとアルゴリズム中心のアプローチに分類します。
経緯と関連報道

KORA:AIワークロード向けの決定論優先実行制御

arXiv:2610.35869v1 発表タイプ:新規 要旨:AIアプリケーションは、推論が必要かどうかを判断する前にしばしばモデルを呼び出します。このデフォルト設定は曖昧な生成タスクには有用ですが、構造化され、決定論的で、方針に基づき、照会中心、あるいは直接検証可能な作業には適していません。KORAは、決定論優先の実行制御を導入します。これは、リクエストをタスクパスとして表現し、まず決定論的または構造化された経路を試行し、その結果を検証し、テレメトリを記録した上で、決定論的な処理だけでは不十分な場合にのみモデル候補への経路へとエスカレートする、事前推論用の制御層です。本論文では、KORAを決定論優先の実行制御アーキテクチャとして提示し、再現可能なベンチマークおよび検証ワークロードによる限定的な実証結果を報告します。再

経緯と関連報道

GoogleのGenie 4が登場:一言で仮想世界を創造し、キーボード操作で自由に探索

財联社10月28日付(編集者 趙昊)Googleは、よりリアルな仮想環境をリアルタイムで生成できる新しい人工知能世界モデルを発表し、かつてゲーム会社を不安に陥れたこの技術をさらに前進させました。Google DeepMindは火曜日、公式サイトでGenie 4を公開しました。ユーザーはテキストによる指示で探索可能な仮想世界を作成でき、キーボードを使ってその中を移動することも可能です。また、シーンが展開する過程でコマンドを入力し、天候をリアルタイムで変更したり、追加したりすることもできます。

谷歌Genie 4亮相:一句话创造虚拟世界、敲键盘自由探索
経緯と関連報道

AIが認知症を抱える数百万人の生活における発見のスピードをどのように変えているか

今日、世界では5,700万人が認知症を抱えています。彼らを支援しようとする研究者たちにとって、障壁となっているのは努力不足ではなく、データが過剰であり、それを統合する専門家が不足していること、そして疾患の進行に追いつかないほどの発見のペースです。[…]における生物医学研究とAIに関するコンソーシアムは…

新闻源配图 · NVIDIA Blog
経緯と関連報道

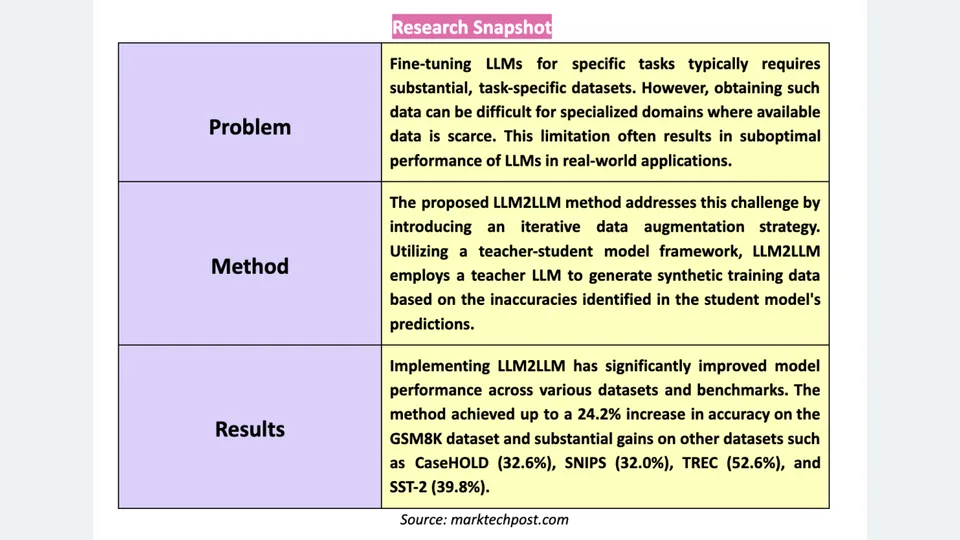
Mirendilが、1,000万トークンのコンテキストを備えた初のモデルであるFern 0.1をリリース

Mirendilは、1,000万トークンのコンテキストウィンドウでゼロから事前学習された初のモデルであるFern 0.1をリリースしました。同モデルはエージェント型AIの研究開発を対象としており、1,000万トークン規模でのRULERシングルニードルテストでは100%のスコアを獲得していますが、エージェント型コーディングにおいては最先端モデルには及ばない結果となっています。この記事「Mirendil、1,000万トークンのコンテキストを持つ初のモデルFern 0.1を公開」は、MarkTechPostに最初に掲載されました。

新闻源配图 · MarkTechPost
経緯と関連報道

シスコ・パートナーサミット:AI時代のチャネルを定義する5つの洞察

30年にわたる歴史の大部分において、シスコ・パートナー・サミットは、パートナーがシスコシステムズ社の技術をどのように販売するかに焦点を当ててきました。今年のバンクーバーでのイベントは、これまでとは異なるテーマ——すなわち、取引そのものがもはや主役でなくなった世界において、パートナーがいかにして収益を上げるか——に注目していました。シスコは、同社の株価が[…]という好調な状況下で、このイベントに臨みました。記事「シスコ・パートナー・サミット:AI時代のチャネルを規定する5つの洞察」は、最初にSiliconANGLEに掲載されました。

経緯と関連報道

ゲインを超えて:エージェントスキルの引退に向けたスキルの定着度測定

arXiv:2610.32322v1 発表タイプ:新規 要旨:LLMエージェントは、最大約10万件のエントリーを保持し、多数のモデルにサービスを提供する公開ハブからスキルを取得します。モデルが進化するにつれて、ハブは特定のモデルが既に内蔵しているスキルを見出し、そのモデルにとってそれらが不要になったことを示すためにそれらのスキルを廃止しなければなりません。しかし、内蔵の度合いはこれまで知られている信頼性で測定されていません。既存のルールでは、スキルを有する場合と無する場合の実行結果を比較し、その差分のみを基準としてスキルの廃止を判断しています。ところが、内蔵されたスキルの場合も、モデルもスキルもその能力を発揮しない状態(我々はこれを「未解明」と呼んでいます)でも、得られる効果はほぼゼロです。そこで、私たちはむしろそのスキルを保留し、それに基づいて合成されたタスクにおいてモデルを評価し、別のモデルがそのスキルによって得点を上げる場合にのみ、補助なしでの高得点を信頼することにしています。なぜなら、高得点のほぼ半数は、何らかのタスクに基づくものであり、

経緯と関連報道

クラウドにおける大規模言語モデル:アーキテクチャ、オーケストレーション、推論に関する議論

arXiv:2610.33475v1 発表タイプ:新規 要旨:クラウドデータセンターにおける基盤となる大規模言語モデル(LLM)の広範な導入は、ステートレスなディープラーニングから分散型でメモリ集約的な生成ワークロードへと、根本的なパラダイムシフトを示しています。しかし、厳しいサービスレベル目標(SLO)の下で巨大な基盤モデルを運用するには、重要な物理的およびシステム上のボトルネックが露呈します。これらの課題には、依然として克服されていない高帯域幅メモリ(HBM)の壁、計算負荷に依存するプリフィル処理とメモリ帯域幅に制約されるデコードとの間の運用上の非対称性、急増するキー・バリュー(KV)キャッシュの膨張、コスト面で非常に負担の大きいサーバーレス環境でのコールドスタート、さらにはハードウェアの信頼性に関する脆弱性などが含まれます。既存の文献レビューは依然として層ごとの分断状態にあり、低レベルのアクセラレーター仮想化とクラスター間の連携が切り離されたままです。

経緯と関連報道

溶媒:多段階逆合成における長期的視野による推論

arXiv:2610.32308v1 発表タイプ:新規 要旨:多段階の逆合成反応では、目的分子を連続する反応ステップを通じて購入可能な構成要素へと再帰的に変換する必要があります。近年の研究では、この課題に取り組むために大規模言語モデル(LLM)による推論が活用され始めています。その最新の進化において、LLMによる推論は長期的な視野の領域へと拡張されました。すなわち、モデルは相互依存的な各ステップにわたって目標を追求し、環境と相互作用しながらフィードバックに適応します。このような変化により、AI主導の数学研究における画期的な成果が示されるなど、LLMの能力は著しく向上しています。この最先端の領域において、我々はSolventを提案します。これは8B規模のLLMであり、長期的な視野での推論を多段階の逆合成反応へと効果的に拡張することに成功しました。二段階の事後訓練カリキュラムを通じて、Solventは反復的な処理を織り交ぜる能力を習得します

経緯と関連報道

PhaseBreak:不正な画像から動画へのアニメーション生成に対する先制的時間的保護

arXiv:2610.33070v1 発表タイプ:新規 要旨:画像から動画へ(I2V)の拡散モデルは、単一のポートレートや写真をアニメーション化し、被写体の許可なしに共有された画像をモーション合成に再利用可能にします。私たちは、このような用途に対する先制的な視覚的保護を検討しています。すなわち、画像が公開される前に、所有者が共有ワークフローを維持しつつ、下流のモーション生成を妨害する制限付きの摂動を加えます。既存のスペクトル破壊手法は、時間的表現を全体的に減衰させるため、微妙な動きや空間的に局在した動きに対しては十分な制御が得られません。私たちの核心的なアイデアは、生成される動態が時間的特徴の強度だけでなく、特徴イベントの発生順序にも依存することです。そこで、我々はホワイトボックス型のスペクトルリタイミング保護手法であるPhaseBreakを提案します。

経緯と関連報道

犬をどれほど信頼できるか?推論型言語モデルにおけるヒント追随の定量化

arXiv:2610.32055v1 発表タイプ:新規 要旨:大規模言語モデル(LLMs)は、客観的な事実や推論に関するタスクにおいてさえ、ユーザーの提案に合わせて回答を変更する「迎合性」をしばしば示す。しかし、この影響の定量的形態や、それが情報源の信頼性に適切に校正されているのかどうかについては、依然として十分に解明されていない。本研究では、MMLUの質問に対するヒントによる回答の変化を通じてこの行動を検証し、「[情報源]は答えが(X)だと思っている」という形式のプロンプトを評価した。さらに、ヒントの帰属先である情報源(教授、友人、あるいは犬)をQwen、Gemma、SmolLMという3つのオープンソースモデルファミリー間で系統的に変化させた。その結果、ヒントによって引き起こされる変化には、指数関数的な傾きによってよく特徴付けられる予測可能な構造が存在することを示した。すなわち、ヒントは

経緯と関連報道

SyncVid:同期ビデオ生成のための世界不変拡散モデル

arXiv:2610.31765v1 発表タイプ:新規 要旨:単一の参照ビデオから動的シーンの複数の映像を生成するには、視点間で観測された内容と未観測の内容を一貫して合成する必要があります。既存のビデオ拡散におけるカメラ制御手法は、通常、カメラ埋め込み、クロスビュー注意機構、幾何学的条件付けといったアーキテクチャ上の仕組みに依存しています。しかし、これらの手法は静的なシーンコンテンツに対しては有効であっても、視点間および時間経過において一貫性が求められる細部にわたる動的ジオメトリにはしばしば対応しきれません。我々は、各2次元画像平面で独立にサンプリングを行うのではなく、ソースビデオから導かれる標準的な3次元空間においてガウスノイズの事前分布をサンプリングし、それをターゲットとなるカメラへラスタライズすることで、拡散プロセス自体を同期させます。我々のm

SyncVid: World-Equivariant Diffusion for Synchronized Video Generation
経緯と関連報道

トレードオフ意識型テリトリーデザイン:企業向け顧客–セラー割り当てのための多目的意思決定システム

arXiv:2610.31701v1 発表タイプ:新規 要旨:企業顧客の購買体験は、製品体験やマーケティングだけでなく、繰り返し行われるリソース配分の意思決定によっても形成されます。B2Bの市場参入(GTM)組織においては、テリトリーデザインが、どのアカウントにセラーのカバレッジを提供するか、どのセラー–アカウント関係を維持するか、そして限られたフィールドキャパシティをどのように配分するかを決定します。しかし、このプロセスは多くの場合手作業で行われるため、機会の比較や価値の継続性の評価、さらには成長・バランス・キャパシティ・実現可能性といった要素間のトレードオフの検討が困難です。本稿では、企業向けGTM計画におけるトレードオフ意識型の顧客–セラー割り当てを支援する運用意思決定システムを提案します。本システムは、予測信号を統合してスコアリングを行う多次元アカウント価値層を含む三つの主要コンポーネントを組み合わせています。

Tradeoff-Aware Territory Design: A Multi-Objective Decision System for Enterprise Customer-to-Seller Allocation
経緯と関連報道

ノイズの多い検索から意思決定証拠へ:インコンテキスト学習のためのシルバーエビデンス実証

arXiv:2610.32128v1 発表タイプ:新規 要旨:RAGやリトリーバル増強型少人数ショットICLは、意思決定に重要な証拠が長くノイズの多い文脈の中に埋もれている場合、性能が低下することがあります。取得されたパッセージやデモンストレーションには、冗長な情報や注意を逸らす要素が含まれる可能性があります。専門家によってラベル付けされた開発例は、各決定を支えるテキストを特定できるものの、これらのアノテーションは通常、回答側の根拠としてのみ利用され、ノイズの多い検索結果をフィルタリングするための監督信号としては用いられていません。そこで私たちは、生の取得パッセージを生成された目標条件付き証拠要約に置き換えるシルバーエビデンス・デモンストレーションを提案します。各ラベル付き開発例について、LLMは専門家のラベルやゴールドエビデンスにアクセスせずにシルバーエビデンスを生成し、これを専門家のラベルと組み合わせます。

経緯と関連報道

NDE 4.0への道:自律型検査のためのアルゴリズム、技術、戦略の総括

arXiv:2610.31704v1 発表タイプ:新規 要旨:非破壊検査(NDI)は、損傷を生じさせることなくインフラや製造部品の安全性と信頼性を確保する上で不可欠な現代品質保証の基盤である。本論文では、現在のNDI分野を包括的にレビューし、計算アルゴリズム、物理的技術、産業応用、研究目標という四つの異なる視点から分析を行う。広範な学術文献を統合し、手動によるアナログな解釈から、NDE 4.0と呼ばれるデジタル化・データ中心のパラダイムへと急速に進化していることを示す。我々の分析は、超音波検査および目視検査が主要な物理的技術として優位性を示している一方で、重要な転換が起こっていることを明らかにする。

The Path to NDE 4.0: A Review of Algorithms, Techniques, and Strategies for Autonomous Inspection
経緯と関連報道

金融犯罪分析のための敵対的ロバスト性を備えた多グラフニューラルネットワークへ

arXiv:2610.31718v1 発表タイプ:新規 要旨:金融取引ネットワークは自然に多グラフとして表現され、同一の口座ペア間の繰り返し取引は異なる辺としてモデル化される。近年提案された多グラフニューラルネットワークのアーキテクチャは、この構造を明示的に活用することで、マネーロンダリング防止(AML)タスクにおいて高い性能を実現している。しかし、検出を回避するために取引構造を操作する敵対者に対するそのロバスト性については、依然としてほとんど研究されていない。本稿では、ノード・エッジ接続行列を用いた多グラフニューラルネットワークに対する構造攻撃および敵対的学習のための初のスケーラブルなフレームワークを提示し、このような多グラフ上で構造的な摂動を最適化するため、射影勾配降下法および射影ランダム化ブロック座標降下法を適用している。

Towards Adversarially Robust Multigraph Neural Networks for Financial Crime Analysis
経緯と関連報道

AudioLift:マルチビュー映像生成による、音声駆動型の単一画像からフルヘッドのガウスアバターへの変換

arXiv:2610.31747v1 発表タイプ:新規 要旨:既存の3D対話型アバター手法は、主に3DMMやFLAMEを含むパラメトリック顔モデルに依存しており、そのコンパクトな動作表現により、極端な表情の合成や、頭飾りなどのアクセサリーのモデリング能力が制限されています。私たちは、パラメトリック顔モデルや個々のインスタンスに対する最適化を用いずに、音声駆動型アバター生成のための中間表現として生成されたマルチビュー映像を用いる二段階フレームワーク「AudioLift」を提案します。本フレームワークは、同期されたマルチビュー映像の生成段階と、不整合に強いガウス再構成段階を組み合わせることで、単一のポートレート画像から一貫性のあるフルヘッドの幾何形状を復元します。広範な実験により、AudioLiftはより多くの表情を捉えられる3D対話型アバターを生成することが示されています。

AudioLift: Audio-Driven Single Image to Full-Head Gaussian Avatar via Multi-view Video Generation
経緯と関連報道