
本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

プレフィックスのキーと値は後から重要になる:ループ型言語モデルにおける自己推測デコード向けRIPEキャッシュ

arXiv:2610.34436v1 発表タイプ:新規 要旨:ループ型言語モデルは、各トークンに対して層のブロックを$R$回実行するため、そのキーバリューキャッシュ(KVキャッシュ)には各再帰層ごとに$R$個の平面が格納され、自己予測的デコーディング(一部のループで予備的に推論し、残りの$R$すべてで検証する手法)ではそれらすべてが読み込まれる。我々は、プレフィックスのキーとバリューが影響を及ぼすのは後半に集中していることを発見した。同程度の摂動サイズにおいて、ループ25〜32はループ2〜9に比べてそれぞれ$e^{15.0}$倍(Huginn-0125)および$e^{12.8}$倍(Raven-Llama)も敏感であり、各ループごとの平面数は0.88および0.81という比率で最終的な平面へと幾何級数的に近づいていく。そして、最も深い平面単独で十分かどうかは、後半の平面がどれほど成熟しているかに依存する。Ravenでは、それを保存するだけでbf16からfp32への変更と区別できない一方、Huginnでは、全体の誤差の74%をわずか1%の位置が占めている。これをRIPEに展開すると、最も深い…
経緯と関連報道

行動のペナルティをいつ停止すべきか?VLA強化学習におけるマルチンゲールGRPO

arXiv:2610.32431v1 発表タイプ:新規 要旨:視覚・言語・行動(VLA)のロールアウトが失敗したとしても、すべての行動が失敗に寄与したわけではない。しかし、グループ相対方策最適化(GRPO)では、ロールアウト中の全行動に対して単一の軌道レベルの優位性が割り当てられるため、本来有用な復旧試行すら、それらが修正しようとする誤りとともにペナルティを受ける可能性がある。失敗フィードバックにおける理想的な停止条件は、成功確率および方策スコアのマルチンゲールを用いて特徴付けられる。これらの停止点において、除去された勾配寄与は、保持された情報条件下で条件付き期待値がゼロとなる。したがって、切り捨てによって参照となるGRPOのグループ勾配推定器の期待値は維持され、その共分散を低減できる。このような停止の一つは、成功の条件付き確率が

経緯と関連報道

Transformer理論の検証

arXiv:2610.32104v1 発表タイプ:新規 要旨:トランスフォーマー アーキテクチャの能力と限界を特徴付けるため、複数の形式理論が提案されており、それぞれがアーキテクチャの異なる側面を捉えるために異なる抽象化手法を用いている。これらの理論は、その基礎となる仮定や概念的枠組みに違いがあるため、トランスフォーマーにとってどのタスクが容易でどのタスクが困難かという予測において一致しないことがある。本研究では、トランスフォーマーの能力に関する7つの理論(Star-free、$\mathsf{AC}^0$、$\mathsf{TC}^0$、C-RASP、MPC、BAPO、および Sensitivity)を整理し、それらの結果を、異なる計算構造を網羅する一連のタスクに対する共通の予測マトリックスへと変換した。さらに、このマトリックスを完成させるための新たな理論的成果を提示する。その後、理論的な評価を行った

経緯と関連報道

DualPace:大規模言語モデルの推論における、非同期スケジューリングとGPU–CPU協調デコード

arXiv:2610.33501v1 発表タイプ:新規 要旨:大規模言語モデル(LLM)のサービスでは、推論スループットを向上させるためにバッチ処理が用いられるが、キー値(KV)キャッシュはシーケンス長に応じて増大し、GPU上での並行処理能力を制限する要因となっている。CPUオフロードによりホストメモリを活用してKV容量を拡張することは可能だが、既存のシステムは依然として大部分がGPUに依存しており、CPU上に常駐するリクエストが進捗するのは、GPUスケジューラが適切なオーバーラップの機会を提供した場合に限られる。その結果、ホストメモリとCPU計算は独立したサービス資源として機能せず、負荷下ではCPU側の進捗が断続的になり、末端のトークン間遅延(ITL)が過剰に増大するという問題が生じる。本稿では、ホストを独立してスケジュール可能なデコードエンジンへと変える、LLM向けの実行時環境であるDualPaceを提案する。DualPaceは、スケジューリング権限を二つのエンジン間に分割し、GPUエンジン

経緯と関連報道

PhaseBreak:不正な画像から動画へのアニメーション生成に対する先制的時間的保護

arXiv:2610.33070v1 発表タイプ:新規 要旨:画像から動画へ(I2V)の拡散モデルは、単一のポートレートや写真をアニメーション化し、被写体の許可なしに共有された画像をモーション合成に再利用可能にします。私たちは、このような用途に対する先制的な視覚的保護を検討しています。すなわち、画像が公開される前に、所有者が共有ワークフローを維持しつつ、下流のモーション生成を妨害する制限付きの摂動を加えます。既存のスペクトル破壊手法は、時間的表現を全体的に減衰させるため、微妙な動きや空間的に局在した動きに対しては十分な制御が得られません。私たちの核心的なアイデアは、生成される動態が時間的特徴の強度だけでなく、特徴イベントの発生順序にも依存することです。そこで、我々はホワイトボックス型のスペクトルリタイミング保護手法であるPhaseBreakを提案します。

経緯と関連報道

OpenAIが、より高速で性能の高いAIエージェントを半額で提供するGPT-6.1 Terraを発表

OpenAIグループPBCは本日、最先端の人工知能システム群におけるミドル層モデルのアップグレード版であるGPT-6.1 Terraを発表しました。新モデルはGPT-5.6 Terraの後継にあたり、価格は約50%安くなる一方で、コンピュータ利用タスクをより高速かつ高精度に処理します。TerraはOpenAIのラインナップにおいて日常的な用途向けモデルとして位置付けられ、設計されています[…] この記事「OpenAI、より高速で性能の高いAIエージェントを半額で提供するGPT-6.1 Terraを発売」は、元々SiliconANGLEに掲載されたものです。

経緯と関連報道

企業がAIの実験段階から自律運用へと移行する際に注目すべきポイント

過去3年間、企業向け人工知能の議論は、モデルが何を言えるかに焦点を当ててきました。今後3年間は、システムに何を許容するかがテーマとなるでしょう。これは、優れたモデルだけでは解決できない、より難しい課題です。10月28日(水)、私はボストンで開催されるブルームバーグ・テック・イベント「Building the […]」に出席します。記事「企業がAIの実験から自律運用へ移行する際に注目すべきポイント」は、もともとSiliconANGLEに掲載されたものです。

経緯と関連報道

Nace AI、AIエージェント向け検索用Drexをリリース:BrowseComp-Plusで92.05%、12.6回の検索呼び出し

Nace AIは、Drex for Searchをリリースし、同社のDrex意思決定モデルをAIエージェント向けのドキュメント検索に導入しました。Naceによると、BrowseComp-Plusでは12.6回の検索呼び出しで92.05%のスコアを達成しており、OfficeQA Proではエージェントの操作回数がさらに減少しています。この記事「Nace AI、AIエージェント向けDrex for Searchをリリース:BrowseComp-Plusで12.6回の検索呼び出しで92.05%」は、MarkTechPostに最初に掲載されました。

経緯と関連報道

清華大学と香港中文大学が共同でAKVをオープンソース化:LLMエージェント向けのKVキャッシュエンジニアリングサービスシステム

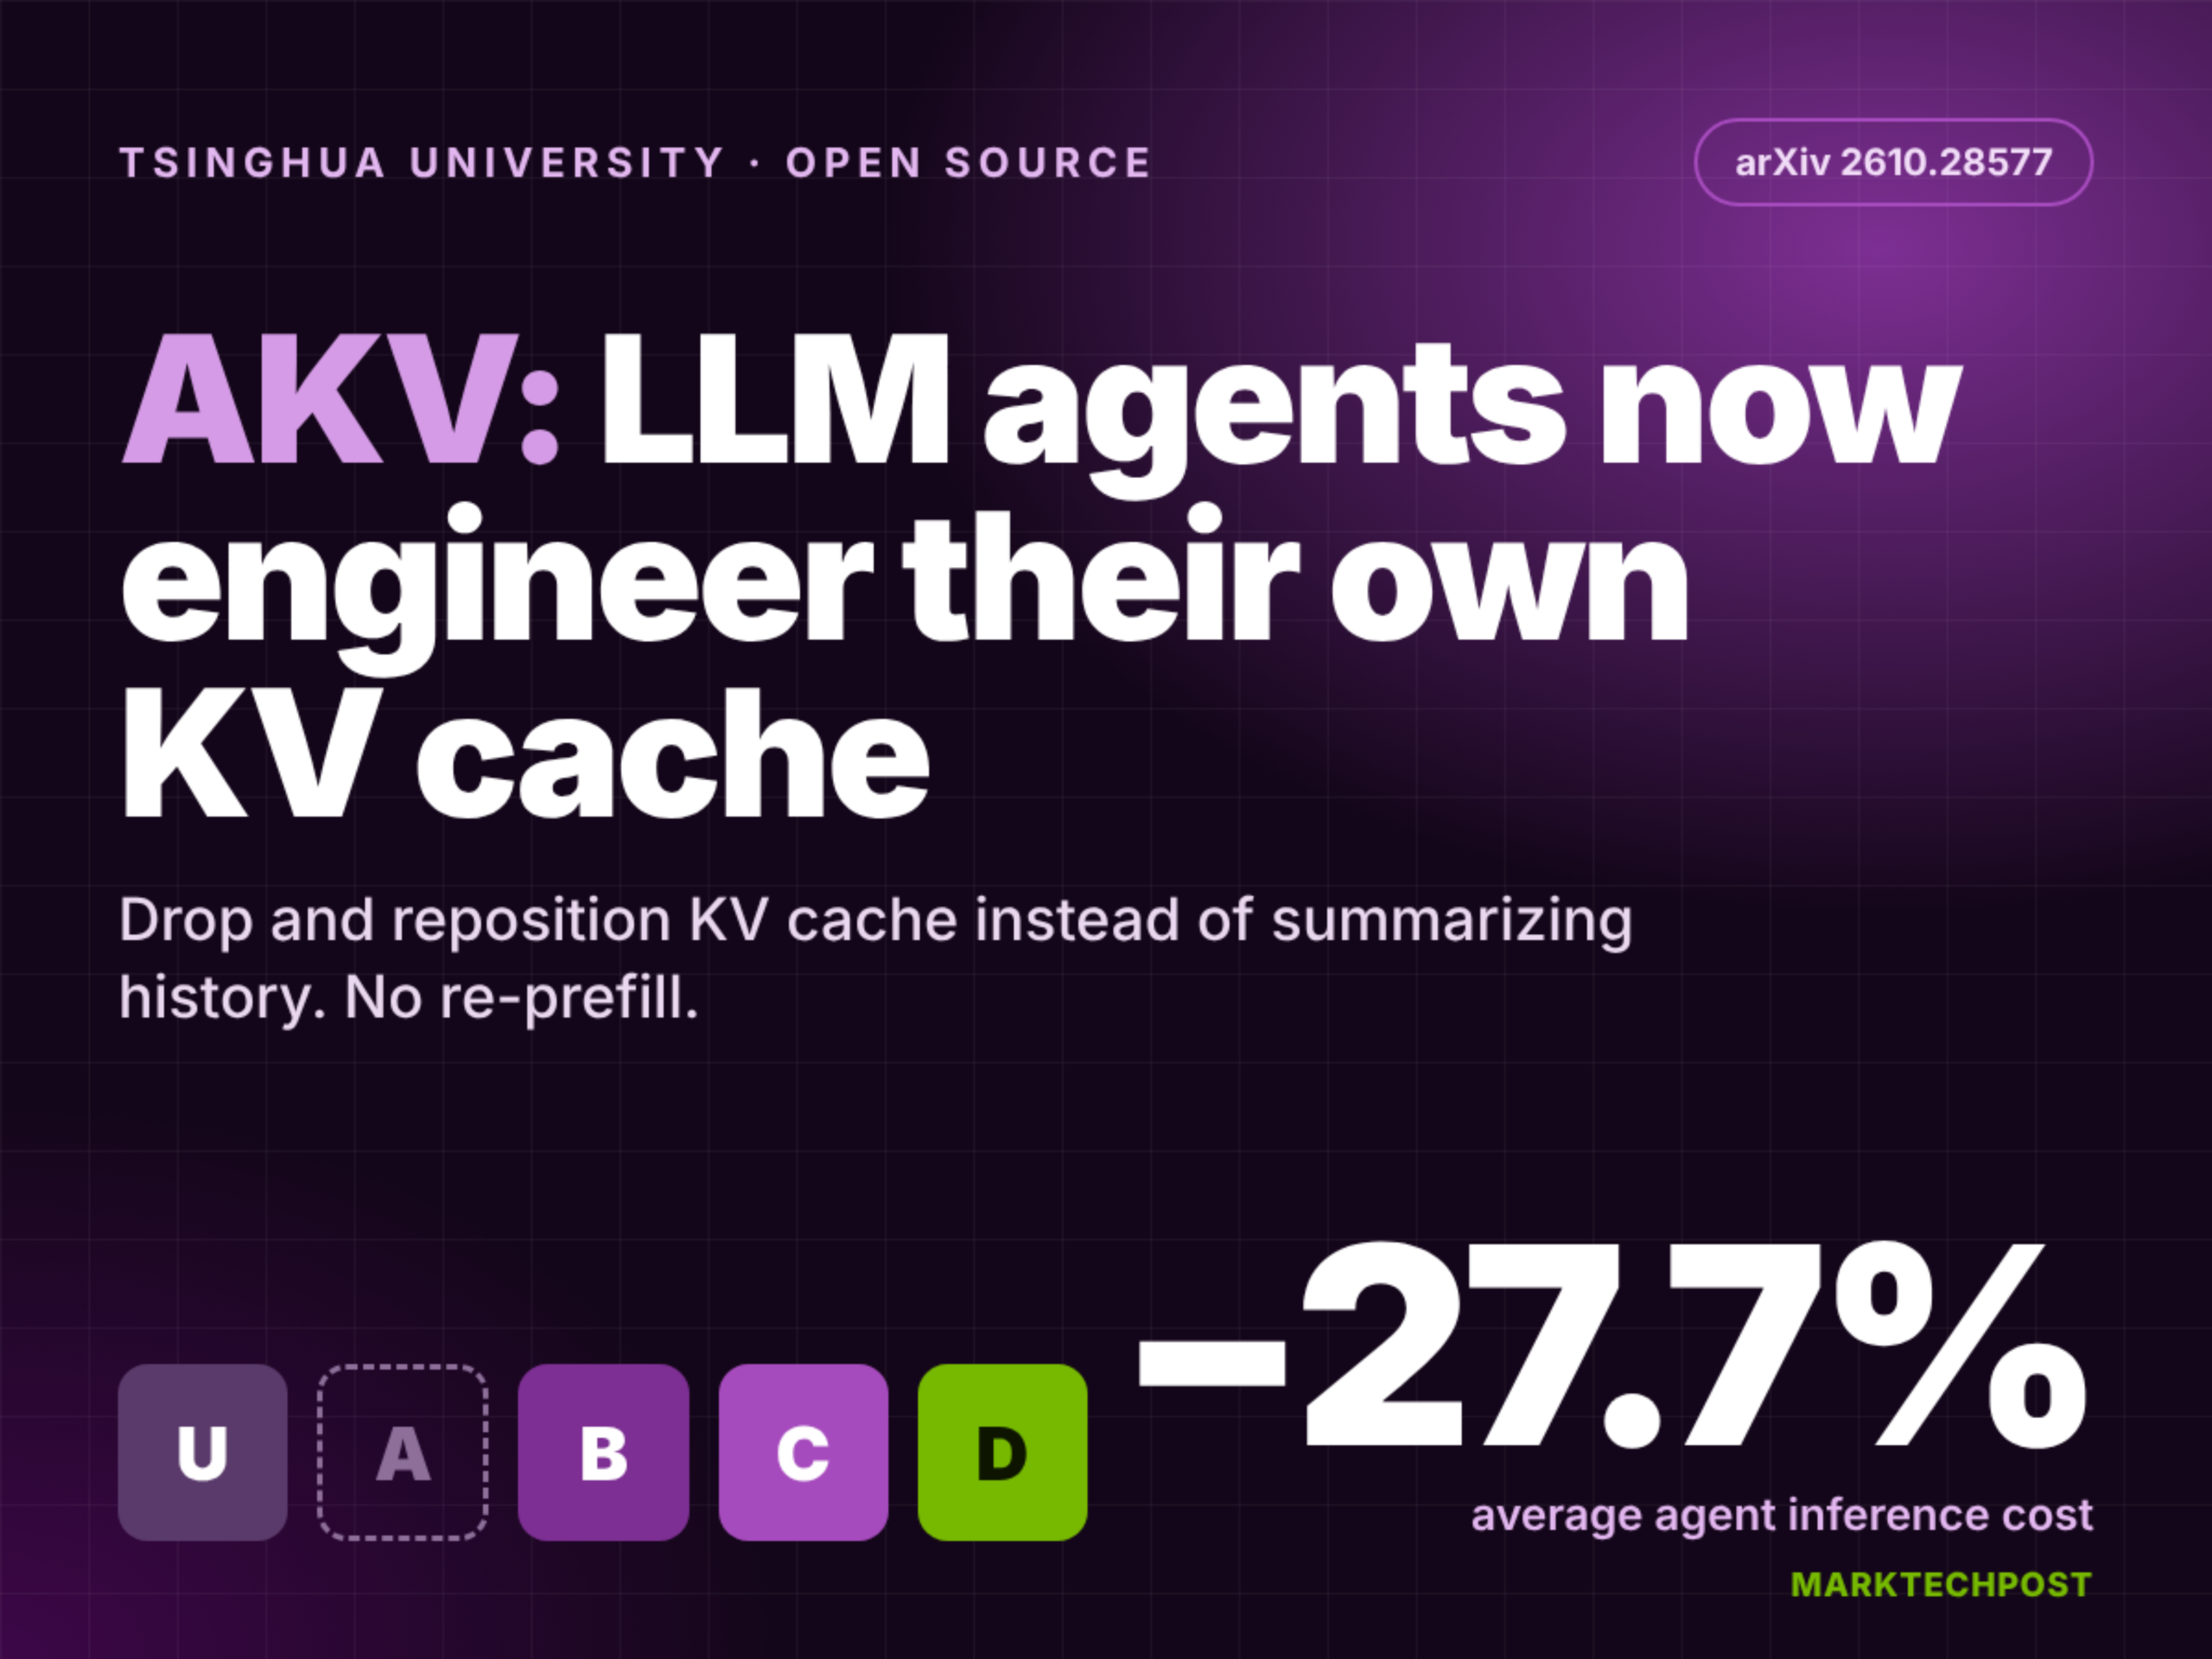
清華大学と香港中文大学の研究者らは、2026年10月26日、SGLangを基盤とし、大規模言語モデル(LLM)エージェント向けに設計されたKVキャッシュ用のエンジニアリングサーバーであるAKVをオープンソース化しました。このシステムは、従来のテキスト履歴の要約ではなく、エージェントが自らKVキャッシュを積極的に破棄・再配置することで、4つのエージェントベンチマークにおいて推論コストを平均27.7%削減し、タスクの平均スコアを1.7ポイント向上させました。コードはApache-2.0ライセンスのもとで公開されており、現在はQwen、GPT-OSS-120B、MiniMax-M2.7などのモデルをサポートしています。

Tsinghua AI Open-Sources AKV, a Cache Engineering Server for LLM Agents on SGLang

注目する理由:この成果は、LLMエージェントによる効率的な推論の新たなパラダイムを示しています。テキストの切り捨てや要約に依存する「コンテキストエンジニアリング」とは異なり、AKVはKVキャッシュ状態を直接操作することで、重複したプリフィルを回避し、長距離間の相互作用におけるKV負荷を大幅に軽減します。実測では、高並行負荷下でP95遅延が229.9秒から30.6秒へと短縮され、明確な工学的価値と再現性を備えています。情報源はMarkTechPostが公開した権威ある技術レポートであり、公開日時(2026-10-26T07:56:45Z)は現在時刻と一致しており、最新の公表進展です。

経緯と関連報道

$\Psi$-0.6:統一された視覚言語世界モデルにおける思考のストリームの適応的生成

arXiv:2610.32177v1 発表タイプ:新規 要旨:人間は、問題が進行するにつれてさまざまな推論形式を柔軟に組み合わせることで、物理的世界について推論を行う。この柔軟性を実現することは、AI分野における大きな未解決の課題である。現在の多くのシステムでは、各機能が専用のモデルごとに分離されており、それらをどのように組み合わせてタスクに共同で適応させるかという点で制限が生じている。私たちは、$\Psi$-0.6を提案する。これは、視覚と言語を統合した世界モデルであり、思考のストリームと呼ぶ共有された推論プロセスの中で、知覚、言語、幾何学、シミュレーションを適応的に組み合わせる。これらのストリームは、画像、テキスト、および幾何学や運動の明示的な表現を相互に交錯させ、すべてを共有されたトークンインターフェースを通じてモデルが生成・解釈できる。$\Psi$-0.6は、多視点空間に関するゼロショット性能において、最先端のオープンウェイトモデルを凌駕する。

経緯と関連報道

InferSlice:通信事業者の広域ネットワーク上でのSLO主導型LLM推論向けリファレンスアーキテクチャ

arXiv:2610.32638v1 発表タイプ:新規 要旨:大規模言語モデル(LLM)の推論は、企業向けおよび対話型アプリケーションの基幹サービスとしてますます導入されていますが、主権・コンプライアンス・遅延・リソースの局所性といった要件により、集中型クラウド展開の適応性が制限されることがあります。通信事業者は、これらの制約に対処するため、地理的に分散した計算およびネットワークインフラを提供しています。しかし、既存のLLMサービスフレームワークは、緊密に結合されたデータセンター向けに設計されており、地理的に分散し多様なリソースの調整には十分なサポートを提供していません。そこで私たちは、通信事業者インフラ上でサービスレベル目標(SLO)主導型のLLM推論を実現するためのリファレンスアーキテクチャであるInferSliceを提案します。本アーキテクチャは、ネットワークスライシング、GPUパーティショニング、エラスティックなサービス提供、ならびに可観測性を統合しています。

InferSlice: A Reference Architecture for SLO-driven LLM Inference over a Telco Wide-Area Network
経緯と関連報道

リアルタイムの分割制御におけるゼロショット協調のための認知的に制約されたパートナー

arXiv:2610.31726v1 発表タイプ:新規 要旨:効果的な人間と機械のチーム編成には、予測不可能な人間のパートナーと協調できるエージェントが必要である。実際の人間からのフィードバックや大規模な行動データセットを用いた強化学習はコストが高く、一方でシミュレーションのみによる訓練では人工的な慣例に過剰適合し、現実の人間とのゼロショット協調において失敗してしまう。我々は、認知的に制約されたパートナーに対してチーム編成エージェントを訓練するためのフレームワークを提案する。このフレームワークでは、報酬設計や過去の訓練チェックポイントではなく、人間の生理学的文献に基づく手続き上の制約(特に反応遅延や知覚限界)から生じる多様性を持つシミュレートされたパートナーを用いる。改良版のルナランダー環境において、これらのパートナーはより…のように振る舞うことを示す予備的な証拠を報告する。

Cognitively Constrained Partners for Zero-Shot Coordination in Real-Time Partitioned Control
経緯と関連報道

定常状態の実行プリミティブとしての移行:低軌道における仮想的静止性のためのランタイム

arXiv:2610.32720v1 発表タイプ:新規 要旨:低軌道(LEO)衛星メガコンステレーションは、遅延が極めて重要な地球中心型アプリケーション向けに軌道上のエッジコンピューティングを実現するが、衛星の運動により視線通信の窓はわずか数分間にまで圧縮される。論理的な地理的近接性を維持するため、仮想的静止性(VS)と呼ばれるパラダイムでは、アプリケーションはコンステレーション内を通過する衛星間を継続的に移動しなければならない。従来のライブ移行メカニズムは、個別に開始されたリロケーションや複製を最適化するものだが、軌道運動によって必要とされる連続的なホスト間の引き継ぎには対応していない。我々は、ライブ移行を定常状態の実行モデルとして再定式化し、新たな仮想的静止性ランタイムパラダイムを提案する。さらに、連続的な移行の実現可能性を形式的に定式化し…

Migration as a Steady-State Execution Primitive: A Runtime for Virtual Stationarity in Low-Earth Orbit
経緯と関連報道

バースト性の高いHPCワークロードに対する公平なスケジューリングを、階層的アルゴリズムによって実現するバウンディングキュー

arXiv:2610.32027v1 発表タイプ:新規 要旨:HPCクラスターは多くのプロジェクト間で共有されており、各プロジェクトにはノード時間の割り当てが与えられていますが、その公平性を確保することはますます難しくなっています。ファウンデーションモデルによるワークフローや自動化パイプラインの登場により、ジョブの提出はバースト的かつ一部の利用者に集中するようになり、少数の頻繁な利用者が引き起こすキュー待ちを、他の利用者はその長さを知ることなく受け入れざるを得なくなっています。既存のスケジューラーは、過去の使用状況を無視したり、キュー先頭のジョブのみを優先保護したり、実行中のジョブはプリエンプト可能であると仮定したりしています。そこで私たちは、HyDRAを提案します。これはハイブリッドな締め切りとランキング意識型のスケジューラーであり、すべてのユーザー間の公平性を保ちつつ、各ジョブのキュー待ち時間を制限します。HyDRAは、ジョブのサイズや所属プロジェクトの優先度に基づいて、到着時に各ジョブに締め切りを設定します。

Bounding Queue Waits for Fair Scheduling of Bursty HPC Workloads via Hierarchical Algorithms
経緯と関連報道

誰を信頼すべきかを知るだけでは不十分:反復的多者間LLM交渉における信頼―合意のギャップ

arXiv:2610.31971v1 発表種別:新規 要旨:大規模言語モデル(LLM)エージェントは、個人や組織に代わって交渉に参加する機会が増加している一方で、特に反復的な多者間のやり取りにおいては、依然として操作のリスクにさらされています。従来のマルチエージェントシステムは、明示的な信頼および評判モデルによってこの課題に対処してきましたが、既存のLLMによる交渉に関する研究では、信頼をむしろ創発的な現象として扱うものが主流です。本研究では、過去の相互作用から有用な信頼評価を形成し、それを活用して将来の交渉結果を改善できるかどうかを検証します。さらに、繰り返し参加するエージェントが一連の交渉ゲームに携わる中で、一方の参加者が密かに合意成立を妨害しようとする、反復的かつ多者間・多問題型の交渉フレームワークを提案します。

Knowing Whom to Trust is not Enough: The Trust--Agreement Gap in Repeated Multi-Party LLM Negotiation
経緯と関連報道