本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

LangChainが「企業向けエージェントフレームワーク」の5つの主要コンポーネントを発表

LangChainは2026年10月25日にブログを公開し、マーケティング、セールス、エンジニアリングの各チーム内でAIエージェント(GTM Agent、OpenSWE、Content Studio)を導入する際に蓄積された、以下の5つの一般的なアーキテクチャ原則を体系的に説明しました。すなわち、ネイティブな統合ワーク環境(Slack)、動的なアイデンティティモデル(OBO+固定資格情報)、二層メモリ機構(グローバル/ユーザー単位)、サンドボックス化されたコード実行、そして高い割合でのスケジュール実行(手動トリガーではない)です。すべてのエージェントはManaged Deep Agentsプラットフォームに基づいて構築されています。

注目する理由:この情報はLangChainの公式ブログから引用したもので、公開日時(2026-10-25T18:06:32.000Z)は現在のシステム時刻(2026-10-25T23:01:18.857Z)より前であり、内容はすでに実装された社内用インテリジェントエージェントの実践事例に焦点を当てています。詳細も具体的で(Slackのスレッド分離、GitHubアカウントの所有権帰属ロジック、NotionやTwitterの権限階層など)、未検証の予測や外部からの主張は含まれておらず、時宜性と事実性の要件を満たしています。

経緯と関連報道

スタンフォード大学とカリフォルニア大学バークレー校の研究者らがTokenGateを発表:トークンゲート型アテンションにより、長文コンテキストのプリフィル処理が最大11.3倍高速化

スタンフォード大学とカリフォルニア大学バークレー校の研究者らは、既存の大規模言語モデル(LLM)に適用可能なプラグアンドプレイ型の学習ベースのトークン剪枝モジュール「TokenGate」を提案しました。この手法は、精度を損なうことなく、長文コンテキストに対する初期文字生成時間(TTFT)を1.4倍から11.3倍に加速し、ピークメモリ使用量を1.5倍から3.4倍削減します。関連コードおよびチェックポイントはオープンソースとして公開されています。

Researchers from Stanford and UC Berkeley Introduce TokenGate: Token-Gated Attention Makes Long-Context Prefill Up to 11.3x Faster
経緯と関連報道

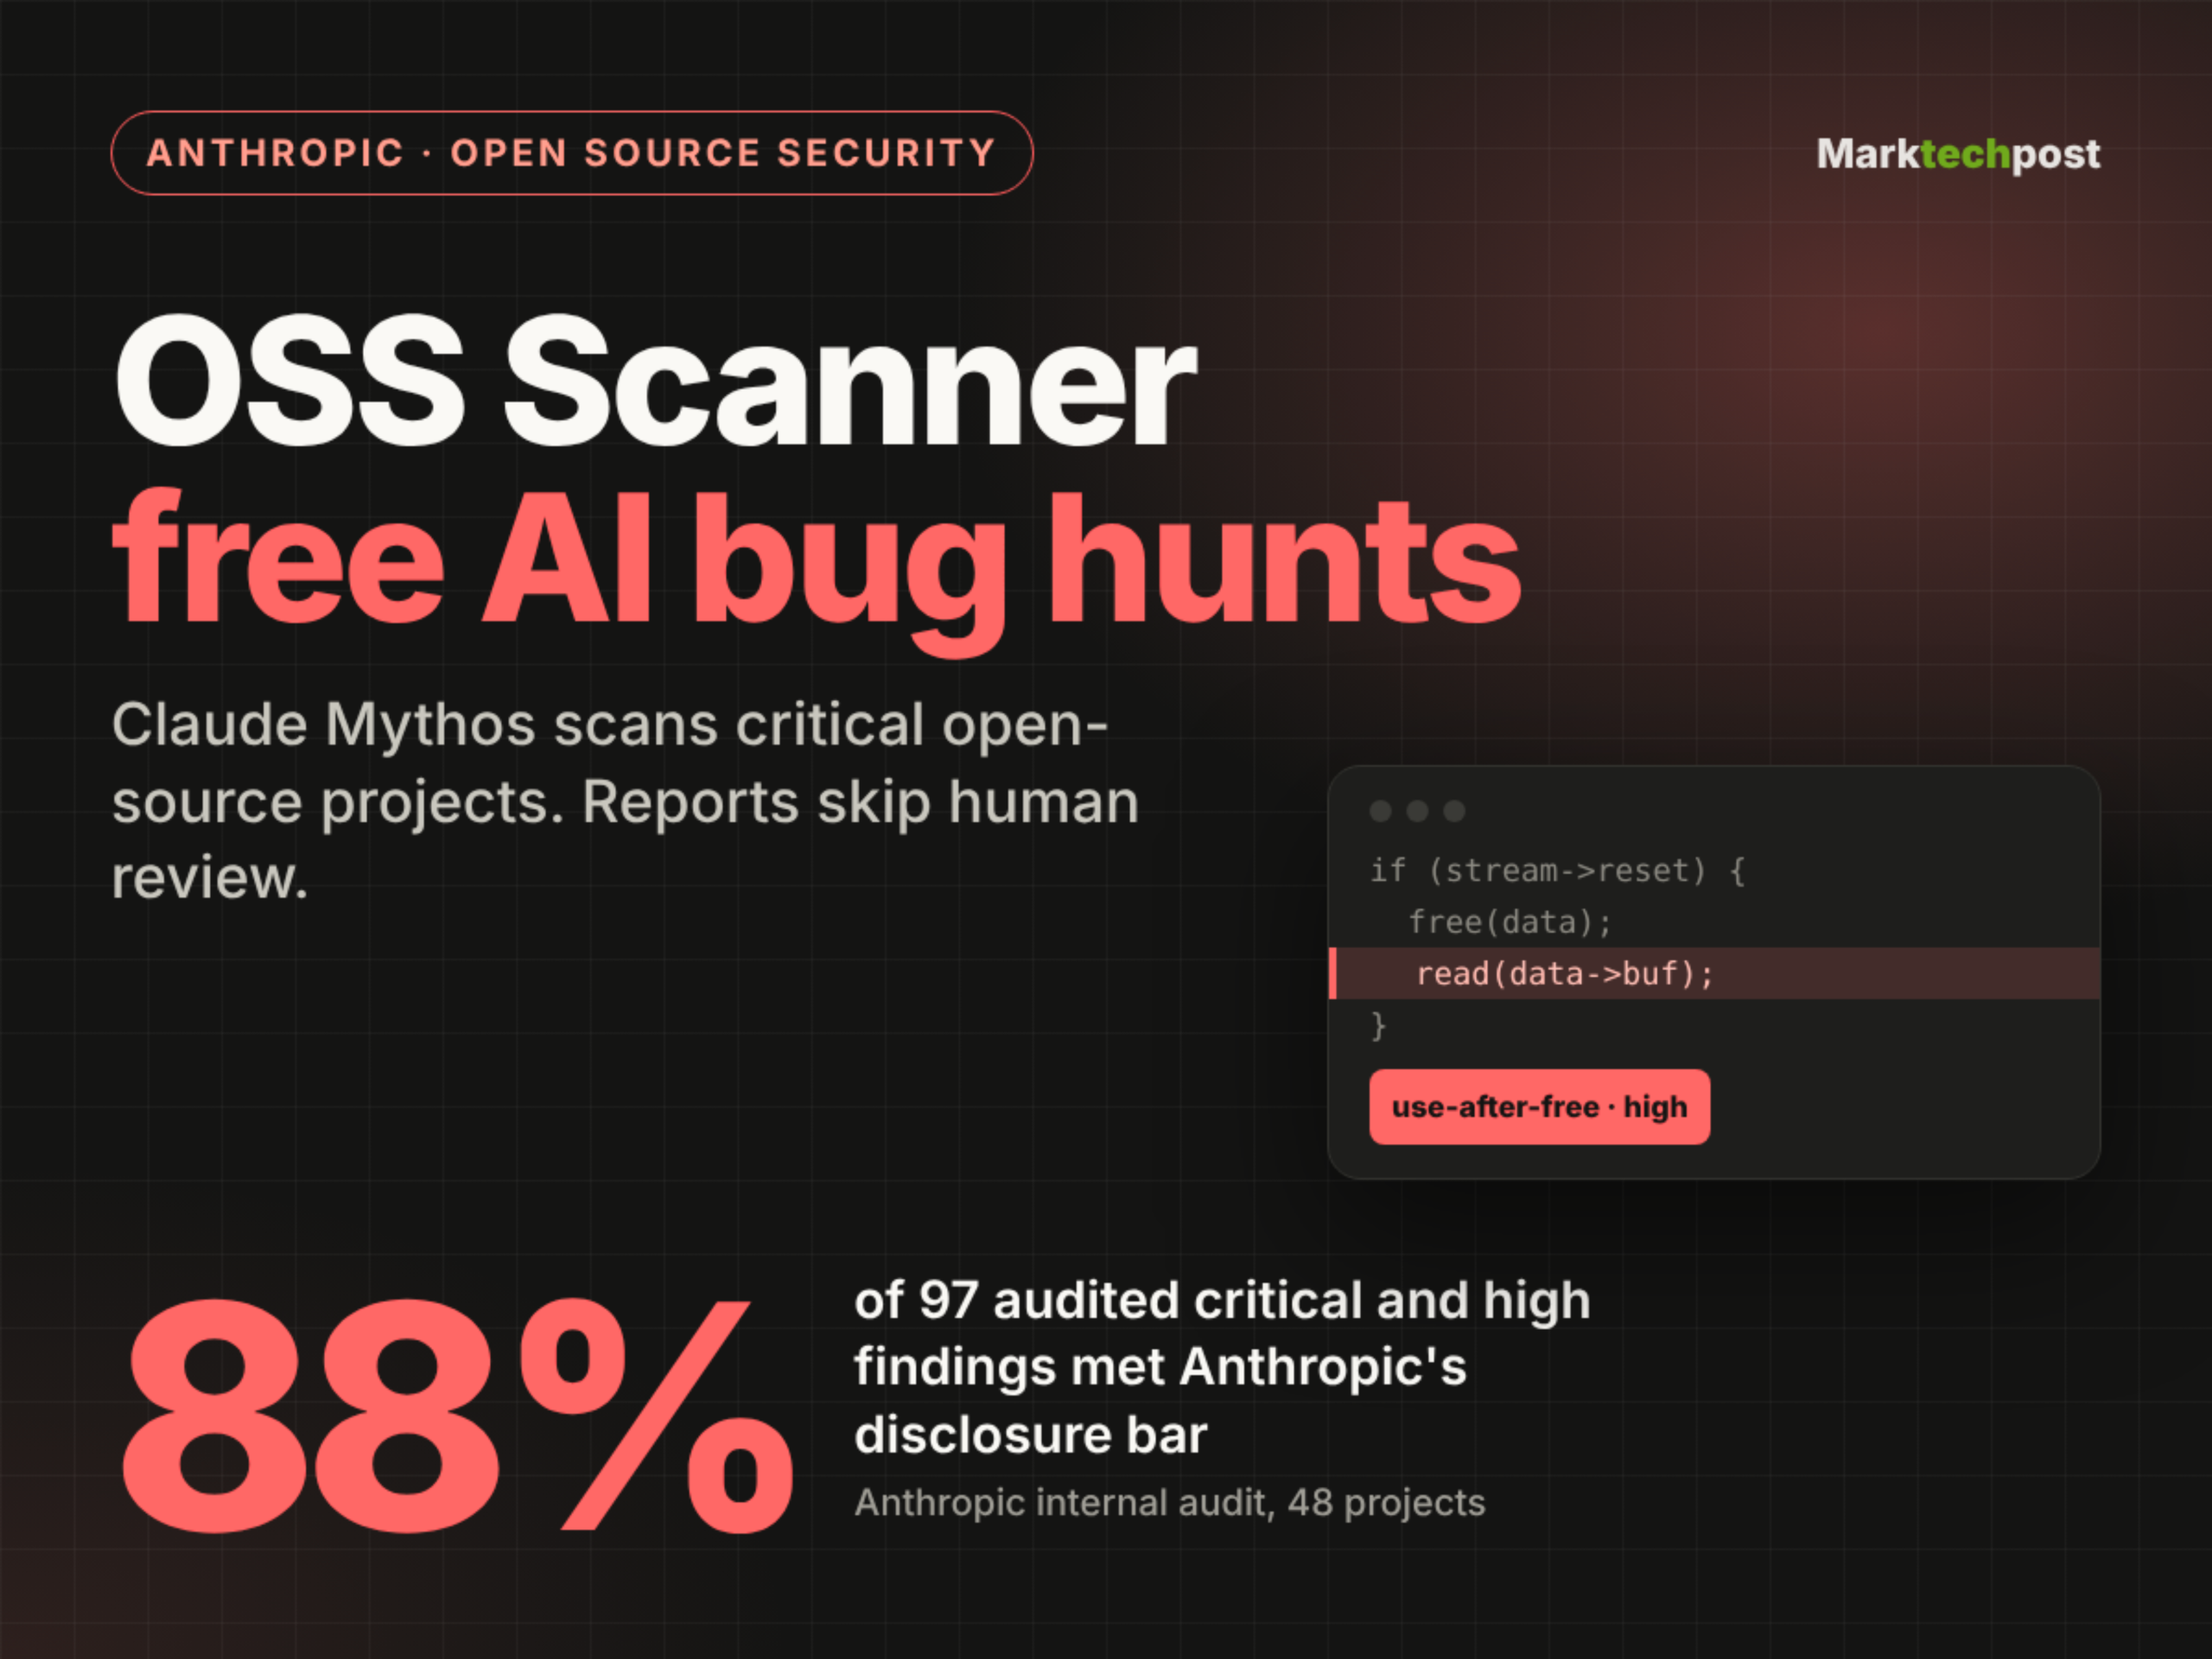
Anthropicが、主要なオープンソースプロジェクト向けの無料AI脆弱性スキャナー「OSS Scanner」を発表しました

Anthropicは2026年10月8日、Claude Mythosなどの強力なモデルを基にした無料でオプトイン型のAI脆弱性スキャンツール「OSS Scanner」をリリースし、重要なオープンソースプロジェクト向けに設計しました。10月19日時点で、114のプロジェクトが受け入れられ、11日間で深刻度レベル77件および高リスクレベル803件の脆弱性(モデルによる評価)が報告され、サンプリングされた監査結果の88%が同社の開示基準に適合していることが確認されました。

Anthropic Launches OSS Scanner, a Free AI Vulnerability Scanner

注目する理由:このツールは、オープンソースセキュリティ分野におけるLLMの大規模な実装事例を示しており、無償・完全自動・オフラインでの監査を特徴としています。ただし、人手によるレビュー工程を省略することで、誤検知や重複する問題が生じるリスクも伴います。その精度データ(有効率88%、偽陽性率1%)および実際のプロジェクトからのフィードバック(wolfSSLやcurlなど)は、現在のAI主導型脆弱性発見能力に関する実証的なベンチマークを提供しています。

経緯と関連報道

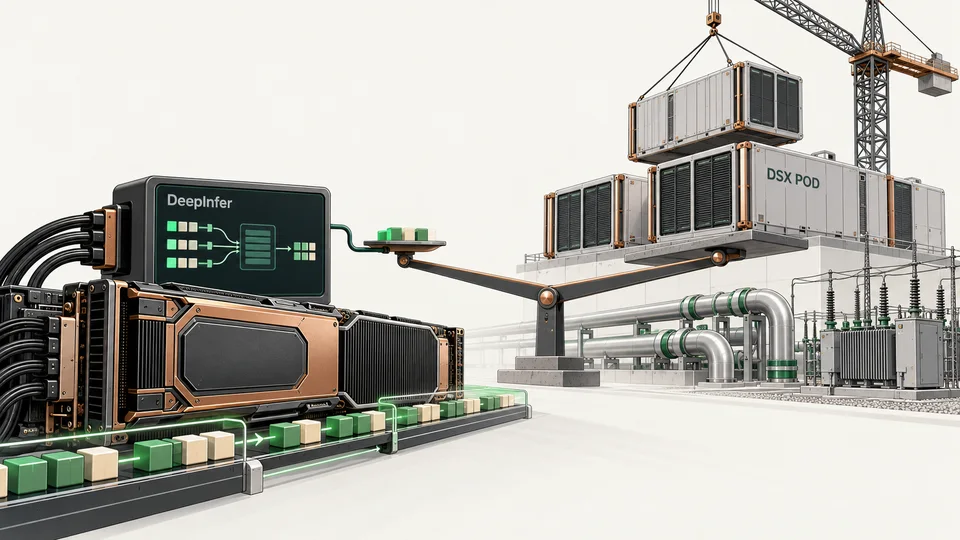
低価格のスマートさと高価な野心:DeepInfer、DSX POD、そしてAIへの投資拡大

第958号『The Sequence Radar』では、推論ソフトウェア、モジュール型AI工場、そして企業向けAIへの投資を一堂に集めて考察しています。単回の推論コストが安くなったからといって、業界全体の総投資額が必ずしも低下するわけではありません。本稿は元記事をそのまま整理し、DeepSeekおよびNVIDIAの公式資料を用いて技術範囲と納品条件を補足しました。

推理软件效率与模块化AI基础设施投入的编辑示意,非实际产品照片
経緯と関連報道

KimiがK3.1 Proを発表:エンドポイントタスク能力がトップに躍進、シミュレーションによるデバッグとマルチモーダルプログラミングにより具現知能の原型を示す

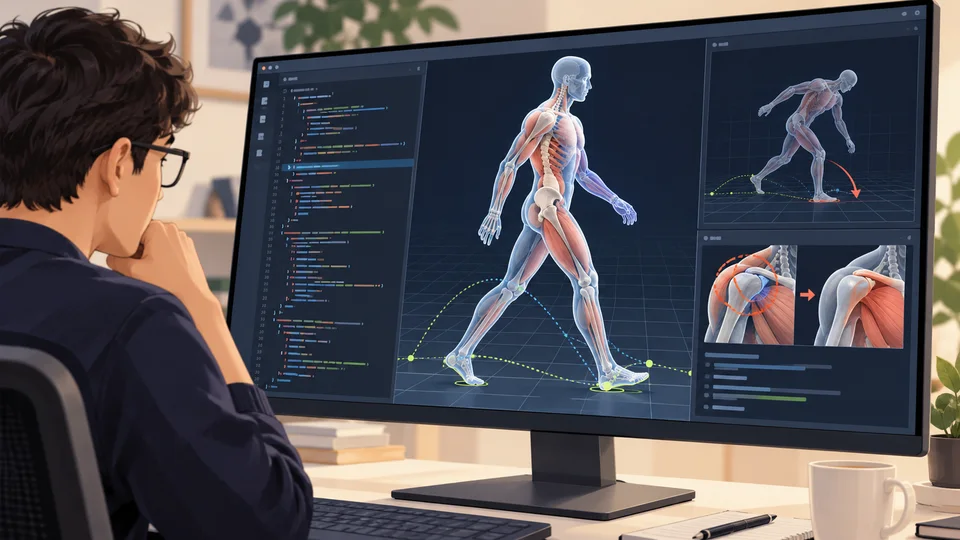
Kimiは2026年10月25日にK3.1 Proモデルを発表し、Terminal-Bench 4.0のタスクテストにおいて成功率67.2%で首位に立った。また、エミュレーターのバグを自律的に修正し、物理シミュレーション、音声解析、3Dシーン構築、動画編集といった多様なタスクをこなす能力を備えており、身体拡張型知能技術の道筋を探る方向性を示している。

根据报道中的虚拟人行走训练和模拟器调试制作的编辑示意,非软件实拍截图

注目する理由:本資料は、钛媒体が許諾して公開した実測レポートに基づいており、Artificial Analysis、Terminal-Bench 4.0 などの権威ある第三者評価データ、公式による自主テスト結果、ならびに著者による多様なシーンにおける機能検証を網羅しています。K3.1 Pro の実行性能、シミュレーションのクローズドループ、マルチモーダルプログラミングにおける実質的な進歩に焦点を当てるとともに、性能上の限界や未公表の情報(例:Flash/Ultra はまだリリースされていない)についても明示しており、事実確認および出典表示の要件に準拠しています。

経緯と関連報道

インフィニオンとWolfspeedが契約を更新:200mmシリコンカーバイドウェハの供給契約が成立

インフィニオンとWolfspeedは2026年10月15日、炭化ケイ素ウェハの供給契約を拡大・延長すると発表し、協力を150mmから200mm規格へと拡張する。これにより、インフィニオンの200mm製造への移行を支援し、サプライチェーンの弾力性を強化する。一方、Wolfspeedはこの取り組みを通じて、主要顧客における200mm材料の長期的な活用を拡大するが、同社の材料事業は依然として売上高の減少とマイナスの粗利益率という圧力に直面している。

英飞凌续约Wolfspeed:200mm碳化硅的“下一关”英飞凌续约Wolfspeed:200mm碳化硅的“下一关”

注目する理由:この事件は、世界的な炭化ケイ素産業における競争の重心が正式に大サイズ基板および製造工程へと移行したことを示しており、サプライチェーンの上流・下流が協調して200mmウェーハの量産を推進するための重要なシグナルである。材料の出所は明確であり(ティーメディア、2026年10月25日掲載)、すべての事実は原文に記載された時間・主体・データおよび制約条件に厳密に照らし合わせており、推論や補完、拡張は一切行っていない。

経緯と関連報道

パネルメーカー各社は、AIによる上流コストの圧迫に対応するため一斉に価格を引き上げているが、下流の受け入れ度は低く、端末製品の品質管理にも圧力がかかっている

2026年9月以降、TCL華星、京東方、惠科などのパネルメーカーが相次いで値上げ通知を発表しています。その主な要因は、AI大規模モデルの発展に伴うHBM需要の急増により、成熟プロセス向け半導体の生産キャパシティが逼迫し、ドライバIC、PCB、ガラス基板など主要部材の価格が上昇していることです。同時に、コーニングをはじめとする上流サプライヤーも一斉に価格を引き上げています。コスト面での圧力は明確ですが、下流のテレビ/ディスプレイブランドによる調達価格は広く値上がりしておらず、端末ユーザーからは過熱やブラックスポットといった品質管理上の問題が頻発しているとの不満が寄せられています。そのため、値上げはまだ実際の取引価格の上昇や体験の向上には反映されていません。

AI大模型狂飙,面板行业也扛不住了

注目する理由:材料システムは、AI産業が直接的な関連性のないハードウェア業界に及ぼすクロスチェーンによる伝播メカニズムを明らかにした——AIによるパネル需要の押し上げではなく、ウェハ生産能力の再配分を通じて全チェーンにわたるコストの再設定が引き起こされているのだ。同時に、価格上昇の動きと市場の実際の反応(価格の硬直化、出荷の減少、ユーザーからの苦情)との間に顕著な乖離が存在することも示しており、産業における交渉力と製品力の不一致という深い矛盾を浮き彫りにしている。

経緯と関連報道

米国のデータセンター反対運動が参考にできる世界的な経験:アイルランドの電力網危機からニュージーランドの地域コミュニティにおけるAI活用事例まで

パリス・マークスは『超大規模』において、世界のデータセンターをめぐる抗争の歴史を整理し、アイルランドでは送電網の容量が飽和したため規制が導入され、企業が代わりに自家用のガス火力発電所を建設する事例を指摘している。一方、ニュージーランドでは、地元クラウドを活用してマオリ語の音声認識を支援する、搾取的でないAIの道筋が模索されている。さらに、現在米国で広がっている反対の波は、実は以前から予兆されていた世界的な矛盾の再現にすぎない。

経緯と関連報道

Open WebUI v0.12.4がリリース:必要に応じたスキルのロード、コンテキスト圧縮の可視化、および数百項目に及ぶアクセシビリティ改善とバグ修正

Open WebUI v0.12.4 は、オープンソースの大規模言語モデル向けフロントエンドインターフェースの重要なメンテナンスリリースであり、信頼できるメタデータ日付である2026年10月25日以前に公開されました。主要な更新内容には、必要に応じたスキルのロード(組み込みのSkillsツールを有効にする必要があり、デフォルトでは無効)や、チャット中のコンテキスト圧縮プロセスの明示的なマーク付け、WCAG基準を100項目以上上回るアクセシビリティ強化に加え、GitHubのプルリクエスト/イシューで検証された26件の機能修正および動作改善が含まれます。これには、権限管理の強化やSafari/RTL/複数フォルダーなどの各シナリオにおける不具合の修正も含まれます。なお、新しいモデル、API、または第三者サービスは導入されておらず、パフォーマンスベンチマーク、ユーザーデータ、規制関連情報なども一切含まれていません。

経緯と関連報道

llama.cpp がバージョン b11871 をリリース:サービスのクラッシュを防ぐため、JSON のネスト深度に制限を追加

llama.cpp のバージョン b11871 では、重要なセキュリティ修正が導入され、リクエスト内の JSON のネスト階層に対して 128 層のハード制限を設けることで、深い再帰的解析による HTTP スレッドスタックのオーバーフローおよびサービスのクラッシュ(macOS では SIGBUS、Linux では SIGSEGV をトリガー)を防止しています。この対策は、chat インターフェースの複数の入力シナリオに適用され、統一的に HTTP 400 エラーを返します。

経緯と関連報道

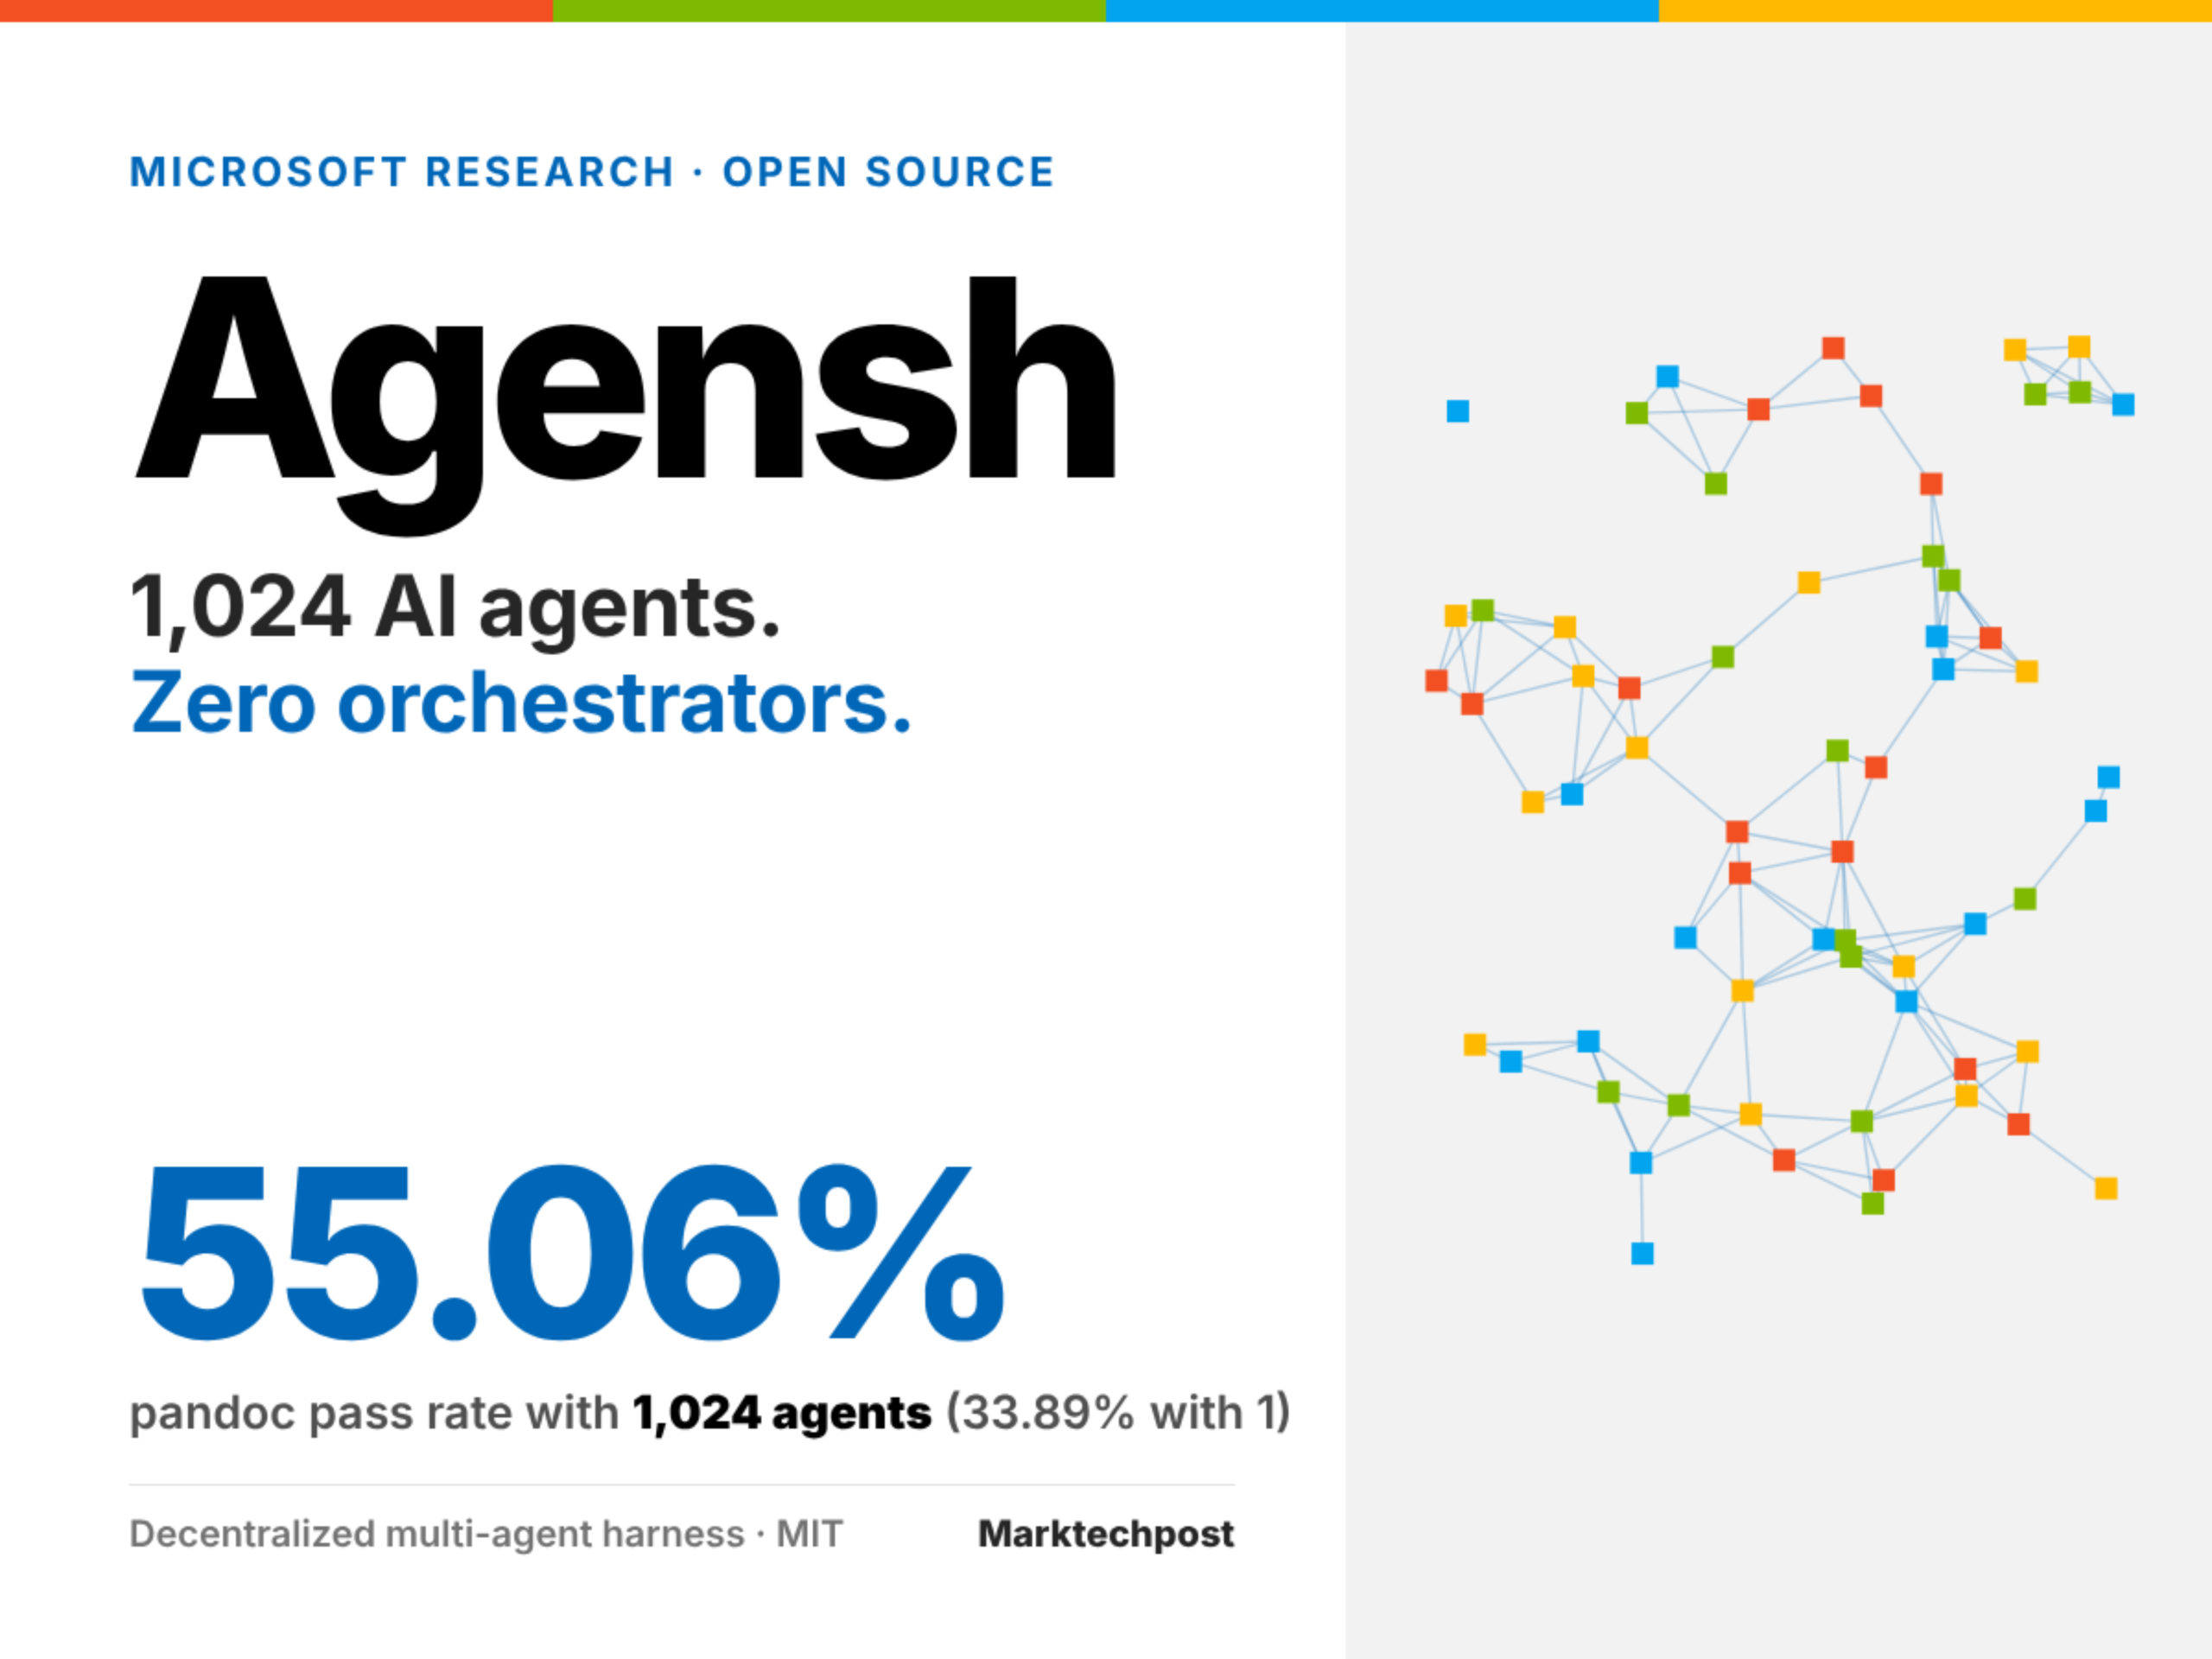
マイクロソフトがAgenshをオープンソース化:1024個の自律協調型AIコーディングエージェントをサポートする分散型フレームワーク

マイクロソフト研究院は2026年10月25日、中央調整者を必要としないマルチエージェント実行時フレームワークであるAgenshをオープンソース化しました。Agenshは、ProgramBench上で1~1024のLLMベースのコーディングエージェントが自己組織的に協調して動作することを支援します。システムはGitea、Mattermost、DeLMスタイルの共有ボードに基づいて分散型の調整を実現しており、すべてのエージェントが同一のプロンプト駆動型五段階ループを実行します。また、Linux+Docker環境下でスケーラビリティが検証されています。

Microsoft Open-Sources Agensh: A Multi-Agent Harness for 1,024 Agents

注目する理由:この成果は、マルチエージェントシステムアーキテクチャの重要な進化を示しており、従来の「マスターエージェント」型パラダイムを廃し、プロンプトエンジニアリングと軽量なサービスの組み合わせによって大規模な自己組織化を実現しています。ProgramBenchにおける実証データ(たとえば、128個のエージェントによる5つのタスクの均等分配において49%の性能向上)は、分散型AIの設計・実装に新たなベンチマークを提供しています。また、MITライセンスでオープンソース化されており、Copilot CLIなどの主流な単一エージェントツールとも互換性があるため、実際の開発における参考価値も備えています。

経緯と関連報道

アンダードッグ・サルキ27B:GSQ-RCOをベースとした2ビットQwen3.8-27Bのツール呼び出しモデルに関する技術解説

本記事では、Underdogが公開したSaluki 27Bモデル——7.9 GBの2ビット量子化を採用したQwen3.8-27Bの変種——について紹介します。同モデルはISTA-DASLabのGSQ-RCO手法を用いて構築されており、120タスクにおけるBFCL v4ツール呼び出しベンチマークにおいて、元の54 GBのフル精度モデルを上回るとされています。ただし、すべての性能に関する結論は開発者による声明に基づくものであり、独立した検証は行われていません。

How to Run Underdog Saluki 27B: 2-Bit Qwen3.8-27B Tool-Calling Guide
経緯と関連報道

llama.cpp が b11870 バージョンをリリースし、DeepSeek-V4.1-Flash モデルを正式にサポートしました

llama.cppはバージョンb11870において、DeepSeek-V4.1-Flash(deepseek41)モデルへの対応を追加し、そのEngramアーキテクチャに対してKVキャッシュ計算の簡略化、BF16精度によるMXFP8代替、in-graph行gatherなど、複数の低レベル最適化を施しました。同時に、macOS、Linux、Windows、Android、iOSおよびopenEulerを網羅するマルチプラットフォームのバイナリビルドも提供しています。

経緯と関連報道

NVIDIAを引きずり込んでAppleに真っ向から対抗し、マイクロソフトのハイエンドAI PCという賭け

マイクロソフトは、NVIDIA RTX Sparkを搭載したSurface Laptop Ultraで、ローカルAI開発者およびハイエンドクリエイターの獲得を目指している。ハードウェアは大容量の統合メモリ、CUDA、RTXグラフィックス機能をポータブルデバイスに持ち込んだが、Macに対する持続的な競争力を確立できるかどうかは、依然としてアプリケーションの適応性、エージェント体験、そして実際のワークフロー次第である。

注目する理由:この競争が最終的に問うべきは、ローカルAIが創作や開発の効率を実際に向上させられるのか、そしてユーザーがそれに伴うデバイス・ソフトウェア・移行コストを負担する価値があるのか、という点です。ハードウェアは新たな可能性をもたらしますが、その可能性がどれほどのユーザーに届くかは、エコシステムと実際の使用体験によって決まります。

経緯と関連報道

Apple初の折りたたみ式スクリーン搭載iPhone Duoが発売と同時に、画面の集中的な割れ問題が発生している

複数のユーザーから、Apple初の折りたたみ式スマートフォン「iPhone Duo」について、開封後わずかな時間でヒンジの真上部分の画面にひび割れや線状の破損が生じるという報告が寄せられており、故障の発生が極めて集中しているとのことです。オーストラリアおよび中国国内でも同様の事例が確認されており、原因はヒンジの組み付け公差にあると疑われています。Apple公式からのコメントはまだなく、アフターサービスでの判定結果次第で、無償交換か高額な自己負担による修理が決まる見込みです。

注目する理由:本件は、新製品における大規模な初期不良をめぐる事案であり、消費者の権利と企業の責任の境界に直面するものであるとともに、三包法規の適用性やAppleCare+サービスの位置付けといった公共的課題も重なり、典型的な警鐘としての意義と権利救済の参考価値を有している。

経緯と関連報道

llama.cpp が b11868 バージョンをリリース:Hexagon NPU のマルチコア Flash Attention に対するサポートを強化し、全プラットフォームでのコンパイルとビルドを網羅

llama.cpp v2.45.0(タグ b11868)が正式にリリースされ、主要な更新点として、Hexagon バックエンドに KV-head のグループ分割メカニズムを導入してマルチコア HMX Flash Attention の性能を最適化し、FA の分割制御フラグを統一しました。同時に、macOS、Linux、Windows、Android、iOS、openEuler など、全プラットフォーム向けのバイナリパッケージを提供しており、CUDA 12/13、Vulkan、ROCm、OpenVINO、SYCL、Snapdragon(Adreno+Hexagon)など、複数のバックエンドに対応しています。

経緯と関連報道

llama.cpp がバージョン b11867 をリリース:サーバーエンジンのエントリーポイントを再構築し、マルチプラットフォームと異種アクセラレーションバックエンドを全面的にサポート

llama.cpp が GitHub 上で正式にバージョン b11867 をリリースしました。主要な変更点として、サーバー側のエントリーポイントの再構築(PR #31113)と、server_role 機構の追加が挙げられます。また、macOS、Linux、Windows、Android、iOS、openEuler を対象とした 40 種類以上の事前ビルド済みバイナリパッケージを提供しており、CPU、CUDA(12.4/12.8/13.4)、Vulkan、ROCm 10.0、OpenVINO、SYCL(FP16/FP32)、Snapdragon(Adreno+Hexagon)など、多様なハードウェアバックエンドをサポートしています。

経緯と関連報道

llama.cpp が b11866 バージョンをリリース:Metal バックエンドの冗長な AMAX スケーリングロジックを削除し、MoE の計算パスを簡素化しました

llama.cpp v.b11866 では、Metal バックエンドに実装されていた時代遅れの src1 の2のべき乗による AMAX スケーリング機構が削除され、代わりに計算グラフ内でのより細粒度なエキスパートごとのトークン単位の amax スケーリングに依存するようになりました。これにより、MoE 下における投影後の活性化値が f16 表現の範囲内に収まることが保証されます。同時に、関連する二段階リダクションカーネル、F32 精度のスケジューリング、および境界外アクセスを検出するテストケースも削除されました。

経緯と関連報道

llama.cpp がバージョン b11861 をリリース:minimax-m3 モデルの量子化スケーリングテンソルが伝達されないことで生じる推論エラーを修正

llama.cpp v.b11861 では、minimax-m3 モデルにおいて NVFP4/MXFP8 の量子化下でスケールテンソルが計算グラフに注入されないために生じていた重みの歪み問題を修正し、『token soup』や残差の埋没を回避しました。また、macOS、Linux、Windows、Android、iOS、openEuler を網羅するマルチプラットフォーム対応のバイナリビルドも同時に提供されています。

経緯と関連報道

AI墓地:失敗に終わったAIプロジェクトとスタートアップ企業の一覧(随時更新)

TechCrunchは2026年10月25日に報道を発表し、2023年から2026年にかけて期待に応えられなかった複数のAIプロジェクトを整理した。これには、Relay、Character.ai、Sora、Humane AI Pinなどのスタートアップや製品に加え、OpenAI、Apple、Microsoftといった大手企業による失敗例や大幅な見直しも含まれる。

The AI graveyard: a running list of projects and startups that didn’t make it

注目する理由:この報道は業界規模の現象的総括であり、対象範囲が広く、時間軸も明確で(具体的な停止・延期日付を含む)、S&P Global Market Intelligenceのデータを引用して企業レベルのAIプロジェクトにおける高い廃棄率(42%)を裏付けています。事例の詳細と構造的な分析を併せ持ち、典型的な参考価値を有しています。

経緯と関連報道