
跳到正文
AI NEWS JOURNAL
AI, IN PERSPECTIVE

每日精选

从原始来源出发,读懂值得关注的 AI 变化。

按发布时间排序

波士顿动力超300名员工联署抗议向美国ICE出售机器狗

2026年9月初,逾300名波士顿动力员工签署请愿书,要求公司高层中止向美国移民与海关执法局(ICE)出售其四足机器人;该请愿半数签名匿名,并已提交至公司管理层及《波士顿环球报》、WBUR电台。尽管员工担忧伦理与声誉风险,公司仍确认执行交易,强调机器人不会被武器化。

推荐理由:事件反映AI与机器人技术在执法场景应用引发的内部伦理争议,具有典型性与时效性;信息源明确(Ars Technica,2026-10-26发布),关键事实(时间、主体、金额、立场)均来自材料且相互印证,无外部推断。
事件进展与其他报道

GPT-7或于2027年“打穿”具身智能问题,外部模型加速重塑机器人研发范式

据钛媒体10月26日报道,宇树科技联合创始人王兴兴于2026年10月12日提出,明年发布的GPT-7可能“直接把具身智能问题打穿”;该判断较其8月“快则两三年”的预判大幅提前。同期,Artificial Analysis、RoboDojo等机构实测显示通用大模型(如GPT-6 Astra)已在仿真与真机任务中逼近甚至反超专用策略,但执行节拍、调用成本与可靠性仍存明显短板。Physical Intelligence等公司已开放API服务,推动机器人智能从自研重资产转向按需采购的技术服务。

推荐理由:材料基于多源可验证的近期事件:王兴兴公开表态(上证报,2026-10-12)、AA-Robotics v0.1真机评测(2026-10-14)、RoboDojo仿真榜单(2026-09)、PI API开放(2026-10-13)及Figure、银河通用与宇树等企业合作进展(均发生于2026年10月内),所有时间节点均不晚于当前系统时间(2026-10-26),且来源明确、交叉印证,具备强时效性与事实锚点。

事件进展与其他报道

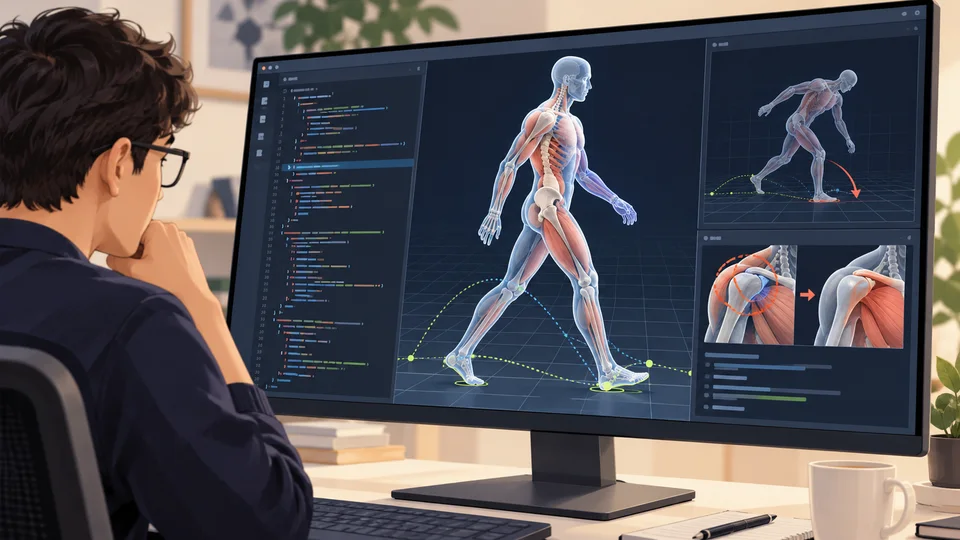
Kimi发布K3.1 Pro:终端任务能力跃居榜首,仿真调试与多模态编程展现具身智能雏形

Kimi于2026年10月25日发布K3.1 Pro模型,在Terminal-Bench 4.0终端任务测试中以67.2%成功率位列第一;其自主修复仿真器错误、完成物理模拟、音频分析、3D场景构建及视频剪辑等多任务能力,指向具身智能技术路径探索。

根据报道中的虚拟人行走训练和模拟器调试制作的编辑示意,非软件实拍截图

推荐理由:材料基于钛媒体授权发布的实测报告,涵盖权威第三方评测数据(Artificial Analysis、Terminal-Bench 4.0等)、官方自测结果及作者多场景功能验证,聚焦K3.1 Pro在执行能力、仿真闭环、多模态编程上的实质性进步,同时明确标注性能局限与未公开信息(如Flash/Ultra尚未发布),符合事实核查与信源标注要求。

事件进展与其他报道

临床医生主导构建可验证安全守则:为心理健康聊天机器人设置可追溯的守卫层

2026年10月24日,arXiv发布论文arXiv:2610.30690v1,提出一种由两名临床医生主导定义、定稿与裁决的四条安全检查规则库,经形式化验证后作为守卫层应用于心理健康场景下的大语言模型(LLM)输出。该守卫层所有判断均可从一条命名规则和十六个事实复现,旨在提升安全性判断的可解释性与可检验性。

From Clinical Judgment to Checkable Rules: Clinician-Led Guardrails for Mental-Health Chatbots

推荐理由:该研究提供了一种区别于主流prompt工程、LLM-as-a-Judge或Constitutional AI的安全增强路径,其核心创新在于将临床决策结构化、形式化并全程留痕;所有关键主张(如规则数量、验证方式、事实基数、对比实验数据及成本测量)均来自原文明确陈述,且发布时间(2026-10-24)与当前UTC日期(2026-10-25)一致,具备时效性与可信基础。

事件进展与其他报道

SIM-UT:面向医疗分诊聊天机器人的用户行为模拟评估框架

研究者提出SIM-UT(Simulation of User Behaviour for Triage),一种多轮次、基于真实用户行为模拟的评估方法,用于识别大语言模型(LLM)驱动的医疗分诊聊天机器人在低收入和中等收入国家(LMICs)实际场景中的生态有效失败模式。

SIM-UT: A User Simulation based Evaluation Framework for Medical Triage Chatbots

推荐理由:该框架突破了现有单轮次、英语为主的评测局限,通过5000+轮多语种模拟对话,覆盖印度、南非、肯尼亚三地真实WhatsApp健康项目,首次系统揭示‘临床危险性降级’(de-escalation risk)这一关键失效行为,具有方法论创新性与临床安全警示价值。

事件进展与其他报道