
深度丨从独占61%企业开源账单到巨头分成,开源模型开始商业化下半场
11 月 5 日,OpenAI 前首席技术官 Mira Murati 创立的 Thinking Machines Lab(TML)交出了第二代模型 Inkling 2 Small。这家成立一年半、正以 400 亿美元投前估值洽谈 50 亿美元融资的硅谷明星实验室,急需用一款足够硬核的新模型向投资人证明自己。评测机构很快给出了“中国以外最高分开源权重模型”的头衔;但当同行翻开...

检索标题、摘要与正文,把分散的信息连起来。
11 月 5 日,OpenAI 前首席技术官 Mira Murati 创立的 Thinking Machines Lab(TML)交出了第二代模型 Inkling 2 Small。这家成立一年半、正以 400 亿美元投前估值洽谈 50 亿美元融资的硅谷明星实验室,急需用一款足够硬核的新模型向投资人证明自己。评测机构很快给出了“中国以外最高分开源权重模型”的头衔;但当同行翻开...
选型选得好只是锦上添花,最终还是要先把用户最真实的需求解决好。查看全文
你有没有想过一件事:你用的那个编程助手模型,最初的权重文件从哪来的?大概率不是公司自己从零训练的。现在做AI应用的公司,十个里有九个是拿一个别人训练好的基础模型,再用自己的数据微调一下,变成自己产品里的"大脑"。Cursor的Composer 2用的是Kimi K2.5底子,WebRL把Llama模型改造成了网页操作助手。这事本身没毛病,省时...

智东西(公众号:zhidxcom)作者 | 李水青编辑 | 心缘智东西10月31日消息,刚刚,阿里巴巴宣布与苹果达成合作,将千问(Qwen)集成至苹果智能(Apple Intelligence),中国用户可以在Siri、写作工具及视觉智能中,直接调用千问的文本与图像理解、内容生成等能力。这些功能将于11月4日起随最新的iOS开发者Beta版开放测试,并...

文丨苏扬 编辑丨徐青阳 Android正在为AI智能体打开更多入口。 美国当地时间10月28日,谷歌举行Android Dev Summit 2026开发者峰会,发布了....
Instagram Direct 将其 Android 用户界面从旧版的 Android View 系统迁移到了 Jetpack Compose,从而创建了一个 AI 原生的用户界面代码库,使 AI 编码代理更容易理解、修改和维护。
LangChain 如何在 Slack 中构建了 Content Studio——一个开源的设计代理,用于制作符合品牌调性的视频、图形和演示文稿,以及为其提供动力的工具链。
arXiv:2610.33019v1 发布类型:新 摘要:随着多模态智能体开展持续交互,长期记忆发挥着两种既 distinct 又互补的功能:细粒度的证据召回,以及用于全局理解的内化解读。尽管情景记忆与隐式记忆分别通过显式的历史记录和内化的经验来满足这些需求,但由于情景记忆在证据覆盖与整合方面存在局限,而隐式记忆又缺乏扎实的事实基础,单一的范式难以兼顾不同任务间多样化的记忆偏好。为弥合这一鸿沟,我们提出了一种双记忆框架,将模型原生的隐式记忆作为直观的先验,同时结合多索引的情景记忆,通过检索驱动的联合对齐实现精确的证据重建。在 i

arXiv:2610.34436v1 发布类型:新 摘要:循环语言模型在每个标记上会运行 $R$ 轮层,因此其键值(KV)缓存为每递归层保存 $R$ 个平面,而自推测解码(先用几轮进行初步推断,再用全部 $R$ 轮验证)会读取所有这些平面。我们发现,前缀键值的影响主要体现在较晚的阶段:在扰动幅度相同的情况下,第 25 至 32 轮的敏感度分别是第 2 至 9 轮的 $e^{15.0}$ 倍(Huginn-0125)和 $e^{12.8}$ 倍(Raven-Llama),且各平面随循环次数呈几何级数逼近最后一个平面,每轮分别达到 0.88 和 0.81。至于是否仅保留最深层的平面即可,这取决于晚期平面的成熟程度:在 Raven 上,仅存储最深层平面与从 bf16 转换为 fp32 的效果几乎无差异;而在 Huginn 上,仅有 1% 的位置就贡献了其误差的 74%。我们将这一发现转化为 RIPE,该方法存储最深层的
arXiv:2610.32177v1 发布类型:新 摘要:人类在面对不断演化的复杂问题时,能够灵活地将多种推理形式加以组合,从而对物理世界进行推理。实现这种灵活性是人工智能领域的一项重大开放性挑战:当前的各类能力往往仍被分割在不同的专用模型中,限制了它们之间的组合方式以及针对特定任务的协同适配能力。我们提出了Ψ-0.6,这是一种统一的视觉—语言世界模型,它能够在一种名为“思维流”的共享推理过程中,自适应地整合感知、语言、几何与仿真等模块。这些思维流交织着图像、文本以及关于几何与运动的显式表示,而模型可通过统一的标记接口生成并解释所有这些信息。Ψ-0.6在多视角空间推理的零样本任务上超越了当前领先的开放权重模型。
arXiv:2610.31721v1 发布类型:新 摘要:在评估成本高昂且约束复杂的高维物理系统时,如何进行优化是科学与工程领域的一项核心挑战。在离线模型基优化(MBO)中,方法必须仅利用固定的数据集来改进设计方案,而不能在测试阶段访问真实的优化目标。然而,现有方法通常存在保守性、对代理模型的无约束利用,或作为静态的推理阶段采样器,无法根据精确的物理目标进一步优化候选解等问题。本文提出了一种用于离线模型基优化的可微扩散条件化(D2C)方法,该方法利用了这样一个事实:确定性采样使得反向去噪链相对于条件信号是可微的。D2C将一个 fro

arXiv:2610.31894v1 发布类型:新 摘要:近期的稀疏自编码器(SAE)能够将大型语言模型(LLM)的表示分解为可解释的特征,从而实现对编码知识的精确读取与控制。然而,现有的SAE将每个特征视为独立单元,而现实世界中的知识往往具有层级化的分类结构。因此,这种读取方式无法保证分类学上的一致性,控制也缺乏足够的粒度来明确指定编辑的范围。我们提出了TaxoSAE,该方法在SAE的特征空间中显式地编码了分类学信息,基于“is-a”(超类—子类)关系构建。TaxoSAE通过堆叠一系列SAE来模拟一个分类体系,每一层对应一个分类层级,并引入了一种分类对齐损失,使每个概念在被激活时都能准确对应其所属的分类层级。
微软研究院于2026年10月25日开源Agensh,一种无需中央协调器的多代理运行时框架,支持1至1024个LLM编码代理在ProgramBench上自组织协作。系统基于Gitea、Mattermost和DeLM风格共享看板实现去中心化协调,所有代理运行同一提示驱动的五步循环,已在Linux+Docker环境下验证可扩展性。
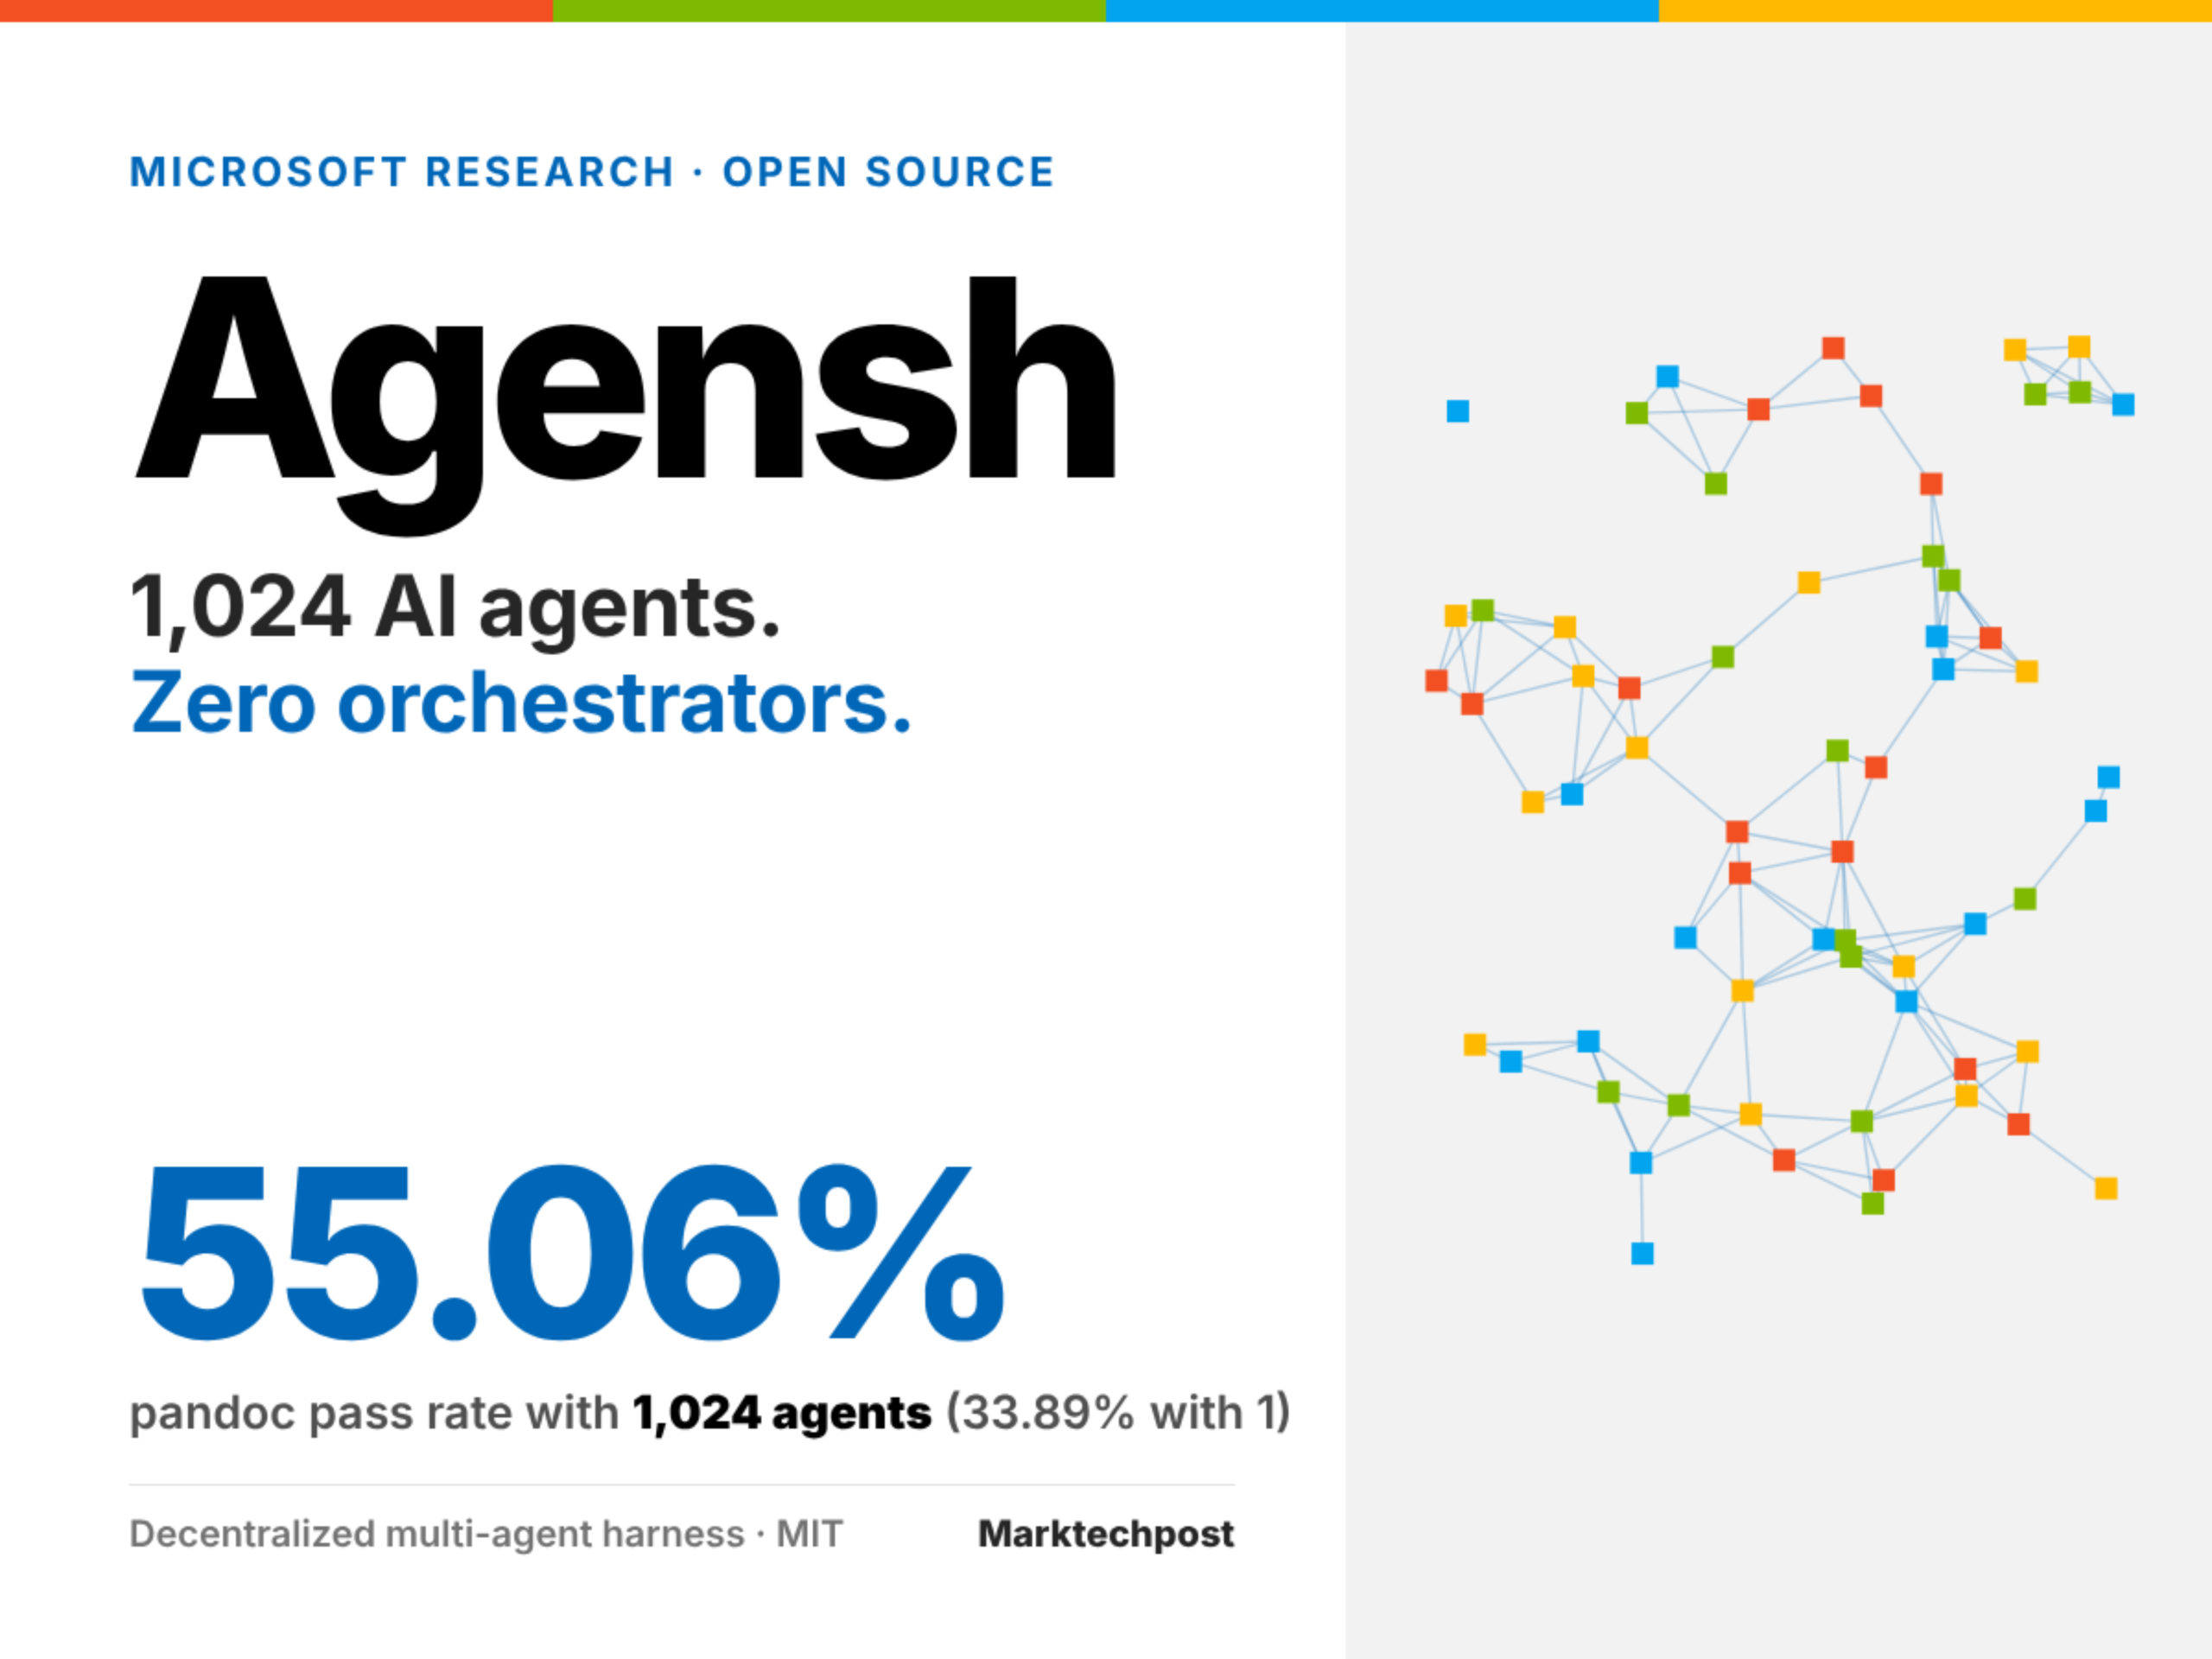
推荐理由:该成果代表多智能体系统架构的重要演进——摒弃传统‘主控代理’范式,通过提示工程与轻量服务组合实现大规模自组织;其在ProgramBench上的实证数据(如128代理使5任务均分提升49%)为分布式AI工程提供新基准;MIT许可证开源且兼容Copilot CLI等主流单代理工具,具备实际开发参考价值。