
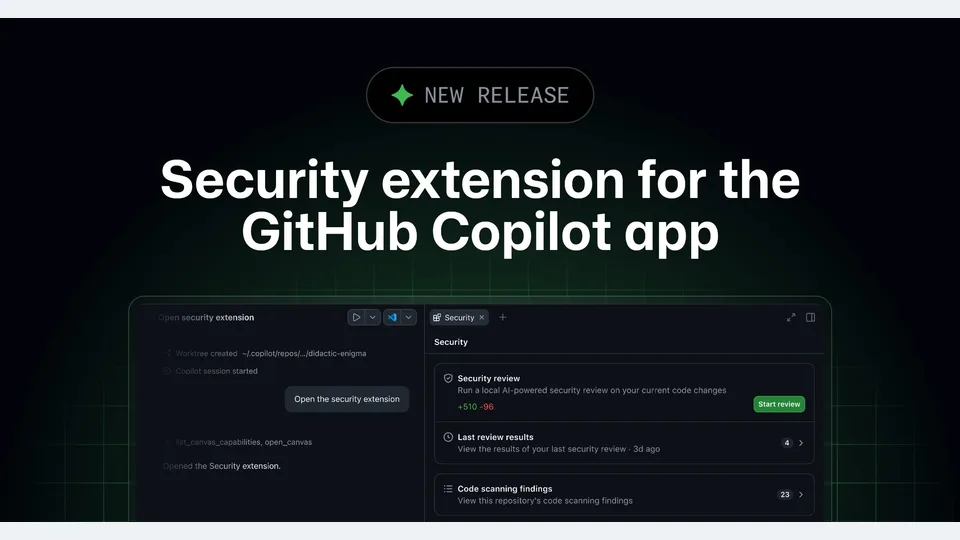
GitHub Copilot 应用的安全扩展
现在,您无需离开 GitHub Copilot 应用,即可处理仓库中的 GitHub 代码扫描警报。全新推出的 GitHub 安全扩展现已进入公开预览阶段,让您能够找到…… 该文章“GitHub Copilot 应用的安全扩展”首发于 GitHub 博客。
检索标题、摘要与正文,把分散的信息连起来。
现在,您无需离开 GitHub Copilot 应用,即可处理仓库中的 GitHub 代码扫描警报。全新推出的 GitHub 安全扩展现已进入公开预览阶段,让您能够找到…… 该文章“GitHub Copilot 应用的安全扩展”首发于 GitHub 博客。
仓库插件默认设置以及由企业管控的插件功能,现已在 VS Code、Copilot CLI 和 GitHub Copilot 应用中全面上线。受信任的仓库可以为…安装并启用默认插件。该文章《仓库插件默认设置与企业级插件管控现已全面可用》首发于 GitHub 博客。
## [3.0.1](https://github.com/n8n-io/n8n/compare/n8n@3.0.0...n8n@3.0.1) (2026-10-28) ### Bug修复 core:在压缩版构建中保留 ExpressionError 的名称 (https://github.com/n8n-io/n8n/issues/42309) ([b3192c6](https://github.com/n8n-io/n8n/commit/b3192c6d151125c76c88fe8a421e027b4242a3f9)) core:在 QuickJS 表达式结果中保留未定义值 (https://github.com/n8n-io/n8n/issues/42264) ([532f645](https://github.com/n8n-io/n8n/commit/532f645f21c99e178a09448caf37ebd77d24b56a)) 编辑器:使分割按钮内的光标对齐 (https://github.com/n8n-io/n8n/issues/42203) ([61cbfea](https://github.com/n8n-io/n8n/commit/61cbfeafa267b5c769b345c50ccbd4fc504b0e69)) 编辑器:提升首次加载速度 (https://github.com/n8n-io/n8n/issues/41987) ([8b6bdbb](https://github.com/n8n-io/n8n/commit/8b6bdbbe874b
## [2.45.5](https://github.com/n8n-io/n8n/compare/n8n@2.45.4...n8n@2.45.5) (2026-10-28) ### 修复的Bug * **核心:** 在压缩版构建中保留 ExpressionError 的名称([#42309](https://github.com/n8n-io/n8n/issues/42309))([b3192c6](https://github.com/n8n-io/n8n/commit/b3192c6d151125c76c88fe8a421e027b4242a3f9)) * **核心:** 在 QuickJS 表达式结果中保留未定义值([#42264](https://github.com/n8n-io/n8n/issues/42264))([532f645](https://github.com/n8n-io/n8n/commit/532f645f21c99e178a09448caf37ebd77d24b56a)) * **编辑器:** 在拆分按钮内对齐光标([#42203](https://github.com/n8n-io/n8n/issues/42203))([61cbfea](https://github.com/n8n-io/n8n/commit/61cbfeafa267b5c769b345c50ccbd4fc504b0e69)) * **编辑器:** 提高首次加载速度([#41987](https://github.com/n8n-io/n8n/issues/4
面向RF设计的智能体驱动解决方案。文章《规划您的RF EDA人工智能设计之旅》首发于Semiconductor Engineering。
arXiv:2610.36083v1 发布类型:新 原文摘要:生成式人工智能的最新进展通过后训练的金融领域大型语言模型(LLMs),显著提升了金融情绪分析的性能。然而,现有方法仍局限于孤立地预测每篇文章的情绪,且运行机制如同“黑箱”,这限制了对上下文的理解,并阻碍了其在高风险金融决策中的应用。为此,我们提出了FinLLM-KG,这是一种与模型无关的框架,将因果推理的大语言模型与金融知识图谱相结合,在推理阶段注入来自美国证券交易委员会10-K文件的、具有时间关联性的公司级知识,而无需更新模型权重。在FinLLM-KG中,上下文既可以以自然语言形式的公司简介提供,也可以以一小部分关系作为输入。
arXiv:2610.36178v1 发布类型:新 摘要:我们无需抽样误差,即可测量当被要求生成一个随机数时,语言模型为1至N之间的每个整数所分配的概率。对于固定的提示词,模型会定义一个概率向量;我们通过累加每个整数的得分拼写来计算该向量,而非采用抽样估计,从而消除了限制早期研究[1, 4]的噪声。我们在两个推理栈上,针对多达N=100的五个范围,评估了18条开放权重模型系列,并采用了29种解码配置;其中15个模型同时拥有基础版和指令微调版的检查点,且两者均能给出可用的答案。指令微调使这15对模型中的分布更加不均匀,它引入了一种避免使用整数的启发式方法,并强化了另一种避免接近端点的启发式方法。基础检查点
arXiv:2610.35925v1 发布类型:新 摘要:训练用于个人身份信息(PII)的上下文化掩码系统,需要能够区分某一实体类型中可掩码与不可掩码提及的示例,但隐私限制使得获取真实数据受到制约。基于作者的增强方法(SPY)会将与作者无关的提及标记为非PII,这种方法假定存在单一的数据主体,而忽视了其他可能的主体。我们提出了ReCoPII(基于关系的上下文化PII掩码),该框架无需这一假设即可构建此类数据:它规划受本体约束的实体关系,编写带有占位符的插入句,通过代码重建标注,利用独立的大型语言模型检查结果,并根据实体关系推导出MASK/KEEP标签。在来自六个领域的韩语文档上,它生成了Re
arXiv:2502.02727v4 发布类型:替换-交叉 摘要:客户端漂移补偿方法能够缓解联邦学习(FL)中数据异构性带来的影响。尽管针对基于随机梯度下降(SGD)的联邦学习,漂移校正已得到充分研究,但其与自适应客户端优化器之间的相互作用仍缺乏深入理解。诸如Adam等自适应优化器会根据过去梯度的运行平均值来构建每次更新,因此仅对最终更新方向进行校正,将无法改变这些平均值及其所包含的漂移。我们提出了联邦自适应梯度校正({\tt FA-GC}),该方法在梯度进入这些运行平均值之前即对其进行校正,并将其与联邦自适应朴素跟踪({\tt FA-NT})进行了对比——后者是在最终更新方向上添加校正。我们证明,在一种理想情况下
arXiv:2610.36582v1 发布类型:新 摘要:为了生成基于地标的路线指引,模型必须同时理解地图的几何结构以及人类对地标的偏好。尽管大型语言模型(LLMs)在语言任务中表现出色,但如何为这些模型高效地组织地图数据,目前仍未形成明确的方案。本文提出了一种用于路线导航中地标选择任务的结构化文本表示方法,利用SVG格式对空间特征进行编码。这种结构化文本与渲染后的地图图像保持几何上的关联,使语言模型能够直接访问空间和语义信息。我们使用一个由人工编写的路线描述与OpenStreetMap数据构建的新数据集,在两个任务上对模型进行了评估:转弯处的地标选择以及目的地附近的地标选择。
arXiv:2610.35877v1 发布类型:新 摘要:改变部署策略可能会使世界模型的不确定性失效,而同时保持物理转换机制和预测器不变。对于一步预测而言,如果源域与目标域的条件机制 $P(Y|X)=Q(Y|X)$ 相同,则该干预可通过预结果度量的变化 $w(X)=dQ_X/dP_X$ 来识别。对于受策略控制的动力学系统,这一比率可分解为状态占用率与动作倾向性两部分。加权保形校准能够将边际覆盖率迁移至目标分布;在估计出比率 $\hat w$ 的情况下,有 $P_Q\{Y \in C_{\hat w}(X)\} \ge 1-\alpha-TV(Q,\hat Q) \ge 1-\alpha-E_P|w-\hat w|$。源域与目标域分类器的总体对数损失遗憾同样界定了这一比率误差。若 $h$ 是其剪切
医疗AI应用现状、政策与商业卡点、以及破局思考
年收入逼近400亿元?红果短剧回应:不实;并入火山近百日后,飞书首席战略官史志隽将卸任转顾问;马斯克称SpaceX移动网络建设将耗时2至3年;新规出炉:有线电视不得播放开机广告;事关能源保供中长期合同管理,国家发展改革委作出部署;13家科创50公司正在实施回购计划,预计金额上限超50亿元;中国作为首批签约国签署《联合国可转让货物单证公约》;崔东树:2026年1-9月汽车行业利润率3.3%;国家统计局:1—9月份全国规模以上工业企业利润增长15.5%
IBM欧洲研究院的研究人员发表了论文《用于神经网络向量存储的叠加式模拟存储器》。摘要:研究人员展示了一种模拟相变存储架构,可在叠加态下存储多个AI向量,并通过可调的精度权衡来提升有效存储密度。在原型PCM硬件上的测试表明,其推理精度接近全精度软件水平。点击此处查看技术论文……» 阅读全文 该文章《模拟叠加提升PCM有效存储密度(IBM欧洲研究院)》首发于Semiconductor Engineering。
如果团队能够解决信任问题,AI 智能体为何能让语义层更加稳固?
TechCrunch采访了那位被委以解释OpenAI最新令人费解的发现重任的麻省理工学院计算机科学家
LangChain 如何在 Slack 中构建了 Content Studio——一个开源的设计代理,用于制作符合品牌调性的视频、图形和演示文稿,以及为其提供动力的工具链。
Property Finder 发现,其视觉AI评估标签中有96.8%源自现有模型,这掩盖了该模型的真实准确率。了解他们如何构建无偏的真值数据、实施进化式提示优化,并在 Amazon Bedrock 上选择了一款更精准且更具成本效益的模型,从而在11项图像质量指标上将成本降低了86%。
正加速迈向AI自动化的各家企业发现,模型与数据的运行环境,其重要性丝毫不亚于模型本身的能力。监管压力、代币成本上升以及对厂商锁定的担忧,正促使企业对其AI工作负载提出更高的管控需求。这种需求正在重塑数据平台供应商们的产品定位与市场策略。[…] 文章《Cloudera押注可移植性而非代理,以在企业AI领域脱颖而出》首发于SiliconANGLE。