
Anthropic 正在燃烧天然气以支撑人工智能的蓬勃发展
在准备上市之际,Anthropic提交的S-1文件使生成式AI对甲烷的依赖暴露无遗。“在获取电力供应以及具备充足电力保障的数据中心选址方面,竞争十分激烈。”在周一提交给美国证券交易委员会的文件中,Anthropic承认,数据中心正日益依赖“天然气”[…]

检索标题、摘要与正文,把分散的信息连起来。
在准备上市之际,Anthropic提交的S-1文件使生成式AI对甲烷的依赖暴露无遗。“在获取电力供应以及具备充足电力保障的数据中心选址方面,竞争十分激烈。”在周一提交给美国证券交易委员会的文件中,Anthropic承认,数据中心正日益依赖“天然气”[…]
Anthropic终于向美国证券交易委员会提交了S-1招股说明书,这份文件旨在让投资者深入了解其业务的方方面面,从高管薪酬、IPO募资的使用计划,到可能阻碍其实现雄心的风险等。这份长达300多页的文件内容十分丰富……

Anthropic的S-1文件显示,其超过一半的年收入超过10万美元的客户如今同时使用Claude平台和自有应用程序,这一交叉销售策略让人联想到亚马逊的做法,正使企业客户黏性不断提升。
人工智能巨头Anthropic PBC今日向美国证券交易委员会提交了首次公开募股申请文件,这使其有望迎来迄今为止规模最大的人工智能开发企业上市。与此同时,有关先进人工智能的警告之声不绝于耳。在提交的文件中,Anthropic表示计划上市[…] 该文章《Anthropic就拟议中的IPO提交S-1文件》首发于SiliconANGLE。
人工智能巨头Anthropic PBC今日向美国证券交易委员会提交了首次公开募股申请文件,这使其有望迎来迄今为止规模最大的人工智能开发企业上市。与此同时,有关先进人工智能的警告之声不绝于耳。在提交的文件中,Anthropic表示计划在[…]上市。该文章《Anthropic为重磅人工智能IPO提交S-1文件》首发于SiliconANGLE。
Anthropic于周一提交了文件,为一场备受瞩目的首次公开募股做准备,这些文件披露了该公司的财务状况、风险因素以及其对人工智能未来发展的看法。
今天,我采访了记者兼新书《AGI编年史》的作者凯文·鲁斯。这本书详细记录了人工智能行业近期发生的剧烈变革。凯文曾长期担任《纽约时报》记者,并主持过热门播客节目“Hard Fork”,但他与节目好友凯西·牛顿刚刚离开了[…]


在双十一期间,聊天助手能够通过优惠券引导订单,而商家软件则早已为设计与运营工作收取费用。平台正以比赢得消费者信任更快的速度,将现有预算变现。
arXiv:2610.31946v1 发布类型:新 摘要:三名学生亲手回答了同一道考试题目:“什么是幸福?你幸福吗?”他们在收集时的年龄分别为17岁、28岁和45岁。其中,17岁的学生的答案措辞谨慎、表达正式。在要求将每份答案匹配到特定年龄与性别标签的任务中,大多数前沿语言模型都自信地将其归为成年人。本文报告了一项针对这一失败现象的结构化案例研究,涉及六种模型:Claude Fable 5、Gemini 3.1 Pro、GPT-5.6 Sol、Grok 4.5、GPT-4o(2024)以及 DeepSeek V4。我们共进行了1,081次API调用,在六个实验条件下对3,225条回复进行了评分,这些条件分别调整了表述方式、披露格式以及受众意识相关指令。在匹配任务中,六种模型中有三种的表现接近或处于随机水平(1/3),同时报告的准确率却高达73%至88%。
2026年10月26日,arXiv发布论文arXiv:2610.31838v1,提出Sense-Aligned Grounding Evaluation(SAGE)——一个统一的10候选图像选择基准,并配套训练无关的Gloss-Augmented Reasoning(GAR)框架,用于跨名词、动词和实体中心的多模态接地评估。

推荐理由:该研究首次将VWSD、VerSe和WikiDiverse三类任务统一为术语中心的接地评测协议,引入混淆难负样本与上下文交换诊断机制,并通过实证表明定义增强与约束引导推理的协同可显著提升Hits@1指标(65.90→71.22),为多模态语义对齐提供了更细粒度、可解释的评估新范式。
arXiv:2610.32002v1 发布类型:新 摘要:微剧的迅猛发展使得对高质量剧本创作的需求日益增长。利用大语言模型进行长篇微剧剧本生成,既需要丰富多样的情节推进,又要求具备长远的叙事连贯性。我们的观察发现,随着生成过程的推进,候选续写内容越来越倾向于聚焦于少数几种叙事机制;而传统的检索方式则可能加剧套路的重复使用,并忽视对未来情节至关重要的历史信息。为应对这些挑战,我们提出了DraMaze——一种多智能体流水线,通过基于套路记忆的进化树搜索与变异,探索多样化的因果路径;同时,它还构建了后向叙事依赖树,用于组织、保存并检索历史记忆。
arXiv:2610.31721v1 发布类型:新 摘要:在评估成本高昂且约束复杂的高维物理系统时,如何进行优化是科学与工程领域的一项核心挑战。在离线模型基优化(MBO)中,方法必须仅利用固定的数据集来改进设计方案,而不能在测试阶段访问真实的优化目标。然而,现有方法通常存在保守性、对代理模型的无约束利用,或作为静态的推理阶段采样器,无法根据精确的物理目标进一步优化候选解等问题。本文提出了一种用于离线模型基优化的可微扩散条件化(D2C)方法,该方法利用了这样一个事实:确定性采样使得反向去噪链相对于条件信号是可微的。D2C将一个 fro

arXiv:2610.32109v1 发布类型:新 摘要:语言模型能够根据给定的文档或其参数化知识回答问题。然而,当后续被问及答案的来源时,究竟是什么决定了它们的来源报告?我们通过在答案生成之后、源问题提出之前对模型的关键值(KV)缓存进行干预来研究这一问题。在一项受控的事实性任务中,针对四款模型(7B–32B),无论改变还是移除文档的缓存,都不会影响其来源报告。相比之下,在两次运行之间移植问答(Q+A)缓存——且前后的问题与答案标记完全相同——则会转移来源报告:所有符合条件的报告都会沿用捐赠方的来源,而接收方的文档本身保持不变。在两款较小的模型上,沿着事先为任何源问题拟合的方向引导问答值……
arXiv:2610.32237v1 发布类型:新 摘要:在现代金融市场中,超过四分之三的大宗交易均由基于先进交易策略的算法交易执行,其精度与速度均优于传统的人工交易。然而,以价格指标为核心的传统策略难以捕捉由社会情绪、政治不稳定或突发经济变化等现实事件所引发的市场动态。随着深度强化学习(DRL)的兴起及数据获取的日益便捷,亟需更高效的算法,以便将这些外部因素纳入交易策略之中。深度强化学习在模拟现实场景以及简化复杂决策方面展现出巨大潜力,因为DRL智能体能够自动
arXiv:2610.31986v1 发布类型:新 提要:视觉语言模型(VLMs)正越来越多地被应用于消费级智能家居摄像头系统,用于解析录制的视频并提供洞察。然而,从智能家居摄像头捕获的视频片段与现有 VLM 基准测试中占主导地位的精选网络视频存在显著差异。智能家居视频片段通常不包含字幕或旁白,并且拍摄角度各异、光照条件多变、场景也十分多样。然而,在视觉信号稀疏且上下文有限的情况下,现有 VLM 基准测试尚未充分评估模型在这一领域的性能。为弥补这一不足,我们提出了 OpenHome,一个仅基于视觉、采用四选项选择题形式的基准测试,用于评估对智能家居视频的理解能力。I
arXiv:2610.31803v1 发布类型:新 摘要:从视觉规格生成物理上稳定的三维结构,需要在解决几何不确定性的同时考虑物体之间的物理相互作用。我们提出了 StackGen3D,这是一个框架,可根据给定的积木库存和三个正交轮廓图生成稳定的积木组合。我们的方法分为两个阶段。首先,我们开发了一种融合物理信息的图神经网络(PI-GNN),用于建模积木之间的支撑关系,并作为快速的稳定性预测器,用于构建多样化的稳定结构数据集。其次,我们在该数据集上训练了一个条件流匹配模型,以捕捉与目标轮廓图相一致的积木构型的多模态分布。在推理阶段,轻
arXiv:2610.32042v1 发布类型:新 提要:跨语言配音旨在将源语言语音转换为目标语言语音,并使其与原视频保持同步。这一任务的关键在于生成忠实且在源语言时序框架内自然可说的译文,而这并不容易,因为不同语言在音长、节奏和发音方式上存在差异。本文提出了一种名为 X-Dubbing 的方法,将该任务建模为一种同时考虑时间约束的语音转文本翻译与视频感知的文本转语音问题。具体而言,我们的方法由一个能够生成具有时间结构脚本的配音翻译器,以及一个能将其与源视频同步呈现的配音演员组成,二者均以一种与语言无关的时间预算为基础。此外,我们还通过 dubbing 对翻译器进行了进一步优化。
苹果终结二十年触控抵制,首款触屏OLED MacBook Pro定档发布,成为特努斯接任CEO后首个硬件答卷;Meta自由现金流转为-21亿美元,7600亿美元行业资本支出迎盈亏平衡审判;谷歌以1070兆瓦虚拟电厂重构数据中心供能,特斯拉自研AI地图弃用谷歌;Anthropic被指静默削弱Claude Opus 5.5逆向能力;亚马逊、Meta、OpenAI以50美元级AI硬件切入可穿戴赛道。
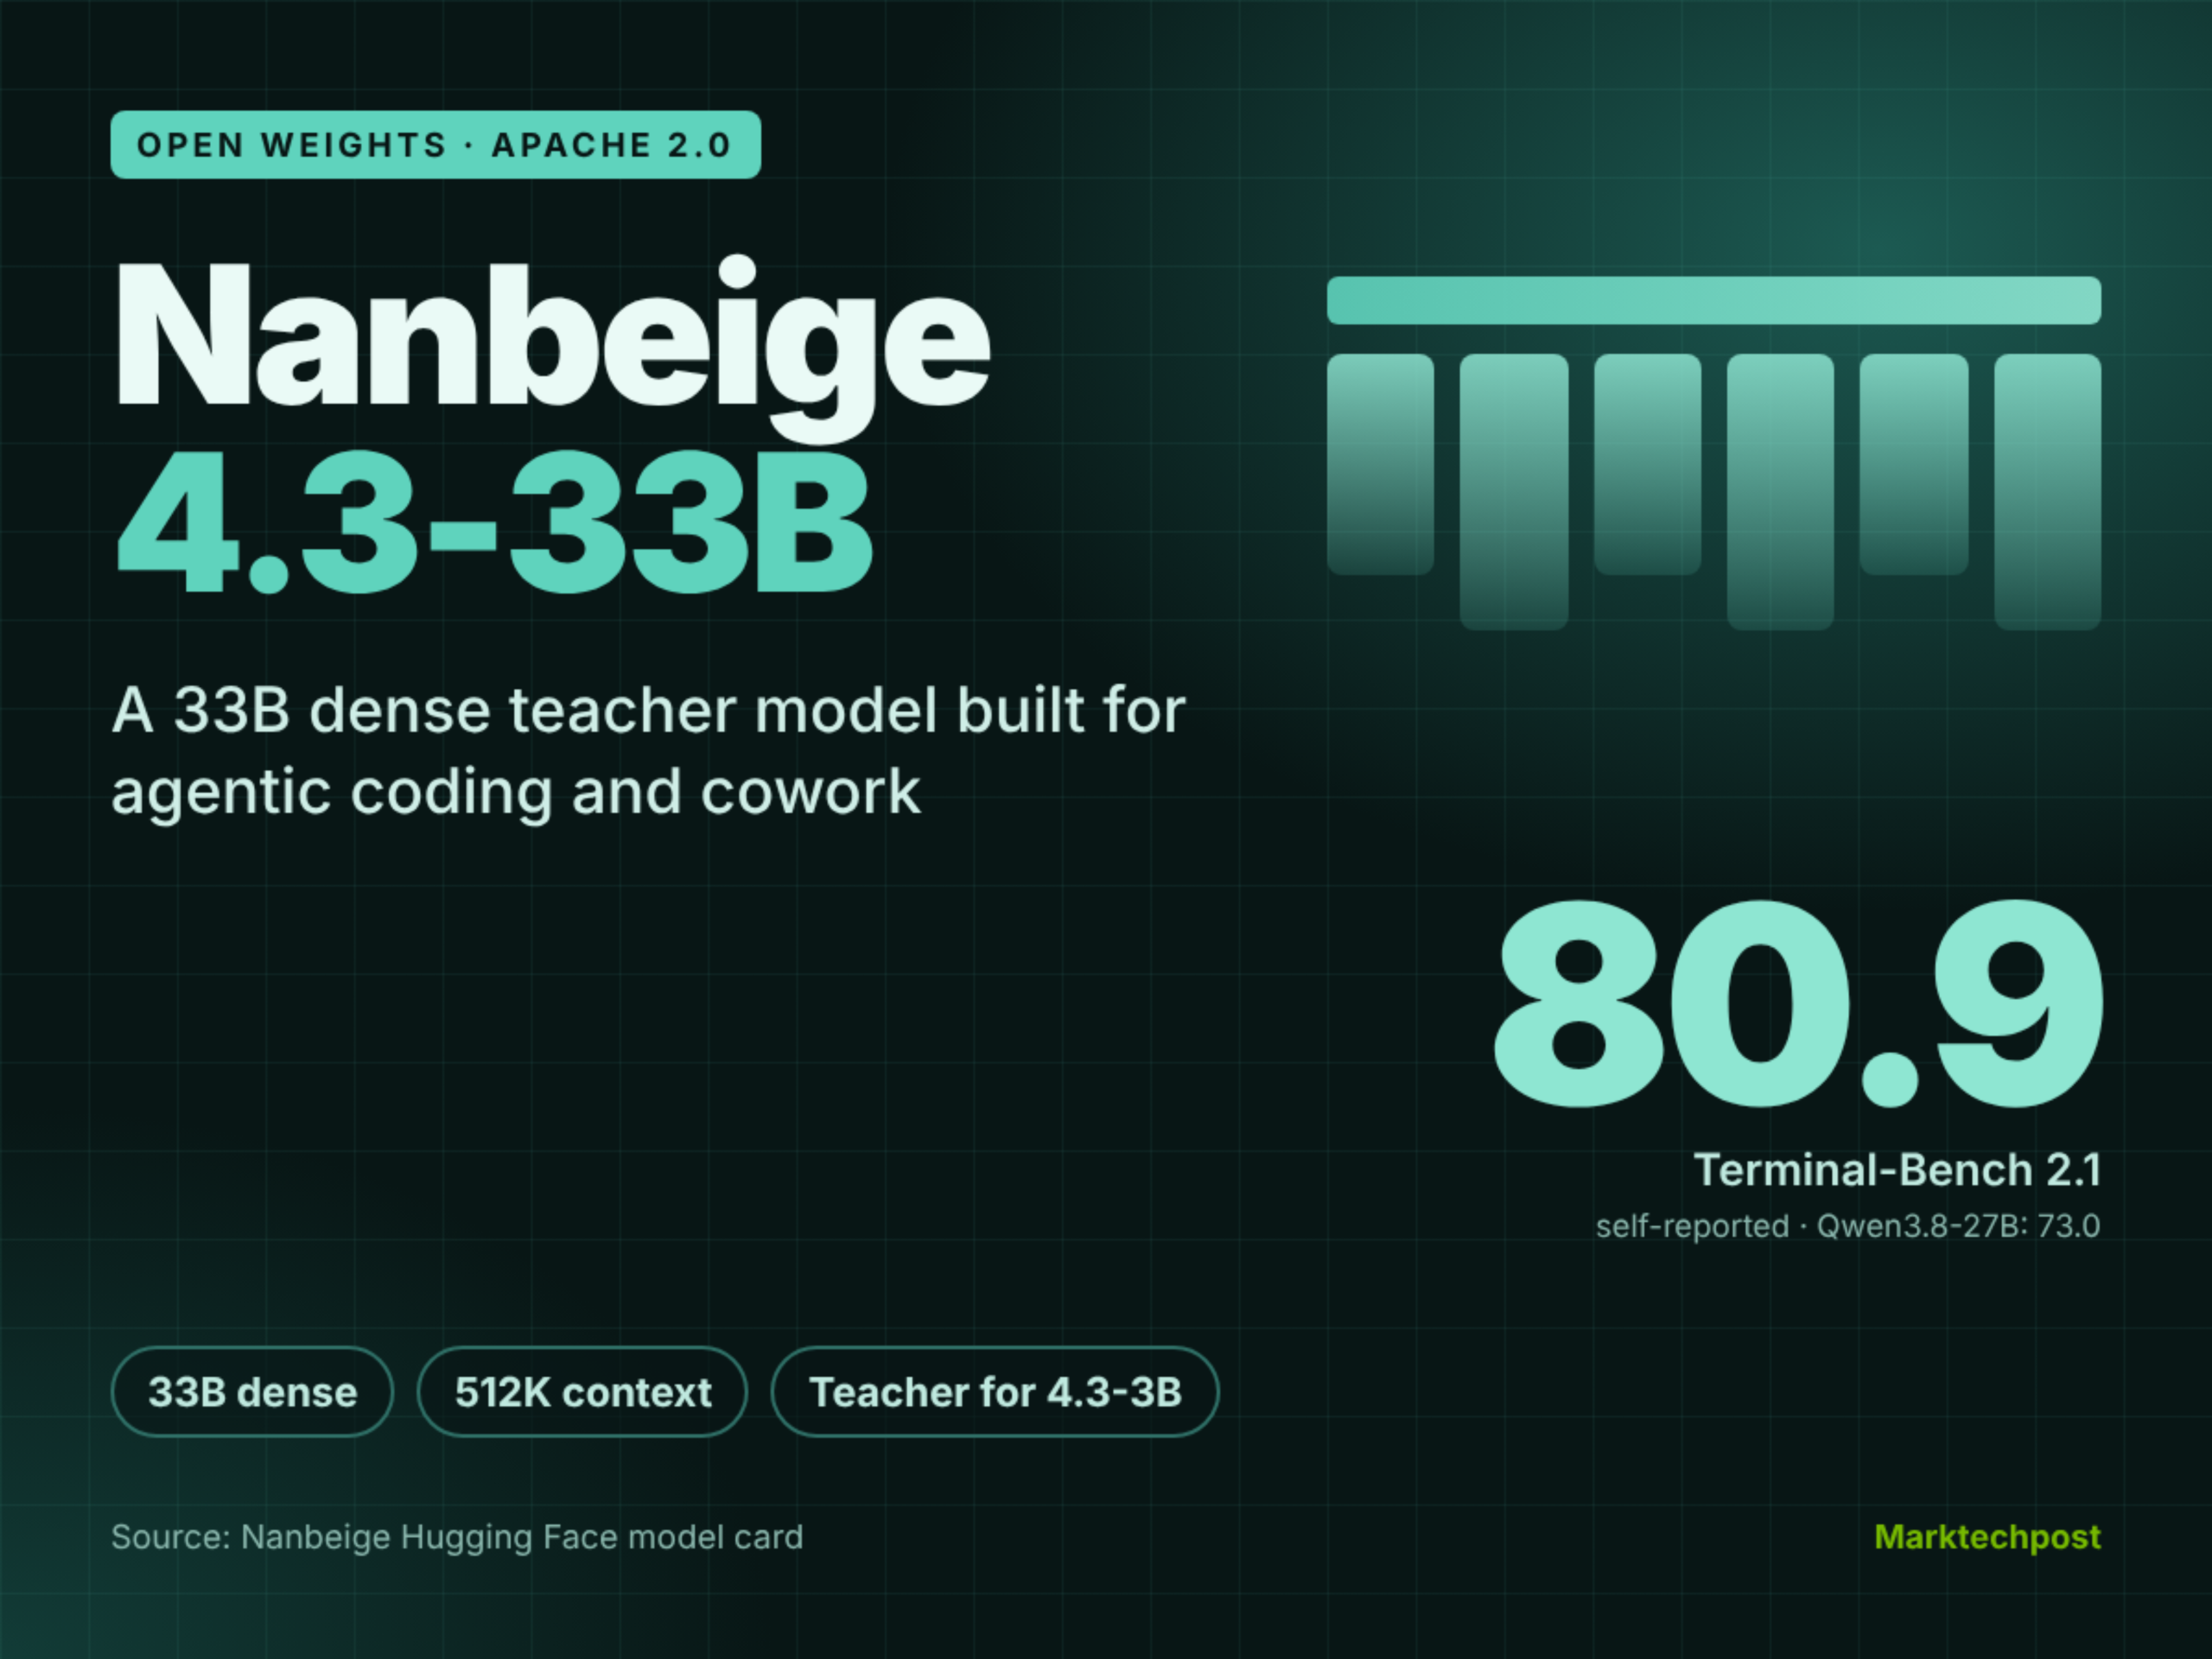
Nanbeige LLM 实验室发布了 Nanbeige4.3-33B,这是一款拥有 512K 上下文的 33B 参数密集型 Apache 2.0 模型。据称,该模型在 Terminal-Bench 2.1 上取得了 80.9 的成绩,并将用于训练即将推出的 Nanbeige4.3-3B。文章《Nanbeige 发布 Nanbeige4.3-33B,一款 33B 开放式智能体驱动编码模型》首发于 MarkTechPost。
arXiv:2610.30296v1 发布类型:新 摘要:大型语言模型(LLMs)加速了针对低资源和多语言自然语言处理的研究,但其在构建公平研究环境方面的有效性仍未得到充分评估。我们分析了2020年至2025年间发表的1,158篇同行评议的开放获取论文,考察了研究界对低资源语言(LRLs)的关注程度以及在不同语言和语种群体中的代表性。为超越单纯出版数量来评估语言包容性,我们提出了语言包容性框架(LIF),这是一个多维度框架,从四个维度衡量语言包容性:研究增长、代表性扩展、代表性延续以及分布公平性。尽管年度论文发表量从52篇增至415篇,增幅达5.4倍,但在ACL文集中……