
“跑高分”不等于“能交付”:AI排行榜正在经历一场信用重估
旧榜跑分逼近满分,新榜实战却集体不及格。当大模型评测本身变成生意,企业选型正从看排名转向算成本账。
检索标题、摘要与正文,把分散的信息连起来。
旧榜跑分逼近满分,新榜实战却集体不及格。当大模型评测本身变成生意,企业选型正从看排名转向算成本账。
硅谷下一轮洗牌,或许就从这里开始。
近几年来,DeepSeek、Kimi 等国产大模型凭借较低的调用成本和不断提升的模型性能,让大模型市场的价格竞争愈发激烈。如今,OpenAI、Anthropic 也相继下调模型价格,部分模型的降幅甚至达到 80%。大模型越来越便宜,背后究竟是怎样的市场逻辑?这场价格战还会持续多久,Token 的价格未来又会走向何方?曾任 BuzzFeed 高级数...
大的,终于来了。 10 月 26 日,Anthropic 向美国证监会公开递交了 S-1 招股书,准备在纳斯达克全球精选市场挂牌上市,股票代码定为 ANT。媒体报道中,这家公司的估值讨论区间已经来到了 1.5 万亿至 2 万亿美元,发行价区间尚未披露。 24 小时内,这本 300 多页的招股书已经被科技圈和金融圈翻了个底朝天,最抓眼球的几个数字大家都看过了:2026 年上半年营收 162.86 亿美元,去年同期只有 11.63 亿美元;第二季度交出 9.74 亿美元经营利润,迎来公司历史上首个经营盈利的季度;至于账面上高达 807 亿美元的净亏损,大头是 723.88 亿美元的可转债、衍生负债和 SAFE 公允价值变动,属于非现金的会计费用。 但在这些华尔街叙事之外,国内的开发者和日常使用者有着另一种割裂的体感。在中国大陆用户眼里,Claude 大概是目前市面上封号最多、风控最严苛、用起来最让人恼火的 AI 产品。 为什么一家做出顶尖大模型的公司,在面对普通个人用户时总是显得如此冷淡? 翻完招股书的财务附注和风险提示,答案其实就写在账本上。在 Anthropic 的商业版图里,个人用户贡献的真金白银占比非常小。 01 不到 20% 的个人用户 要看懂一家公司真正在乎谁,最直接的办法就是去翻它的收入构成表。在招股书的财报附注 2 里,Anthropic 把营收拆成了两大块,一块是按用量计费的收入,另一块是订阅收入。 数据对比非常悬殊。2025 年全年,按用量计费的收入是 37.96 亿美元,订阅收入只有 7.89 亿美元,比例大约是 83% 对 17%。到了 2026 年上半年,按用量计费的收入冲到 130.64 亿美元,订阅收入是 32.22 亿美元,前者依然占到 80% 左右,订阅收入只占约 20%。 更关键的细节藏在订阅收入的构成里。这 20% 里,既有个人用户的 Cl
招股书显示,2026年上半年,公司实现营收162.86亿美元,约为上年同期的14倍,营业亏损却从21.35亿美元收窄至6.93亿美元。
AI排行榜上的冠军会换,用户每天使用的产品却未必换。大模型的下一场竞争,不仅仅是谁的模型更强,而是把一次使用变成习惯。
dbt Wizard 的设计负责人和工程负责人展示了该代理在代码投入生产之前如何对其自身的工作进行验证。
Anthropic的S-1文件显示,其超过一半的年收入超过10万美元的客户如今同时使用Claude平台和自有应用程序,这一交叉销售策略让人联想到亚马逊的做法,正使企业客户黏性不断提升。
Nace AI 发布了 Drex for Search,将其 Drex 决策模型应用于 AI 智能体的文档搜索。Nace 在 BrowseComp-Plus 上取得了 92.05% 的成绩,仅需 12.6 次搜索调用,并且在 OfficeQA Pro 上实现了更少的智能体交互次数。该文章“Nace AI 为 AI 智能体发布 Drex for Search:在 BrowseComp-Plus 上取得 92.05% 成绩,仅需 12.6 次搜索调用”首发于 MarkTechPost。
如果说利润表令人震惊,那么资产负债表上的承诺才是真正的故事。
Ramp 通过将内部 AI 视作分析工程,共享了其构建的代理、沙盒和仪表板。
Verisk 将数十年的保险数据从大型机迁移至 dbt,实现了 AI 就绪。
DocuSign 将 Claude Code、dbt Agent Skills、dbt MCP 和 dbt v2 集成到一个工作流中,并测得生产力提升了50%。
Careem 的 AI 智能体在有人审查 PR 之前,就已端到端地编写并验证 dbt 模型。
一位数据科学家如何为组织知识构建了一个AI上下文层,而仅靠一个dbt项目是无法承载的。
本恩·斯坦西尔借助 Hugging Face 的这一技巧,阐释了为何最有用的创意往往源自最奇特的关联。
一个 AI 智能体利用 BI 层内的 dbt 血缘关系,在喝咖啡的工夫里就解开了三个数据谜团。
今天,我采访了记者兼新书《AGI编年史》的作者凯文·鲁斯。这本书详细记录了人工智能行业近期发生的剧烈变革。凯文曾长期担任《纽约时报》记者,并主持过热门播客节目“Hard Fork”,但他与节目好友凯西·牛顿刚刚离开了[…]


arXiv:2610.31810v1 发布类型:新 基本摘要:即使经过仔细校对的论文,其证明或所作假设中也可能存在细微漏洞。我们提出了 PaperFormalizer,一个基于 Lean 的智能体驱动流水线,帮助作者发现并弥补自身论文中的此类漏洞,并将每篇论文转化为经 Lean 验证的版本。PaperFormalizer 从 LaTeX 源文件入手,将其转换为陈述的依赖关系图,逐条审核自然语言表述的忠实性、歧义性和正确性,随后在 Lean 中对这些陈述进行形式化并加以证明,同时参考 Mathlib、可选的领域库以及作者个人的工具包。只有作者最清楚某条陈述的真实意图,以及如何最佳地填补某一结论中的形式化缺口。因此,该流水线会在必要时暂停,并向作者提出相关问题。

微软研究院于2026年10月25日开源Agensh,一种无需中央协调器的多代理运行时框架,支持1至1024个LLM编码代理在ProgramBench上自组织协作。系统基于Gitea、Mattermost和DeLM风格共享看板实现去中心化协调,所有代理运行同一提示驱动的五步循环,已在Linux+Docker环境下验证可扩展性。
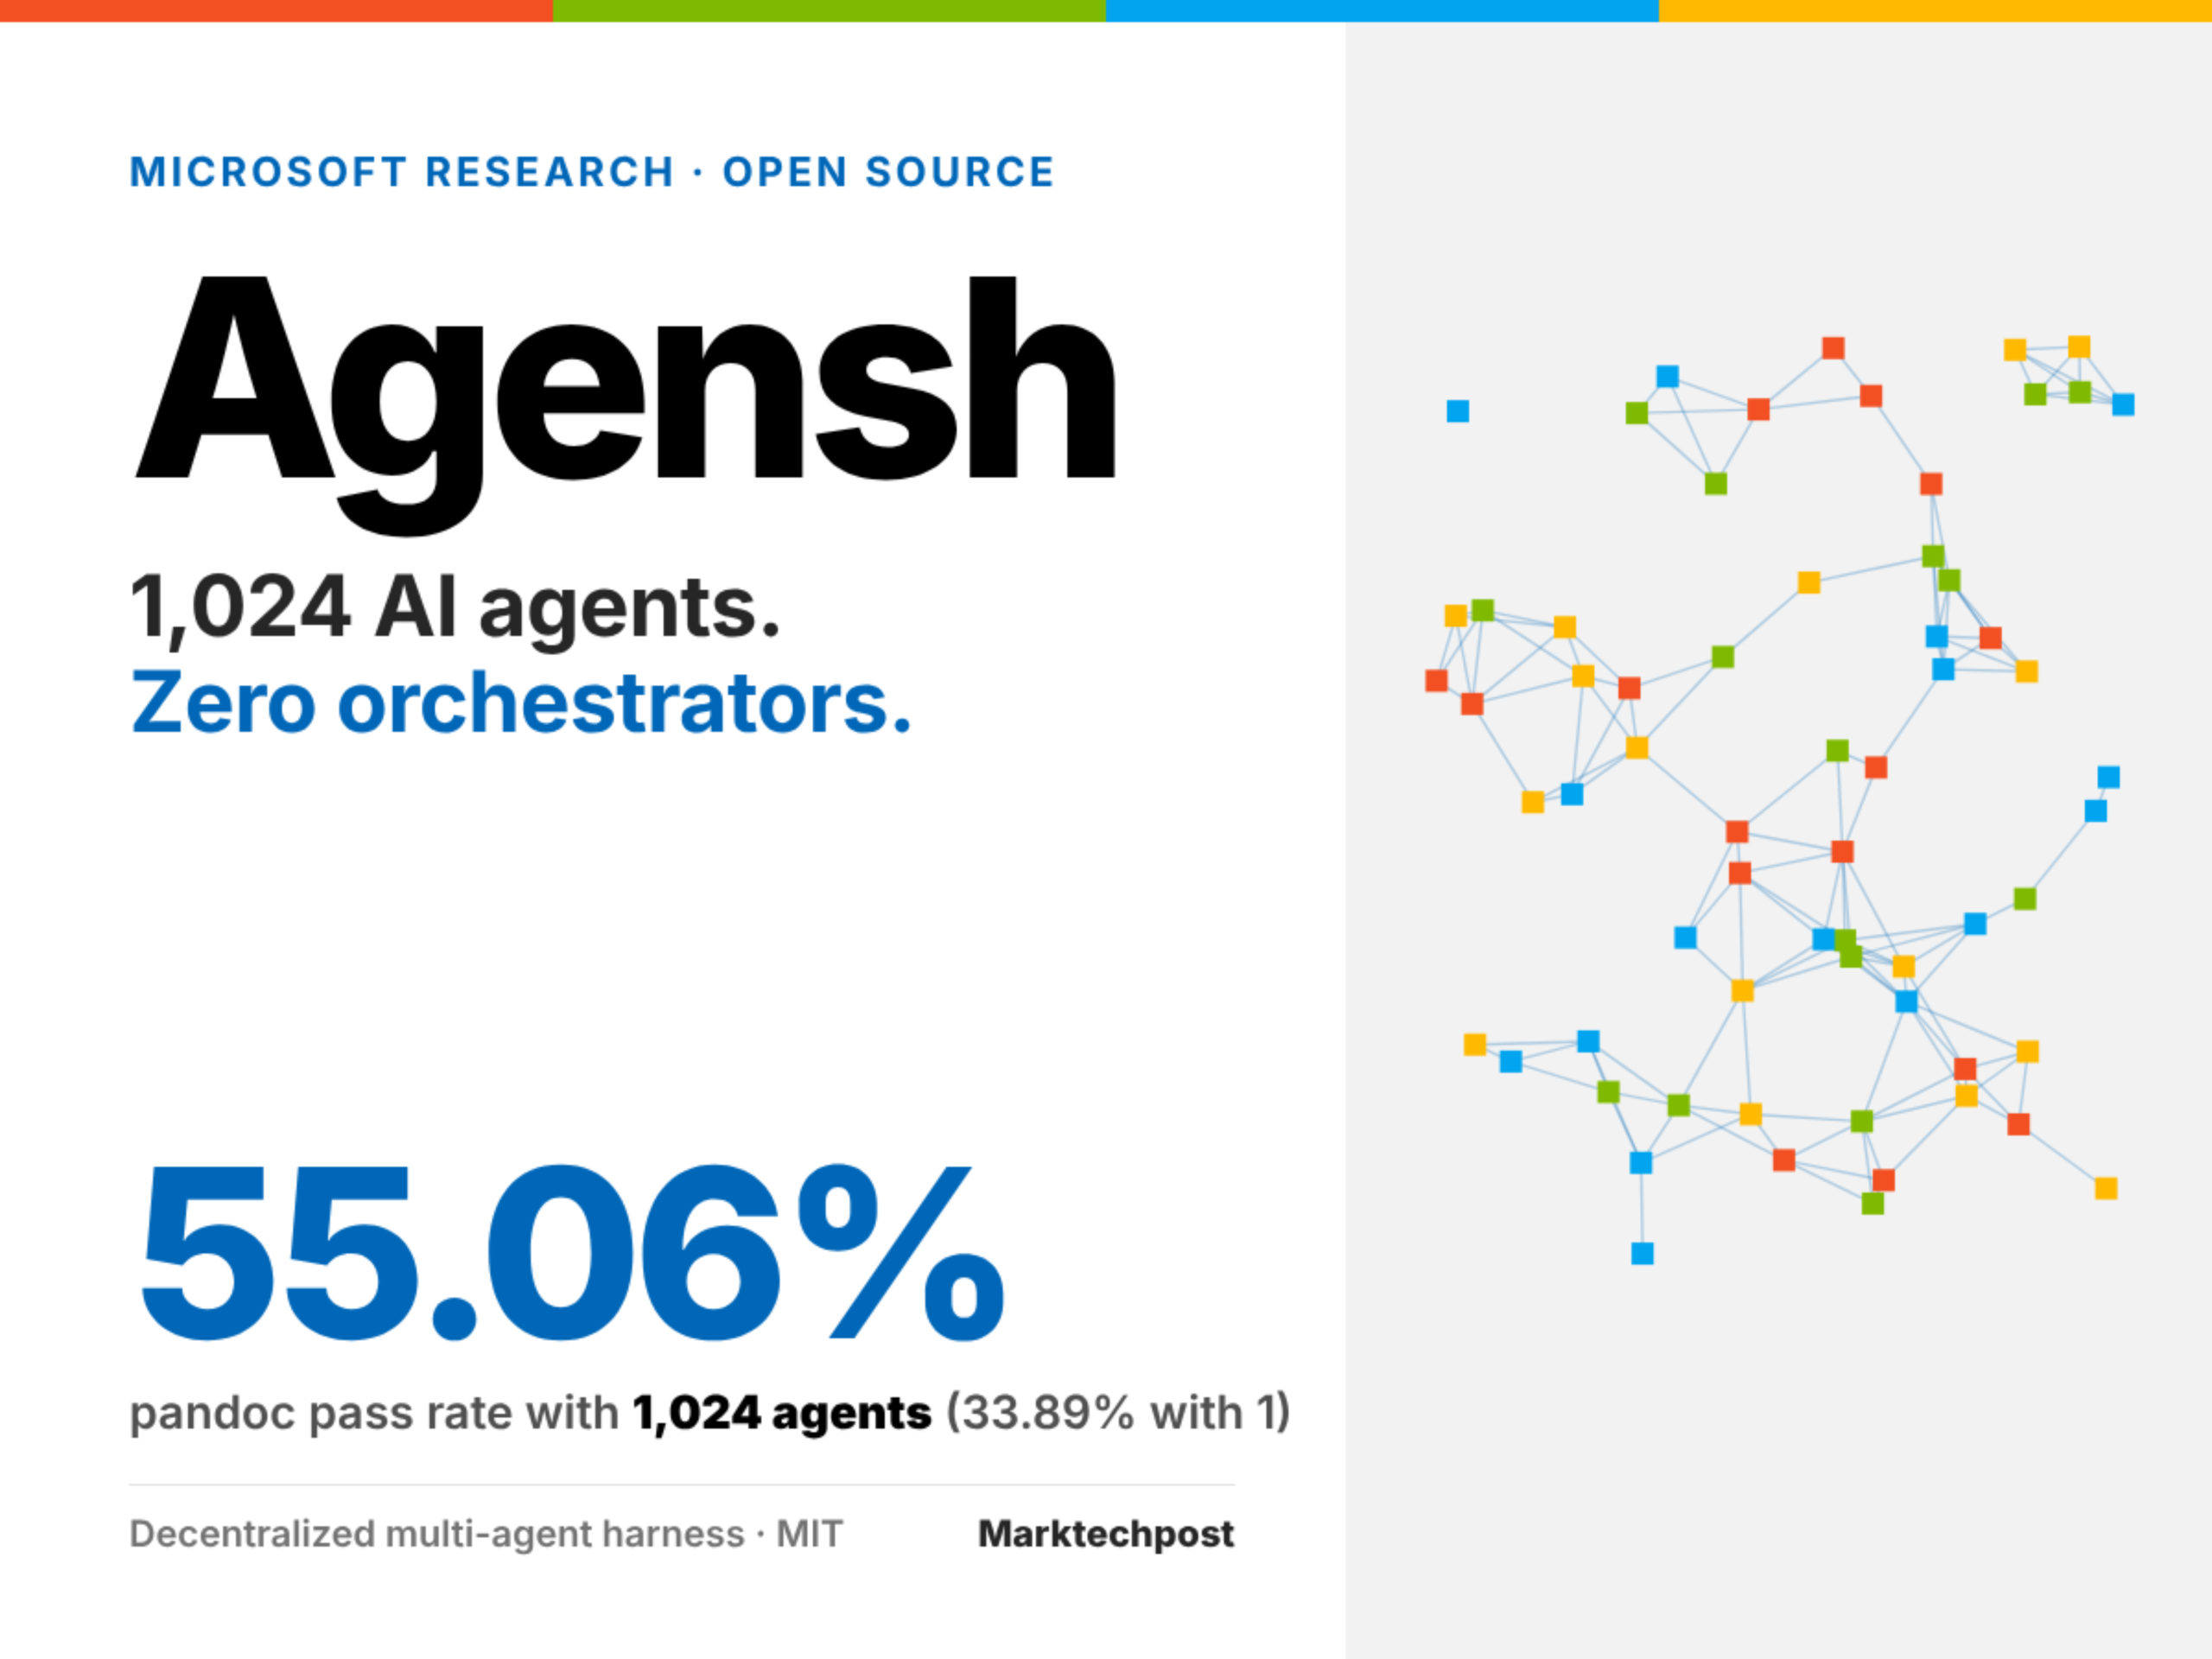
推荐理由:该成果代表多智能体系统架构的重要演进——摒弃传统‘主控代理’范式,通过提示工程与轻量服务组合实现大规模自组织;其在ProgramBench上的实证数据(如128代理使5任务均分提升49%)为分布式AI工程提供新基准;MIT许可证开源且兼容Copilot CLI等主流单代理工具,具备实际开发参考价值。