
본문으로 건너뛰기
AI NEWS JOURNAL
AI, IN PERSPECTIVE

오늘의 추천

원문 출처를 바탕으로 주목할 AI 변화를 이해합니다.

발행 시간순

징둥 광고는 화웨이 쿤펑과 협력해 생성형 광고 추론 지연을 15% 단축했으며, 618 대규모 프로모션에서 핵심 시나리오 검증을 완료했습니다.

징둥 광고는 화웨이 쿤펑과 협력하여 링취우 인터넷을 통해 300TB 규모의 공유 메모리 풀을 구축하고 RPC 통신을 재구성함으로써, 엔드투엔드 추론 지연 시간을 15% 단축하고 KV 캐시와 RPC 성능을 크게 향상시켰으며, 2026년 618 대규모 프로모션의 핵심 시나리오에서 5% 트래픽을 통해 검증을 완료했습니다. 또한 이 협력은 서치 및 추천 등 검색·추천 시나리오에 긍정적인 파급 효과를 가져왔으며, SuperCache, Agent 샌드박스 등 애지네틱 AI의 최첨단 분야에도 적극적으로 진출하고 있습니다.

추천 이유:이 보도는 2026년 10월 26일에 tmtpost.com에서 발표된 독창적인 기술 뉴스를 바탕으로 하며, 실제 적용된 기술 협업을 중점적으로 다룹니다. 협력 주체(징둥 광고/화웨이 쿤펑), 기술 경로(링취우 상호 연결, 이중 캐시, UB 프로토콜 직접 연결 URMA), 정량적 성과(지연 시간 15% 감소, TP99 최적화 85% 이상), 검증 시나리오(618 대규모 프로모션 트래픽의 5%), 그리고 발전 계획(SuperCache, Agent 샌드박스) 등이 명확히 공개됩니다. 모든 핵심 사실은 자료 내에서 상호 확인 가능하며, 외부 정보의 추가나 주관적 추론은 포함되지 않습니다.
진행 상황 및 관련 보도

칭화대학교와 홍콩중문대학교가 공동으로 오픈소스 AKV를 출시했습니다: LLM 에이전트를 위한 KV 캐시 엔지니어링 서비스 시스템

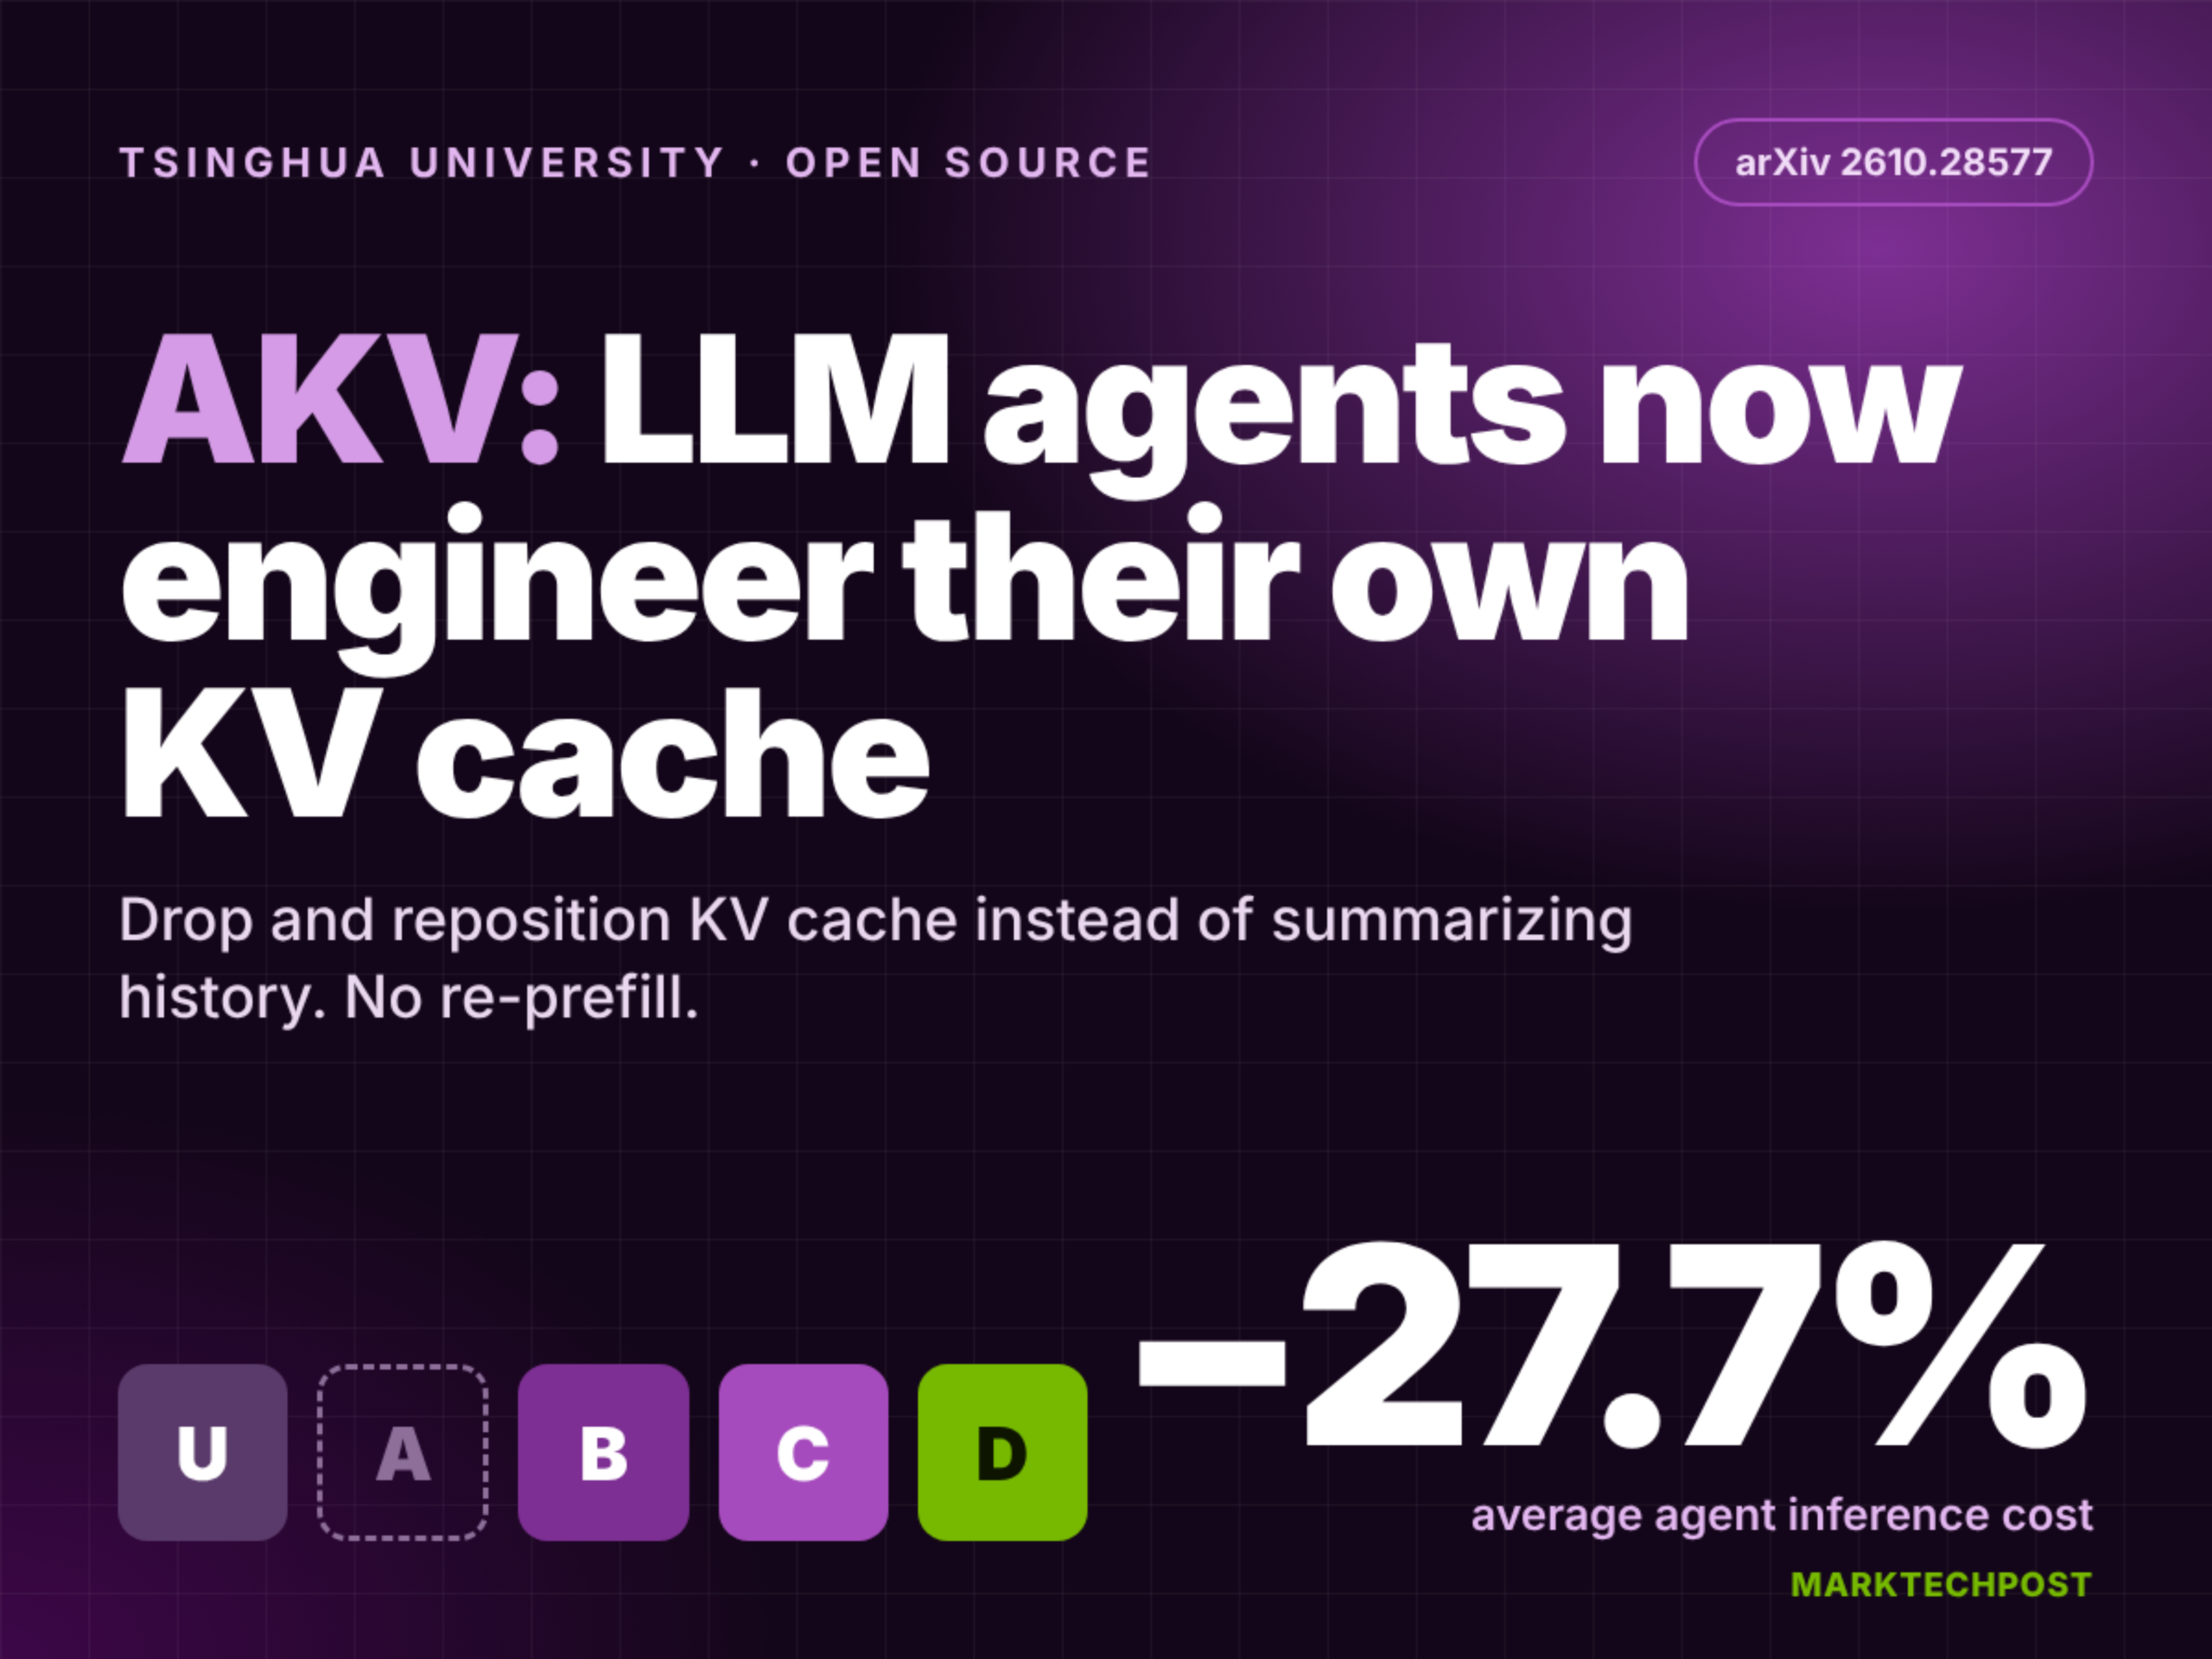
칭화대학교와 홍콩중문대학교의 연구진은 2026년 10월 26일, SGLang 기반으로 구축된 대규모 언어모델(LLM) 에이전트 전용 KV 캐시 엔지니어링 서버인 AKV를 오픈소스로 공개했습니다. 이 시스템은 기존의 텍스트 히스토리 요약 방식이 아닌, 에이전트가 스스로 KV 캐시를 적극적으로 버리고 재배치하도록 함으로써, 4개의 에이전트 벤치마크에서 추론 비용을 평균 27.7% 절감하고, 과제 평균 점수를 1.7점 상승시켰습니다. 해당 코드는 Apache-2.0 라이선스를 적용했으며, 현재 Qwen, GPT-OSS-120B, MiniMax-M2.7 등의 모델을 지원합니다.

Tsinghua AI Open-Sources AKV, a Cache Engineering Server for LLM Agents on SGLang

추천 이유:이 성과는 LLM 에이전트의 효율적 추론을 위한 새로운 패러다임을 제시합니다. 텍스트 절단이나 요약에 의존하는 ‘컨텍스트 엔지니어링’과 달리, AKV는 KV 캐시 상태를 직접 조작하여 중복 프리필을 방지함으로써 장거리 상호작용에서의 KV 부하를 크게 완화합니다. 실제 실험 결과, 높은 동시성 환경에서 P95 지연 시간이 229.9초에서 30.6초로 감소하여 명확한 엔지니어링 가치와 재현 가능성을 입증했습니다. 해당 정보는 MarkTechPost가 발표한 권위 있는 기술 보고서에 근거하며, 게시일시(2026-10-26T07:56:45Z)가 현재 시각과 일치해 최신 공개된 진행 상황임을 나타냅니다.

진행 상황 및 관련 보도