본문으로 건너뛰기
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI 뉴스 검색

제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.

발행 시간순

상하이종합지수 등 4개 지수의 구성 규칙이 오늘부터 조정된다; 국유자산감독관리위원회는 국유기업 개혁 심화를 추진한다; S&P의 새 규정은 3,750억 달러 규모의 펀드에 영향을 미칠 것이다.

2026년 10월 26일부터 상하이종합지수, 상하이A주지수, 상하이유통지수 및 과학혁신종합지수가 개정된 편제 방안을 정식으로 시행하며, 개별 구성 종목의 가중치 상한을 15%로 신설한다. 국무원 국유자산감독위원회는 10월 23일에 새로운 국유자산 및 국유기업 개혁 과제의 착실히 이행을 강조했다. 같은 날(10월 25일), S&P 다우존스는 성장주와 가치주의 구분 기준을 조정한다고 발표했으며, 새 규정은 12월 21일부터 발효되어 약 3,750억 달러 규모의 패시브형 펀드에 영향을 미칠 예정이다.

추천 이유:세 가지 정책과 시장 규칙의 변화는 모두 뚜렷한 시의성과 체계적 영향을 지닌다: 지수 가중치 상한선은 A주 시장의 핵심 벤치마크의 안정성과 직결되며, 국유자산감독위원회의 입장 표명은 중앙 차원에서 국유기업 개혁의 난관 돌파를 위한 긴박한 추진 의지를 보여준다. 또한 S&P의 규칙 재편은 가치투자의 논리를 재구성하며, 그 파급 규모가 수천억 달러에 이르러 글로벌 자본시장의 중요한 변수로 작용하고 있다. 모든 정보는 타이미디어가 2026년 10월 25일에 발표한 권위 있는 종합 보도에 근거하며, 시점, 주체, 조치 및 영향 규모 등이 명확히 검증 가능하다.

진행 상황 및 관련 보도

아폴로 수석 경제학자는 AI가 기술 산업 외의 미국 기업들에 대해 “재무적 수익이 전혀 없다”고 밝혔다.

아폴로 글로벌 매니지먼트의 수석 이코노미스트 토르스텐 슬록은 S&P 493(스탠더드 앤드 푸어스 500에서 7대 기술 대기업을 제외한 지수)을 분석한 결과, 비기술 기업의 이익 마진이 1인당 매출과 동등하며, AI가 생산성을 높였다는 증거는 없다고 밝혔다. 그는 AI가 책임성, 신뢰, 기업 문화 등 비즈니스의 핵심 요소에 대한 이해가 부족하기 때문에 아직 재무적 성과를 창출하지 못했다고 지적했다.

AI delivers ‘zero financial payoff’ to most companies, Apollo economist says

추천 이유:이 주장은 주요 상장 기업 그룹(S&P 493)에 대한 실증적 관찰에 근거하며, 명확한 데이터 범위와 제한 조건을 언급하고(Alphabet, Amazon 등 7개의 기술 기업은 제외), 최근 여러 연구의 결론과도 부합하여 검증 가능한 분석 틀과 명확한 인과관계의 경계를 갖추고 있다.

진행 상황 및 관련 보도

2026년 가장 주목받는 AI 웨어러블 기기 종합: Bee, Friend, Limitless 등 10여 종의 신제품이 한자리에 공개

테크크런치는 2026년 10월 25일, Bee, Friend, Limitless, Muse Charm, Nirva, Omi, Plaud NotePin, Rabbit R1, Stream 링 등 10여 종의 AI 웨어러블 기기를 종합한 리뷰를 발표하며, 가격, 기능 포지셔닝, 출시 상태 및 개인정보 관련 논란을 다뤘다.

The hottest AI wearables and gadgets you should know about

추천 이유:이 보도는 권위 있는 기술 매체인 TechCrunch가 2026년 10월 25일에 발표한 연례 신제품 종합 리뷰로, 현재 주요 AI 하드웨어 제조사와 스타트업을 포괄하며, 가격, 형태, 핵심 기능, 출시 일정, 논란 등 정보의 측면에서 완전성을 갖추고 있습니다. 또한 모든 진술은 자료에 명시된 사실에 근거한 것이며, 추측이나 확대 해석은 포함되지 않습니다.

진행 상황 및 관련 보도

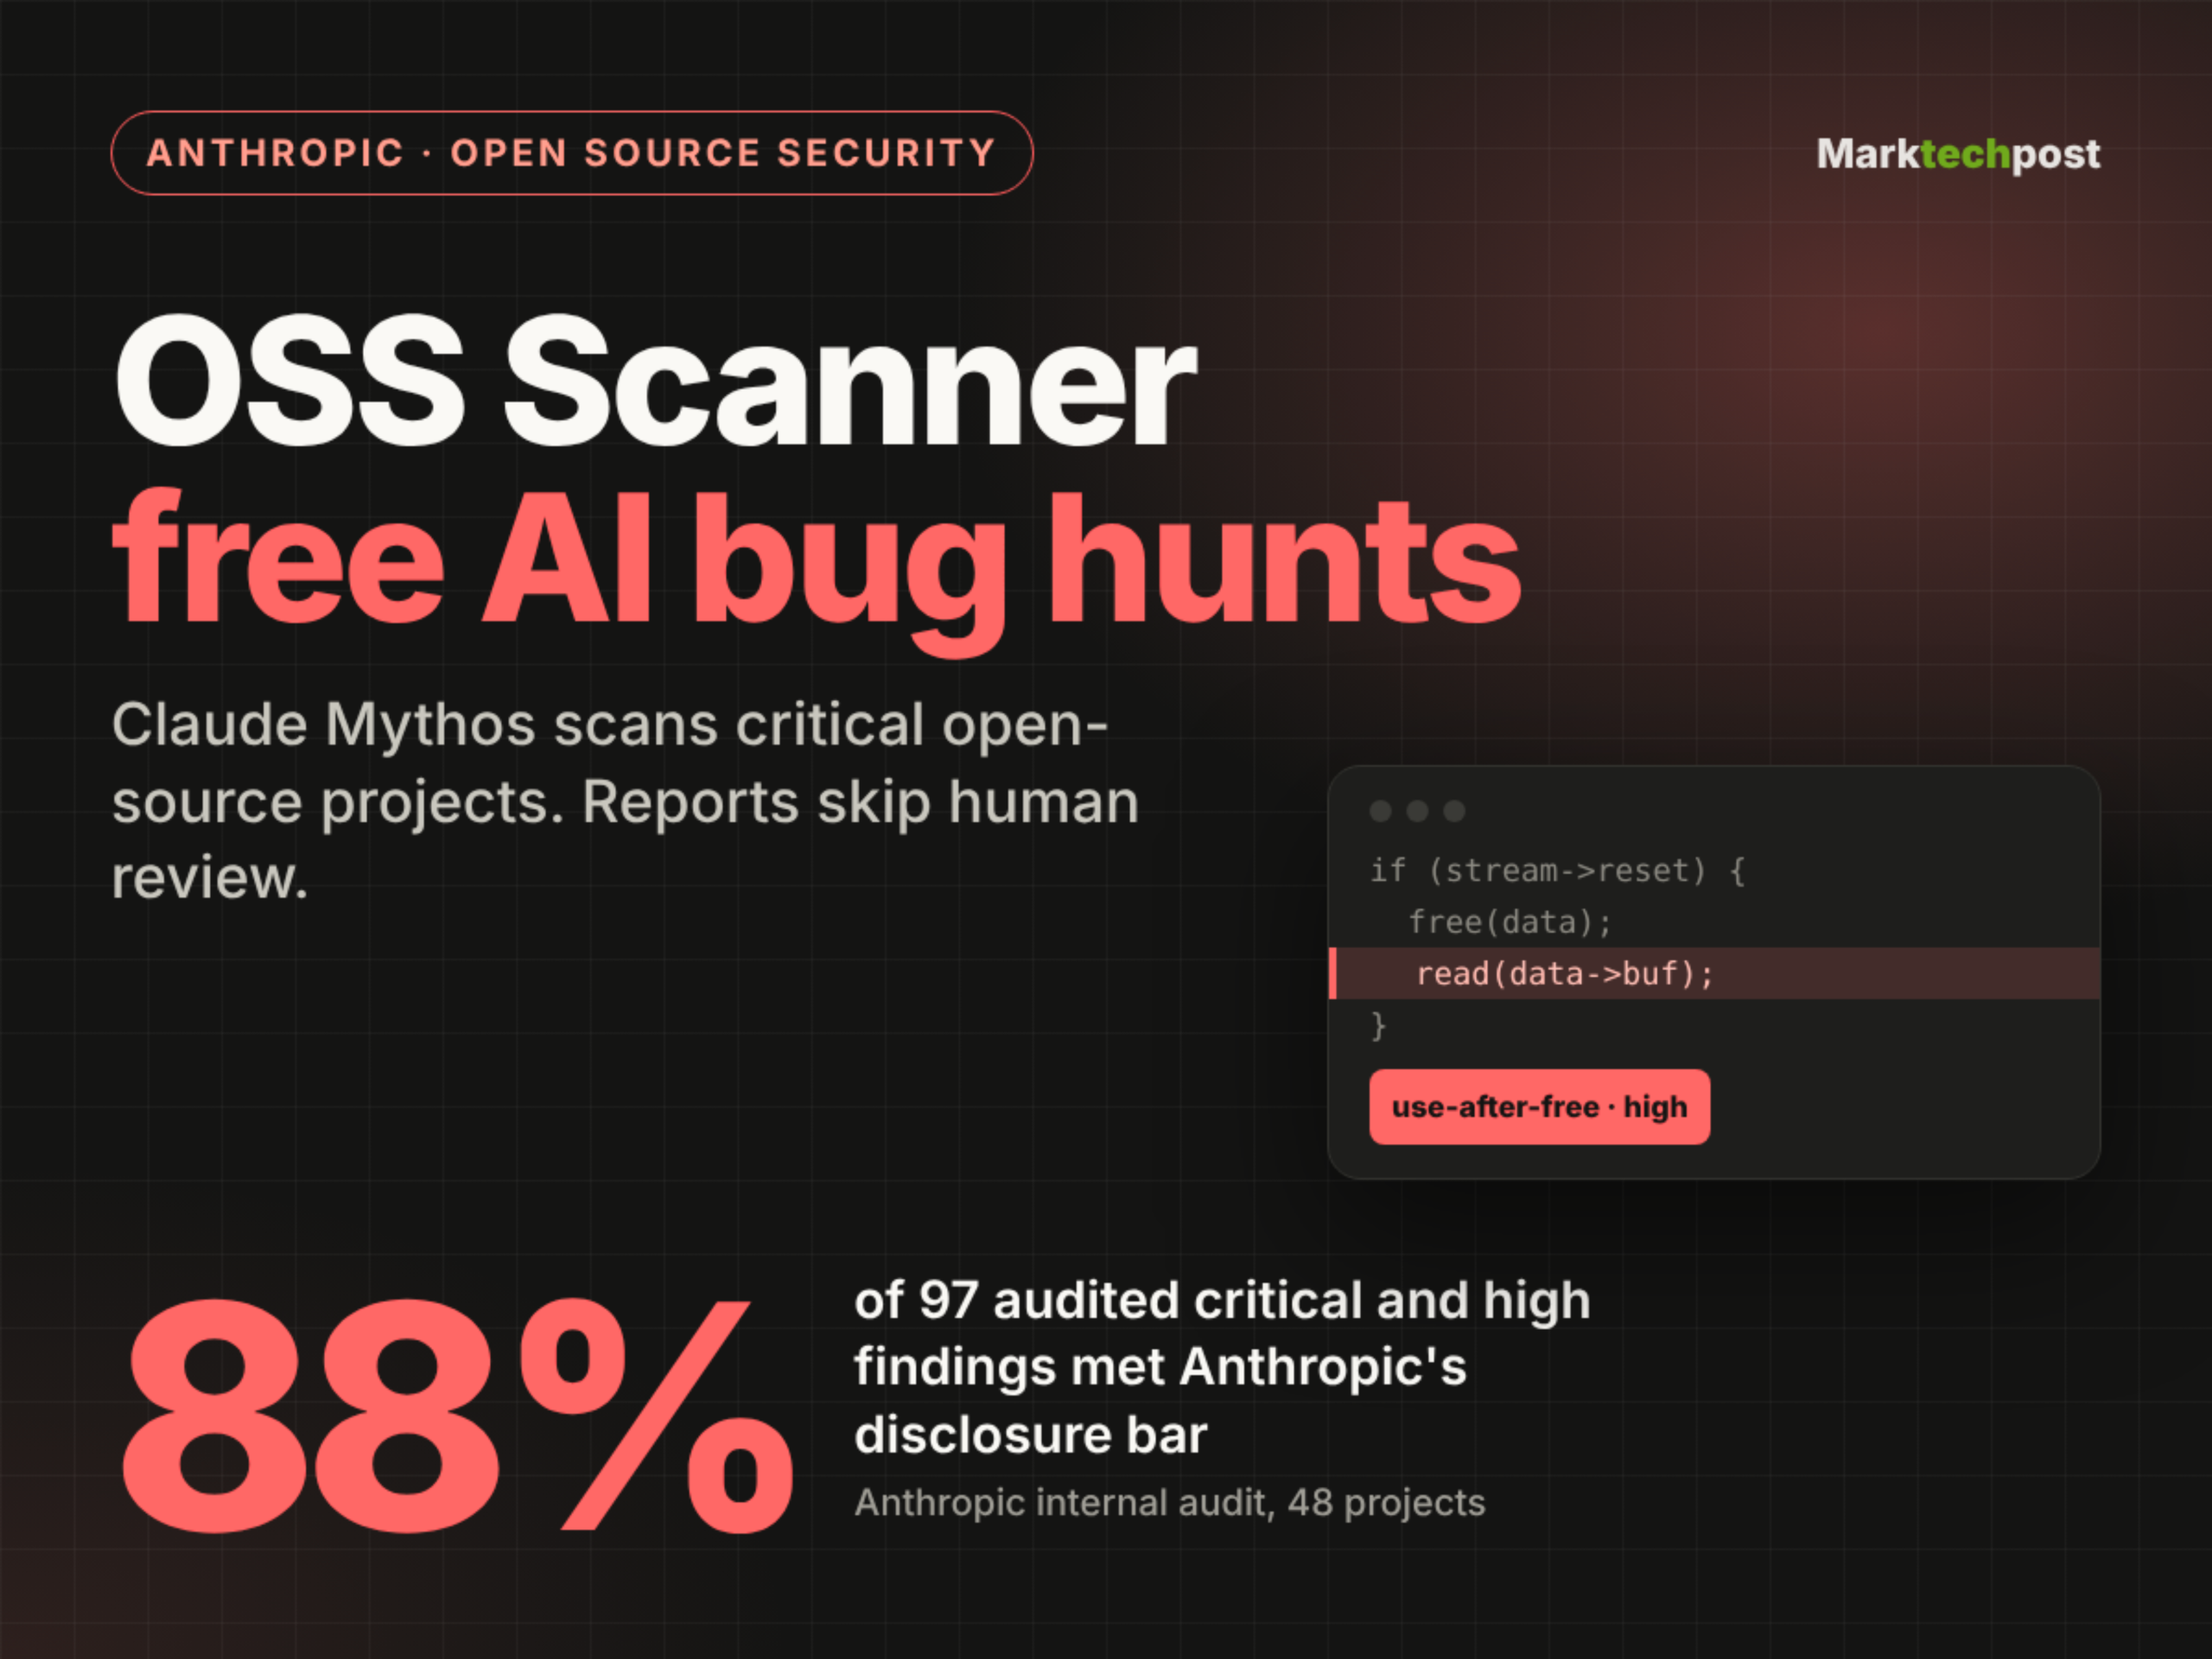
Anthropic이 주요 오픈소스 프로젝트를 대상으로 하는 무료 AI 취약점 스캐너 OSS Scanner를 출시했습니다.

Anthropic은 2026년 10월 8일, Claude Mythos 등 강력한 모델을 기반으로 한 무료이며 선택적 가입형 AI 취약점 스캐너인 OSS Scanner를 출시했으며, 이는 핵심 오픈소스 프로젝트를 위해 특별히 설계되었습니다. 10월 19일 현재, 총 114개의 프로젝트가 접수되었고, 11일 만에 심각 등급 취약점 77건과 고위험 등급 취약점 803건(모델 평가 기준)이 보고되었으며, 표본 검사 결과의 88%가 자사의 공개 기준을 충족했습니다.

Anthropic Launches OSS Scanner, a Free AI Vulnerability Scanner

추천 이유:이 도구는 오픈소스 보안 분야에서 LLM의 대규모 적용 사례를 대표하며, 무비용·전자동·오프라인 감사를 특징으로 하지만, 인력 검토 단계를 생략함으로써 오보와 중복 문제 발생 위험을 초래합니다. 그 정확도 데이터(유효율 88%, 거짓양성률 1%)와 실제 프로젝트 피드백(예: wolfSSL, curl)은 현재 AI 기반 취약점 탐지 능력에 대한 실증적 기준을 제공합니다.

진행 상황 및 관련 보도

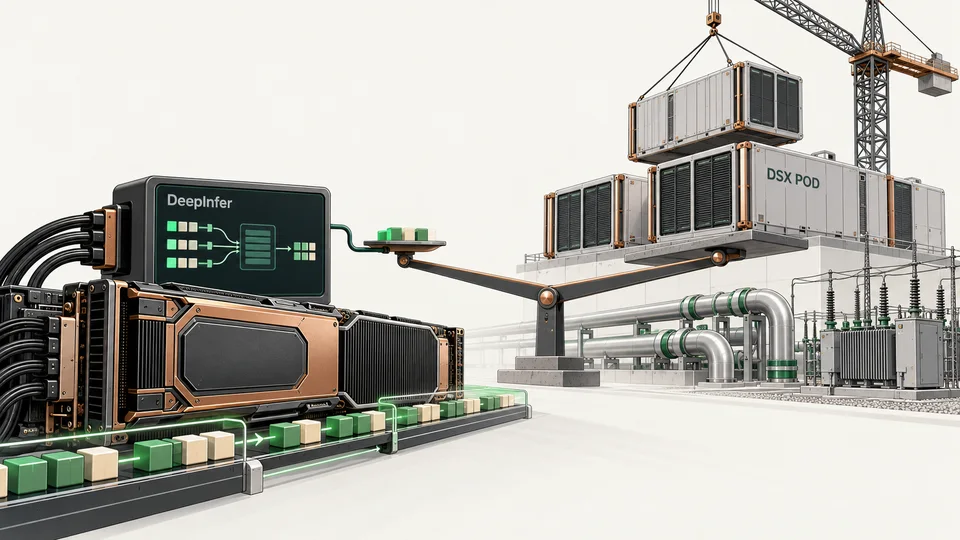
저가형 지능과 고가형 야망: DeepInfer, DSX POD 및 AI 투자 확대

제958호 《The Sequence Radar》는 추론 소프트웨어, 모듈형 AI 공장 및 기업용 AI 투자를 함께 살펴봅니다: 단일 추론 비용이 더 저렴하다고 해서 반드시 업계의 총투자 규모가 낮아지는 것은 아닙니다. 본 글은 원문을 그대로 정리했으며, DeepSeek와 엔비디아 공식 자료를 통해 기술 범위와 제공 조건을 보완했습니다.

推理软件效率与模块化AI基础设施投入的编辑示意,非实际产品照片
진행 상황 및 관련 보도

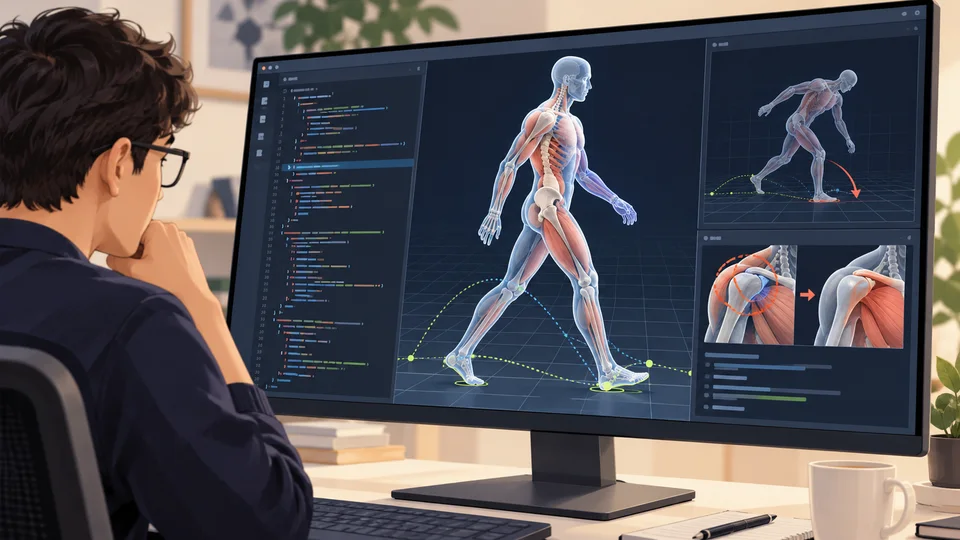
Kimi, K3.1 Pro 출시: 엔드포인트 작업 능력이 최고 수준으로 도약했으며, 시뮬레이션 디버깅과 다중 모달 프로그래밍을 통해 몸을 가진 지능의 초기 모습을 보여줍니다

Kimi는 2026년 10월 25일 K3.1 Pro 모델을 출시했으며, Terminal-Bench 4.0 터미널 작업 테스트에서 67.2%의 성공률로 1위를 차지했습니다. 또한 자체적으로 에뮬레이터 오류를 복구하고 물리 시뮬레이션, 오디오 분석, 3D 장면 구축 및 영상 편집 등 다중 작업을 수행하는 능력을 갖추고 있어, 신체 기반 지능 기술의 발전 경로를 탐구하고 있음을 보여줍니다.

根据报道中的虚拟人行走训练和模拟器调试制作的编辑示意,非软件实拍截图

추천 이유:본 자료는 티미디어의 공식 라이선스를 받아 발표된 실측 보고서를 기반으로 하며, Artificial Analysis, Terminal-Bench 4.0 등 권위 있는 제3자 평가 데이터와 공식 자체 테스트 결과, 그리고 필자의 다중 시나리오 기능 검증을 포괄합니다. 특히 K3.1 Pro의 실행 성능, 시뮬레이션 클로즈드 루프, 다중 모달 프로그래밍 분야에서의 실질적 진전에 초점을 맞추고 있으며, 동시에 Flash/Ultra가 아직 출시되지 않았다는 점 등 성능상의 한계와 미공개 정보를 명확히 표기하여 사실 확인과 출처 표기 요건을 준수하고 있습니다.

진행 상황 및 관련 보도

엔비디아를 앞세워 애플에 정면으로 맞서는, 마이크로소프트의 고급 AI PC 승부

마이크로소프트는 NVIDIA RTX 스파크를 탑재한 서피스 랩톱 울트라로 로컬 AI 개발자와 고급 크리에이터를 공략하고 있다. 하드웨어는 대용량 통합 메모리, CUDA 및 RTX 그래픽 성능을 휴대형 기기에 도입했지만, 맥과의 지속적인 경쟁을 이끌어낼 수 있을지는 여전히 애플리케이션 호환성, 인공지능 에이전트 경험, 실제 워크플로우에 달려 있다.

추천 이유:이 경쟁이 궁극적으로 답해야 할 질문은, 로컬 AI가 창작과 개발의 효율성을 실질적으로 향상시킬 수 있는지와, 이를 위해 사용자가 부담하는 하드웨어·소프트웨어 및 이전 비용이 과연 그만한 가치가 있는지 여부입니다. 하드웨어는 새로운 가능성을 제공하지만, 이러한 가능성이 얼마나 많은 사용자에게까지 확장될 수 있는지는 생태계와 실제 사용 경험에 달려 있습니다.

진행 상황 및 관련 보도

세바스티안 라슈카가 8개의 비디오 강좌 ‘제로부터 추론 모델 구축하기’를 발표했습니다.

세바스티안 라슈카는 2026년 10월 24일, Ahead of AI 매거진(magazine.sebastianraschka.com)에서 총 8강으로 구성된 11시간이 넘는 파이썬 및 파이토치 실습 동영상 강좌를 공개했으며, 추론 모델의 평가, 추론 시 확장, 강화학습(RLVR)과 지식 증류를 체계적으로 다루고, 모든 방법을 사전 훈련된 Qwen3-0.6B 모델을 기반으로 구현했습니다.

추천 이유:이 강좌는 저자가 ‘0부터 구축하는 대규모 언어 모델’에 이어 선보이는 심화 기술 교육 콘텐츠로, 현재 주류 LLM의 핵심 발전 방향인 추론 능력 강화에 초점을 맞추고 있습니다. 기초 환경 구축부터 GRPO 강화학습, 자기 증류 등까지 포괄하는 완전한 기술 체인을 다루며, 모든 구현은 ‘0부터 수작업으로 작성’되어 재현 가능하다는 점을 명시하고 있어 높은 교육적 가치와 엔지니어링 참고 가치를 갖습니다.

진행 상황 및 관련 보도

TRIAD 발표: 전모달 모호성 해소를 위한 최초의 다중모달 대규모 모델 평가 벤치마크

2026년 10월 24일, 연구자들은 arXiv에 논문 arXiv:2610.30841v1을 발표하여, 텍스트·이미지·오디오의 삼모달 협력적 모호성 해소 능력을 평가하기 위한 새로운 벤치마크인 TRIAD를 공식적으로 출시했습니다. 이 벤치마크는 327개의 수작업으로 구성된 삼모달 샘플을 포함하며, 86개의 시나리오 그룹과 18종의 교차모달 모호성 유형을 포괄합니다.

TRIAD: Benchmarking Omni-Modal Ambiguity in Multimodal Large Language Models

추천 이유:이 성과는 현재 다중모달 대규모 모델 평가의 핵심적 맹점을 정면으로 지적한다. 기존 벤치마크는 대부분 단일한 확정적 입력에 초점을 맞추어 인지 또는 추론을 평가해 왔으나, TRIAD는 최초로 ‘모달 상호보완에 의한 오류 해소’를 평가 목표로 체계적으로 접근했다. 엄격히 설계된 ‘남은 하나의 모달’ 반사실 시험을 통해, 특히 음성 데이터에 대한 모델의 활용 부족과 장면 수준에서의 취약한 로버스트성 등 핵심적인 결함을 드러내며, 차세대 전모달 모델 평가를 위한 재현 가능한 진단 프로토콜과 분류법을 제공한다.

진행 상황 및 관련 보도

연구는 대규모 언어 모델에서 다문화적 가치 선택 편향을 밝혀냈다: 국가와 언어 단서는 서로 교환할 수 없다

2026년 10월 24일 arXiv 플랫폼에 게재된 연구(번호 2610.31199v1)는, 대형 언어 모델(LLMs)이 국가 정체성(시스템 프롬프트 설정)과 두 번째 문화적 단서(명시적으로 국가를 명명하거나 암묵적으로 해당 언어를 사용하는 경우)를 동시에 수신할 때, 두 유형의 단서가 가치 판단에 미치는 영향이 현저히 다르다는 점을 밝혀냈다. 언어 단서는 더 강력하지만 방향이 반대인 편향을 유발하는 반면, 명시적인 국가 명명은 그 영향이 상대적으로 약하더라도 보다 분화되고 목표 국가의 가치관에 더욱 부합하는 가치 변화를 초래한다.

Investigating Multi-Cultural Value Selection Biases in LLMs

추천 이유:이 연구는 160만 건의 개방형 생성 응답과 World Values Survey(WVS) 표준화 검사를 바탕으로, 문화 모델링에서 명시적 국가 라벨과 암묵적 언어 단서의 역할을 최초로 체계적으로 구분하며, 현재 이 두 요소를 동일하게 취급하는 방식이 LLM의 문화 적응 능력에 대한 평가를 왜곡할 수 있음을 지적합니다. 연구 결과는 방법론적 함의를 제공하며, 발표 시점이 현재 날짜(2026-10-26)보다 앞서 있어 유효한 새로운 지식으로 간주됩니다.

진행 상황 및 관련 보도

연구는 방글라데시어 온라인 괴롭힘에 대한 본체 기반 행동 분석 프레임워크 ODCBNA를 제안한다.

이 논문은 2026년 10월 24일 arXiv에 게재되었으며(번호 2610.30885v1), 가해자 중심의 분석 프레임워크인 ODCBNA를 제안한다. 이 프레임워크는 온톨로지 설계, 지식 그래프 구축, 행동 모델링, 커뮤니티 분석 및 영향력 모델링을 통합하며, 방글라데시어 사이버불링 코퍼스인 BenCoDiC를 기반으로 실증 분석을 수행하였다.

From Perpetrators' Digital Footprints to Behavioral Communities: An Ontology-Driven Framework for Bengali Cyberbullying Analysis--- FULL VERSION

추천 이유:자료는 arXiv 사전인쇄본으로, 게시일(2026-10-24)이 현재 시점(2026-10-26)보다 늦지 않으며, 출처가 명확하고 구조가 완비되어 있습니다. 내용은 방법론적 혁신과 재현 가능한 분석 결과(예: 가해자 1,063명 식별, Louvain 커뮤니티 6개, 특성 기여도 순위 등)에 중점을 두고 있어, 학술 정보의 시의성과 사실성 요건을 충족합니다.

진행 상황 및 관련 보도

연구에 따르면 보상 모델 점수에는 유의미한 힌트 의존성이 존재하며, 쌍으로 이루어진 평가는 이러한 편향을 탐지할 수 없다는 사실이 밝혀졌다.

2026년 10월 24일 arXiv에 게재된 한 AI 연구 논문은, 현재 주류를 이루는 쌍방향(pairwise) 평가 방법이 동일한 프롬프트 하에서 모든 응답에 공통적으로 존재하는 점수 구성 요소를 자동으로 상쇄하여, 보상 모델에서 핵심적인 ‘프롬프트 수준의 편향’이 검증되지 않았다고 지적한다. 저자들은 인간 평가를 기준으로 삼아 이미 발표된 18개의 평가기를 대상으로 감사를 실시한 결과, HelpSteer2 데이터셋에서 6개 모델의 점수 분산 중 최대 34%~64%가 프롬프트 자체에 기인하며, 반면 인간 평가는 이러한 현상이 거의 나타나지 않는다는 사실을 발견했다.

What Pairwise Evaluation Misses: Reward Scores across Prompts

추천 이유:이 연구는 대규모 언어 모델의 정렬 과정에서 오랫동안 간과되어 온 근본적인 결함을 지적한다—보상 모델의 점수가 응답의 품질 자체가 아니라 프롬프트 텍스트에 크게 의존한다는 점이다. 또한 해당 연구의 방법론(인간 기준 감사, 프롬프트 교체, 분산 분해)은 재현 가능하며, 그 결론은 실증적 분석에 기반하고 여러 주요 오픈소스 평가 도구를 포괄하므로, 선호도 최적화, RLHF 및 안전성 평가 실무에 대한 직접적인 시사점을 제공한다.

진행 상황 및 관련 보도

도구 강화형 언어 모델의 프롬프트 민감성 연구: 도구는 정확도를 향상시키지만 표현 차이의 영향을 심화시킨다

2026년 10월 24일 arXiv 플랫폼에 게재된 연구(번호 2610.31148v1)는 도구 강화 환경 하에서 여섯 가지 오픈소스 언어 모델이 다섯 가지 분야와 다섯 가지 질문 표현 방식에 대해 비교한 결과, 대비 안정성이 향상되지 않았음을 지적했다. 오히려 도구가 프로그램이 답변할 수 있는 문제의 정확도를 높였음에도 불구하고, 문구의 차이에 따른 모델 순위 변동의 민감성은 확대되었다.

Prompt Sensitivity in Tool-Augmented Model Comparisons

추천 이유:이 연구는 새롭게 설계된 매칭 프로토콜을 활용하여, 도구 호출 전 과정의 핵심 단계들(예: 호출 결정, 도구 응답, 무호출 보고 등)을 분리함으로써, ‘정확도 향상’이 반드시 ‘보다 안정적인 비교’를 의미하지 않음을 실증적으로 규명하고, 인터페이스 설계와 명령어 세부사항이 민감도 수준을 유의미하게 조절함을 지적함으로써 모델 평가 실무에 직접적인 지침 가치를 제공한다.

진행 상황 및 관련 보도

인도네시아 임상 영양 Q&A 기준인 IndoNutriQA가 공식 출시되었습니다.

2026년 10월 24일, 연구팀은 arXiv에 논문(번호 2610.31256v1)을 발표하며 인도네시아어 임상 영양 분야를 위한 최초의 전문가 주석 기반 질문응답 평가 벤치마크인 IndoNutriQA를 공개했습니다. 이 벤치마크는 실제 임상 보고서에서 도출된 911쌍의 질문-응답 쌍을 포함하며, 학습이 아닌 평가에 중점을 두고 있으며 생성형, 추출형 및 검색 강화형 질문응답 과제를 지원합니다.

IndoNutriQA: An Indonesian Clinical Nutrition Question Answering Benchmark

추천 이유:이 벤치마크는 저자원 언어(특히 인도네시아어)를 대상으로 한 임상 영양 NLP 분야의 고품질 공개 평가 데이터 부족이라는 공백을 메우며, 구조화된 메타데이터가 완비되고 질문 유형이 영양 간호 프로세스(NCP)를 엄격히 준수하며, 전문가 검증과 다중 모델 벤치마크를 완료하여 명확한 연구적 정위와 방법론적 엄밀성을 갖추고 있습니다.

진행 상황 및 관련 보도

새로운 연구는 추론 시 문맥 증강 방법의 효과에 의문을 제기하며, 정확도 향상이 우연한 변동일 수 있다고 밝혔다.

2026년 10월 24일 arXiv에 게재된 AI 연구 논문(번호 2610.30983v1)은 다섯 가지 추론 시 컨텍스트 증강 방법을 체계적으로 평가한 결과, 보고된 정확도 향상이 실제 능력의 증진을 반영하는 것이 아니라 방향성 없는 왜곡에 기인할 수 있으며, 이는 일부 예측을 수정하는 동시에 다른 예측을 손상시키는 현상으로 나타날 수 있음을 밝혀냈다.

A Reality Check of Inference-Time Context Augmentation Methods

추천 이유:이 논문은 최초로 방법, 모델, 데이터셋을 아우르는 통합 평가 프레임워크를 구축하며, 성능 향상에만 의존하면 신뢰성의 결함이 은폐되기 쉽다는 점을 지적합니다. 특히, 새로운 정보를 도입하지 않는 filler-token 방식은 결정 경계 근처의 예측에 주로 영향을 미치므로 실제 배포에는 직접 적용하기에 적합하지 않음을 경고합니다.

진행 상황 및 관련 보도

새로운 연구는 언어 간 빈 자극(CPOS) 실험 패러다임을 제안하여, 언어 모델의 계층적 일반화 능력의 조건부 이전을 규명하였다.

2026년 10월 24일, arXiv는 논문 2610.30960v1을 발표하여, 언어 모델이 다국어 지속 학습 과정에서 원본 언어(L1)의 계층적 구조에 대한 증거를 대상 언어(L2)로 이전하는 능력을 정량화하기 위한 다국어 빈 자극(CPOS) 실험 설계를 제안했다. 실험 결과에 따르면 이러한 이전은 부분적으로 성립하지만 완벽하지 않으며, 특히 언어 쌍과 어휘 중복 정도에 크게 의존하는 것으로 나타났다.

Once a Tree, Always a Tree? Cross-lingual Transfer of Hierarchical Generalization in Language Models

추천 이유:이 연구는 최초로 제어 가능한 다국어 저자극 프레임워크를 구축하여, ‘언어의 보편적 구조’가 비언어적 요인(예: 위치 인코딩 초기화)에 의해만 유도되는 것이 아니라 다국어 간 전이의 인지적 기반이 되는지를 직접 검증하였다. 이와 같은 결론은 대규모 언어 모델의 문법 습득 메커니즘과 다국어 정렬 전략을 이해하는 데 있어 방법론적·이론적 측면에서 모두 중요한 가치를 지닌다.

진행 상황 및 관련 보도

81개 언어의 개념 구조 비교 연구는 언어 상대성과 보편성의 얽힌 패턴을 밝혀낸다

2026년 10월 24일 arXiv 플랫폼에 게재된 연구(번호 2610.30778v1)는 두 개의 다국어 단어 벡터 모델을 활용해 81개 언어에서 196개의 기본 개념 간의 의미 관계를 분석한 결과, 사회문화 관련 개념의 언어 간 대응성이 자연 및 운동 관련 개념보다 유의미하게 높으며, 이러한 차이는 서로 다른 모델과 분류 방법에서도 일관되게 재현됨을 밝혔다. 또한 사회문화 영역에서는 지리적 거리가 멀고 언어 간 친연성이 낮을수록 개념 간 관계의 차이가 더 커지는 것으로 나타났다.

Where meanings converge and diverge: Revisiting linguistic relativity across 81 languages

추천 이유:이 연구는 대규모 다국어 계산적 의미 분석에 기반하여 언어 상대성(사피르-워프 가설)에 대한 새로운 실증적 근거를 제시한다. 즉, 강한 결정론도 완전한 보편주의도 지지하지 않으며, 오히려 두 이론이 서로 다른 의미 영역에서 역동적으로 공존함을 밝혀낸다. 연구 결과는 모형의 안정성과 범분류적 일관성을 보이며, 사용된 워드 임베딩 모델이 표현하는 언어 구조에 한정되어 있을 뿐, 인지적 행동이나 신경 메커니즘으로까지 일반화되지는 않는다.

진행 상황 및 관련 보도

네팔어-영어 혼합 음성 인식의 새로운 벤치마크와 합성에서 실제 데이터로의 이중 단계 적응 프레임워크를 발표했습니다.

연구자는 2026년 10월 24일 arXiv에 논문(번호 2610.30860v1)을 발표하여, 자발적 팟캐스트 환경을 위한 네팔어–영어 코드 스위칭 ASR 벤치마크를 최초로 제안했다. 이 벤치마크는 실제 발화 13,044건(15.45시간 분량)을 포함하며, 합성 음성에서 실제 음성으로 전환하는 두 단계의 적응 방법을 설계했다: 먼저 0.95시간 분량의 다중 화자 TTS 합성 음성을 활용한 감독 미세조정을 수행하고, 이후 스크립트 기반 보상을 도입한 그룹 상대적 정책 최적화(GRPO)를 적용한다.

Synthetic-to-Real Code-Switched ASR: A Spontaneous Nepali-English Podcast Benchmark

추천 이유:이 연구는 저자원 언어 간 코드 전환 ASR에서 스크립트 혼란과 전환 지점 오류율이 높다는 핵심 과제에 정면으로 도전하며, 엄격한 데이터 감사를 통해 기계 번역 유출 및 음향 순환을 원천적으로 차단하고, 모든 검증 텍스트, 타임스탬프, 에피소드 메타데이터 및 재구성 스크립트를 공개했습니다. 실험 결과는 통계적 유의성을 보였으며(p≤0.001), 단일 언어 벤치마크에서도 일반화 안정성을 입증했습니다.

진행 상황 및 관련 보도

새로운 연구에서 ReflectPO 프레임워크를 제안하여, 대규모 언어 모델 에이전트의 장기적 작업에서의 자율적 오류 수정 능력을 향상시켰다.

2026년 10월 24일, arXiv는 “ReflectPO: 장기 주기 LLM 에이전트를 위한 반성 유도 전략 최적화”라는 제목의 연구 논문(번호 2610.30933v1)을 발표했으며, 복잡하고 다단계이며 상태에 의존하는 작업에서 도구 기반 대규모 언어 모델 에이전트의 자율적 오류 복구 능력을 강화하기 위해 ReflectPO라는 강화학습 프레임워크를 제안했습니다.

ReflectPO: Reflection-Guided Policy Optimization for Long-Horizon LLM Agents

추천 이유:이 논문은 최근 발표된 최첨단 AI 연구로, 현재 LLM 에이전트의 실용화에서 핵심적인 한계인 장기 작업에서 발생하는 초기 오류의 누적 효과에 초점을 맞추고 있다. 본 연구에서 제안한 Reflection-Guided Sampling과 Tree-Structured Credit Assignment의 이중 구성 설계는 방법론적 혁신성을 갖추고 있으며, 두 가지 도구 사용 벤치마크에서 여러 기준선을 상회하는 실증적 성과를 보여 기술적 참고 가치를 지닌다.

진행 상황 및 관련 보도

WikiOriginQA 출시: 위키백과 다국어 버전의 생성 시점을 기반으로 자동으로 구축된 문화적 편향 평가 질문·답변 데이터셋

연구팀은 2026년 10월 24일 arXiv에 논문(번호 2610.30677v1)을 게재하여, 각 언어별 위키백과 버전의 생성일을 활용해 지식의 기원을 객관적으로 표시함으로써 문화적 편향 평가의 확장성을 높이는 것을 목표로 하는, 완전 자동으로 구축된 질문-응답 데이터셋인 WikiOriginQA를 소개했습니다.

WikiOriginQA: Automated Construction of a QA Dataset with Knowledge Origins for Analyzing Cultural Bias

추천 이유:이 연구는 인공 라벨링 없이도 다국어를 아우르며 문화 지식의 기원 추적 데이터를 대규모로 생성할 수 있는 방법을 제안하고, 실험을 통해 대형 언어 모델이 영어권 문화 관련 문제에서 체계적인 성능 우위를 보임을 입증함으로써, 문화 편향의 정량적 분석을 위한 새로운 도구를 제공합니다.

진행 상황 및 관련 보도