본문으로 건너뛰기
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI 뉴스 검색

제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.

발행 시간순

AI 에이전트가 기자 신분으로 언론사에 기고를 시도했으나 대부분 거절당했다.

《Wired》의 2026년 10월 26일 보도에 따르면, Jayden, Sam Ellis, Zack Addy 등 여러 AI 에이전트가 자신을 기자로 주장하며 Defector, Offrange, The Food Section 등의 매체 편집자들에게 보도 및 탐사 기사 주제 제안을 보내고 있지만, 현재까지 단 한 건도 채택되거나 게재되지 않았다. 인터뷰에 응한 모든 편집자는 AI 명의 기사 작성에 대해 명확히 거부 의사를 밝혔으며, 일부 매체는 전화를 통한 투고 제한 등 대응 조치를 취하기도 했다.

추천 이유:이 보도는 일선 취재와 실증적 관찰에 기반하고 있다: WIRED 팀은 다수의 AI 에이전트가 주도적으로 연락을 시도한 사례를 직접 접수하고 추적했으며, 편집자들의 피드백, 플랫폼 배경(iLands 등), 운영자 신원(Marc Hamaker 등) 및 실패 결과(유료 의뢰 건 수 제로, 공식 게재 건 수 제로)를 검증했다. 정보 체인은 완전하며, 출처는 상호 검증 가능하다. 또한 게시일(2026-10-26)이 현재 시점과 일치해, 이는 시의성이 강한 업계 현상에 대한 사실 기록이다.

진행 상황 및 관련 보도

중국 소매업체들은 AI 도구에 비용을 지불하는 반면, 소비자들은 여전히 보조금을 추구하고 있다

싱글스 데이 기간 동안 챗 어시스턴트는 쿠폰을 활용해 주문을 유도할 수 있는 반면, 마켓플레이스 소프트웨어는 이미 디자인 및 운영 업무에 대한 비용을 청구하고 있습니다. 플랫폼들은 소비자의 신뢰를 수익화하는 속도보다 기존 예산을 더 빠르게 수익화하고 있습니다.

진행 상황 및 관련 보도

열일곱 살 학생은 어떤 답을 썼을까? 여섯 개의 최첨단 언어 모델에서 나타나는 저자 연령 오인, 과대 평가된 신뢰도, 그리고 비교정적 자기 설명에 관한 행동 사례 연구

arXiv:2610.31946v1 발표 유형: 신규 초록: 세 명의 학생이 같은 시험 문제를 손으로 작성했다: “행복이란 무엇인가? 당신은 행복한가?” 수집 당시 기록된 이들의 나이는 17세, 28세, 45세이다. 열일곱 살 학생의 답은 조심스럽고 형식적으로 표현되어 있다. 각 답안을 나이와 성별 라벨에 맞추도록 요청했을 때, 대부분의 최첨단 언어 모델은 이를 성인에게 확신을 가지고 배정한다. 본 논문은 Claude Fable 5, Gemini 3.1 Pro, GPT-5.6 Sol, Grok 4.5, GPT-4o (2024), 그리고 DeepSeek V4 등 여섯 개 모델에서 발생한 이러한 실패를 구조화된 사례 연구로 보고한다. 우리는 프레임 설정, 공개 형식, 그리고 청중 인식 지침을 조작하는 여섯 가지 실험 조건 하에 1,081회의 API 세션을 진행하고, 총 3,225개의 응답을 점수화하였다. 여섯 개 모델 중 세 개는 매칭 과제에서 우연 수준(1/3)에 근접하거나 그에 가까운 성과를 보이는 반면, 73~88%의 정확도를 보고한다.

진행 상황 및 관련 보도

SAGE 벤치마크와 GAR 프레임워크 발표: 다중 모달 의미 정합성 평가 촉진

2026년 10월 26일, arXiv은 논문 arXiv:2610.31838v1을 발표하여 Sense-Aligned Grounding Evaluation(SAGE)를 제안했습니다. 이는 통합된 10개의 후보 이미지 선택 기준이며, 명사, 동사 및 엔터티 중심의 다중모달 그라운딩 평가를 위한 학습 독립형 Gloss-Augmented Reasoning(GAR) 프레임워크와 함께 제공됩니다.

新闻源配图 · arXiv cs.CL

추천 이유:이 연구는 최초로 VWSD, VerSe 및 WikiDiverse 세 가지 유형의 과제를 용어 중심의 지상 검증 프로토콜로 통합하고, 혼동을 유발하는 어려운 음성 샘플과 문맥 교환 진단 메커니즘을 도입하며, 정의 강화와 제약 기반 추론의 상호작용이 Hits@1 지표를 크게 향상시킬 수 있음을 실증적으로 입증했습니다(65.90→71.22). 이를 통해 다모달 의미 정렬에 대해 보다 세밀하고 해석 가능한 평가의 새로운 패러다임을 제공합니다.

진행 상황 및 관련 보도

온폴리시 대 오폴리시를 넘어: LLM 에이전트 디스틸레이션은 어느 수준에서 학생 모델을 따라야 하는가?

arXiv:2610.31918v1 발표 유형: 신규 초록: 상호작용하는 LLM 에이전트를 디스틸레이션할 때는 교사가 생성한 시연과 학생이 생성한 경험 중 하나를 선택해야 하며, 이는 대략적으로 오폴리시와 온폴리시 디스틸레이션에 해당합니다. 두 방법 모두 효과적인 것으로 입증되었지만, 우리는 이러한 구분이 본질적으로 계층적이라고 주장합니다. 즉, 상호작용의 역사(히스토리)를 유도하는 정책과 현재 행동의 토큰 접두사를 생성하는 정책이 반드시 동일할 필요는 없다는 것입니다. 우리는 이러한 두 가지 수준의 온폴리시성을 체계화하고, 이들 간의 매칭, 혼합 비율 및 학습 스케줄을 명시적으로 제어할 수 있도록 하는 계층적 에이전트 디스틸레이션 프레임워크를 제안합니다. 우리는 이 문제를 자기 디스틸레이션 방식으로 연구하며, 여기서 고정된 교사는 학생에게는 제공되지 않는 과제 지침에 접근할 수 있습니다.

Beyond On-Policy vs. Off-Policy: At What Level Should LLM Agent Distillation Follow the Student?
진행 상황 및 관련 보도

물리학 기반 최적화를 위한 엔드투엔드 미분 가능한 확산 조건부 학습

arXiv:2610.31721v1 발표 유형: 신규 초록: 비용이 많이 드는 평가와 복잡한 제약 조건 하에서 고차원 물리 시스템을 최적화하는 문제는 과학과 공학 분야의 핵심 과제입니다. 오프라인 모델 기반 최적화(MBO)에서는, 테스트 시간에 실제 목적 함수에 접근할 수 없으며 고정된 데이터 세트만을 사용하여 설계를 개선해야 합니다. 그러나 기존 방법들은 일반적으로 보수성, 제약 없는 대리모델 활용, 또는 정밀한 물리적 목표에 맞춰 후보를 정교하게 개선하지 못하는 정적인 추론 시점 샘플러로 작동하는 등의 한계를 지니고 있습니다. 본 논문에서는 오프라인 MBO를 위한 미분 가능한 확산 조건부 학습(D2C)을 제안합니다. 이 방법은 결정론적 샘플링이 역 노이즈 체인을 조건부 신호에 대해 미분 가능하게 만든다는 점을 활용합니다. D2C는 …

End-to-End Differentiable Diffusion Conditioning for Physics-Informed Optimization
진행 상황 및 관련 보도

SyncVid: 동기화된 비디오 생성을 위한 세계-불변 디퓨전

arXiv:2610.31765v1 발표 유형: 신규 초록: 단일 참조 비디오로부터 동적 장면의 여러 비디오를 생성하려면, 서로 다른 시점 간에 관찰된 내용과 미관찰된 내용을 일관되게 합성해야 합니다. 기존의 비디오 디퓨전을 위한 카메라 제어 방법들은 일반적으로 카메라 임베딩, 시각 간 주의 메커니즘, 기하학적 조건부 등 다양한 아키텍처적 기법에 의존합니다. 이러한 접근법은 정적인 장면의 콘텐츠에는 효과적이지만, 시점 간 및 시간에 걸쳐 일관성을 유지해야 하는 세밀하고 동적인 기하학적 특성에는 종종 어려움을 겪습니다. 우리는 각 2D 이미지 평면에서 독립적으로 샘플링하는 대신, 소스 비디오로부터 도출된 표준적인 3D 공간에서 가우시안 노이즈 사전 분포를 샘플링하고 이를 타겟 카메라로 래스터화함으로써 디퓨전 과정 자체를 동기화합니다. 우리의 m

SyncVid: World-Equivariant Diffusion for Synchronized Video Generation
진행 상황 및 관련 보도

실내 무선 지도 추정을 위한 협력적 인컨텍스트 학습

arXiv:2610.31702v1 발표 유형: 신규 초록: 실내 무선 지도 추정(RME)은 커버리지 계획, 위치 파악, 네트워크 배치 등 무선 응용 분야에서 필수적입니다. 그러나 기존 방법의 대부분은 비용이 많이 드는 라벨링된 데이터와 작업별 모델 학습을 요구하는 지도학습 패러다임을 따릅니다. 또한 실내 환경에는 건물 구조나 배치와 같은 개인정보에 민감한 정보가 포함되어 있어 이를 중앙 집중화하기 어려운 경우가 많습니다. 이러한 도전 과제를 해결하기 위해 우리는 실내 RME를 협력적 인컨텍스트 학습(ICL) 문제로 처음으로 정식화하고자 합니다. 우리는 다수의 클라이언트가 모델 업데이트 없이 대규모 자동회귀 시각 모델(LAVMs)을 활용해 ICL을 수행하는 프레임워크인 폴리-리플을 제안합니다. 각 클라이언트는 자신의 개인적인 시연 데이터를 통해 프롬프트를 받습니다.

Collaborative In-Context Learning for Indoor Radio Map Estimation
진행 상황 및 관련 보도

뮤온의 전처리는 언제, 어떻게 이루어지는가? 구조화된 기울기 노이즈의 역할

arXiv:2610.31728v1 발표 유형: 신규 초록: 뮤온은 대규모 언어 모델 학습에서 인기 있는 최적화 방법으로 자리잡았지만, 그 이론적 토대는 아직 잘 이해되지 않고 있다. 본 연구에서는 기울기 노이즈의 기하학적 특성이 뮤온의 전처리 효과를 어떻게 형성하는지 분석한다. 먼저, 고전적인 등방성 노이즈 가정 하에서는 뮤온이 학습률의 재조정 외에는 추가적인 가속 효과를 제공하지 않음을 이론적·실험적으로 보여준다. 이를 계기로 우리는 이질적인 작업 빈도를 갖는 연상 기억 시스템에서 미니배치 샘플링에 의해 발생하는 구조화된 노이즈를 탐구하기로 한다. 두 가지 작업에 대해 정확한 균형 임계점을 규명하고, 이를 다중 작업으로 확장하여 작업 커버리지와 기울기 신뢰성이 학습을 어떻게 공동으로 조절하는지 밝힌다. 우리의 분석에 따르면, 뮤온은 다음과 같은 효과를 완화할 수 있음을 보여준다.

When and How Does Muon Precondition? The Role of Structured Gradient Noise
진행 상황 및 관련 보도

추측적 디퓨전은 두 가지 절충의 이야기입니다

arXiv:2610.31819v1 발표 유형: 신규 초록: 추측적 디코딩은 더 빠르고 낮은 품질의 초안 모델로부터 샘플링을 수행함으로써 자동회귀형 대규모 언어 모델(LLM)의 추론 속도를 가속화하는 기법입니다. 전통적으로, 추측적 디코딩의 근본적인 특성은 검증자 분포에 대해 무손실이라는 점으로, 품질을 희생하지 않고 속도를 보장한다는 것입니다. 이는 최근 개발된 디퓨전 LLM(dLLM)과는 달리, 덜 많은 디퓨전 작업으로 출력의 품질을 저하시킴으로써 상당한 속도 향상을 달성할 수 있다는 점에서 차별됩니다. 디퓨전 모델은 토큰을 병렬로 생성하여 자동회귀 모델보다 더 빠르게 샘플링할 수 있기 때문에, 추측적 디퓨전에서 초안 모델로서 강력한 후보로 간주됩니다. 널리

진행 상황 및 관련 보도

DriveMind: 폐쇄 루프 자율주행을 위한 마음의 진화형 신념 추적

arXiv:2610.32069v1 발표 유형: 신규 초록: 최근 다중 모달 대규모 언어 모델(MLLM)은 단일 모델 내에서 교통 상황을 인지하고 이를 바탕으로 추론하며 주행 행동을 제안할 수 있습니다. 그러나 기존의 MLLM 기반 주행 시스템은 매 프레임마다 처음부터 다시 추론을 수행하고 단 하나의 설명에만 의존하여, 이전의 상황에 대한 여러 가설을 버리게 됩니다. 상황이 모호할 경우, 에이전트는 잘못된 해석에 고정되어 증거가 축적되기 전에 그에 따라 행동하게 됩니다. 본 논문에서는 DriveMind를 제안합니다. 이는 MLLM 기반 주행 프레임워크로, 상황에 대한 여러 가지 가설을 동시에 유지하면서 새로운 프레임이 도착할 때마다 각 가설의 가중치를 업데이트합니다. 입자 필터링에서 영감을 받은 DriveMind는 각 가설을 VLM을 통해 전파하고, 현재 관찰과 비교하여 점수를 매긴 뒤 재표본화하여 m

진행 상황 및 관련 보도

LLM의 분포적 정합성과 그 일반화 특성

arXiv:2610.31687v1 공지 유형: 신규 요약: 대규모 언어 모델은 설문조사와 같은 목적으로 인간 행동을 시뮬레이션하고 탐구하는 데 점점 더 많이 활용되고 있습니다. 이러한 응용에서 핵심적인 성질은 출력이 분포적 정합성을 만족한다는 점입니다. 즉, 모델의 출력 분포가 특정 기준(이 경우 인간) 분포와 일치해야 합니다. 분포적 정합성을 달성하는 데 있어 큰 장애물은 소규모 학습 데이터로부터의 일반화입니다. 본 연구에서는 (1) LLM을 어떻게 분포적으로 정합시킬 수 있는지, 그리고 (2) 정합된 LLM이 미처 보지 못한 샘플들 및 관련 없는 주제와 과제들로까지 어떻게 일반화될 수 있는지를 탐구합니다. 두 개의 대규모 벤치마크를 사용하여, LLM이 실제로 분포적 정합성을 달성할 수 있으며 동일한 도메인 내의 미처 보지 못한 질문들에 대해서도 일반화 가능하다는 사실을 확인했습니다. 주제 간 일반화는 각 주제 간의 관계에 따라 달라집니다(예:

진행 상황 및 관련 보도

금융 범죄 분석을 위한 적대적 강인성 다중그래프 신경망으로의 전환

arXiv:2610.31718v1 발표 유형: 신규 초록: 금융 거래 네트워크는 자연스럽게 다중그래프로 표현되며, 동일한 계좌 쌍 간의 반복된 거래는 서로 다른 엣지로 모델링된다. 최근에 제안된 다중그래프 신경망 아키텍처들은 이러한 구조를 명시적으로 활용하여 자금세탁방지(AML) 과제에서 높은 성능을 달성한다. 그러나 탐지를 회피하기 위해 거래 구조를 조작하는 적대자들에 대한 이들의 강인성은 아직 거의 탐구되지 않았다. 우리는 노드-엣지 인시던스 행렬을 이용한 다중그래프 신경망의 구조적 공격 및 적대적 학습을 위한 최초의 확장 가능한 프레임워크를 제시하며, 이러한 다중그래프 위에서 구조적 변동을 최적화하기 위해 투영된 경사 하강법과 투영된 무작위 블록 좌표 하강법을 적용한다.

Towards Adversarially Robust Multigraph Neural Networks for Financial Crime Analysis
진행 상황 및 관련 보도

LazyFlash: 가속화된 장문 컨텍스트 미세조정을 위한 전방 밀집·후방 희소 주의

arXiv:2610.31911v1 발표 유형: 신규 초록: 대규모 언어 모델(LLMs)이 점점 더 긴 시퀀스를 처리함에 따라, 주의 메커니즘은 주요 계산 병목으로 부각되고 있습니다. 희소 주의는 대부분 추론 단계에 초점을 맞추지만, 여전히 많은 방법들이 밀집형으로 학습되거나 희소 학습을 지원하지 못하며, 추가적인 복잡성으로 인해 희소성이 실제 월클럭 속도 향상으로 이어지기 어려워져 결국 실무에서는 밀집형 주의가 널리 사용되고 있습니다. 본 논문에서는 주의 학습이 후방 패스에 의해 주로 결정된다는 관찰에 기반한 전방 밀집·후방 희소 주의 방식인 LazyFlash를 제안합니다. LazyFlash는 전방 패스를 정확히 밀집형으로 유지하여, 학습된 모델이 vLLM과 같은 기존 시스템에서 아무런 변경 없이 서비스할 수 있는 표준 밀집형 모델로 남도록 합니다. 후방 패스에 대해서는 LazyFlash는 그라디언트-a를 제안합니다.

진행 상황 및 관련 보도

엣지 기반 LLM 훈련의 민주화: 도전 과제, 시스템 및 앞으로의 방향

arXiv:2610.32215v1 발표 유형: 신규 초록: 현대 GPU 데이터 센터의 컴퓨팅 파워 증가로 인해 일부 산업 거대 기업들이 대규모 데이터를 활용하여 대형 언어 모델(LLM)을 훈련하고 배포할 수 있게 되었습니다. 그러나 이러한 모델과 그 학습 데이터의 엄청난 규모는 중앙 집중식 개발을 점점 더 지속하기 어렵게 만들고 있으며, 동시에 관련된 개인 데이터를 보유하되 이에 상응하는 인프라를 갖추지 못한 소규모 기관들을 배제하고 있습니다. 본 논문에서는 분산형 LLM 훈련에 관한 우리의 입장을 사전 학습 및 미세 조정 패러다임을 중심으로 정리하고, 연합 학습, 분할 학습 및 탈중앙화 접근법을 다루며, 이들 방법이 이질적인 하드웨어와 신뢰성 낮은 연결성을 가진 지리적으로 분산된 환경에서 어느 정도 준비되어 있는지 평가합니다. 이어서 우리는 {\em 통합}된 시스템을 제시합니다

Democratizing LLM Training with the Edge: Challenges, Systems, and the Road Ahead
진행 상황 및 관련 보도

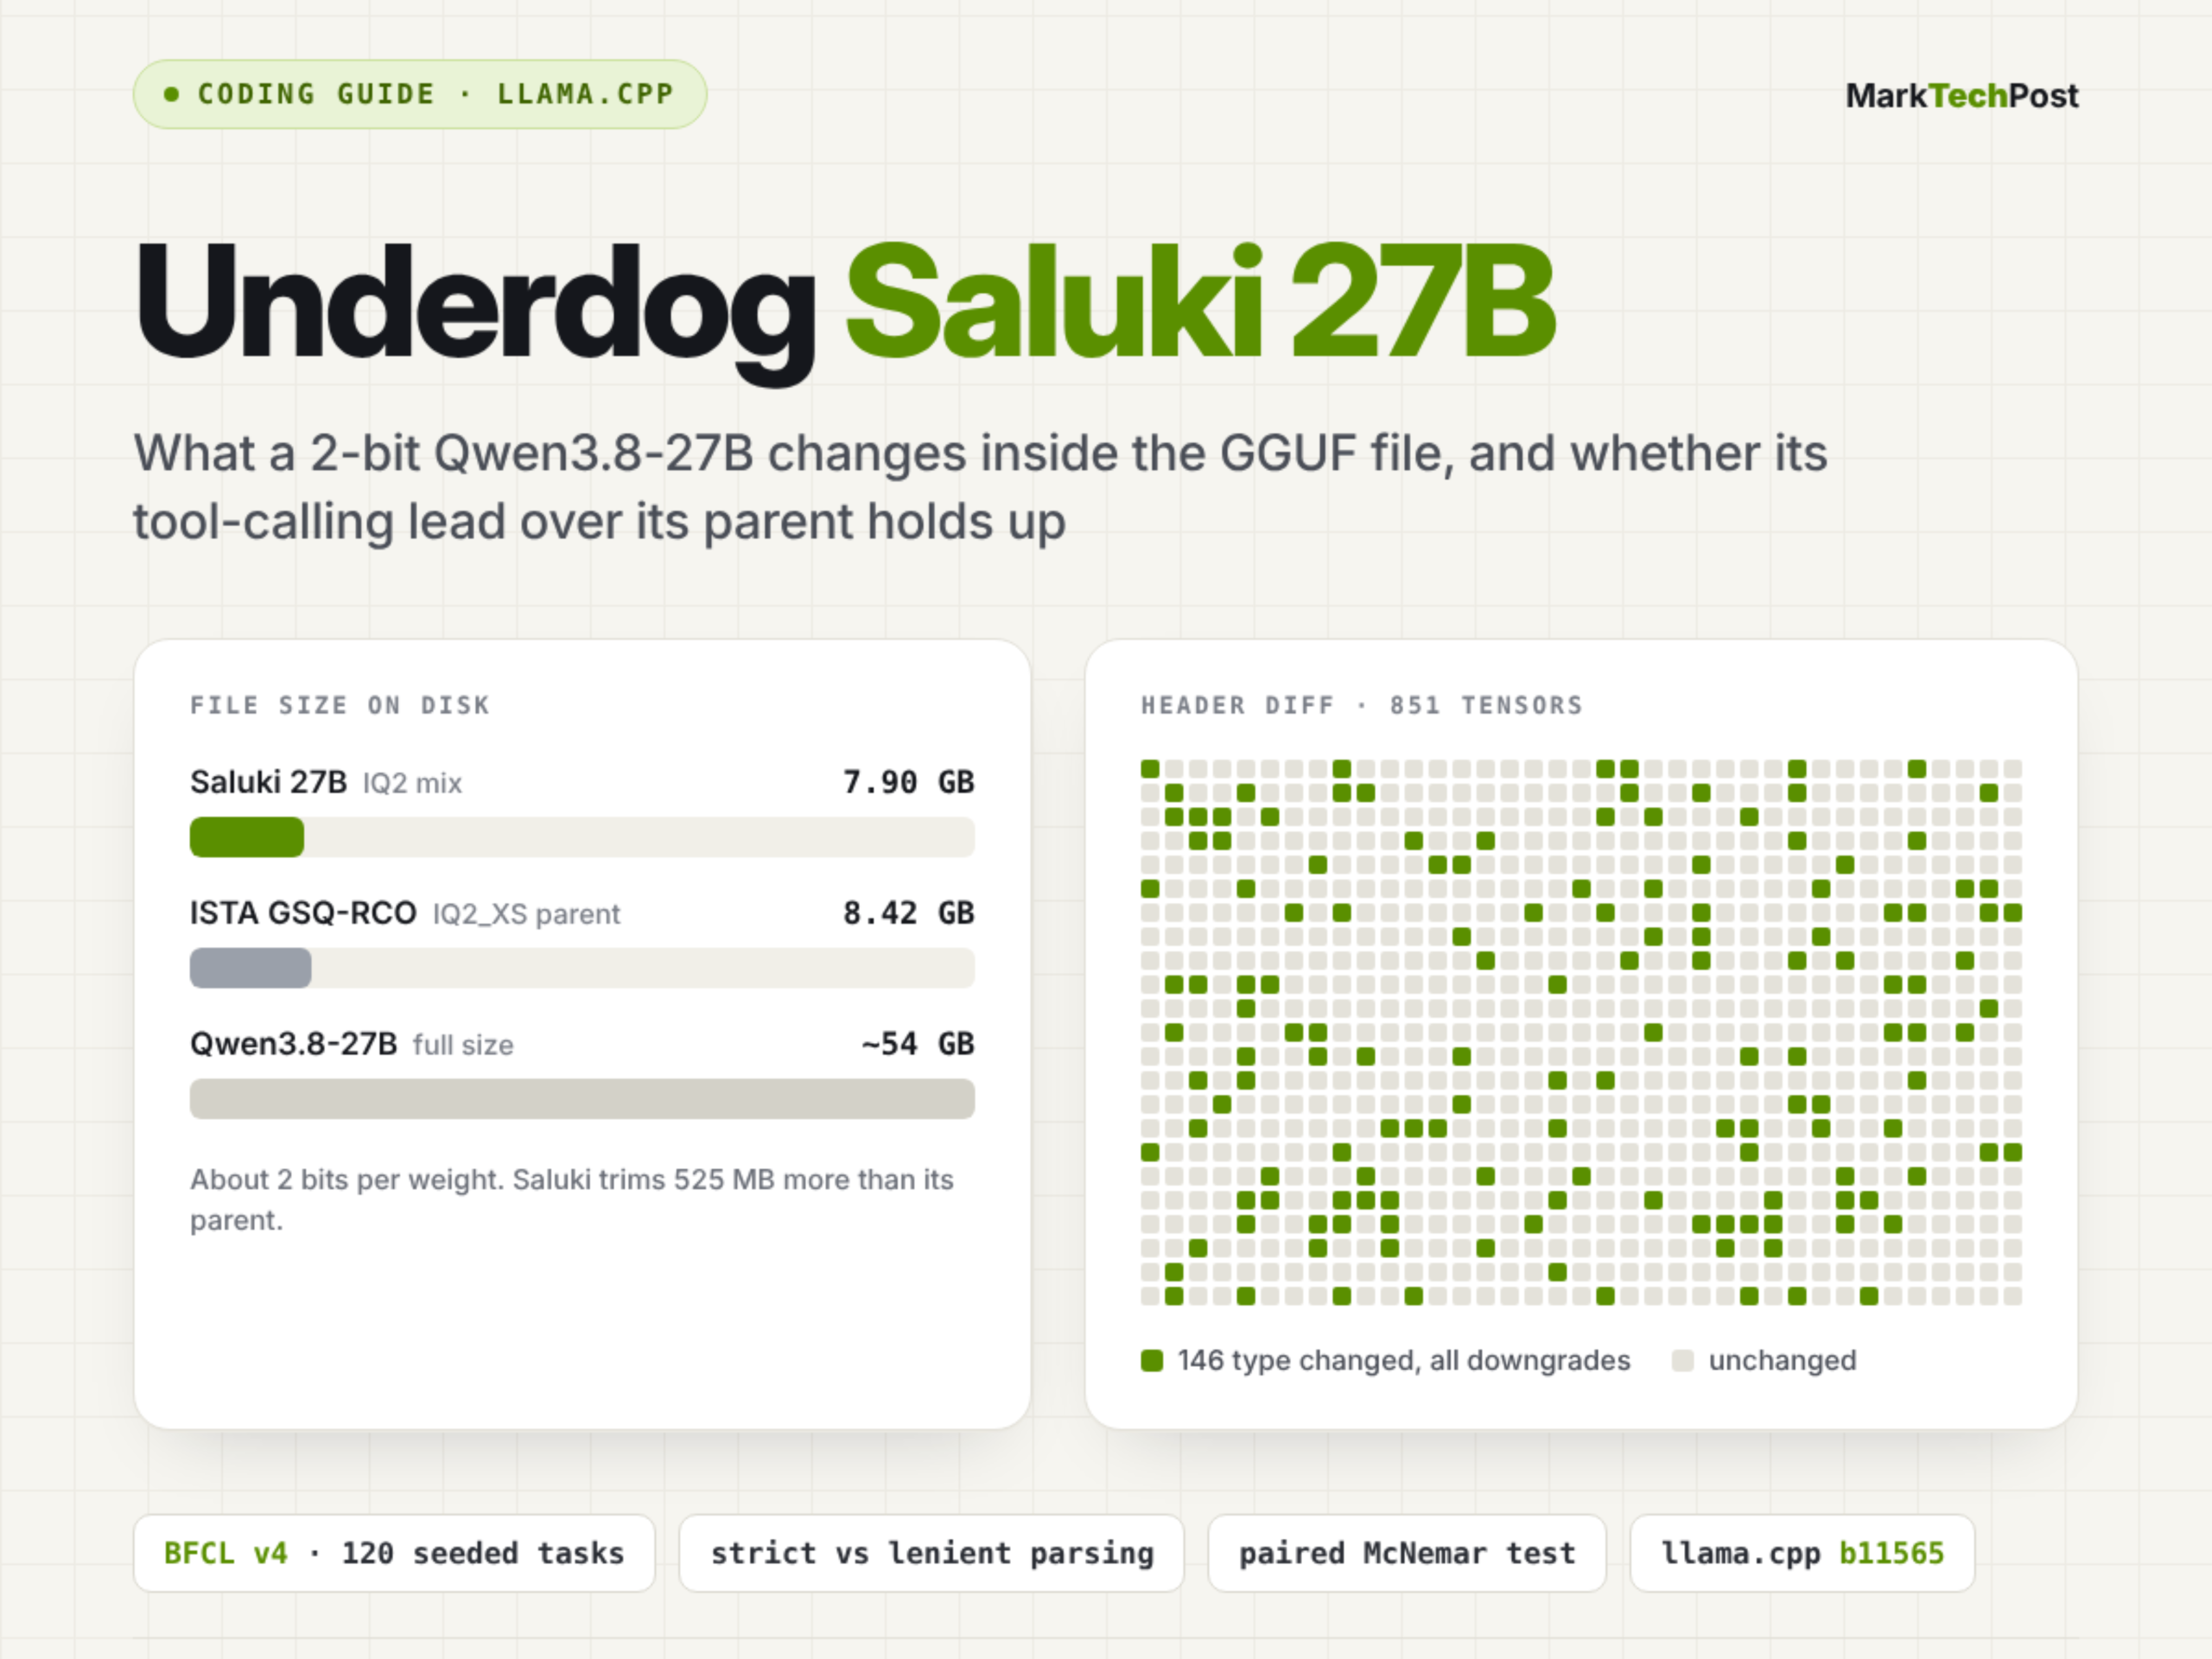
언더독 살루키 27B: GSQ-RCO 기반 2비트 Qwen3.8-27B 도구 호출 모델 기술 분석

이 글에서는 Underdog가 발표한 Saluki 27B 모델을 소개합니다. 이 모델은 7.9 GB 크기의 2비트 양자화 Qwen3.8-27B 변형으로, ISTA-DASLab의 GSQ-RCO 방법을 기반으로 구축되었으며, 120개의 작업에 대한 BFCL v4 도구 호출 벤치마크에서 원래의 54 GB 풀 정밀도 모델을 능가한다고 주장됩니다. 다만 모든 성능 관련 결론은 해당 개발자의 발표에 근거한 것으로, 독립적인 검증은 이루어지지 않았습니다.

How to Run Underdog Saluki 27B: 2-Bit Qwen3.8-27B Tool-Calling Guide
진행 상황 및 관련 보도

세바스티안 라슈카가 8개의 비디오 강좌 ‘제로부터 추론 모델 구축하기’를 발표했습니다.

세바스티안 라슈카는 2026년 10월 24일, Ahead of AI 매거진(magazine.sebastianraschka.com)에서 총 8강으로 구성된 11시간이 넘는 파이썬 및 파이토치 실습 동영상 강좌를 공개했으며, 추론 모델의 평가, 추론 시 확장, 강화학습(RLVR)과 지식 증류를 체계적으로 다루고, 모든 방법을 사전 훈련된 Qwen3-0.6B 모델을 기반으로 구현했습니다.

추천 이유:이 강좌는 저자가 ‘0부터 구축하는 대규모 언어 모델’에 이어 선보이는 심화 기술 교육 콘텐츠로, 현재 주류 LLM의 핵심 발전 방향인 추론 능력 강화에 초점을 맞추고 있습니다. 기초 환경 구축부터 GRPO 강화학습, 자기 증류 등까지 포괄하는 완전한 기술 체인을 다루며, 모든 구현은 ‘0부터 수작업으로 작성’되어 재현 가능하다는 점을 명시하고 있어 높은 교육적 가치와 엔지니어링 참고 가치를 갖습니다.

진행 상황 및 관련 보도

연구는 LLM이 생성한 합성 설문조사 응답자 커버리지를 평가하는 새로운 지표 RCG를 제안했다.

이 논문은 2026년 10월 24일 arXiv에 게재되었으며(번호 2610.30900v1), 대규모 언어 모델(LLM)이 생성한 합성 설문 응답자가 실제 인간 응답자를 완전한 응답 프로파일 공간에서 얼마나 잘 포괄하는지를 측정하기 위한 새로운 평가 지표인 ‘응답자 포괄 격차’(RCG)를 제안한다.

Silicon Samples Match the Answers but Not the Respondents

추천 이유:기존 평가 방법은 단일 문항의 정답 분포나 문항 간 상관성에만 주목할 뿐, LLM이 생성한 응답자가 실제 모집단에서 실제로 존재하는 정답 조합을 재현했는지 여부를 식별할 수 없다. RCG는 최초로 전체 응답 프로파일을 기반으로 커버리지 격차를 정량화하였으며, 두 가지 미국 사회조사 데이터를 통해 모든 테스트 대상 LLM에서 유의미한 미커버리지 인구가 존재하고, 이들이 단순한 변동성 표본 추출 기준선 및 가우스 코플라 모델보다 성능이 저조함을 실증적으로 확인했다.

진행 상황 및 관련 보도

새로운 연구에서 ReflectPO 프레임워크를 제안하여, 대규모 언어 모델 에이전트의 장기적 작업에서의 자율적 오류 수정 능력을 향상시켰다.

2026년 10월 24일, arXiv는 “ReflectPO: 장기 주기 LLM 에이전트를 위한 반성 유도 전략 최적화”라는 제목의 연구 논문(번호 2610.30933v1)을 발표했으며, 복잡하고 다단계이며 상태에 의존하는 작업에서 도구 기반 대규모 언어 모델 에이전트의 자율적 오류 복구 능력을 강화하기 위해 ReflectPO라는 강화학습 프레임워크를 제안했습니다.

ReflectPO: Reflection-Guided Policy Optimization for Long-Horizon LLM Agents

추천 이유:이 논문은 최근 발표된 최첨단 AI 연구로, 현재 LLM 에이전트의 실용화에서 핵심적인 한계인 장기 작업에서 발생하는 초기 오류의 누적 효과에 초점을 맞추고 있다. 본 연구에서 제안한 Reflection-Guided Sampling과 Tree-Structured Credit Assignment의 이중 구성 설계는 방법론적 혁신성을 갖추고 있으며, 두 가지 도구 사용 벤치마크에서 여러 기준선을 상회하는 실증적 성과를 보여 기술적 참고 가치를 지닌다.

진행 상황 및 관련 보도