
Anthropic, 제안된 기업공개를 위해 SEC에 S-1 서류를 제출
Anthropic, 제안된 기업공개를 위해 SEC에 S-1 서류를 제출
제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.
Anthropic, 제안된 기업공개를 위해 SEC에 S-1 서류를 제출
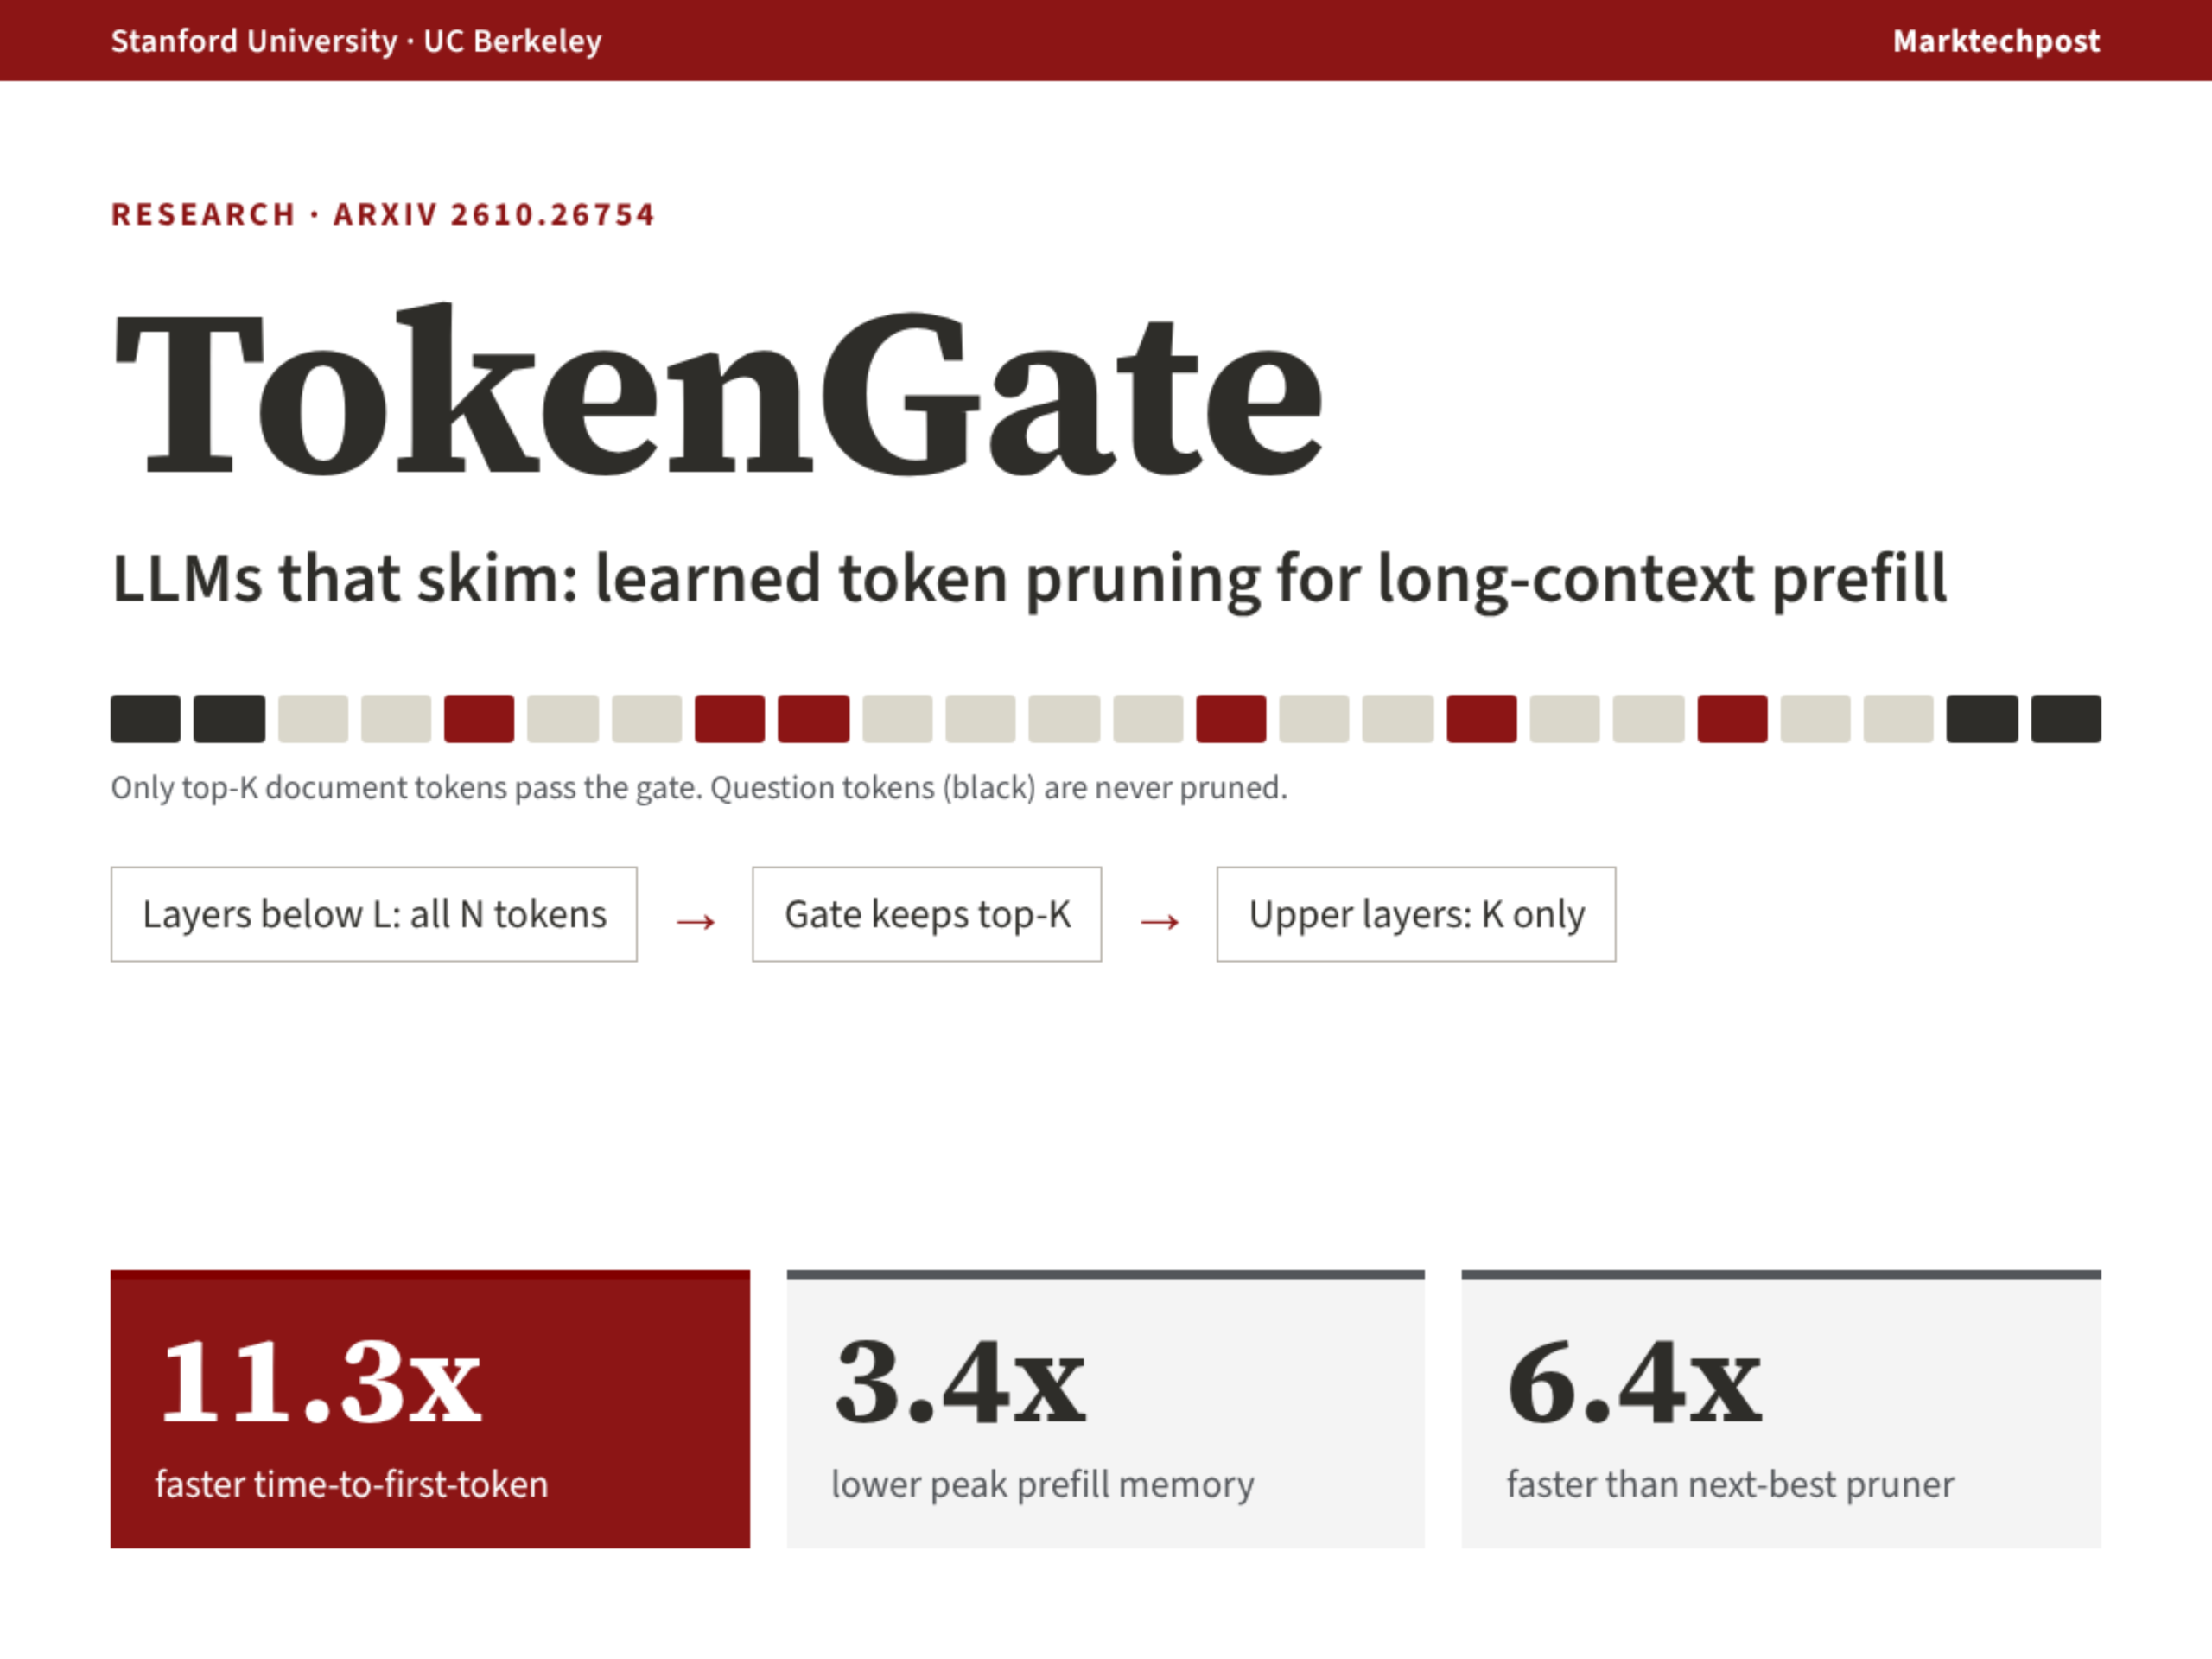
스탠퍼드 대학교와 캘리포니아 대학교 버클리 캠퍼스의 연구진은 기존 대규모 언어 모델(LLM)에 적용 가능한 플러그 앤 플레이 방식의 학습형 토큰 가위 모듈인 TokenGate를 제안했습니다. 이 방법은 정확도를 유지하면서, 긴 컨텍스트를 사전 채워 넣는 첫 글자 생성 시간(TTFT)을 1.4배에서 최대 11.3배까지 가속화하고, 최대 메모리 사용량을 1.5배에서 최대 3.4배까지 절감합니다. 관련 코드와 체크포인트는 오픈소스로 공개되었습니다.
arXiv:2610.30296v1 발표 유형: 신규 초록: 대규모 언어 모델(LLMs)은 저자원 및 다국어 NLP에 대한 연구를 가속화했지만, 이들이 공평한 연구 환경을 조성하는 데 얼마나 효과적인지는 아직 명확히 규명되지 않았습니다. 우리는 2020년부터 2025년까지 출판된 1,158편의 동료 심사 오픈 액세스 논문을 분석하여, 저자원 언어(LRLs)에 대한 연구 관심도와 언어 및 사용자 집단 전반에 걸친 표현 수준을 검토합니다. 출판 건수 외에도 언어적 포용성을 평가하기 위해, 우리는 언어적 포용성 프레임워크(LIF)를 도입합니다. 이는 연구 성장, 표현 확대, 표현 지속성, 그리고 분포적 형평성 등 네 가지 차원에서 언어적 포용성을 측정하는 다차원적 체계입니다. 연간 출판물 수는 52건에서 415건으로 5.4배 증가했으며, ACL Antholo

Claude Mods는 Anthropic이 출시한 Claude Code의 프로그래밍 가능 플러그인 시스템으로, ‘주의 인터페이스’(Attention Interface)의 초기 형태를 나타냅니다. 이는 기존의 기계 지향형 에이전트 런타임 프레임워크(agent harness)에서 인간의 주의에 맞춘 맞춤형 상호작용 계층으로 전환합니다. 사용자는 TypeScript/JS로 Mods를 작성하거나 자연어를 통해 Claude에게 자동 생성을 요청함으로써, 언제 중단될지, 어떤 내용을 보게 될지, 어떤 결정을 내려야 하는지를 스스로 정할 수 있습니다.
Claude Mods는 Anthropic이 출시한 개발자용 프로그래밍 가능 플러그인 시스템으로, ‘에이전트 하네스’가 기계 측 인터페이스에서 인간 측 인터페이스인 ‘어텐션 인터페이스’로 전환됨을 의미합니다. 이를 통해 사용자는 TypeScript/JavaScript를 활용해 Claude Code의 동작, 렌더링 및 상호작용 로직을 맞춤 설정할 수 있으며, 사람과 AI가 함께 워크플로를 설계하는 것을 가능하게 합니다. 이 메커니즘은 You Should Know와 같은 내장 기능에도 이미 적용되어 있으며, 사용자가 직접 플러그인을 구축하거나 Claude의 도움을 받아 생성하는 것도 지원합니다.
i14는 30.28억 개의 파라미터를 갖는 Laplace 3B 모델을 출시했으며, Softmax 주의 메커니즘을 대체해 게이트 제어 선형 주의(GLA)를 채택했습니다. 이 모델은 추론 시 각 시퀀스의 재귀 상태 크기가 항상 29.5 MB로, 컨텍스트 길이와 무관합니다. 해당 모델은 AWS trn2.48xlarge 인스턴스 한 대(Trainium2 칩 16개 탑재)에서 훈련 및 서비스 검증을 완료했으며, 훈련 처리량은 초당 12만 토큰에 달하고, 서비스 처리량은 초당 11,544 출력 토큰(동시 실행 시퀀스 수 1,280)입니다. 모든 성능 데이터는 i14와 AWS GenAIIC 팀의 내부 실측 결과입니다.
PyTorch 2.15는 Apple Silicon 맥을 위한 주요 MPS 백엔드 업그레이드를 제공하며, macOS에서 처음으로 FP8 텐서 연산을 네이티브로 지원합니다. 또한 MoE 모델의 디코딩 속도가 5~6.5배 향상되고, 비디오 VAE 디코딩 시 최대 GPU 메모리 사용량이 270 GiB에서 8 GiB로 감소하며, 다수의 연산자들이 MPSGraph에서 전용 Metal 커널로 이전되었습니다.
우리는 “이 코드를 사람이 읽었나요?”라는 질문이 “이 변경에서 어떤 문제가 발생할 수 있으며, 이를 잡아낼 적절한 검사는 자동화된 것인지 인간의 것인지”라는 질문을 정확히 대신한다고 보지 않습니다. 이러한 질문을 던지는 방식도 리뷰가 이루어지는 시점에 따라 달라집니다. 이전에는 리뷰가 길의 끝에 있는 관문처럼 작용했습니다: 코드를 작성하고, PR을 열고, 동료의 답변을 기다리는 것이었습니다. 이제는 리뷰가 지속적으로 진행되며, 마치 글을 쓰는 도중 맞춤법 검사를 하는 것과 같습니다. 대부분의 변경 사항은 인간이 검토하기 전에 최소 한 번 이상 Claude에 의해 검토되고 수정됩니다. 이를 통해 일상적인 실수 대부분을 미리 발견할 수 있고, 팀의 주의력을 더 고차원적인 문제와 심층적 검토에 집중시킬 수 있습니다. — 애디 오스마니, 모건 웨슬리 런트, 그리고 칭 왕, Claude Code 팀의 코드 리뷰 방식 태그: 안트로픽, Claude, AI, Claude-Code, LLMs, 애디-오스마니, 코딩-에이전트, 생성형-AI, 에이전틱-엔지니어링,
FLUX는 이제 Replicate에서 훨씬 더 빠르며, 저희의 최적화 방식을 오픈소스로 공개하여 여러분이 그 작동 원리를 정확히 확인하고 이를 기반으로 발전시킬 수 있도록 했습니다.