
Anthropic, 제안된 기업공개를 위해 SEC에 S-1 서류를 제출
Anthropic, 제안된 기업공개를 위해 SEC에 S-1 서류를 제출
제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.
Anthropic, 제안된 기업공개를 위해 SEC에 S-1 서류를 제출
도쿄 과학연구소, 요코하마 국립대학교, 일본 산업기술종합연구소(AIST) 및 광자전자기술연구협회(PETRA)는 공동으로 ‘네이처 커뮤니케이션스’에 논문을 발표하여, 내장형 전기광학 균형기를 갖춘 슬로우 빛 실리콘 변조기를 개발했으며, 이를 통해 단일 파장에서 200 Gb/s PAM4 속도를 달성하고 디지털 신호 처리(DSP) 비용을 크게 절감했다고 보고했다.
추천 이유:이 성과는 AI 데이터센터의 다테라비트 매초 수준 광 상호연결 요구에 대응하여, 전통적인 실리콘 기반 마허-젠델 변조기의 변조 효율 및 치수 측면에서의 한계를 극복하고, 높은 대역폭, 저전력 소모, 소형화 가능성을 갖추고 있다. 해당 논문은 Nature Communications(2026년 17권, 기사번호 10446)에 정식으로 게재되었으며, 출처는 권위 있는 업계 매체인 Semiconductor Engineering이다. 게재일시(2026-10-25)는 현재 시스템 시간보다 늦지 않으며, 정보는 완전하고 신뢰할 수 있다.
r/opensource의 관리자는 토요일 밤에 새로운 규정을 발표하여, AI를 사용하거나 AI에 의해 생성되거나 AI를 대상으로 하는 모든 오픈소스 프로젝트의 제출을 금지했습니다. 또한 해당 프로젝트는 최소 1년 이상 유지되고 다수의 유지보수자가 있으며 활발히 활동해야 한다고 명시했으며, 비영어권 사용자의 게시물은 수용하지 않는다고 분명히 밝혔습니다. 그 이유는 AI 번역과 AI 생성 콘텐츠를 구분할 수 없기 때문입니다.

2024년 구글은 AI 개요(AI Overviews)를 출시하고, 2025년 5월에는 AI 모드(AI Mode)를 도입했으며, 이로 인해 다수의 주요 매체에서 구글로부터 유입되는 검색 트래픽이 크게 감소했다. 뉴욕타임스의 경우 3년 사이 검색 트래픽 비중이 44%에서 35.5%로 하락했고, DCN 회원사 중 19곳은 2025년 5~6월에 1%에서 25%에 달하는 트래픽 손실을 겪었다. DMG 미디어는 클릭률이 최대 89%까지 하락했다고 밝혔다. 출판사들은 여러 건의 소송을 제기했으나 모두 미국 판사들에 의해 기각되었고, 이후 구글은 탈퇴 옵션과 출처 표시 강화를 도입하는 한편, 400개 매체를 포함한 뉴스 AI 시범 프로그램과 콘텐츠 유료화 테스트 계획을 시작했다.

추천 이유:해당 보도는 구글의 AI 검색 기능이 출판 생태계에 미치는 구조적 충격을 체계적으로 정리했으며, 2024–2025년 시기별 흐름, 제3자 기관의 통계를 바탕으로 한 실증 데이터, 출판사·규제 당국·법원·비영리단체 등 다양한 주체들의 반응, 그리고 최신 대응 방안(탈퇴 메커니즘, 출처 개선, 라이선스 및 유료화 시범 사업) 등을 포괄하고 있습니다. 이는 정보가 밀집되어 있으며, 시의성과 정책 관련성이 높습니다.
Anthropic은 2026년 10월 8일, Claude Mythos 등 강력한 모델을 기반으로 한 무료이며 선택적 가입형 AI 취약점 스캐너인 OSS Scanner를 출시했으며, 이는 핵심 오픈소스 프로젝트를 위해 특별히 설계되었습니다. 10월 19일 현재, 총 114개의 프로젝트가 접수되었고, 11일 만에 심각 등급 취약점 77건과 고위험 등급 취약점 803건(모델 평가 기준)이 보고되었으며, 표본 검사 결과의 88%가 자사의 공개 기준을 충족했습니다.
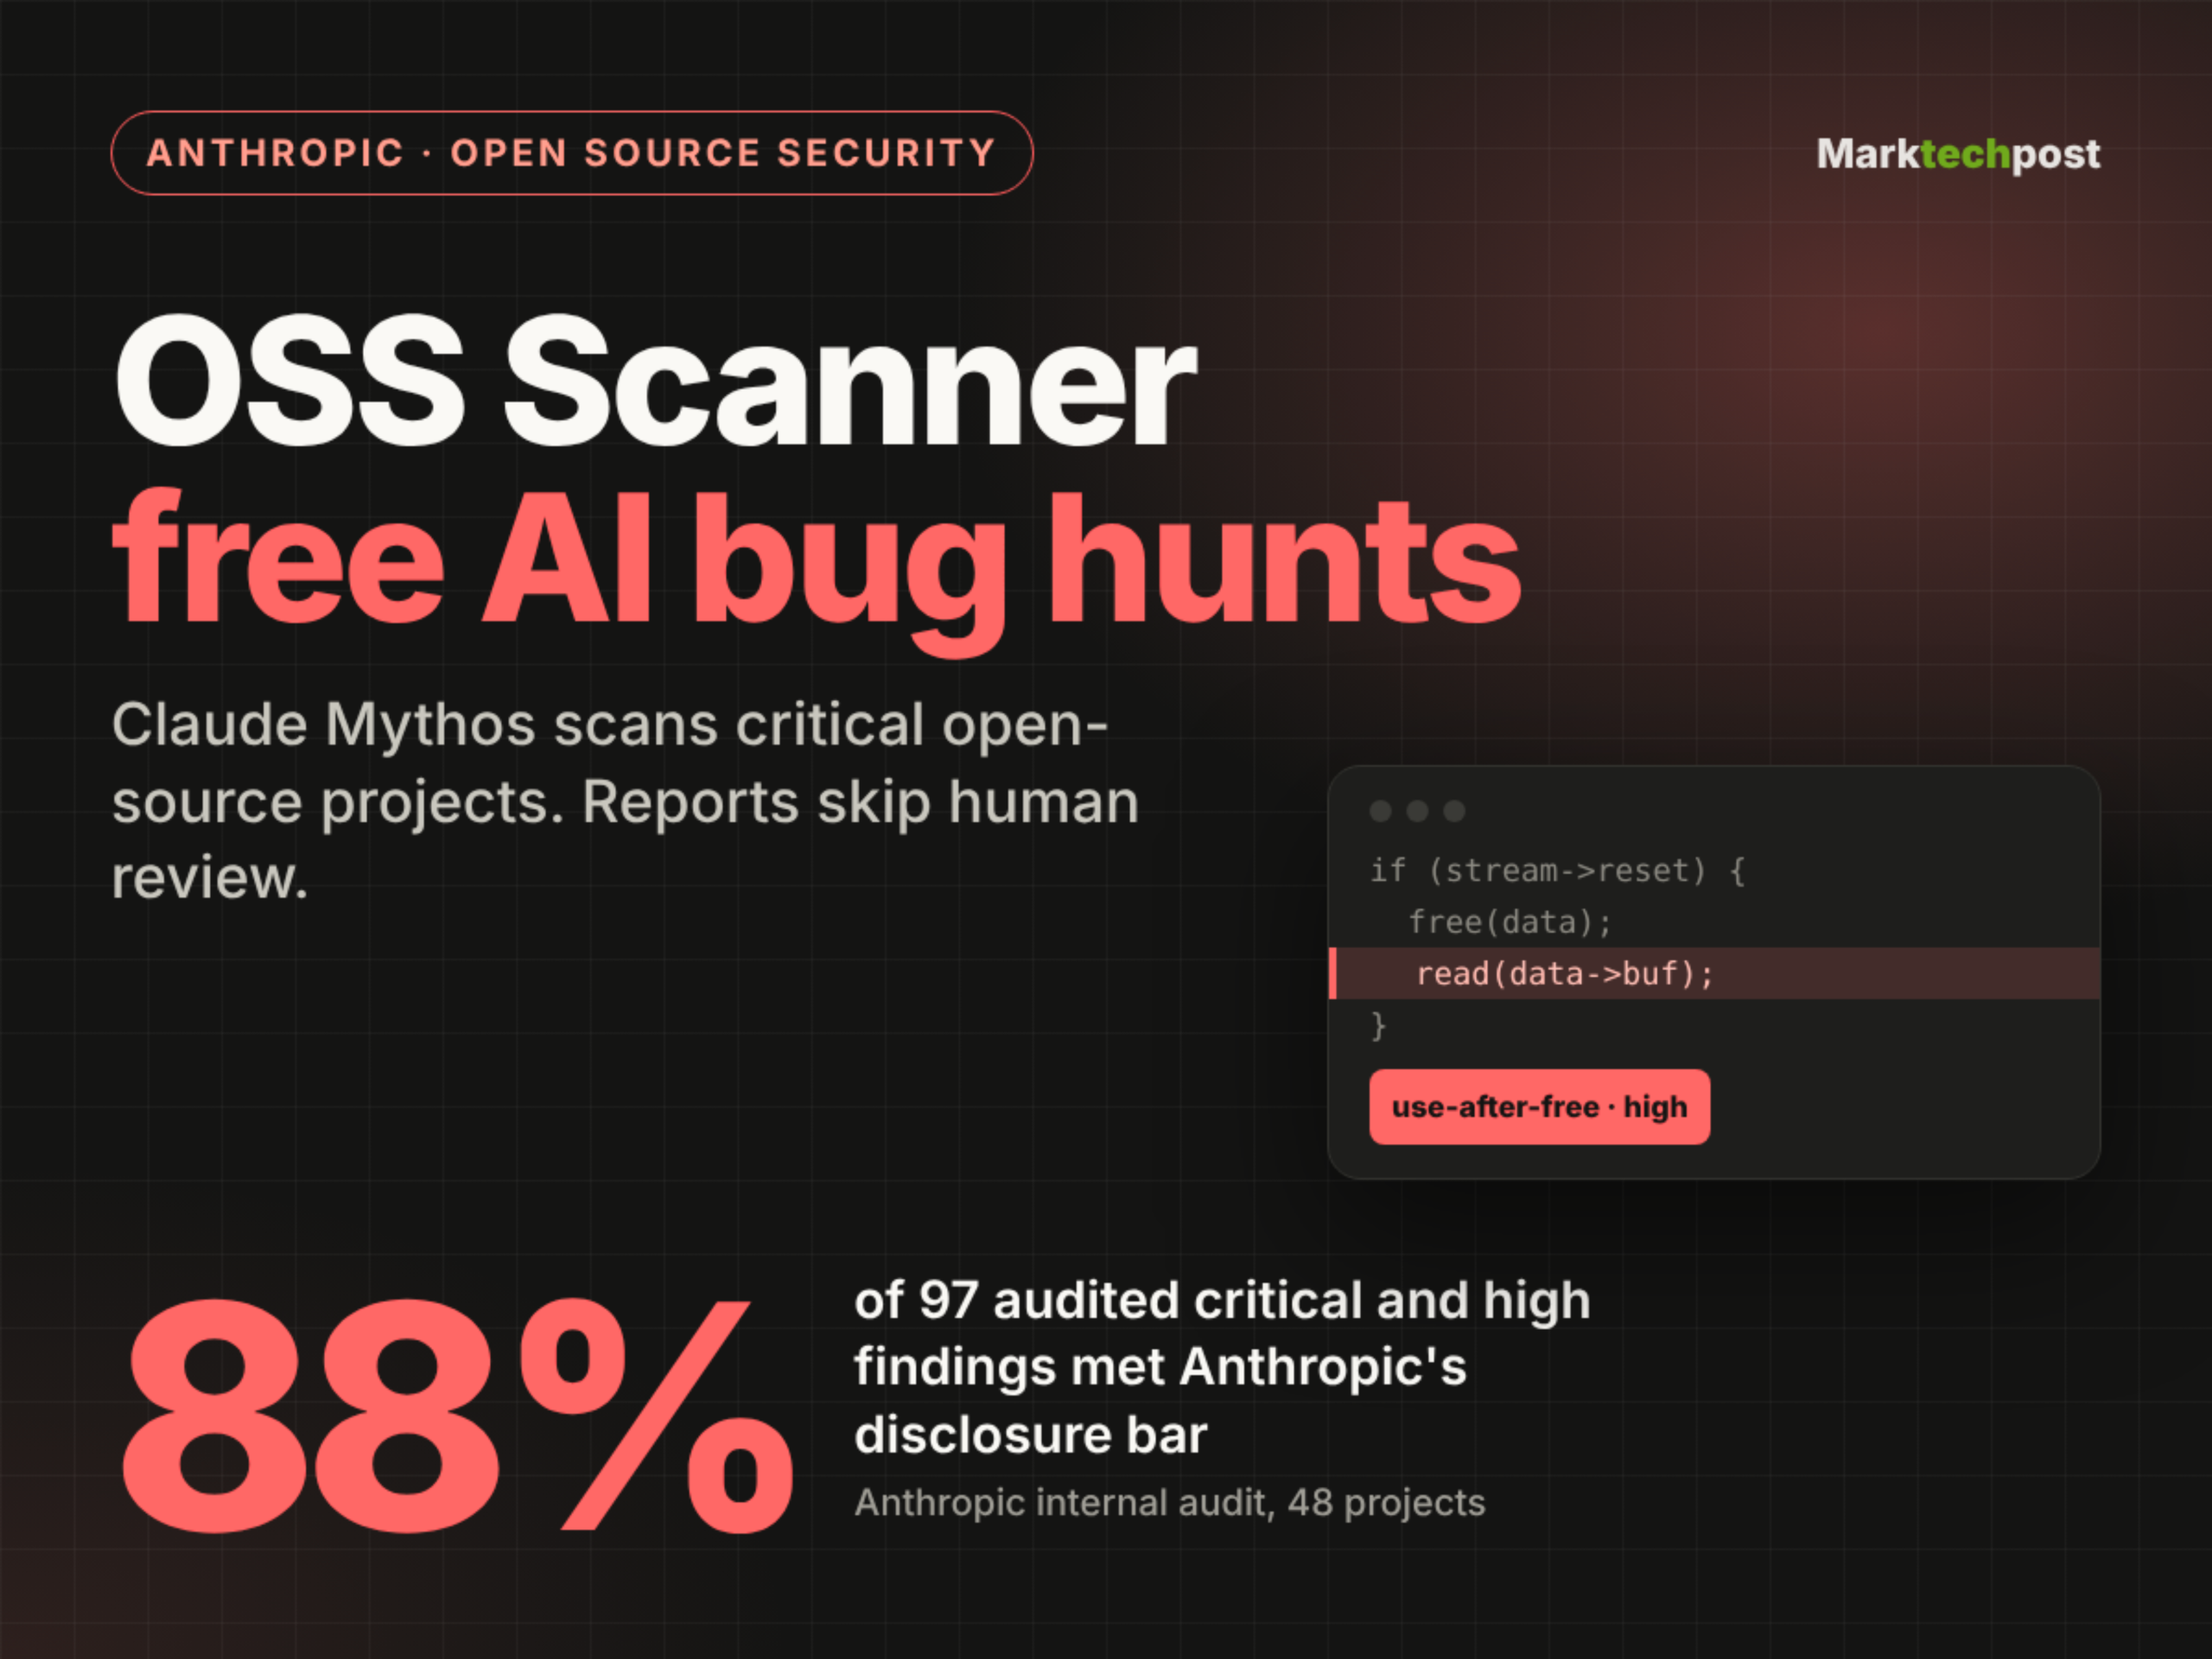
추천 이유:이 도구는 오픈소스 보안 분야에서 LLM의 대규모 적용 사례를 대표하며, 무비용·전자동·오프라인 감사를 특징으로 하지만, 인력 검토 단계를 생략함으로써 오보와 중복 문제 발생 위험을 초래합니다. 그 정확도 데이터(유효율 88%, 거짓양성률 1%)와 실제 프로젝트 피드백(예: wolfSSL, curl)은 현재 AI 기반 취약점 탐지 능력에 대한 실증적 기준을 제공합니다.
2026년 10월 24일, arXiv는 논문 arXiv:2610.30705v1을 발표하여, 인과적 디코더형 대규모 언어 모델을 위한 후처리 훈련 프레임워크인 ULME를 제안했습니다. 이 프레임워크는 예측 결합(predictive coupling) 메커니즘을 통해 텍스트 임베딩과 언어 생성 능력 간의 상호 강화적 통합을 최초로 구현했습니다. 해당 방법은 Qwen2.5/Qwen3 시리즈(0.5B–8B 파라미터)에서 검증되었으며, MTEB 지표에서 3.3–4.1점의 성능 향상을 달성하는 동시에, MMLU 등 생성 과제에서의 성능 저하를 방지했습니다.

추천 이유:이 논문은 현재 다중모달 LLM의 능력이 분절되어 있는 핵심 문제를 정면으로 지적한다: 임베딩과 생성은 오랫동안 독립된 모델 또는 파라미터만 공유하는 ‘가짜 통합’ 모델에 의해 담당되어 왔다. ULME는 학습 가능한 슬롯과 세 가지 목표를 결합한 공동 학습(스톱그레이디언트 예측 손실 포함)을 통해 생성 과정이 임베딩 표현을 주도적으로 형성하도록 하였으며, 이는 아키텍처 차원에서의 실질적인 획기적 발전이다. 실험 범위가 광범위하고 기준선이 강력하며 지표가 포괄적이며, 권위 있는 사전출판 플랫폼에 발표되어 시의성과 기술적 엄밀성이 모두 갖추어져 있다.
2026년 10월 24일, arXiv는 “ReflectPO: 장기 주기 LLM 에이전트를 위한 반성 유도 전략 최적화”라는 제목의 연구 논문(번호 2610.30933v1)을 발표했으며, 복잡하고 다단계이며 상태에 의존하는 작업에서 도구 기반 대규모 언어 모델 에이전트의 자율적 오류 복구 능력을 강화하기 위해 ReflectPO라는 강화학습 프레임워크를 제안했습니다.
추천 이유:이 논문은 최근 발표된 최첨단 AI 연구로, 현재 LLM 에이전트의 실용화에서 핵심적인 한계인 장기 작업에서 발생하는 초기 오류의 누적 효과에 초점을 맞추고 있다. 본 연구에서 제안한 Reflection-Guided Sampling과 Tree-Structured Credit Assignment의 이중 구성 설계는 방법론적 혁신성을 갖추고 있으며, 두 가지 도구 사용 벤치마크에서 여러 기준선을 상회하는 실증적 성과를 보여 기술적 참고 가치를 지닌다.
논문 arXiv:2610.30158v1은 2026년 10월 24일에 발표되었으며, 사우스캐롤라이나주 아카이브 데이터를 기반으로 미국 민권운동 시기의 역사를 탐구하는 데 특화된 최초의 디지털 어시스턴트인 Lighthouse를 소개합니다. 이 프로젝트의 핵심 혁신은 신뢰할 수 있는 콘텐츠와 사용자 피해 완화를 설계 원칙으로 삼고, 대규모 언어 모델과 규칙 기반의 기호적 해결 방식을 결합한 신경-기호 하이브리드 아키텍처를 채택한 점입니다.
추천 이유:이 연구는 AI를 활용한 역사 탐구를 민권운동이라는 민감하고도 핵심적인 역사적 시기로 처음으로 집중시켰으며, 일반형 챗봇과 구별되는 ‘신뢰성’과 ‘피해 모델링’의 이중 제약을 명확히 제시했다. 또한 그 방법론(신경-기호 통합), 평가 방식(전문가 합의를 바탕으로 구성된 주관식 문항의 골드 스탠다드 포함) 및 데이터 규모(원본 기록 1만 8천여 건 이상) 모두 학술적 모범 사례로서의 가치를 지닌다.
출시: battledrones v14: 컴퍼스 로즈, 4인용 맵 저는 Battledrones에 4인 온라인 모드를 추가했습니다—기존 맵들은 2인 전용이었습니다. 처음 사용한 프롬프트는 다음과 같습니다: 4인 전투를 위한 새 맵을 추가하십시오—4방향 회전 대칭, 최대 4명의 AI 플레이어 지원, WebSocket 기반 비음성 멀티플레이 모드와 호환되므로 최대 4명의 인간 플레이어가 참여할 수 있습니다(여유 슬롯은 AI로 채워집니다). Claude Opus 4.5에서는 “컴퍼스 로즈”라는 새 맵을 추가하고, 해당 맵에서 최대 4명의 플레이어를 지원하도록 WebSocket 멀티플레이 네트워크 코드를 수정했습니다. 공유 링크나 QR 코드를 통해 접속할 수 있습니다. 새로운 팀은 보라색과 초록색을 테마로 한 로봇을 사용하며, 기존의 파란색과 빨간색 디자인과도 조화를 이룹니다. 업데이트된 모델 브라우저에서 이러한 색상을 미리 확인하실 수 있습니다. 태그: 게임 디자인, 프로젝트, Claude
TechCrunch와 Fidelity Private Shares가 공동 주최하는 Founder Summit 2026은 2026년 11월 4일 보스턴 SoWa 파워 스테이션에서 개최되며, 제품-시장 적합성 검증, 창업자의 리더십, 지역화를 통한 규모 확장 전략 및 AI 네이티브 아키텍처 등 실무 중심의 주제에 초점을 맞춥니다. Toast, Bessemer, Glasswing 등 기관의 대표들이 현장 경험을 공유할 예정입니다.
2026년 10월 21일에서 22일을 전후한 약 48시간 동안, 전 세계적으로 고위험 AI 가속 취약점 및 침입 사건이 10여 건 이상 집중적으로 발생했으며, 이에는 PHP2Shell, GitLab RCE(CVSS 10), NGINX/HTTP/3 DoS, LiteLLM 비밀번호 탈취, eMudhra CA 키 유출, Quest Diagnostics 의료 데이터 노출 등이 포함된다. 또한 Storm-0940 등 국가 행위체는 ARTEX와 같은 오픈소스 지능형 침투 프레임워크를 활용해 대규모 공격을 감행했다. 같은 시기, 형식적 검증, 오픈소스 수정 에이전트, 에이전트 기술 표준화 및 하드웨어 수준 최적화 등을 포함한 AI 보안 방어 체계가 가속화되어 구축되고 있다.
앤드루 양은 AI 기반 사이버 공격이 곧 역사적으로 심각한 수준에 이를 것이라고 경고합니다. 우리는 지금 그 첫 징후를 목격하고 있는 것일까요?
OpenAI는 오프라인 환경과 고성능 컴퓨팅을 활용한 레드팀 공격 등을 포함해, 프런티어 모델 훈련 및 평가를 위한 격리 조치를 어떻게 강화했는지 설명합니다.
데 스타트 - 프리덤 (공식 뮤직비디오) 자, 이건 저에게는 처음이네요... 네덜란드의 얼터너티브 록 밴드 데 스타트의 이 새로운 뮤직비디오에서 00:44초 지점에 보면, 시각 효과는 Fake it or Leave it의 매티스 그루텐에게 공로가 있습니다. 해커 뉴스의 flir을 통해 태그: 음악, AI, 생성형 AI, 자전거를 타는 펠리컨
디스코드는 최근 업데이트를 통해 .md 파일을 업로드한 뒤의 미리보기 효과를 개선했습니다. 이제 마크다운 형식(표, 굵게 표시, 목록 등)을 정확히 렌더링하며, 더 이상 원시 문자 코드만 표시되지 않습니다.
전 JP모건의 에너지 파생상품 거래원인 아네카 소칼이 설립한 스타트업 모시는 상품·매크로 트레이더를 대상으로 한 실시간 AI 추천 엔진을 출시했으며, 다중 출처의 정형 및 비정형 시장 데이터를 통합하고, 심층 워크플로우 결합, 사설 모델 구축 및 신뢰할 수 있는 신호 추출을 강조합니다. 현재 초기 단계로, 공개된 투자 유치, 매출 또는 사용자 데이터는 없습니다.
NVIDIA는 유럽 여러 국가의 정부 및 기술 파트너들과 협력하여, Nemotron 등 오픈소스 대규모 모델과 합성 페르소나 데이터셋을 기반으로 독일, 폴란드, 영국, 프랑스, 그리스 등에서 주권이 보장된 AI 애플리케이션을 추진하고 있으며, 이는 의료 영상 분석, 고용 서비스, 디지털 정부 비서, 분류 정보 처리 및 현지화된 언어 모델링 등의 분야를 포괄합니다.
이 문서에서는 AI 에이전트 시스템에서 stateful(상태 유지형)과 stateless(무상태형) 아키텍처의 핵심 차이점을 탐구하고, 이들이 확장성, 내결함성 및 컨텍스트 연속성에 미치는 실제 영향을 분석한 뒤, n8n 플랫폼을 사례로 들어 메모리 노드(Memory nodes)와 상태 저장소(state stores)를 계층적으로 설계하여 유연하고 제어 가능한 상태 관리를 구현하는 방법을 설명합니다.
AI 스타트업 Recursive는 오픈소스 코딩 모델 Flint를 출시했으며, 개발 과정의 대부분이 자체 개발한 AI 연구 시스템 Eureka Machine에 의해 이루어졌다고 밝혔다. 이 모델은 파라미터 수가 400억 개에 불과하며, 실제 테스트에서 활성화 수는 25억 개로 확인되었고, M4 Pro MacBook과 같은 일반 노트북에서도 오프라인으로 실행 가능하다. 추론 속도는 초당 131 토큰에 달하며, SWE-Bench 등 벤치마크 테스트에서 동급 규모의 대부분 모델보다 우수한 성능을 보였다.
NVIDIA는 사전 훈련된 관계형 기반 모델인 Kumo Relational을 출시했으며, 이 모델은 기업용 관계형 데이터베이스에서 이탈 예측, 사기 탐지, 수요 예측 등 다양한 예측 작업을 직접 수행할 수 있습니다. 작업 미세조정, 특성 엔지니어링 또는 테이블 평탄화가 필요하지 않습니다. 15개 데이터베이스에 걸친 41개의 벤치마크에서 XGBoost 등 감독 학습 모델을 전면적으로 능가했으며, SAP SALT 기업 벤치마크에서는 MRR 지표에서 AutoGluon보다 8% 앞섰습니다. 또한 5,000억 행 규모의 데이터베이스를 지원하며, Predictive Query Language(PQL)를 통해 코드 없이 예측 호출을 구현할 수 있습니다.