
듣는 기계 만들기
파리스 스마라그디스 교수는 음성 인식, 음악 이해, 환경 모니터링 등 다양한 분야에 활용될 초인간 수준의 청력을 갖춘 컴퓨터를 개발하고 있습니다.

제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.
파리스 스마라그디스 교수는 음성 인식, 음악 이해, 환경 모니터링 등 다양한 분야에 활용될 초인간 수준의 청력을 갖춘 컴퓨터를 개발하고 있습니다.
arXiv:2610.32104v1 발표 유형: 신규 초록: 변환기 아키텍처의 능력과 한계를 규명하기 위해 여러 가지 형식적 이론들이 개발되어 왔으며, 각 이론은 아키텍처의 서로 다른 특징을 포착하는 다양한 추상화 방식을 사용한다. 이러한 이론들은 기본 가정과 개념적 틀의 차이로 인해, 변환기가 어떤 과제를 쉽게 또는 어렵게 여길지에 대한 예측에서 서로 상충될 수 있다. 우리는 변환기 능력에 관한 일곱 가지 이론(Star-free, $\mathsf{AC}^0$, $\mathsf{TC}^0$, C-RASP, MPC, BAPO, 그리고 Sensitivity)을 정리하고, 이를 다양한 계산 구조를 포괄하는 여러 과제 세트에 걸쳐 공통적인 예측 매트릭스로 변환하였다. 또한 이 매트릭스를 완성하기 위한 새로운 이론적 결과를 제시한다. 이후 우리는 이론적…
arXiv:2610.31911v1 발표 유형: 신규 초록: 대규모 언어 모델(LLMs)이 점점 더 긴 시퀀스를 처리함에 따라, 주의 메커니즘은 주요 계산 병목으로 부각되고 있습니다. 희소 주의는 대부분 추론 단계에 초점을 맞추지만, 여전히 많은 방법들이 밀집형으로 학습되거나 희소 학습을 지원하지 못하며, 추가적인 복잡성으로 인해 희소성이 실제 월클럭 속도 향상으로 이어지기 어려워져 결국 실무에서는 밀집형 주의가 널리 사용되고 있습니다. 본 논문에서는 주의 학습이 후방 패스에 의해 주로 결정된다는 관찰에 기반한 전방 밀집·후방 희소 주의 방식인 LazyFlash를 제안합니다. LazyFlash는 전방 패스를 정확히 밀집형으로 유지하여, 학습된 모델이 vLLM과 같은 기존 시스템에서 아무런 변경 없이 서비스할 수 있는 표준 밀집형 모델로 남도록 합니다. 후방 패스에 대해서는 LazyFlash는 그라디언트-a를 제안합니다.
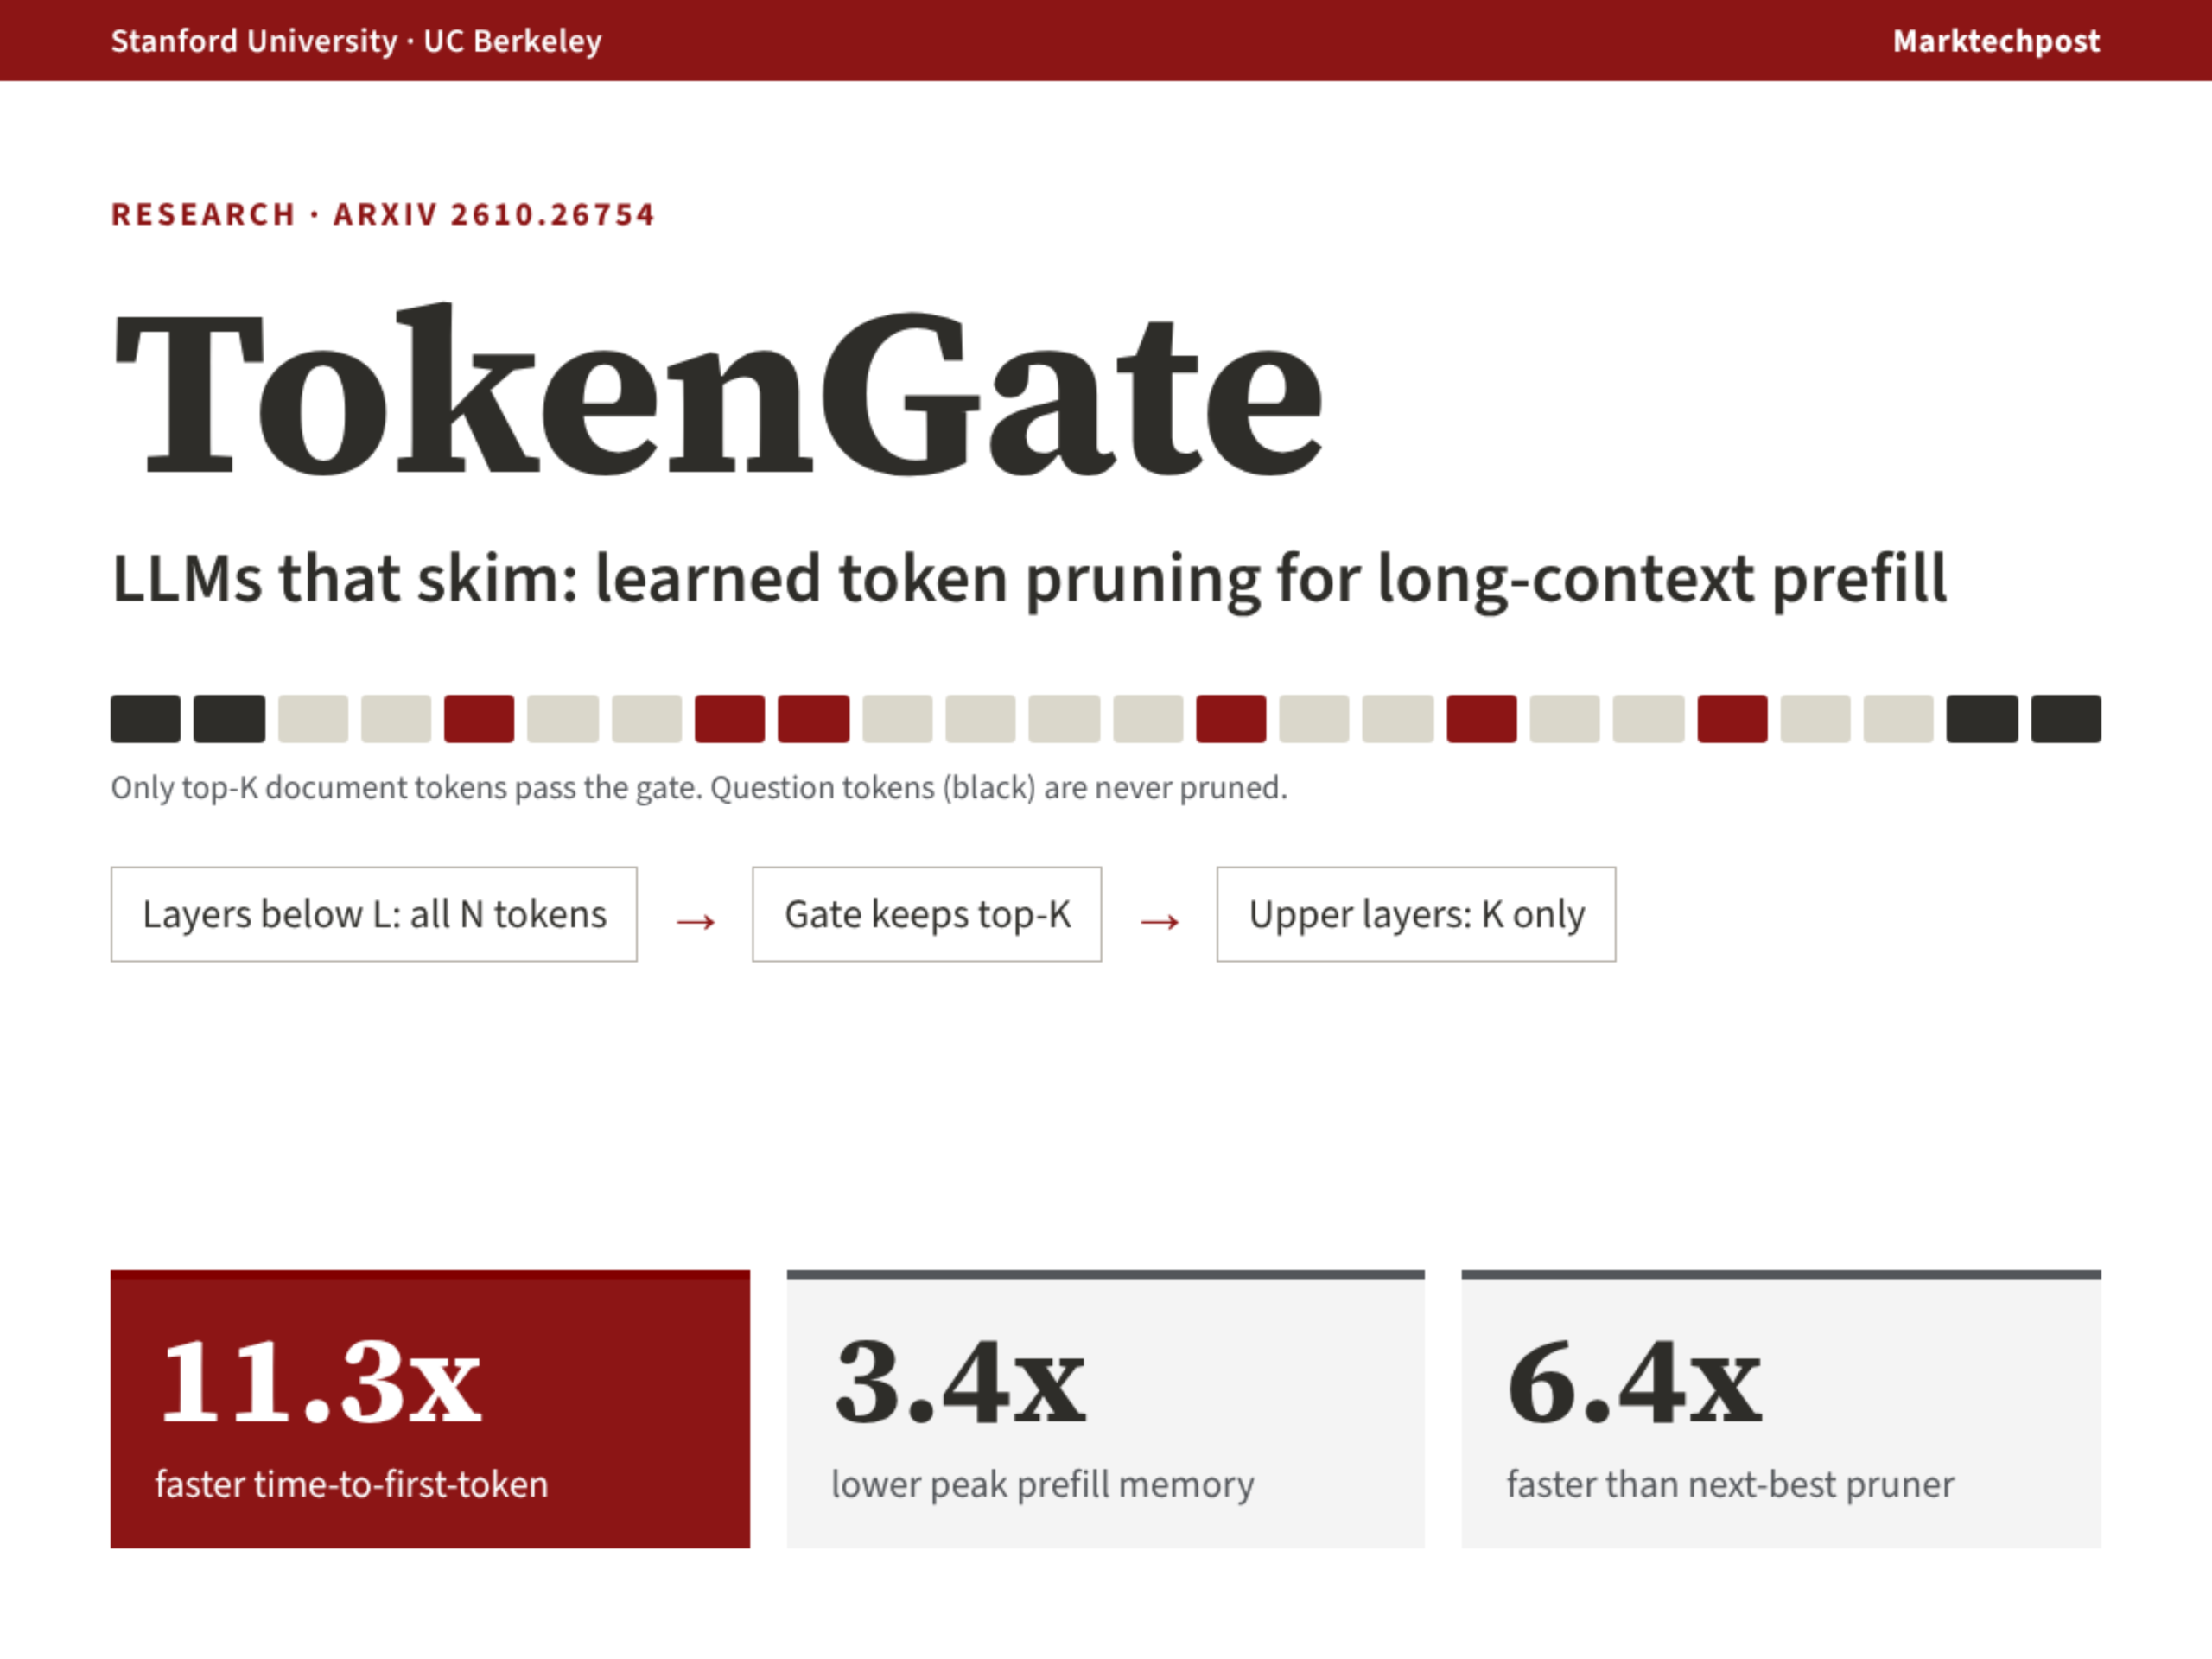
스탠퍼드 대학교와 캘리포니아 대학교 버클리 캠퍼스의 연구진은 기존 대규모 언어 모델(LLM)에 적용 가능한 플러그 앤 플레이 방식의 학습형 토큰 가위 모듈인 TokenGate를 제안했습니다. 이 방법은 정확도를 유지하면서, 긴 컨텍스트를 사전 채워 넣는 첫 글자 생성 시간(TTFT)을 1.4배에서 최대 11.3배까지 가속화하고, 최대 메모리 사용량을 1.5배에서 최대 3.4배까지 절감합니다. 관련 코드와 체크포인트는 오픈소스로 공개되었습니다.
arXiv:2610.30296v1 발표 유형: 신규 초록: 대규모 언어 모델(LLMs)은 저자원 및 다국어 NLP에 대한 연구를 가속화했지만, 이들이 공평한 연구 환경을 조성하는 데 얼마나 효과적인지는 아직 명확히 규명되지 않았습니다. 우리는 2020년부터 2025년까지 출판된 1,158편의 동료 심사 오픈 액세스 논문을 분석하여, 저자원 언어(LRLs)에 대한 연구 관심도와 언어 및 사용자 집단 전반에 걸친 표현 수준을 검토합니다. 출판 건수 외에도 언어적 포용성을 평가하기 위해, 우리는 언어적 포용성 프레임워크(LIF)를 도입합니다. 이는 연구 성장, 표현 확대, 표현 지속성, 그리고 분포적 형평성 등 네 가지 차원에서 언어적 포용성을 측정하는 다차원적 체계입니다. 연간 출판물 수는 52건에서 415건으로 5.4배 증가했으며, ACL Antholo

PyTorch 2.15는 Apple Silicon 맥을 위한 주요 MPS 백엔드 업그레이드를 제공하며, macOS에서 처음으로 FP8 텐서 연산을 네이티브로 지원합니다. 또한 MoE 모델의 디코딩 속도가 5~6.5배 향상되고, 비디오 VAE 디코딩 시 최대 GPU 메모리 사용량이 270 GiB에서 8 GiB로 감소하며, 다수의 연산자들이 MPSGraph에서 전용 Metal 커널로 이전되었습니다.