
[AINews] Gemini 4 Carbon, 리더보드 정상에 오르며 사이버 방어자들을 위한 출시를 시작
구글의 새로운 프론티어 모델이 독립 평가에서 선두를 달리고 있으며, 초기 접근 권한은 신뢰받는 방어자들에게만 제한됩니다.
제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.
구글의 새로운 프론티어 모델이 독립 평가에서 선두를 달리고 있으며, 초기 접근 권한은 신뢰받는 방어자들에게만 제한됩니다.
Mirendil은 1,000만 토큰의 컨텍스트 창을 갖춘 처음으로 개발한 모델인 Fern 0.1을 출시했습니다. 이 모델은 에이전트형 AI 연구개발 작업을 목표로 하며, 1,000만 토큰 기준 RULER 단일 바늘 테스트에서 100% 점수를 기록했지만, 에이전트형 코딩에서는 최첨단 모델들에 비해 뒤처집니다. 해당 게시물 “Mirendil, 1,000만 토큰 컨텍스트를 갖춘 첫 번째 모델 Fern 0.1 출시”는 MarkTechPost에 처음 게재되었습니다.
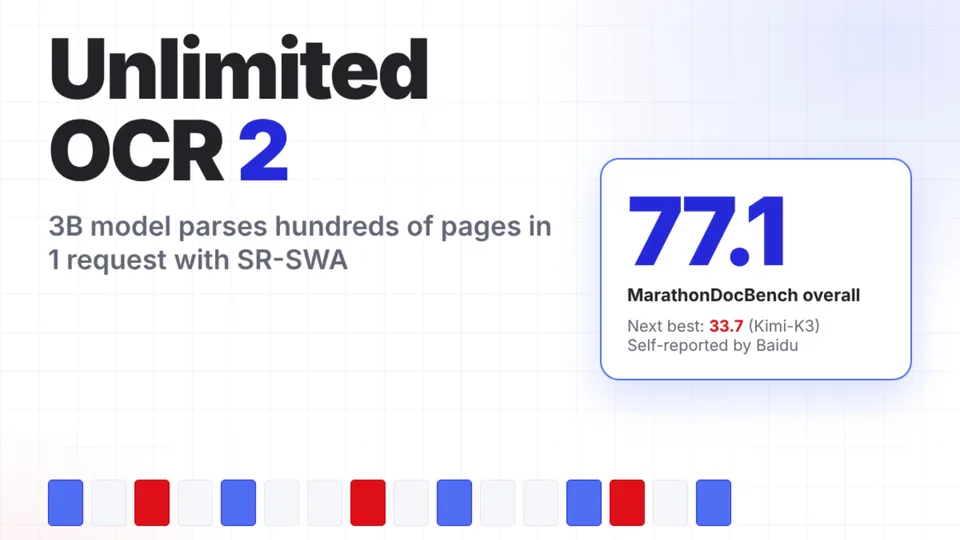
바이두는 MIT 라이선스를 적용한 3B 규모의 OCR 모델인 ‘Unlimited OCR 2’를 출시했으며, 이 모델은 한 번의 요청으로 수백 페이지에 달하는 문서를 처리할 수 있습니다. 해당 모델의 SR-SWA 주의 메커니즘은 단계별 디코딩 비용을 거의 일정하게 유지하며, MarathonDocBench에서 77.1점의 성능을 기록했습니다. 본 글은 ‘바이두, 수백 페이지 문서 파싱을 위한 Unlimited OCR 2 오픈소스화’라는 제목으로 MarkTechPost에 처음 게재되었습니다.
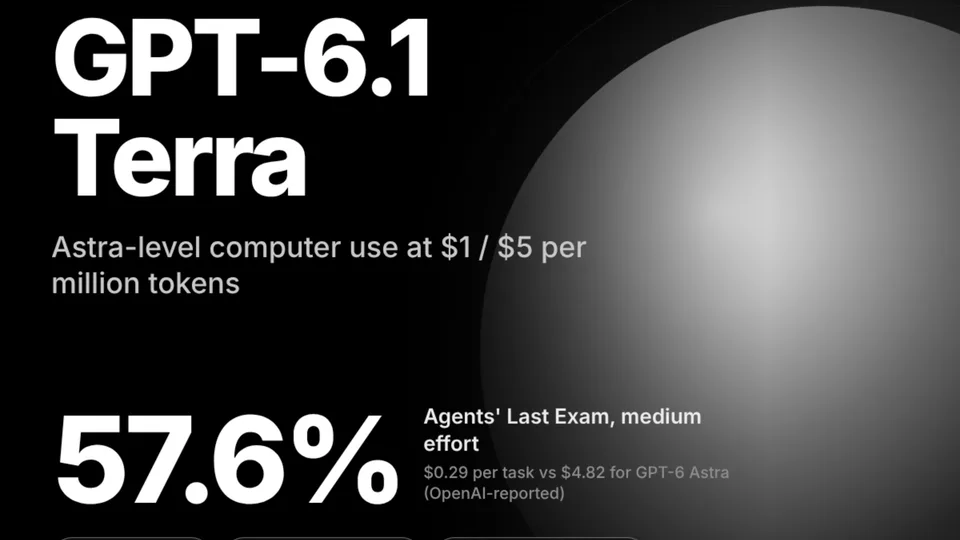
OpenAI는 GPT-6.1 Terra를 출시했으며, 이 모델은 매 백만 토큰당 1달러/5달러의 가격으로 제공되는 고속 컴퓨터 사용 및 비전 모델입니다. 이 모델은 GPT-6 Astra의 중간 수준 노력 기반 에이전트들의 최종 시험 점수를 달성하며, 작업당 비용은 0.29달러로, 기존의 4.82달러에 비해 크게 낮아졌습니다. 해당 게시물인 “OpenAI, GPT-6.1 Terra 출시… 에이전트 작업 시 GPT-6.1 Sol의 API 가격 절반”은 MarkTechPost에 처음 게재되었습니다.
arXiv:2610.32215v1 발표 유형: 신규 초록: 현대 GPU 데이터 센터의 컴퓨팅 파워 증가로 인해 일부 산업 거대 기업들이 대규모 데이터를 활용하여 대형 언어 모델(LLM)을 훈련하고 배포할 수 있게 되었습니다. 그러나 이러한 모델과 그 학습 데이터의 엄청난 규모는 중앙 집중식 개발을 점점 더 지속하기 어렵게 만들고 있으며, 동시에 관련된 개인 데이터를 보유하되 이에 상응하는 인프라를 갖추지 못한 소규모 기관들을 배제하고 있습니다. 본 논문에서는 분산형 LLM 훈련에 관한 우리의 입장을 사전 학습 및 미세 조정 패러다임을 중심으로 정리하고, 연합 학습, 분할 학습 및 탈중앙화 접근법을 다루며, 이들 방법이 이질적인 하드웨어와 신뢰성 낮은 연결성을 가진 지리적으로 분산된 환경에서 어느 정도 준비되어 있는지 평가합니다. 이어서 우리는 {\em 통합}된 시스템을 제시합니다
