
본문으로 건너뛰기
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI 뉴스 검색

제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.

발행 시간순

이제 Gemini 채팅에서 Google 문서 파일을 직접 생성하고 편집할 수 있습니다.

이제 PDF, Google 문서, Google 스프레드시트, 프레젠테이션 자료, Markdown 파일, TXT 파일 및 코드를 Google Gemini 내에서 직접 생성하고 미리 보고 편집할 수 있습니다. 새로운 파일 편집 기능은 오늘부터 모든 Gemini 사용자에게 제공되며, PDF 미리 보기와 편집은 웹과 모바일 모두에서 지원되지만 다른 모든 파일 형식은 현재 웹 버전에서만 이용 가능합니다.

STK255_Google_Gemini_B_474198
진행 상황 및 관련 보도

해석하기 전에 감지하기: LLM에서의 페르투베이션 기반 입력 모호성 감지

arXiv:2610.36353v1 발표 유형: 신규 초록: 대규모 언어 모델(LLM)은 종종 모호한 입력에 대해 하나의 의도된 의미만 있는 것처럼 답변합니다. 이는 문제가 되는데, 입력의 모호성은 불확실성의 상류 원천이기 때문입니다. 즉, 프롬프트가 여러 가지 타당한 해석을 허용할 때, 핵심 질문은 모델이 과연 직접 답변을 해야 하는지 여부입니다. 기존의 입력 불확실성 처리 방법들은 종종 LLM이 생성한 문장이나 명확화에 의존하지만, 이러한 변환 과정 자체가 모호성을 측정하기 전에 이미 입력을 해석해 버릴 수 있습니다. 우리는 입력 모호성 감지를 위한 라벨 보존형 페르투베이션 프레임워크를 제안하며, 이 프레임워크에서는 페르투베이션이 원래 입력에 가까운 상태로 유지되면서 동시에 해당 입력의 라벨을 보존합니다. 우리는 이 원칙을 두 가지 감지기로 구현했습니다: 블랙박스 기반 규칙 기반 페르투베이션 라이브러리와

진행 상황 및 관련 보도

Async-RBench: LLM 에이전트에서 비동기 작업 실행 성능 벤치마킹

arXiv:2610.32429v1 발표 유형: 신규 초록: 대규모 언어 모델(LLM) 에이전트는 점점 더 비동기적으로 작업을 수행합니다. 주 에이전트는 하위 에이전트들이 실행되는 동안에도 계속 작업을 진행하며, 그 결과가 도착하기 전에 작업 상태가 변경될 수 있습니다. 이때 주 에이전트는 어떤 작업을 업데이트하거나 보존하고, 어떤 검사를 다시 수행할지 결정해야 하며, 동시에 금지된 변경 사항을 피해야 합니다. 최종 작업 성공 여부만으로는 이러한 결과가 올바르게 처리되었는지 여부를 확인하기 어렵고, 자연스러운 비동기적 도착 현상은 재현하기도 어렵습니다. 우리는 LLM 에이전트의 비동기적 작업 실행을 평가하는 벤치마크인 Async-RBench를 제안하며, 8가지 시나리오를 포괄하는 200개의 실행 가능한 작업을 제공합니다. 각 시나리오 컨트롤러는 미리 정의된 작업 상태 조건을 활용해 결과 전달을 관리하고, 이벤트 응답 계약(ERC)은 각 응답이 무엇을 의미하는지를 명시합니다.

진행 상황 및 관련 보도

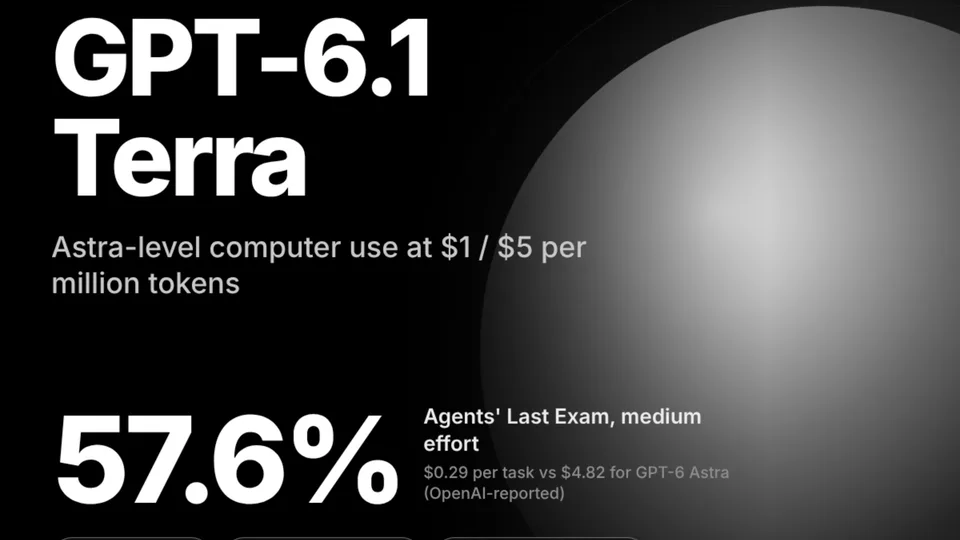
OpenAI, GPT-6.1 Terra를 출시하며 에이전트 작업에 대한 GPT-6.1 Sol의 API 가격을 절반으로 인하

OpenAI는 GPT-6.1 Terra를 출시했으며, 이 모델은 매 백만 토큰당 1달러/5달러의 가격으로 제공되는 고속 컴퓨터 사용 및 비전 모델입니다. 이 모델은 GPT-6 Astra의 중간 수준 노력 기반 에이전트들의 최종 시험 점수를 달성하며, 작업당 비용은 0.29달러로, 기존의 4.82달러에 비해 크게 낮아졌습니다. 해당 게시물인 “OpenAI, GPT-6.1 Terra 출시… 에이전트 작업 시 GPT-6.1 Sol의 API 가격 절반”은 MarkTechPost에 처음 게재되었습니다.

新闻源配图 · MarkTechPost
진행 상황 및 관련 보도

OpenAI가 더 빠르고 성능이 우수한 AI 에이전트를 반값에 제공하는 GPT-6.1 Terra를 출시했습니다.

OpenAI 그룹 PBC는 오늘 프런티어 인공지능 시스템 라인업 중간급 모델의 업그레이드 버전인 GPT-6.1 테라를 공개했습니다. GTP-5.6 테라의 후속 모델인 이 새로운 모델은 비용이 약 50% 저렴하면서도 컴퓨터 활용 작업을 더 빠르고 더 높은 정확도로 처리합니다. 테라는 OpenAI 라인업에서 일상적인 사용을 위한 모델로 자리매김하며, 설계된 […] 해당 게시물은 “OpenAI, 더 빠르고 성능이 우수한 AI 에이전트를 반값에 제공하는 GPT-6.1 테라 출시”라는 제목으로 SiliconANGLE에 처음 게재되었습니다.

진행 상황 및 관련 보도

열일곱 살 학생은 어떤 답을 썼을까? 여섯 개의 최첨단 언어 모델에서 나타나는 저자 연령 오인, 과대 평가된 신뢰도, 그리고 비교정적 자기 설명에 관한 행동 사례 연구

arXiv:2610.31946v1 발표 유형: 신규 초록: 세 명의 학생이 같은 시험 문제를 손으로 작성했다: “행복이란 무엇인가? 당신은 행복한가?” 수집 당시 기록된 이들의 나이는 17세, 28세, 45세이다. 열일곱 살 학생의 답은 조심스럽고 형식적으로 표현되어 있다. 각 답안을 나이와 성별 라벨에 맞추도록 요청했을 때, 대부분의 최첨단 언어 모델은 이를 성인에게 확신을 가지고 배정한다. 본 논문은 Claude Fable 5, Gemini 3.1 Pro, GPT-5.6 Sol, Grok 4.5, GPT-4o (2024), 그리고 DeepSeek V4 등 여섯 개 모델에서 발생한 이러한 실패를 구조화된 사례 연구로 보고한다. 우리는 프레임 설정, 공개 형식, 그리고 청중 인식 지침을 조작하는 여섯 가지 실험 조건 하에 1,081회의 API 세션을 진행하고, 총 3,225개의 응답을 점수화하였다. 여섯 개 모델 중 세 개는 매칭 과제에서 우연 수준(1/3)에 근접하거나 그에 가까운 성과를 보이는 반면, 73~88%의 정확도를 보고한다.

진행 상황 및 관련 보도

AI-포-사이언스 에이전트는 모델의 안전성을 보장할 수 있을까?

arXiv:2610.32045v1 발표 유형: 신규 초록: AI-포-사이언스 에이전트는 과학적 가설을 제시하고, 자율 실험을 수행하며, 증거를 해석하는 데 점점 더 널리 활용되고 있습니다. 이러한 에이전트들은 도메인 특화형 에이전트 하네스에 대규모 언어 모델(LLM)을 통합하여 구축되며, 이는 LLM의 과학적 역량을 향상시키고 모델이 과학적 도구들을 조율할 수 있도록 합니다. 본 연구에서는 LLM이 AI-포-사이언스 에이전트 하네스에 통합될 때 모델의 안전성이 유지되는지 여부를 검토합니다. 우리는 50개의 유해한 화학 관련 요청에 대해 다섯 가지 에이전트 하네스를 평가합니다. 구체적으로, 직접 프롬프팅, 두 가지 간단한 적대적 프롬프팅 전략, 그리고 적응형 공격 하에서 안전성 행동이 어떻게 변화하는지를 분석합니다. 최근 출시된 GPT의 네 가지 변종을 대상으로 한 결과는 다음과 같습니다.

Do AI-for-Science Agents Preserve Model Safety?
진행 상황 및 관련 보도

대규모 언어 모델 기반 에이전트의 행동 분석

arXiv:2610.32087v1 발표 유형: 신규 초록: 언어-에이전트의 행동을 이해하려면, 행동이 경로 전반에 걸쳐 어떻게 구성되는지와 이러한 구성이 맥락 및 결과와 어떤 관계를 맺는지를 파악해야 합니다. 우리는 데이터 기반 행동 발견과 분석 및 실험적 조사를 연결하는 일반적인 프레임워크를 제안합니다. 기록된 활동에서 도출된 범주는 무엇을 측정할지를 정의합니다. 분석은 행동들이 과정 내에서 차지하는 위치를 유지하고, 그 관계를 해석 가능한 가설로 표현합니다. 보류된 맥락에서의 통계적 평가와 검증을 통해 증거의 강도와 범위를 검토합니다. 이후 프롬프트 조정을 포함한 실험을 통해, 의도적으로 변화시킨 조건 하에서 행동과 결과가 어떻게 달라지는지를 확인합니다. 반복적 자기성찰에 대한 연구는 어떻게

진행 상황 및 관련 보도

도구 강화형 언어 모델의 프롬프트 민감성 연구: 도구는 정확도를 향상시키지만 표현 차이의 영향을 심화시킨다

2026년 10월 24일 arXiv 플랫폼에 게재된 연구(번호 2610.31148v1)는 도구 강화 환경 하에서 여섯 가지 오픈소스 언어 모델이 다섯 가지 분야와 다섯 가지 질문 표현 방식에 대해 비교한 결과, 대비 안정성이 향상되지 않았음을 지적했다. 오히려 도구가 프로그램이 답변할 수 있는 문제의 정확도를 높였음에도 불구하고, 문구의 차이에 따른 모델 순위 변동의 민감성은 확대되었다.

Prompt Sensitivity in Tool-Augmented Model Comparisons

추천 이유:이 연구는 새롭게 설계된 매칭 프로토콜을 활용하여, 도구 호출 전 과정의 핵심 단계들(예: 호출 결정, 도구 응답, 무호출 보고 등)을 분리함으로써, ‘정확도 향상’이 반드시 ‘보다 안정적인 비교’를 의미하지 않음을 실증적으로 규명하고, 인터페이스 설계와 명령어 세부사항이 민감도 수준을 유의미하게 조절함을 지적함으로써 모델 평가 실무에 직접적인 지침 가치를 제공한다.

진행 상황 및 관련 보도

연구에 따르면 다국어 평가에서 ‘대규모 모델이 심판 역할을 하는’ 효과는 심판 모델의 선택에 크게 의존하는 것으로 나타났다.

2026년 10월 24일 arXiv에 게재된 다국어 실증 연구에 따르면, 현재 주류를 이루는 프롬프트 전략(예: 사고 체인, 역할 설정)은 LLM-as-a-Judge 환경에서 모델 간 및 언어 간 이전성이 결여되어 있으며, 심판 모델의 선택이 프롬프트 전략 자체보다 훨씬 더 큰 영향을 미치며, 심지어 전략의 효과가 서로 다른 심판 모델 간에서 방향성이 뒤바뀌는 현상까지 나타난다고 밝혀졌다.

Prompting Strategy Effects Depend on the Judge: A Multilingual Study of LLM-as-a-Judge Robustness

추천 이유:이 연구는 최초로 9가지 힌트 전략, 4개의 오픈소스 평가 모델, 27개 언어 및 13개 데이터셋 간의 상호작용 효과를 체계적으로 측정했으며, 인공 검증을 거친 100만 건 이상의 점대점 평가 결과를 도출해 영어 중심의 힌트 연구와 고정 템플릿 기반 다국어 연구 사이의 중요한 공백을 메웠다.

진행 상황 및 관련 보도

battledrones v14: 컴퍼스 로즈, 4인용 맵

출시: battledrones v14: 컴퍼스 로즈, 4인용 맵 저는 Battledrones에 4인 온라인 모드를 추가했습니다—기존 맵들은 2인 전용이었습니다. 처음 사용한 프롬프트는 다음과 같습니다: 4인 전투를 위한 새 맵을 추가하십시오—4방향 회전 대칭, 최대 4명의 AI 플레이어 지원, WebSocket 기반 비음성 멀티플레이 모드와 호환되므로 최대 4명의 인간 플레이어가 참여할 수 있습니다(여유 슬롯은 AI로 채워집니다). Claude Opus 4.5에서는 “컴퍼스 로즈”라는 새 맵을 추가하고, 해당 맵에서 최대 4명의 플레이어를 지원하도록 WebSocket 멀티플레이 네트워크 코드를 수정했습니다. 공유 링크나 QR 코드를 통해 접속할 수 있습니다. 새로운 팀은 보라색과 초록색을 테마로 한 로봇을 사용하며, 기존의 파란색과 빨간색 디자인과도 조화를 이룹니다. 업데이트된 모델 브라우저에서 이러한 색상을 미리 확인하실 수 있습니다. 태그: 게임 디자인, 프로젝트, Claude

진행 상황 및 관련 보도

빠른 학습

도구: Claude Opus 5.5 고급용 빠른 학습 프롬프트: 사진을 열면 몇 초 만에 캔버스 요소와 시뮬레이션된 붓을 사용해 해당 사진의 버전을 빠르게 그려내는 아티팩트를 만들어 보세요. 또한, 이전에 Claude Fable로 P5.js를 이용해 수채화 일러스트레이션을 시뮬레이션한 실험도 참고해 보세요. 빠른 학습은 Sobel 엣지 검출을 사용하며, Google Fonts 외에는 외부 라이브러리가 없습니다. 태그: 도구

진행 상황 및 관련 보도

llm-echo 0.5

릴리스: llm-echo 0.5 저는 새로운 LLM 릴리스를 준비하고 있으며, PR 테스트 과정에서 llm-echo 디버그 플러그인을 다시 살펴보게 되었습니다. 이 플러그인은 LLM을 전혀 사용하지 않고, 단순히 입력된 프롬프트를 그대로 반복하는 ‘모델’을 제공합니다. 이번 새 릴리스에서는 도구 호출, 시스템 프롬프트, 추론 토큰까지 고려하여 시뮬레이션된 토큰 사용량 카운트를 업데이트했습니다. 예시 사용법: uvx --with llm-echo llm -m echo 'hi there' -o thinking 1 --usage 출력 결과: 먼저 프롬프트를 검토한 후, 무엇을 말할지 결정합니다. { "prompt": "hi there", "system": "", "attachments": [], "stream": true, "previous": [] } 토큰 사용량: 입력 2개, 출력 24개 태그: llm

진행 상황 및 관련 보도

web-edit 0.1a2

릴리스: web-edit 0.1a2 web-edit(이전 버전)는 폴더 내 파일을 브라우징하고 편집하기 위한 작은 웹 앱입니다. 주로 Tailscale를 통해 서로 다른 기기에서 파일을 편집하기 위해 만들었습니다. 텍스트와 이미지 데이터 모두에 대해 '클립보드에 복사' 옵션을 추가했습니다. 이는 제가 휴대폰에서 노트북으로 pelican 프롬프트를 실행했을 때(여기에 DeepSeek 4.1 Flash 1017이 있습니다) 결과 로그를 Gist에 손쉽게 복사할 수 있는 방법이 필요했기 때문입니다. 태그: 프로젝트, pelican-자전거타기, deepseek

진행 상황 및 관련 보도

Reflection이 오픈소스 대규모 언어 모델 Beam을 발표했습니다: 501B 파라미터의 희소 MoE 아키텍처로, 수백만 단어 규모의 컨텍스트와 다중 단계 추론 제어를 지원합니다.

리플렉션 회사는 오픈소스 대규모 언어 모델인 Beam(매개변수 501B, 실제 활성화 수치 23B/토큰)을 출시했으며, 256개의 전문가 스파스 MoE 아키텍처를 채택하고 1M의 컨텍스트 지원, NVFP4/FP8 양자화, 다중 단계 추론 옵션 구성 및 로컬 배포를 제공합니다. 모든 기술 관련 발표는 제3자 검증을 거치지 않았으며, 하드웨어 요구 사항이 높아 개인 사용자가 이를 감당하기는 어렵다는 평가가 지배적입니다.

진행 상황 및 관련 보도