
본문으로 건너뛰기
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI 뉴스 검색

제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.

발행 시간순

해석하기 전에 감지하기: LLM에서의 페르투베이션 기반 입력 모호성 감지

arXiv:2610.36353v1 발표 유형: 신규 초록: 대규모 언어 모델(LLM)은 종종 모호한 입력에 대해 하나의 의도된 의미만 있는 것처럼 답변합니다. 이는 문제가 되는데, 입력의 모호성은 불확실성의 상류 원천이기 때문입니다. 즉, 프롬프트가 여러 가지 타당한 해석을 허용할 때, 핵심 질문은 모델이 과연 직접 답변을 해야 하는지 여부입니다. 기존의 입력 불확실성 처리 방법들은 종종 LLM이 생성한 문장이나 명확화에 의존하지만, 이러한 변환 과정 자체가 모호성을 측정하기 전에 이미 입력을 해석해 버릴 수 있습니다. 우리는 입력 모호성 감지를 위한 라벨 보존형 페르투베이션 프레임워크를 제안하며, 이 프레임워크에서는 페르투베이션이 원래 입력에 가까운 상태로 유지되면서 동시에 해당 입력의 라벨을 보존합니다. 우리는 이 원칙을 두 가지 감지기로 구현했습니다: 블랙박스 기반 규칙 기반 페르투베이션 라이브러리와
진행 상황 및 관련 보도

LLM 에이전트의 일관성을 위한 재귀적 의미 차이

arXiv:2610.33012v1 발표 유형: 신규 초록: 도구 사용 기능을 갖춘 대규모 언어 모델(LLM) 에이전트는 동일한 초기 상태에서 독립적인 실행 간에 일관되지 않은 행동을 보이며, 서로 다른 도구를 호출하거나 상충되는 출력을 생성하거나 서로 다른 전략을 추구합니다. 이러한 변동성은 시간이 지나면서 누적되어 배포의 신뢰성을 저해합니다. 기존 평가 지표들은 주로 완료 기반 점수를 통해 작업 정확도를 측정할 뿐, 여러 실행에 걸친 에이전트 행동의 일관성을 포착하지 못합니다. 또한, 에이전트의 행동은 확률 분포를 이용한 토큰 수준 또는 의미 클러스터링을 활용한 단일 응답 수준에서 각각 분석되지만, 어느 방법도 궤적의 향후 단계들로 일관성 부족이 어떻게 전파되는지를 파악하지 못합니다. 우리는 재귀적 의미 발산(RSD)이라는 비정식

진행 상황 및 관련 보도

LLM 신뢰도 검출을 위한 표현 서명의 적응적 전이

arXiv:2610.33442v1 발표 유형: 신규 요약: 대규모 언어 모델(LLMs)은 환각 및 추론 오류를 포함한 신뢰성 문제에 취약하다고 보고되고 있습니다. 기존의 품질 감지기는 내부 표현을 기반으로 비교적 높은 정확도로 신뢰할 수 없는 출력을 예측할 수 있습니다. 그러나 이러한 감지기를 학습시키기 위해서는 종종 상당한 양의 도메인 특화된 라벨링 데이터가 필요하며, 이는 새로운 도메인에 대한 적용 가능성을 제한합니다. 우리는 이와 같은 과제를 해결하기 위해 관련 도메인 간에 표현 서명을 전이하는 방법을 제안합니다. 구체적으로, 각 도메인에 대해 저차원 서명을 먼저 추출한 다음, 교차 피팅을 통해 도메인별 예측기의 구성 가중치를 학습하는 통계적 프레임워크를 구축합니다. 이 가중치는 각 소스 도메인의 예측 관련성에 따라 적응됩니다.

진행 상황 및 관련 보도

DMAIC-벤치: 다단계 분석 작업에서 에이전트의 자기성찰부터 자기절제까지

arXiv:2610.32305v1 발표 유형: 신규 초록: 다단계 분석 작업에서는 LLM 에이전트가 계속 진행할지, 경로를 변경할지, 또는 중단할지를 결정하기 위해 중간 단계의 근거를 활용해야 합니다. 에이전트가 자신의 출력을 비판하는 자기반성은 널리 연구되어 왔지만, 이러한 비판만으로는 근거가 다음 행동에 영향을 미쳤는지 여부를 확인할 수 없습니다. 우리는 이러한 능력을 ‘자기제약’이라고 부릅니다. 기존의 에이전트 벤치마크는 대부분 과제 완수 여부나 출력 품질만을 측정하며, 이 능력에 대한 검증은 이루어지지 않았습니다. DMAIC-Bench는 린 식스 시그마의 명시적인 통계적 전제 조건을 바탕으로, 4개 산업 분야에서 15개의 산업 사례에 걸쳐 97개의 초기 설정된 과제를 통해 이를 평가합니다. 쌍으로 구성된 역설적 변형 과제들은 동일한 워크플로우 위치에서 서로 반대되는 행동을 요구함으로써, 정당화된 제약과 무분별한 중단을 구분합니다. 우리는 실행 추적 정보를 통해

진행 상황 및 관련 보도

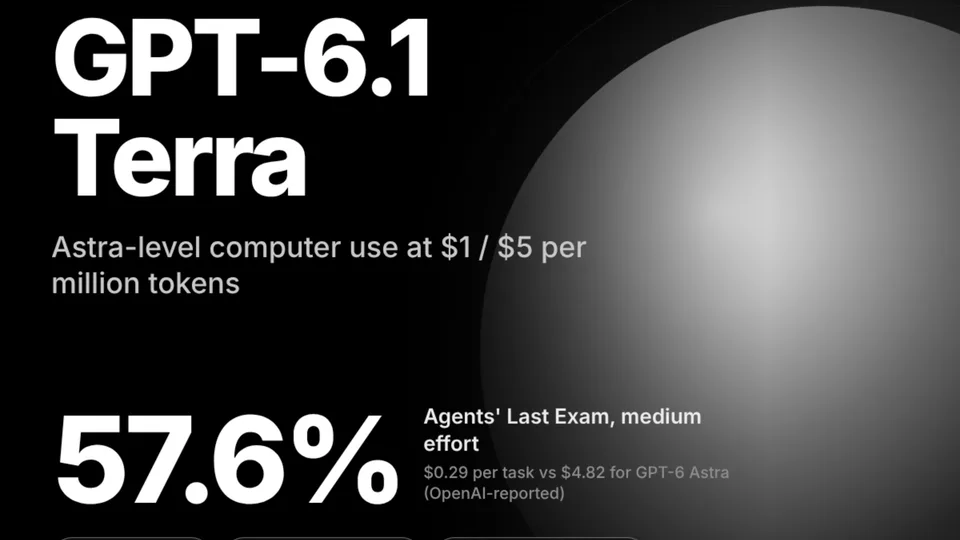
OpenAI, GPT-6.1 Terra를 출시하며 에이전트 작업에 대한 GPT-6.1 Sol의 API 가격을 절반으로 인하

OpenAI는 GPT-6.1 Terra를 출시했으며, 이 모델은 매 백만 토큰당 1달러/5달러의 가격으로 제공되는 고속 컴퓨터 사용 및 비전 모델입니다. 이 모델은 GPT-6 Astra의 중간 수준 노력 기반 에이전트들의 최종 시험 점수를 달성하며, 작업당 비용은 0.29달러로, 기존의 4.82달러에 비해 크게 낮아졌습니다. 해당 게시물인 “OpenAI, GPT-6.1 Terra 출시… 에이전트 작업 시 GPT-6.1 Sol의 API 가격 절반”은 MarkTechPost에 처음 게재되었습니다.

新闻源配图 · MarkTechPost
진행 상황 및 관련 보도

열일곱 살 학생은 어떤 답을 썼을까? 여섯 개의 최첨단 언어 모델에서 나타나는 저자 연령 오인, 과대 평가된 신뢰도, 그리고 비교정적 자기 설명에 관한 행동 사례 연구

arXiv:2610.31946v1 발표 유형: 신규 초록: 세 명의 학생이 같은 시험 문제를 손으로 작성했다: “행복이란 무엇인가? 당신은 행복한가?” 수집 당시 기록된 이들의 나이는 17세, 28세, 45세이다. 열일곱 살 학생의 답은 조심스럽고 형식적으로 표현되어 있다. 각 답안을 나이와 성별 라벨에 맞추도록 요청했을 때, 대부분의 최첨단 언어 모델은 이를 성인에게 확신을 가지고 배정한다. 본 논문은 Claude Fable 5, Gemini 3.1 Pro, GPT-5.6 Sol, Grok 4.5, GPT-4o (2024), 그리고 DeepSeek V4 등 여섯 개 모델에서 발생한 이러한 실패를 구조화된 사례 연구로 보고한다. 우리는 프레임 설정, 공개 형식, 그리고 청중 인식 지침을 조작하는 여섯 가지 실험 조건 하에 1,081회의 API 세션을 진행하고, 총 3,225개의 응답을 점수화하였다. 여섯 개 모델 중 세 개는 매칭 과제에서 우연 수준(1/3)에 근접하거나 그에 가까운 성과를 보이는 반면, 73~88%의 정확도를 보고한다.

진행 상황 및 관련 보도

llm-echo 0.5

릴리스: llm-echo 0.5 저는 새로운 LLM 릴리스를 준비하고 있으며, PR 테스트 과정에서 llm-echo 디버그 플러그인을 다시 살펴보게 되었습니다. 이 플러그인은 LLM을 전혀 사용하지 않고, 단순히 입력된 프롬프트를 그대로 반복하는 ‘모델’을 제공합니다. 이번 새 릴리스에서는 도구 호출, 시스템 프롬프트, 추론 토큰까지 고려하여 시뮬레이션된 토큰 사용량 카운트를 업데이트했습니다. 예시 사용법: uvx --with llm-echo llm -m echo 'hi there' -o thinking 1 --usage 출력 결과: 먼저 프롬프트를 검토한 후, 무엇을 말할지 결정합니다. { "prompt": "hi there", "system": "", "attachments": [], "stream": true, "previous": [] } 토큰 사용량: 입력 2개, 출력 24개 태그: llm

진행 상황 및 관련 보도