
엔비디아, 기업들이 더 적은 GPU로 AI 모델을 실행할 수 있도록 지원하는 인도 스타트업을 후원
심플리스마트는 연간화된 매출액이 6개월 만에 14배로 증가했으며, 미국 시장이 전체 매출의 절반 이상을 차지한다고 밝혔습니다.
제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.
심플리스마트는 연간화된 매출액이 6개월 만에 14배로 증가했으며, 미국 시장이 전체 매출의 절반 이상을 차지한다고 밝혔습니다.
MIT 커뮤니티의 다양한 구성원들이 데이터센터와 초강력 온실가스부터 농업과 교육에 이르기까지 다양한 주제에 대해 논의를 열었습니다.
오늘은 워크스테이션용 ASRock의 고급형 Radeon AI 추론 카드인 Creator Radeon AI Pro R9700을 살펴봅니다. 32GB의 RAM과 1,700달러의 가격대를 갖춘 이 카드는 로컬 AI 추론을 위한 워크스테이션을 구성하는 데 있어 매우 합리적인 선택입니다. 본 글 ‘ASRock Creator Radeon AI Pro R9700 리뷰: AMD 스타일의 워크스테이션 추론’은 ServeTheHome에 처음 게재되었습니다.
스페이스X는 AI 칩 및 관련 데이터센터 장비 구매를 위한 약 400억 달러 규모의 자금 조달에 대해 법적 구속력 있는 계약을 체결했다고 월요일 규제 당국에 제출한 서류에서 밝혔다. 스페이스X는 성명을 통해 이를 사상 최대 규모의 GPU 관련 확정 자금 조달이라고 평가했다.
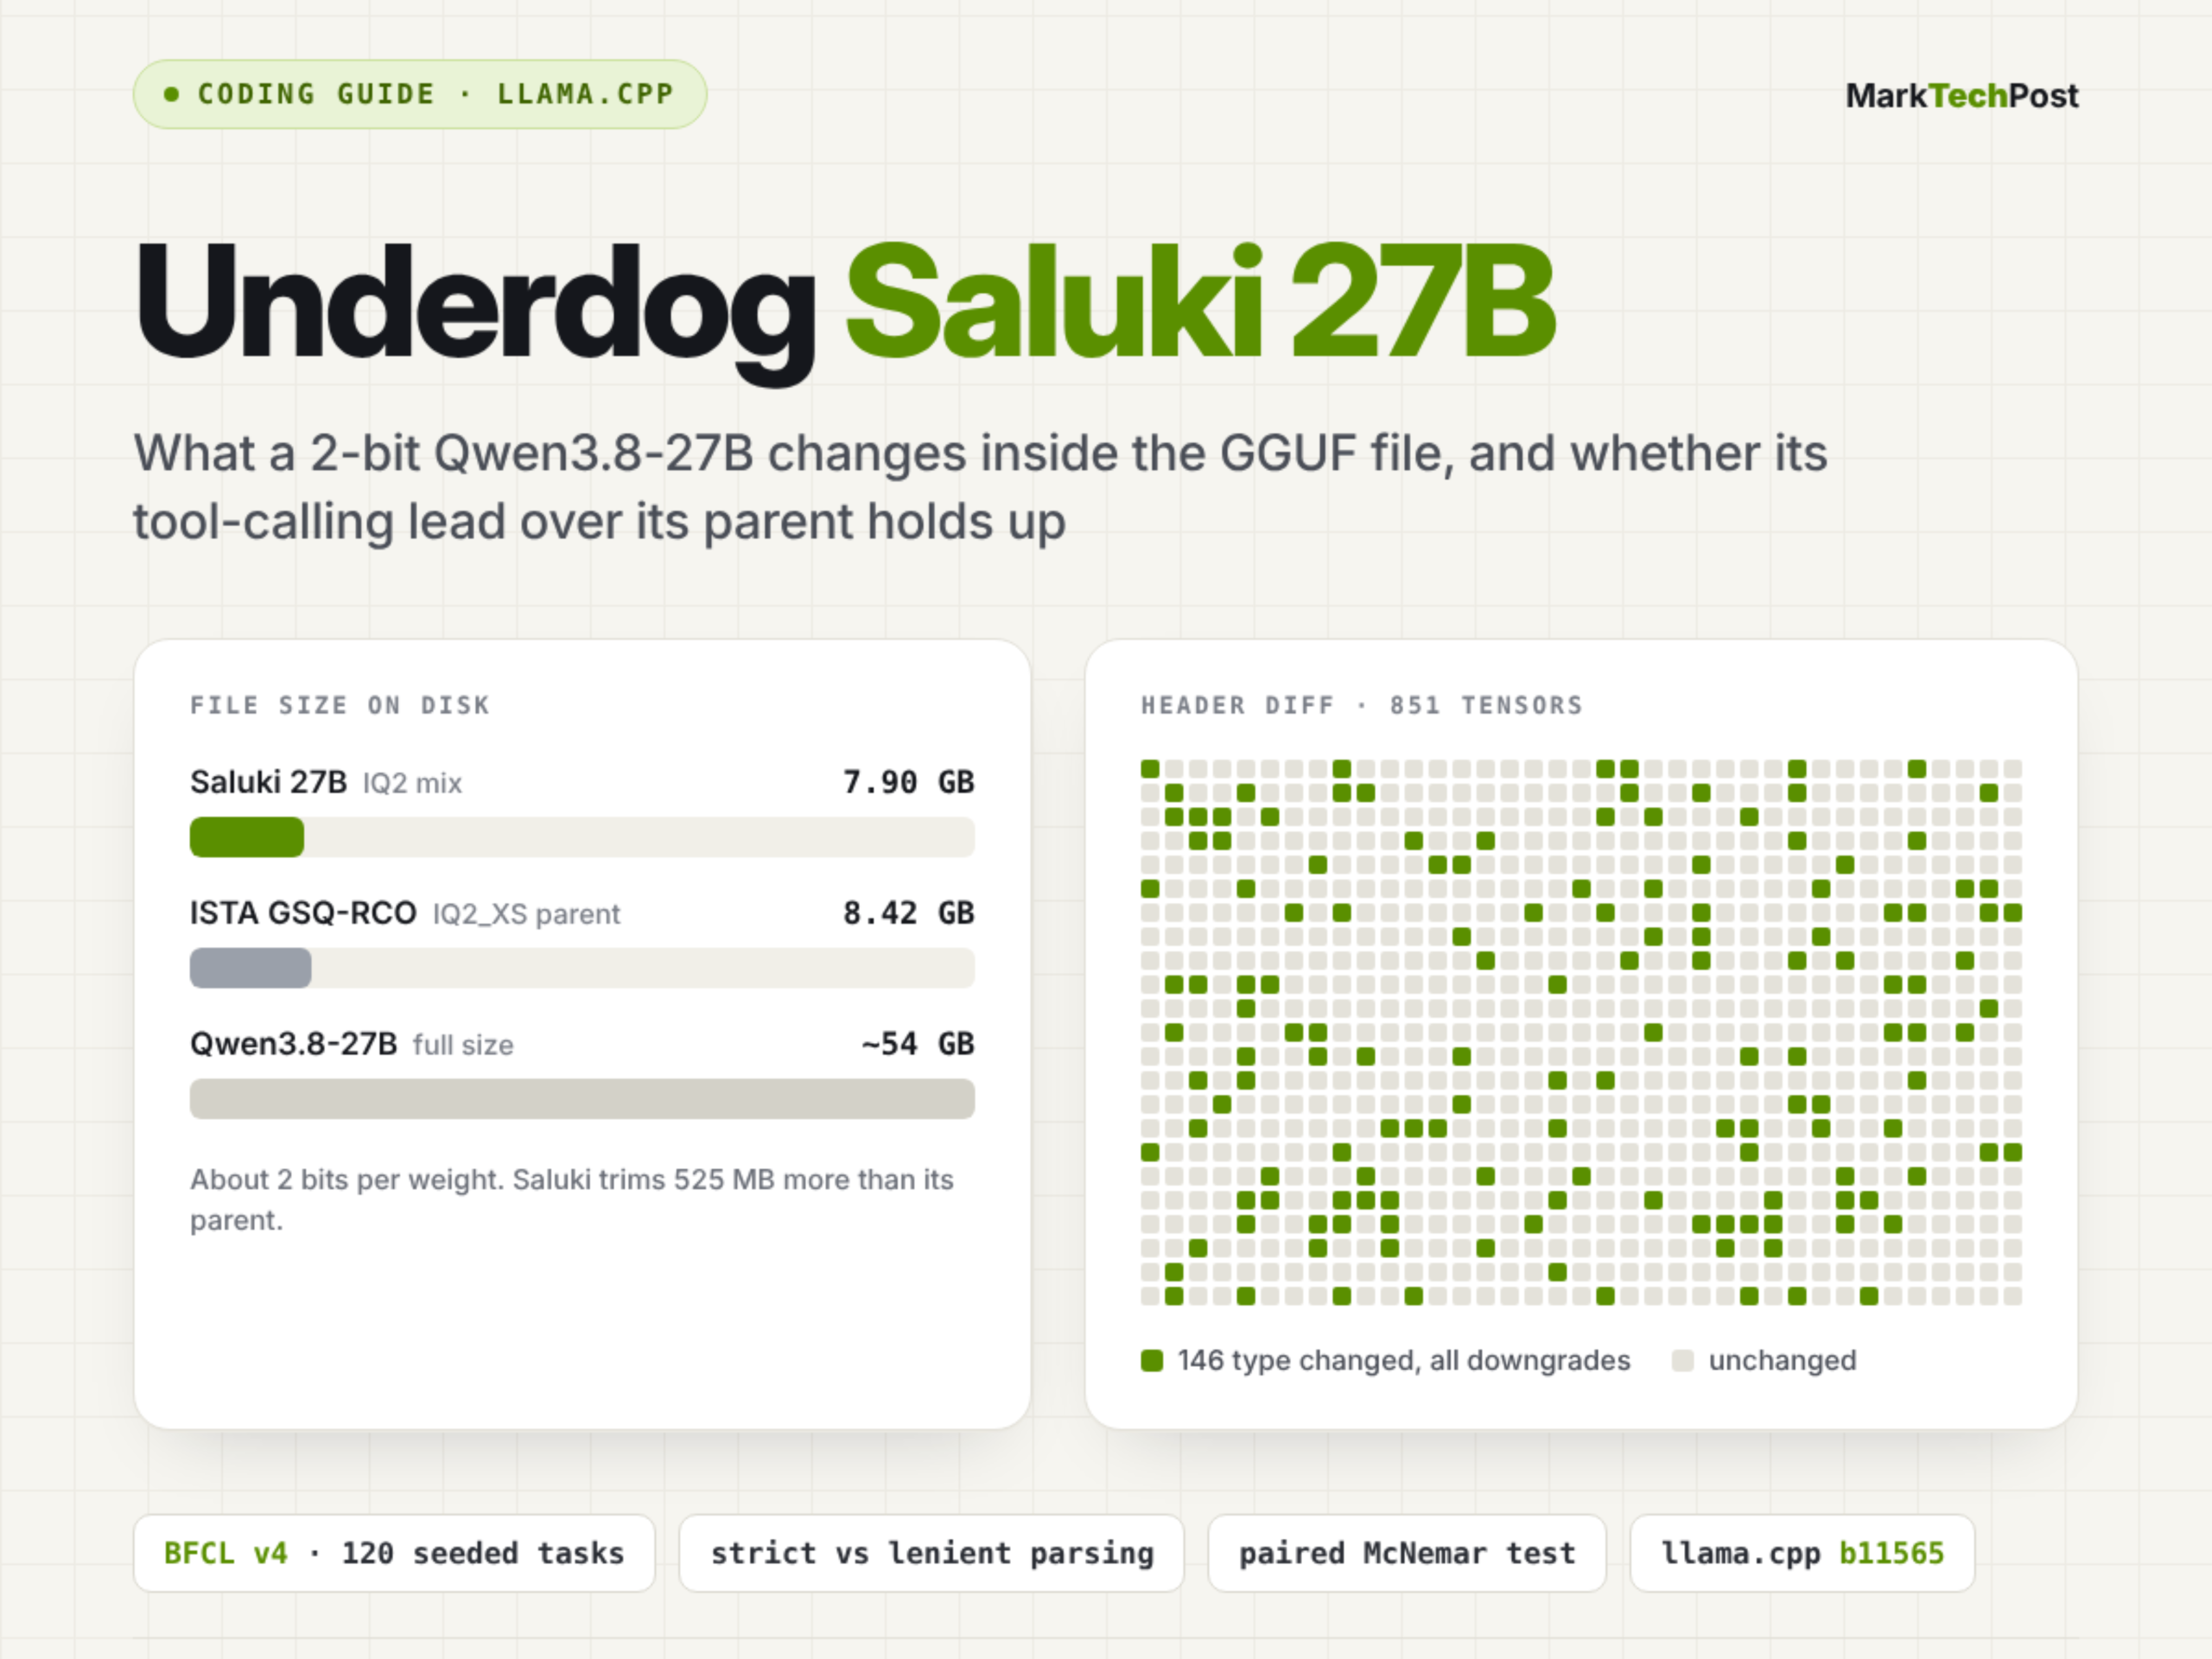
이 글에서는 Underdog가 발표한 Saluki 27B 모델을 소개합니다. 이 모델은 7.9 GB 크기의 2비트 양자화 Qwen3.8-27B 변형으로, ISTA-DASLab의 GSQ-RCO 방법을 기반으로 구축되었으며, 120개의 작업에 대한 BFCL v4 도구 호출 벤치마크에서 원래의 54 GB 풀 정밀도 모델을 능가한다고 주장됩니다. 다만 모든 성능 관련 결론은 해당 개발자의 발표에 근거한 것으로, 독립적인 검증은 이루어지지 않았습니다.
아마존 세이지메이커는 트레이닝 세션(Training Sessions) API를 출시하여, 사용자가 순수 파이썬 스크립트로 SFT, RLHF, GRPO, KTO 등과 같은 맞춤형 대규모 모델 훈련 로직을 구현할 수 있도록 지원합니다. GPU 리소스 스케줄링, 장애 복구, 분산 실행 및 체크포인트 관리는 모두 서비스에서 관리합니다.
이 글은 Hugging Face와 Amazon이 공동으로 발표한 기술 블로그 시리즈의 첫 번째 편으로, AWS Trainium AI 가속 칩에서 TorchNeuron을 활용한 PyTorch 모델 추론 성능 분석 방법을 체계적으로 소개합니다. 여기에는 Neuron 백엔드 통합 원리, torch.profiler 구성 방법, NeuronConfig 및 NeuronProfiler 도구의 사용법, Neuron Explorer를 이용한 시각적 추적 등이 포함되며, RMSNorm을 사례로 삼아 세 가지 구현 방식(순수 PyTorch, torch.rms_norm 내장형 병합, torch.compile 자동 병합) 간의 장치별 처리 시간 차이를 비교합니다.