
본문으로 건너뛰기
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI 뉴스 검색

제목, 요약, 본문을 검색해 흩어진 정보를 연결하세요.

발행 시간순

인피니언과 울프스피드의 계약 연장: 200mm 실리콘 카바이드 웨이퍼 공급 계약 체결

인피니언과 울프스피드는 2026년 10월 15일에 실리콘 카바이드 웨이퍼 공급 계약을 확대·연장한다고 발표했으며, 협력을 150mm 규격에서 200mm 규격으로 확대해 인피니언의 200mm 제조 전환을 지원하고 공급망의 탄력성을 강화할 예정이다. 한편 울프스피드는 이를 통해 주요 고객들 사이에서 200mm 소재의 장기적 활용을 확대하겠지만, 자사의 소재 사업은 여전히 매출 감소와 마이너스 영업이익률이라는 압박에 직면해 있다.


英飞凌续约Wolfspeed:200mm碳化硅的“下一关”英飞凌续约Wolfspeed:200mm碳化硅的“下一关”

추천 이유:이 사건은 글로벌 실리콘카바이드 산업 경쟁의 중심축이 본격적으로 대형 기판과 제조 공정으로 이전되었음을 의미하며, 산업 사슬 상하위 간 협력에 의한 200mm급 양산 추진을 촉진하는 핵심 신호입니다. 재료 출처는 명확하며(타이메디아, 2026년 10월 25일 발표), 모든 사실은 원문에 명시된 시점, 주체, 데이터 및 제약 조건과 엄격히 일치합니다. 추론, 보완 또는 확장은 전혀 포함되어 있지 않습니다.
진행 상황 및 관련 보도

패널 제조사들이 AI로 인한 상류 원자재 비용 압박에 대응하기 위해 일제히 가격을 인상했지만, 하류 수요처의 수용도가 낮고 최종 제품의 품질 관리에도 부담이 가중되고 있다.

2026년 9월부터 TCL 화싱, BOE, 혜커 등 패널 제조사들이 잇따라 가격 인상 공지를 발표했는데, 주요 원인은 AI 대규모 모델의 발전으로 HBM 수요가 급증하면서 기성 공정 칩의 생산 용량을 압도하고, 드라이버 IC, PCB, 유리 기판 등 핵심 소재의 가격을 상승시켰기 때문이다. 코닝 등 상류 공급업체들도 동시에 가격을 인상했다. 비용 부담이 분명히 존재함에도 불구하고, 하위 단계의 TV·디스플레이 브랜드들의 구매 가격은 아직 전반적으로 오르지 않았으며, 최종 사용자들 사이에서는 과열, 블랙 스폿 등 품질 관리 관련 문제가 빈번히 발생해, 가격 인상이 실제 거래와 체험 개선으로 이어지지는 못한 상황이다.

AI大模型狂飙,面板行业也扛不住了

추천 이유:재료 시스템은 AI 산업이 직접적으로 연관되지 않은 하드웨어 업계에 미치는 크로스체인 전파 메커니즘을 규명한다—AI가 패널 수요를 직접적으로 견인하는 것이 아니라, 웨이퍼 생산능력의 재배분을 통해 전 체인에 걸친 비용 재정립을 촉발한다는 점이다. 동시에 가격 인상 행태와 시장의 실제 반응(가격 정체, 출하량 감소, 사용자 불만) 간의 뚜렷한 괴리를 보여주며, 이는 산업의 협상력과 제품 경쟁력 간의 불일치라는 근본적인 모순을 부각한다.

진행 상황 및 관련 보도

미국의 반 데이터센터 운동이 참고할 수 있는 글로벌 경험: 아일랜드 전력망 위기부터 뉴질랜드 지역사회 AI 실천까지

파리 마르크스는 저서 『초대규모』에서 전 세계 데이터센터의 투쟁사를 정리하며, 아일랜드가 전력망 용량 포화로 인해 규제를 도입하고 기업들이 자체적으로 가스 발전소를 건설하는 사례를 지적했다. 또한 뉴질랜드는 지역 클라우드를 활용해 마오리어 음성인식을 지원하는 비약탈적 AI 모델을 모색하고 있다. 한편 미국에서 현재 격화되고 있는 반대 움직임은 사실 오래전부터 예고되어 온 전 세계적 갈등의 재현에 불과하다.

진행 상황 및 관련 보도

llama.cpp 发布 b11871 版本:新增 JSON 嵌套深度限制以防止服务崩溃

llama.cpp 在 b11871 版本中引入关键安全修复,对请求中 JSON 嵌套层级实施 128 层硬性限制,避免因深度递归解析导致 HTTP 线程栈溢出、服务崩溃(macOS 触发 SIGBUS,Linux 触发 SIGSEGV)。该策略覆盖 chat 接口多类输入场景,并统一返回 HTTP 400 错误。

추천 이유:按信源设置仅收录,不参与自动精选

진행 상황 및 관련 보도

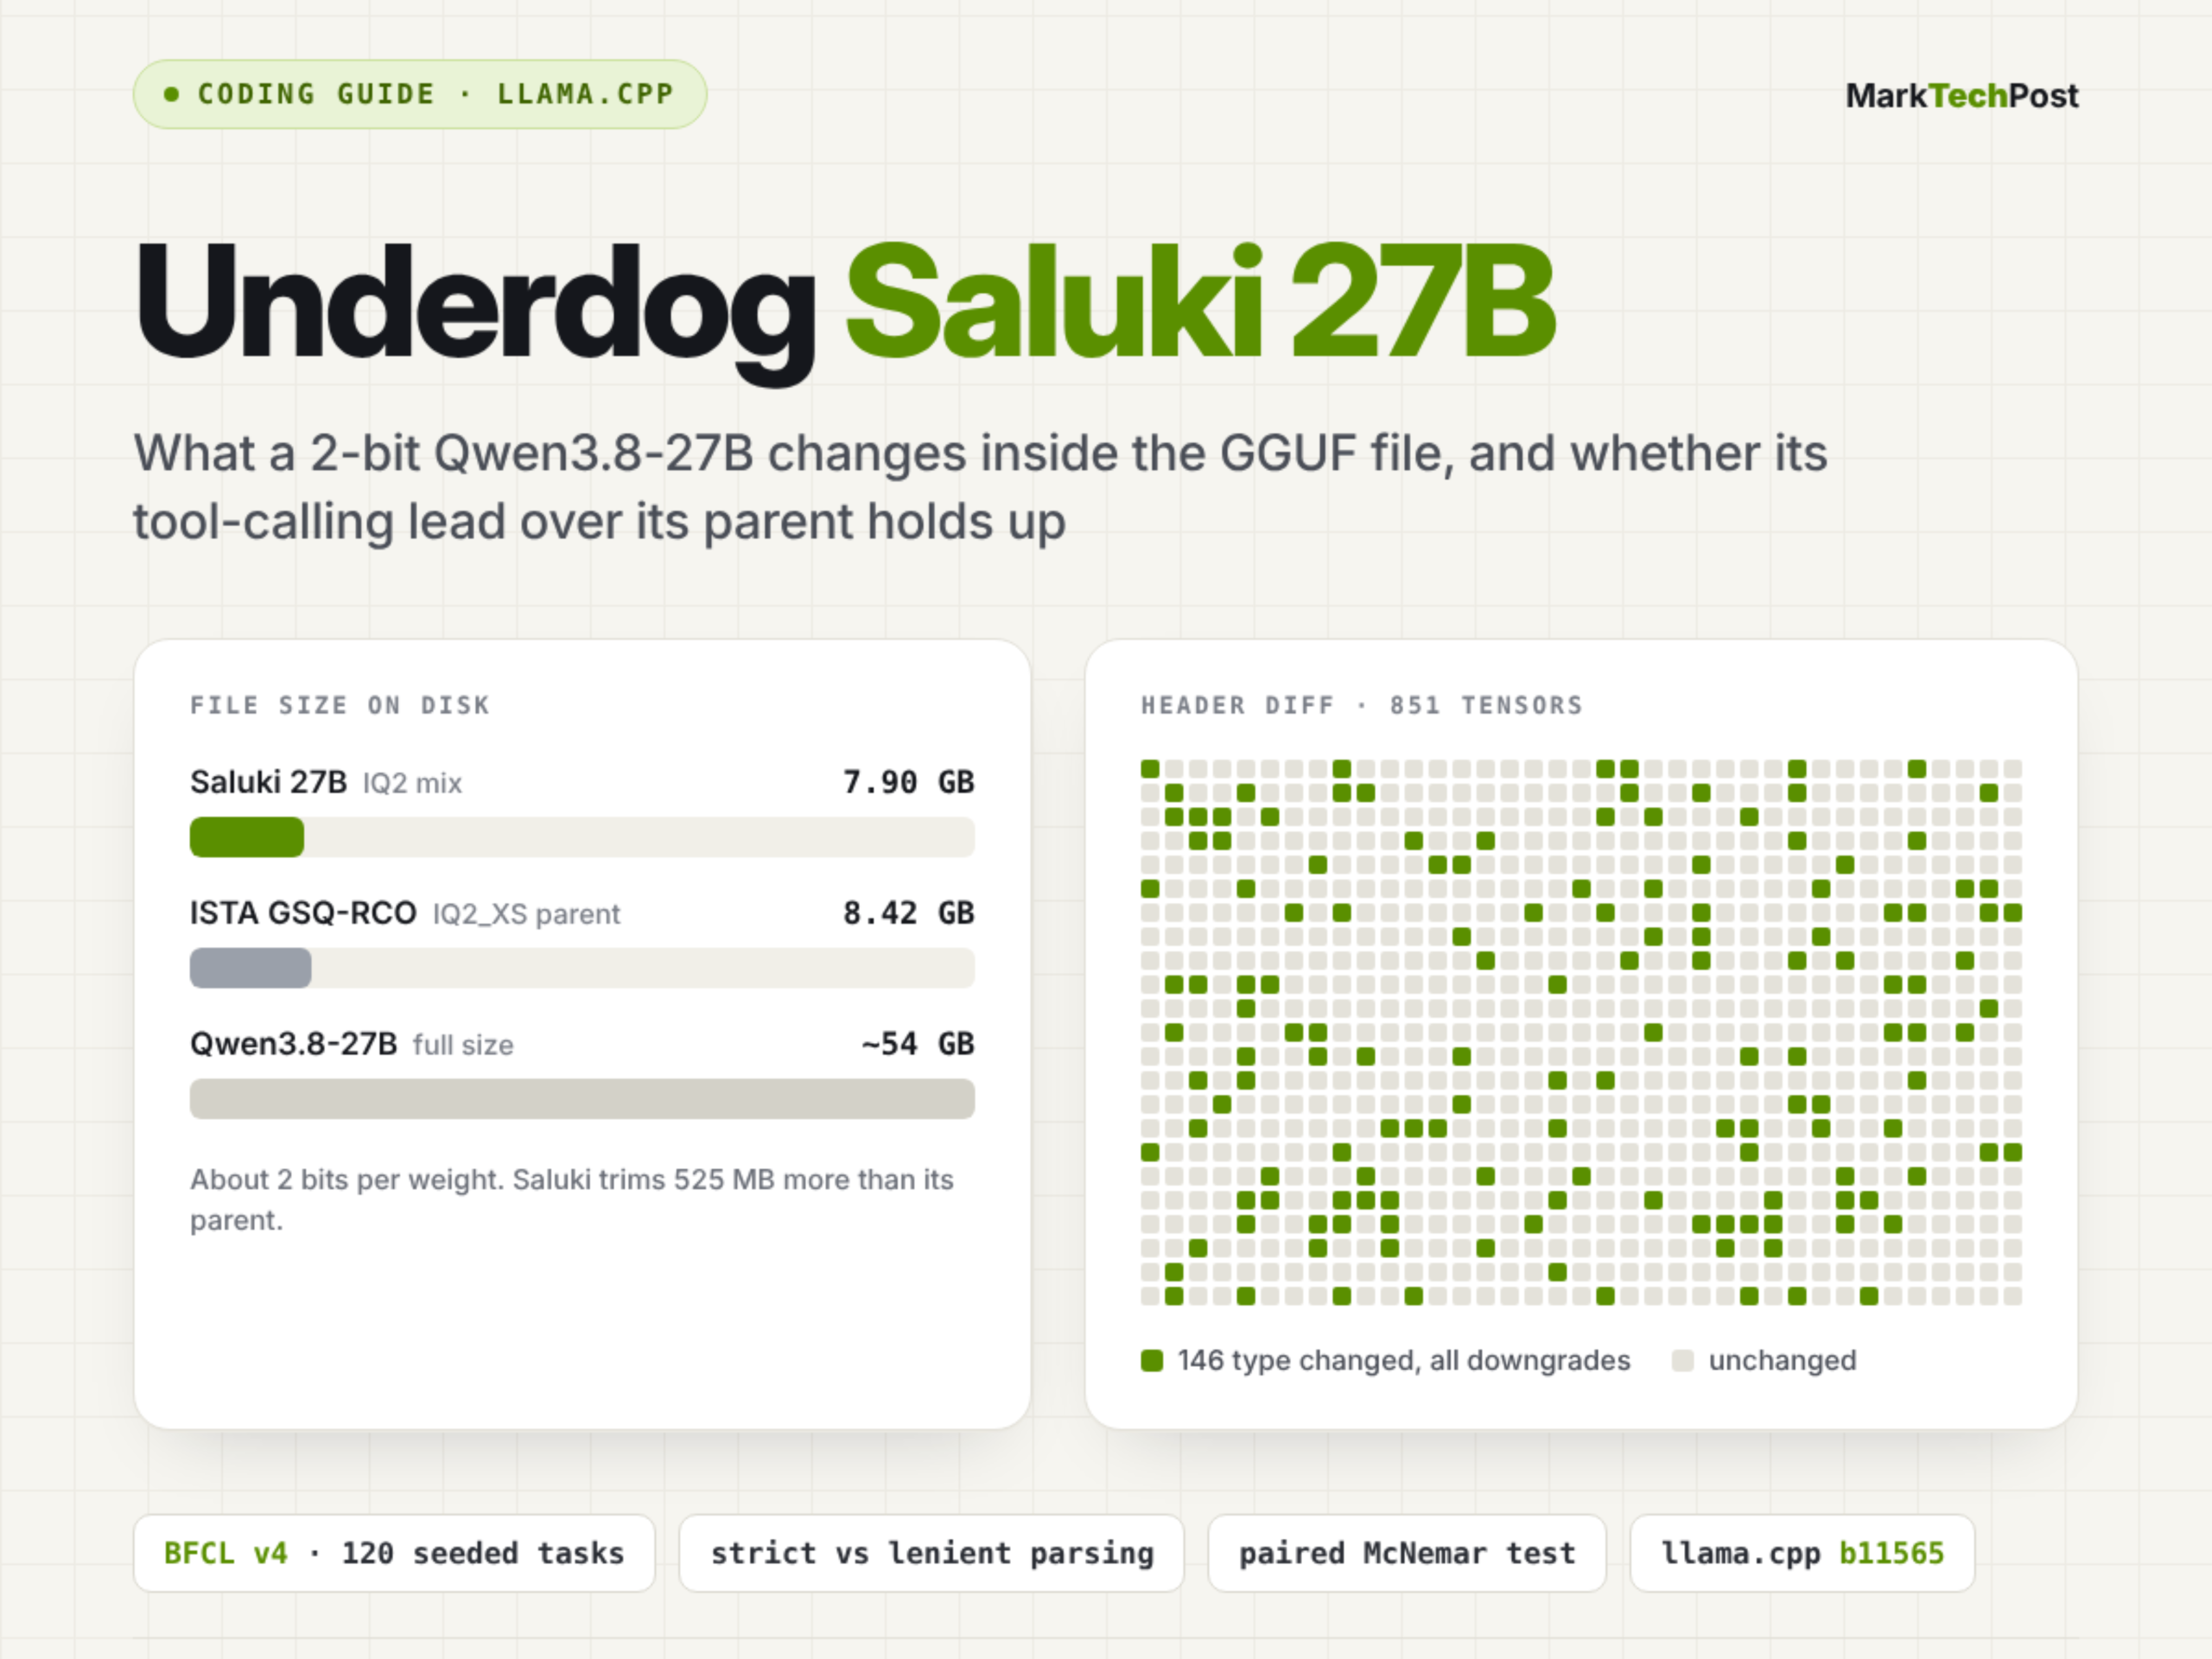
언더독 살루키 27B: GSQ-RCO 기반 2비트 Qwen3.8-27B 도구 호출 모델 기술 분석

이 글에서는 Underdog가 발표한 Saluki 27B 모델을 소개합니다. 이 모델은 7.9 GB 크기의 2비트 양자화 Qwen3.8-27B 변형으로, ISTA-DASLab의 GSQ-RCO 방법을 기반으로 구축되었으며, 120개의 작업에 대한 BFCL v4 도구 호출 벤치마크에서 원래의 54 GB 풀 정밀도 모델을 능가한다고 주장됩니다. 다만 모든 성능 관련 결론은 해당 개발자의 발표에 근거한 것으로, 독립적인 검증은 이루어지지 않았습니다.

How to Run Underdog Saluki 27B: 2-Bit Qwen3.8-27B Tool-Calling Guide
진행 상황 및 관련 보도

llama.cpp 发布 b11870 版本,正式支持 DeepSeek-V4.1-Flash 模型

llama.cpp 在版本 b11870 中新增对 DeepSeek-V4.1-Flash(deepseek41)模型的支持,并针对其 Engram 架构进行多项底层优化,包括 KV 缓存计算简化、BF16 精度替代 MXFP8、in-graph 行 gather 等;同步提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的多平台二进制构建。

추천 이유:按信源设置仅收录,不参与自动精选

진행 상황 및 관련 보도

llama.cpp 发布 b11868 版本:增强 Hexagon NPU 多核 Flash Attention 支持,覆盖全平台编译构建

llama.cpp v2.45.0(标签 b11868)正式发布,核心更新为 Hexagon 后端引入 KV-head 团队拆分机制以优化多核 HMX Flash Attention 性能,并统一 FA 拆分控制标志;同步提供 macOS、Linux、Windows、Android、iOS 及 openEuler 等全平台二进制包,含 CUDA 12/13、Vulkan、ROCm、OpenVINO、SYCL、Snapdragon(Adreno+Hexagon)等多后端支持。

추천 이유:按信源设置仅收录,不参与自动精选

진행 상황 및 관련 보도

llama.cpp 发布 b11867 版本:服务端入口重构,全面支持多平台与异构加速后端

llama.cpp 于 GitHub 正式发布 b11867 版本,核心变更包括服务端(server)入口点重构(PR #31113),新增 server_role 机制;同时提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的 40+ 预编译二进制包,支持 CPU、CUDA(12.4/12.8/13.4)、Vulkan、ROCm 10.0、OpenVINO、SYCL(FP16/FP32)、Snapdragon(Adreno+Hexagon)等多元硬件后端。

추천 이유:按信源设置仅收录,不参与自动精选

진행 상황 및 관련 보도

llama.cpp 发布 b11866 版本:移除 Metal 后端冗余 AMAX 缩放逻辑,精简 MoE 计算路径

llama.cpp v.b11866 移除了 Metal 后端中已过时的 src1 power-of-two AMAX 缩放机制,转而依赖计算图内更精细的 per expert-token amax 缩放,确保 MoE 下投影激活值在 f16 表示范围内;同步删除相关两阶段归约核、F32 精度调度及越界测试用例。

추천 이유:按信源设置仅收录,不参与自动精选

진행 상황 및 관련 보도

llama.cpp 发布 b11861 版本:修复 minimax-m3 模型量化缩放张量未传递导致的推理异常

llama.cpp v.b11861 修复了 minimax-m3 模型在 NVFP4/MXFP8 量化下因 scale 张量未注入计算图而导致的权重失真问题,避免‘token soup’与残差淹没;同步提供覆盖 macOS、Linux、Windows、Android、iOS 及 openEuler 的多平台二进制构建。

추천 이유:按信源设置仅收录,不参与自动精选

진행 상황 및 관련 보도

카자흐스탄이 AI 연산 인프라 구축을 가속화하고 있으며, Firebird는 미국의 수출 허가를 받아 NVIDIA Grace Blackwell GPU 4만5천 개를 배치할 예정입니다.

카자흐스탄의 AI 생태계는 현재 계획 단계에서 규모화된 배치로 전환되고 있으며, Firebird사는 미국의 수출 허가를 획득해 카자흐스탄에 AI 공장을 건설하고, 초기 단계에서 NVIDIA Grace Blackwell GPU 4만5천 개를 배치할 예정입니다. Kazakhtelecom은 이미 H200/B300 GPU 1천 개 이상을 도입했으며, 2025년까지 Vera Rubin 등 GPU 2천 개 이상을 추가로 확보할 계획입니다. 또한 여러 주체가 협력해 연산 능력 공급, 개발자 참여 및 현지 AI 애플리케이션의 실질적 구현을 추진하고 있습니다.

진행 상황 및 관련 보도