
NVIDIA Vera RubinをKubernetesで初日からAI対応にする
NVIDIA Vera Rubinなどの新しいGPUハードウェア向けにKubernetesを設定および最適化するのは、複雑でエラーが発生しやすい作業です。ドライバー、カーネル、ランタイム、ネットワークなど...
見出し・要約・本文から、情報のつながりを探します。
NVIDIA Vera Rubinなどの新しいGPUハードウェア向けにKubernetesを設定および最適化するのは、複雑でエラーが発生しやすい作業です。ドライバー、カーネル、ランタイム、ネットワークなど...
アプリケーション開発インテリジェンスのスタートアップであるLinearB Inc.は本日、人工知能コーディングツールの広範な導入に伴い、組織のソフトウェアデリバリーパイプラインで深刻化している混雑を緩和しようとしていると発表しました。同社はこれを、人間のエンジニアや自律型[…]向けに、より実行可能なコンテキストを提供することに重点を置いた新製品「Agentic Studio」によって実現しています。記事「Agentic Studioにより、LinearBはソフトウェアデリバリーの加速に必要な重要なコンテキストを提供します」は、最初にSiliconANGLEに掲載されました。
NVIDIAは、エンタープライズメタデータからセマンティックレイヤーを生成するApache 2.0ライブラリであるAuto Ontologyを公開しました。このライブラリは、エージェントのSQLを認証済みの定義に基づいて基盤化し、MCP、CLI、APIを通じてコンテキストを提供します。記事「NVIDIA、Auto Ontologyをリリース:AIエージェントのSQLを基盤とするオープンなセマンティックレイヤー」は、MarkTechPostに最初に掲載されました。

人工知能の導入は、企業が将来的にどの程度の費用を知能に対して支払う意思があるかに大きく賭けている。今夏、AIバブルの予測に関する調査において、注目すべき重要な指標の一つは、企業顧客による生産的活用であると私たちは主張した。具体的には、当時、インフラ供給が追いつくのであれば[…] 「企業向けAIは、このブームの代金を支払えるのか?」という記事は、SiliconANGLEに最初に掲載された。
Mistralのオープンウェイトリリース、フロンティアモニタリング、そしてその日のAI関連TwitterとRedditの要約。
複雑さが増し、スケジュールは厳しくなり、ミスのコストもかつてないほど高まるなか、アナログおよびミックスドシグナル設計においてAIの役割がますます重要になっています。記事「アナログ設計におけるAIの活用」は、Semiconductor Engineeringに最初に掲載されました。

LangChainが、ブランドに合わせた動画、グラフィック、プレゼンテーション資料を生成するSlack向けのオープンソース型デザインエージェント「Content Studio」と、それを支えるハーネスをどのように構築したか。
Mirendilは、1,000万トークンのコンテキストウィンドウでゼロから事前学習された初のモデルであるFern 0.1をリリースしました。同モデルはエージェント型AIの研究開発を対象としており、1,000万トークン規模でのRULERシングルニードルテストでは100%のスコアを獲得していますが、エージェント型コーディングにおいては最先端モデルには及ばない結果となっています。この記事「Mirendil、1,000万トークンのコンテキストを持つ初のモデルFern 0.1を公開」は、MarkTechPostに最初に掲載されました。
vLLMセマンティックルーターは、270億パラメータ規模のオープンウェイトなマルチモーダル意思決定モデルであるd3-ultraをリリースしました。同モデルはテキスト、画像、動画を一度に読み込み、各回答に対する確率を返却し、チームのSR-Textテストで87.2点を獲得しています。この記事「vLLMセマンティックルーター、270億パラメータ規模のオープンマルチモーダル意思決定モデルd3-ultraをリリース」は、MarkTechPostに最初に掲載されました。
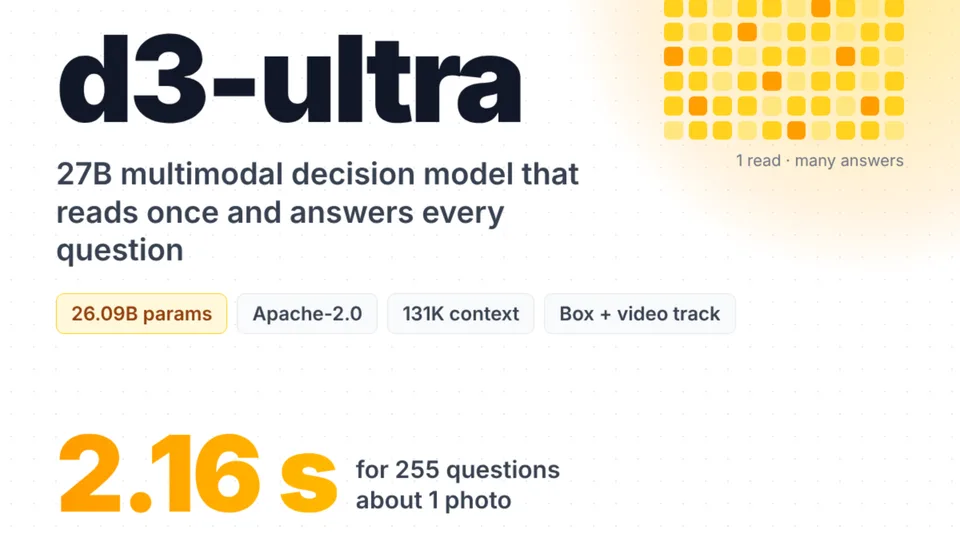
Baiduは、MITライセンスの3B規模のOCRモデルであるUnlimited OCR 2をリリースし、1回のリクエストで数百ページに及ぶ文書を解析できます。同モデルのSR-SWAアテンションにより、各ステップのデコーディングコストはほぼ一定に保たれ、MarathonDocBenchでは77.1点を獲得しています。この記事「Baidu、数百ページの文書解析向けUnlimited OCR 2をオープンソース化」は、MarkTechPostに最初に掲載されました。
Oktaは、dbtを唯一の信頼できる情報源として活用し、AIエージェントのコンテキスト管理手法を再構築しました。
Rampは、社内AIを分析エンジニアリングとして扱うことで構築したエージェント、サンドボックス、ダッシュボードを共有しています。
AIエージェントは、BIレイヤー内からdbtリネージを活用し、コーヒーを淹れる間に3つのデータの謎を解き明かしました。
カリフォルニア州の企業が、今年の米国におけるスタートアップ資金調達の4分の3以上を獲得しています。Crunchbaseのデータによれば、これは明らかに過去最高水準のシェアです。なお、今年はまだ数か月残っています。
arXiv:2610.31704v1 発表タイプ:新規 要旨:非破壊検査(NDI)は、損傷を生じさせることなくインフラや製造部品の安全性と信頼性を確保する上で不可欠な現代品質保証の基盤である。本論文では、現在のNDI分野を包括的にレビューし、計算アルゴリズム、物理的技術、産業応用、研究目標という四つの異なる視点から分析を行う。広範な学術文献を統合し、手動によるアナログな解釈から、NDE 4.0と呼ばれるデジタル化・データ中心のパラダイムへと急速に進化していることを示す。我々の分析は、超音波検査および目視検査が主要な物理的技術として優位性を示している一方で、重要な転換が起こっていることを明らかにする。

arXiv:2610.32215v1 発表タイプ:新規 要旨:現代のGPUデータセンターにおける計算能力の向上により、一部の産業大手企業が膨大なデータを用いて大規模言語モデル(LLM)を訓練し、展開できるようになりました。しかし、これらのモデルとその学習データの圧倒的な規模は、集中型の開発をますます維持困難にすると同時に、関連するプライベートデータを保有しながら同等のインフラを持たない小規模機関を排除しています。本論文では、分散型LLMトレーニングに関する我々の立場を、事前学習および微調整のパラダイムを中心に整理し、フェデレーテッド学習、スプリット学習、そして分散型アプローチを取り上げ、それらが地理的に分散した環境下で、多様なハードウェアや信頼性の低い接続状況においてどの程度実用可能かを評価します。さらに、我々は「統一された」システムを提案します。
マイクロソフト研究院は、表現力が高くセマンティックな対話型データ可視化を構築するための専用言語「Flint-interactive」を発表しました。この言語はコンパイラを通じて、ユーザーの操作(クリックやスワイプなど)を自動的にセマンティックなイベントにマッピングし、高レベルな演算子によってグラフ、テーブル、テキストなどの複数要素間の連動更新を駆動します。これにより、AIエージェントが信頼性の高い対話型可視化を生成する際に必要なコストと開発の複雑さを大幅に削減できます。