本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

エッジによるLLMトレーニングの民主化:課題・システム・今後の展望

arXiv:2610.32215v1 発表タイプ:新規 要旨:現代のGPUデータセンターにおける計算能力の向上により、一部の産業大手企業が膨大なデータを用いて大規模言語モデル(LLM)を訓練し、展開できるようになりました。しかし、これらのモデルとその学習データの圧倒的な規模は、集中型の開発をますます維持困難にすると同時に、関連するプライベートデータを保有しながら同等のインフラを持たない小規模機関を排除しています。本論文では、分散型LLMトレーニングに関する我々の立場を、事前学習および微調整のパラダイムを中心に整理し、フェデレーテッド学習、スプリット学習、そして分散型アプローチを取り上げ、それらが地理的に分散した環境下で、多様なハードウェアや信頼性の低い接続状況においてどの程度実用可能かを評価します。さらに、我々は「統一された」システムを提案します。

Democratizing LLM Training with the Edge: Challenges, Systems, and the Road Ahead
経緯と関連報道

グーグルのAI検索機能がオンライン出版業界に打撃:トラフィックの急減、訴訟の多発、補償メカニズムの初期探求

2024年にGoogleはAIオーバービューを導入し、2025年5月にはAIモードを開始したことで、複数の主要メディアにおけるGoogleからの検索トラフィックが顕著に減少した——『ニューヨーク・タイムズ』では、3年間で検索トラフィックの割合が44%から35.5%へ低下し、DCN加盟の19社のうち2025年5~6月には1%~25%のトラフィック減を経験した。DMG Mediaによれば、クリック率は最大で89%も低下したという。出版社らは複数の訴訟を提起したが、いずれも米国の裁判官によって却下された。その後、Googleは退会オプションの提供や情報源表示の強化に加え、400社のメディアを対象としたニュースAIパイロットおよびコンテンツ有料化のテストプログラムを開始した。

Google’s AI search changes upended online publishing

注目する理由:同報道は、GoogleのAI検索機能が出版エコシステムに与える構造的な衝撃を体系的に整理しており、タイムライン(2024年~2025年)、実証データ(第三者機関による統計)、多方面からの反応(出版社、規制当局、裁判所、非営利団体)および最新の対応策(撤退メカニズム、情報源の最適化、ライセンスおよび有料化のパイロットプロジェクト)を網羅しています。情報は密度が高く、時事性と政策的関連性も備えています。

経緯と関連報道

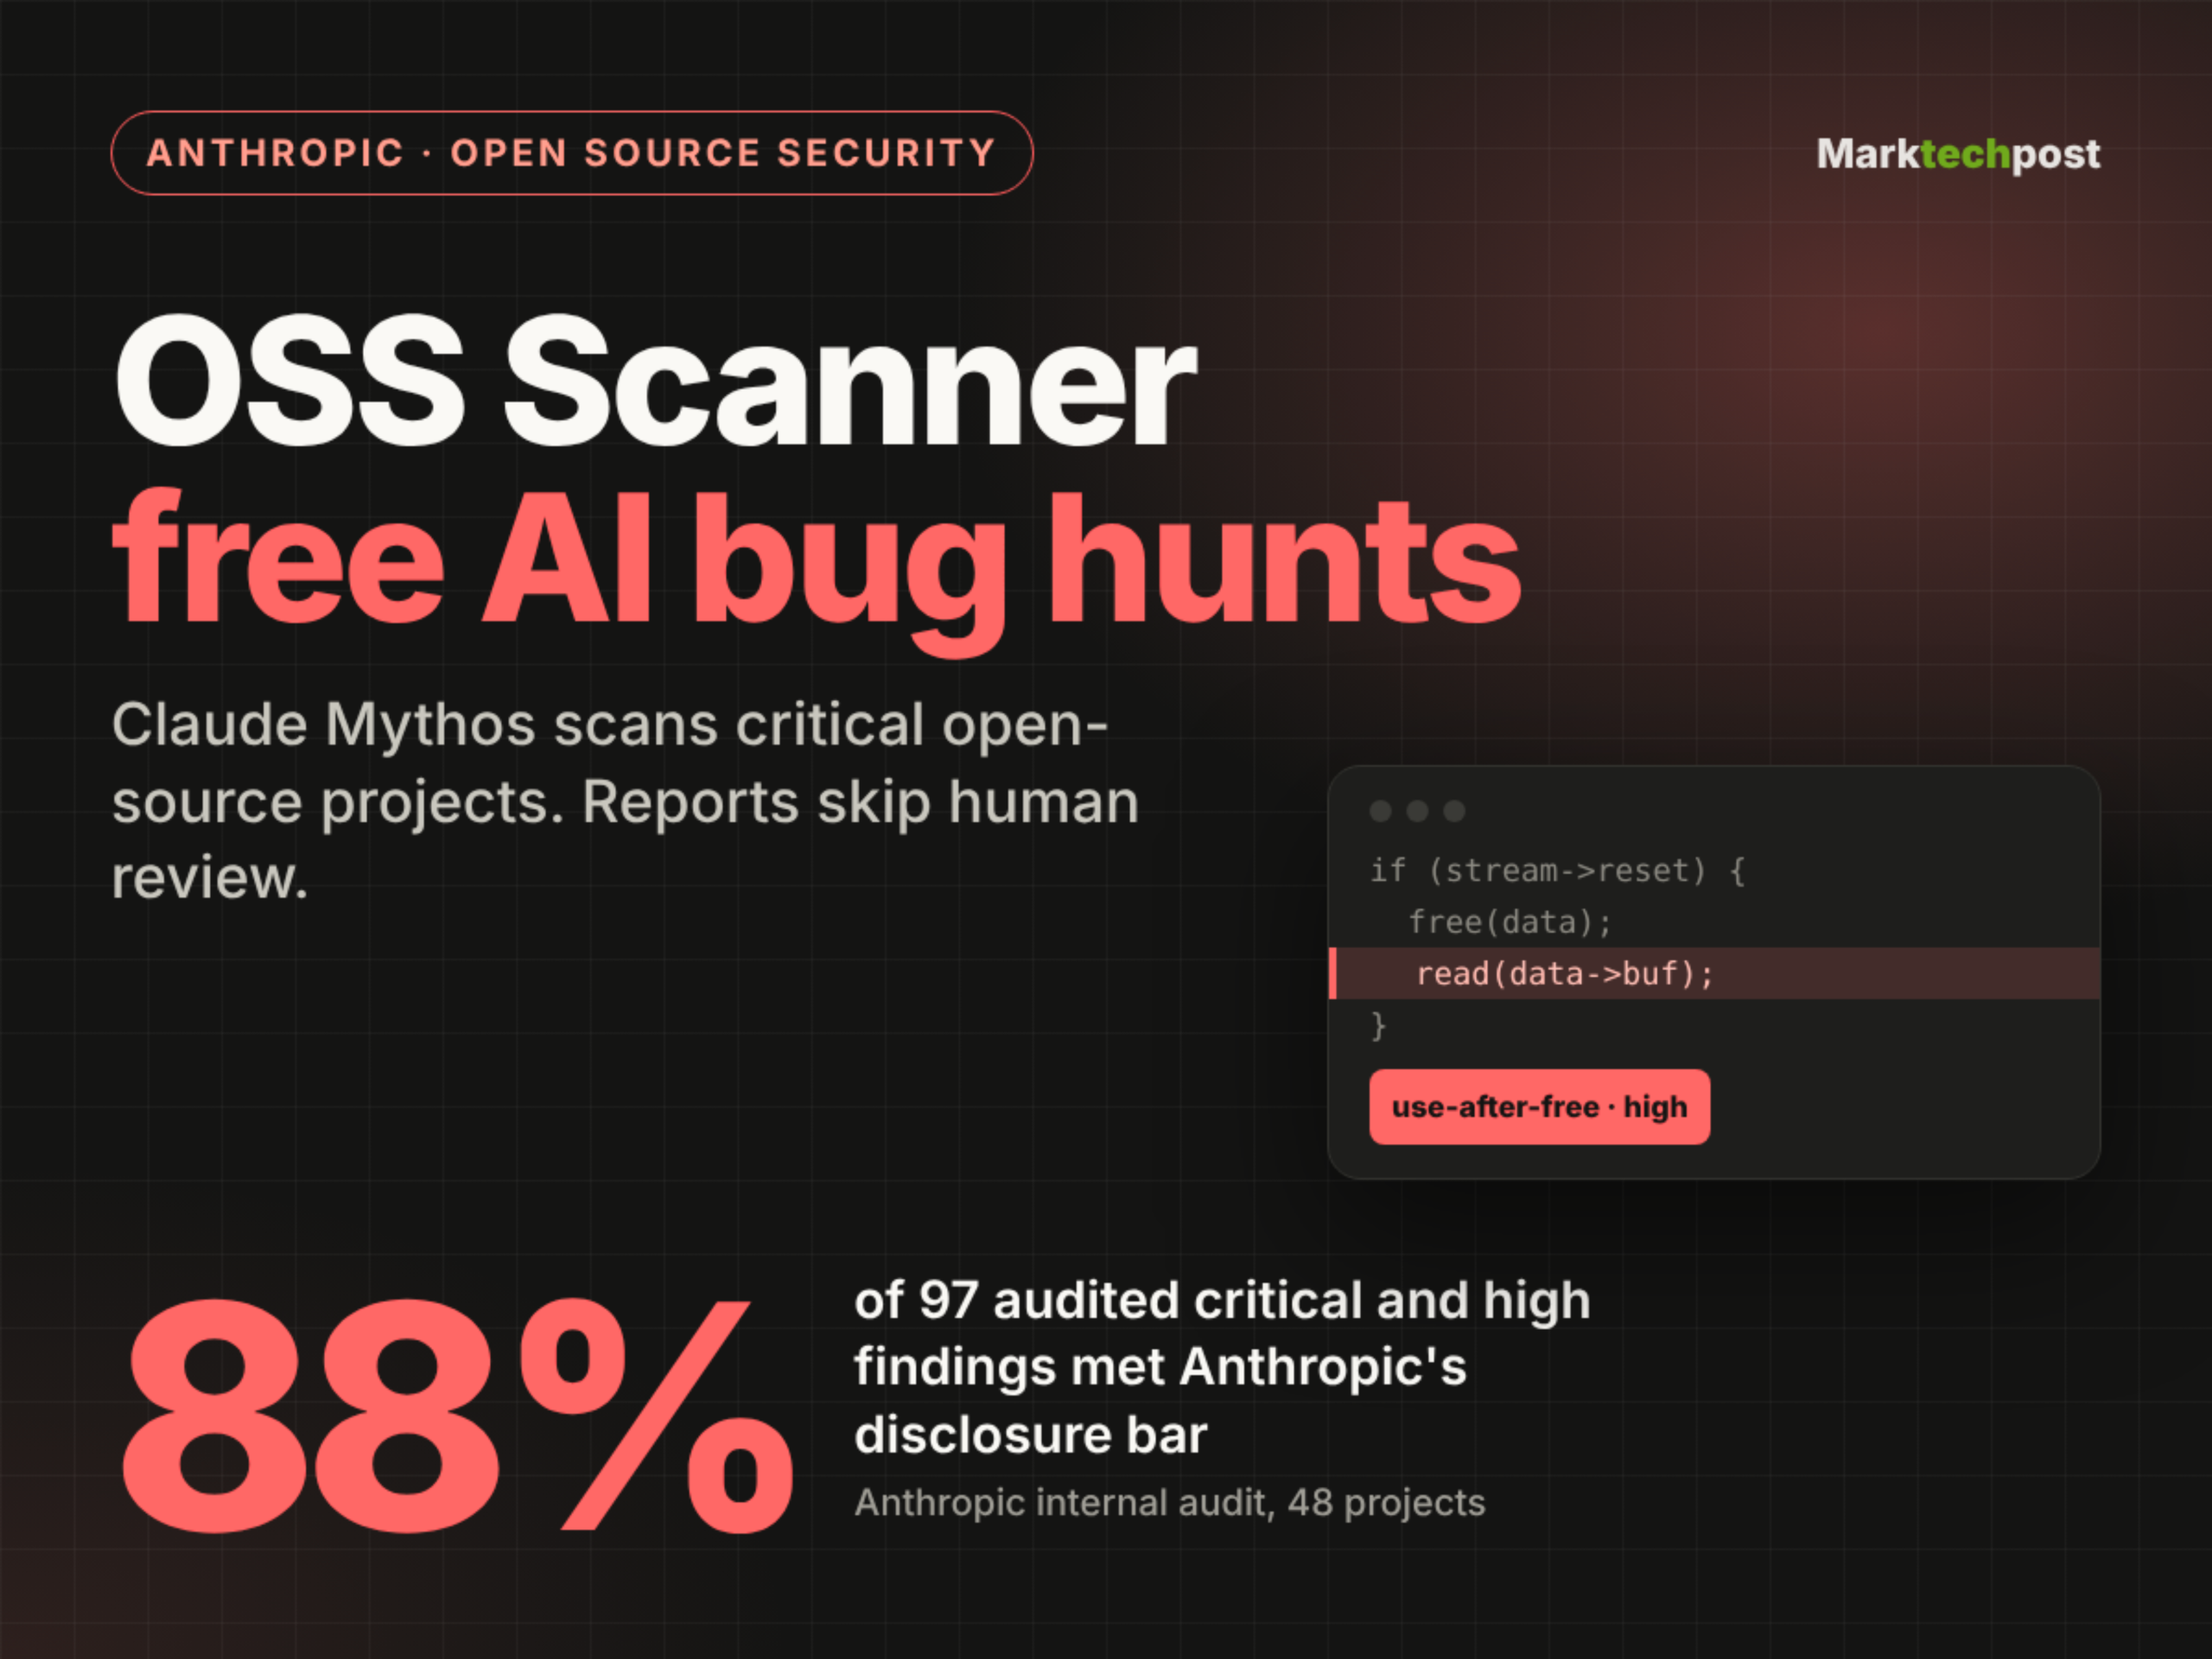
Anthropicが、主要なオープンソースプロジェクト向けの無料AI脆弱性スキャナー「OSS Scanner」を発表しました

Anthropicは2026年10月8日、Claude Mythosなどの強力なモデルを基にした無料でオプトイン型のAI脆弱性スキャンツール「OSS Scanner」をリリースし、重要なオープンソースプロジェクト向けに設計しました。10月19日時点で、114のプロジェクトが受け入れられ、11日間で深刻度レベル77件および高リスクレベル803件の脆弱性(モデルによる評価)が報告され、サンプリングされた監査結果の88%が同社の開示基準に適合していることが確認されました。

Anthropic Launches OSS Scanner, a Free AI Vulnerability Scanner

注目する理由:このツールは、オープンソースセキュリティ分野におけるLLMの大規模な実装事例を示しており、無償・完全自動・オフラインでの監査を特徴としています。ただし、人手によるレビュー工程を省略することで、誤検知や重複する問題が生じるリスクも伴います。その精度データ(有効率88%、偽陽性率1%)および実際のプロジェクトからのフィードバック(wolfSSLやcurlなど)は、現在のAI主導型脆弱性発見能力に関する実証的なベンチマークを提供しています。

経緯と関連報道

四分の一PRは「AIゴミ」だ!Linux財団が新たな報告書を発表:AIによるコード生成は52%速くなったが、オープンソースのメンテナーはかえって疲れている

Linux財団は10月20日に発表した報告書で、生成型AIによりコード作成にかかる時間は平均52%短縮された一方で、オープンソースプロジェクトのメンテナーらは、プルリクエストの約25%が低品質な「AIスロップ」に該当すると推定していると指摘しました。大規模プロジェクトではその割合が31%にまで上昇しています。報告書は、効率向上による恩恵が審査やガバナンスのコスト削減には必ずしも反映されておらず、正式なAI貢献ポリシーを策定しているプロジェクトは全体の35%にとどまっていることを明らかにしています。さらに、メンテナーの疲弊と信頼不足が顕在化している状況も浮き彫りにされています。

経緯と関連報道

Apple初の折りたたみ式スクリーン搭載iPhone Duoが発売と同時に、画面の集中的な割れ問題が発生している

複数のユーザーから、Apple初の折りたたみ式スマートフォン「iPhone Duo」について、開封後わずかな時間でヒンジの真上部分の画面にひび割れや線状の破損が生じるという報告が寄せられており、故障の発生が極めて集中しているとのことです。オーストラリアおよび中国国内でも同様の事例が確認されており、原因はヒンジの組み付け公差にあると疑われています。Apple公式からのコメントはまだなく、アフターサービスでの判定結果次第で、無償交換か高額な自己負担による修理が決まる見込みです。

注目する理由:本件は、新製品における大規模な初期不良をめぐる事案であり、消費者の権利と企業の責任の境界に直面するものであるとともに、三包法規の適用性やAppleCare+サービスの位置付けといった公共的課題も重なり、典型的な警鐘としての意義と権利救済の参考価値を有している。

経緯と関連報道

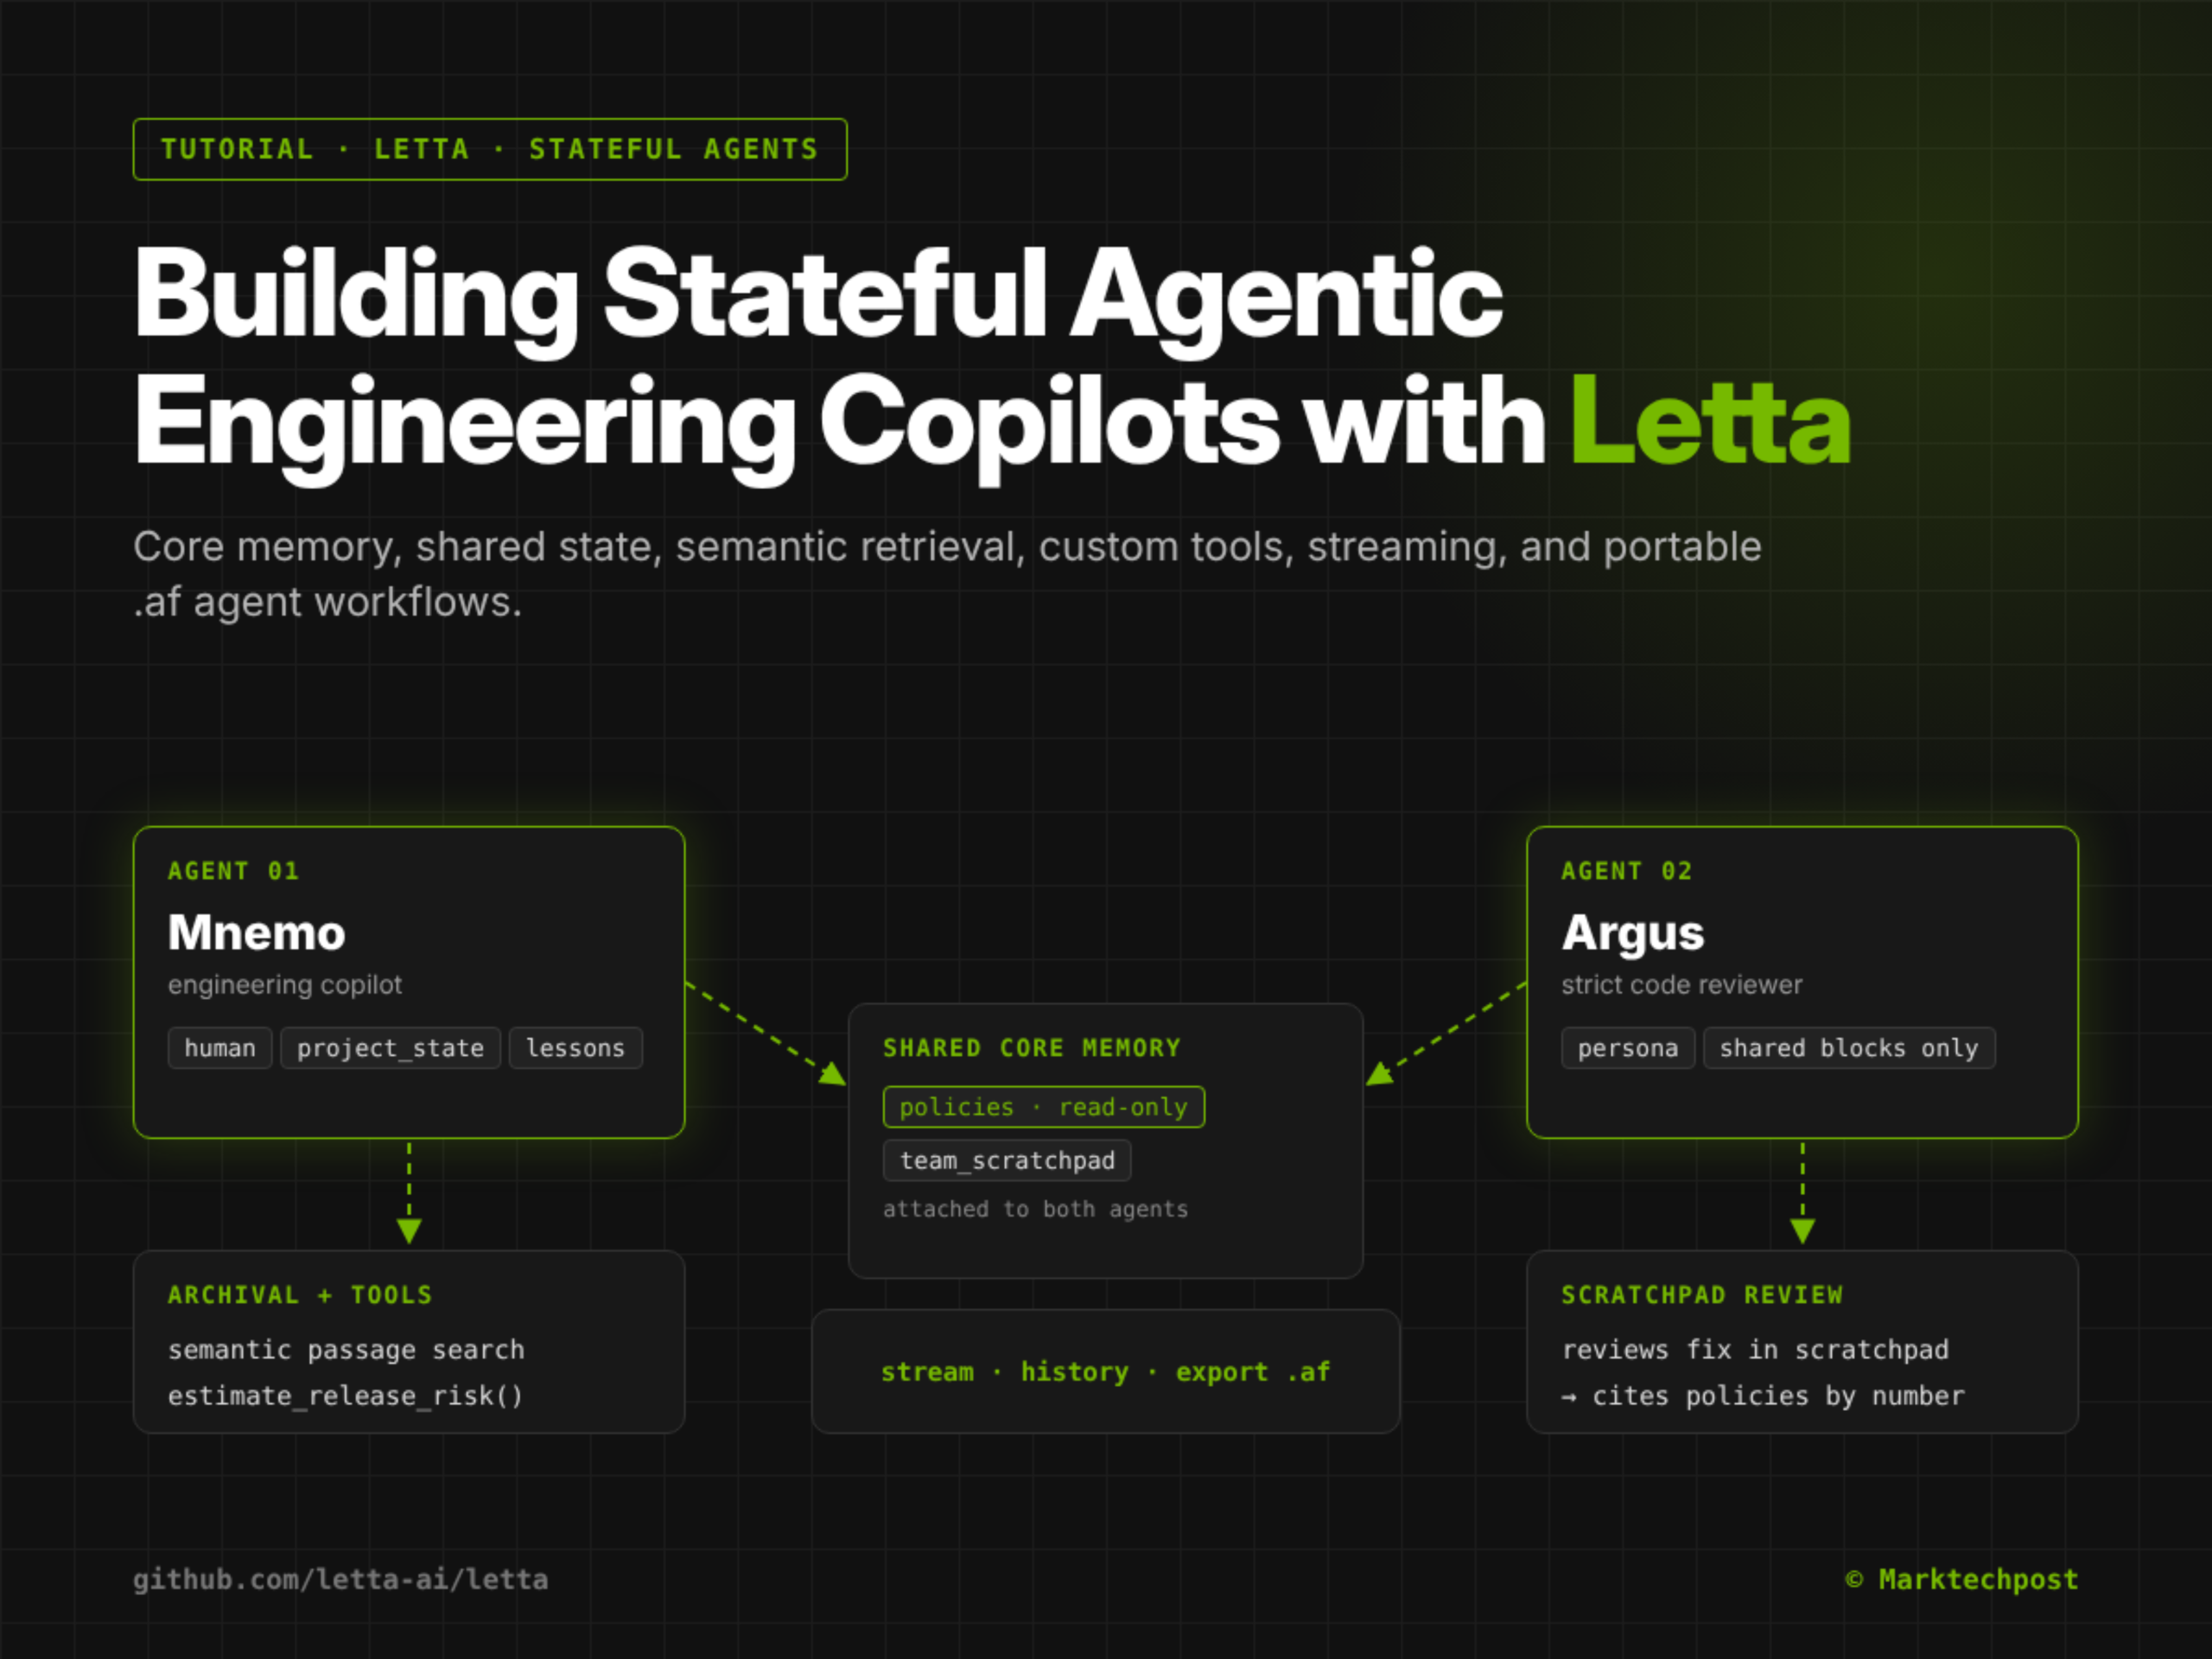
Lettaプラットフォームが、ステートフルなエンジニアリングにおける共同作業者向けの構築チュートリアルを公開:コアメモリ、共有状態、およびポータブルなワークフローをサポート

MarkTechPostは2026年10月24日、Lettaフレームワークを基に永続的状態を備えたエンジニアリング協働者(agentic copilot)を構築する方法を紹介するチュートリアルを公開しました。内容には、検証可能なコアメモリ、マルチエージェント間の共有メモリ、セマンティック検索による知識のアーカイブ、カスタムPythonツールの統合、ストリーミング応答、および .agent形式(.af)でのエクスポートといった機能が含まれます。本稿は技術実践ガイドであり、性能指標やセキュリティ監査、あるいは本番環境での検証については提供されていません。

Stateful Agentic Engineering Copilots with Letta: Core Memory, Shared State, Semantic Retrieval, Custom Tools, Streaming, and Portable Agent Workflows
経緯と関連報道

研究では、自己評価強化学習フレームワークSARLを提案し、検索拡張型大規模モデルの探索状態認識能力を向上させました。

2026年10月24日、arXivは論文arXiv:2610.30435v1を公開し、既存の検索強化型大規模言語モデルにおいて、検索エージェントが検索状態を認識する能力を欠いているという問題を解決することを目的とした、自己評価強化学習(SARL)フレームワークを提案しました。

Self-Assessment Reinforcement Learning for Search-State Awareness in Retrieval-Augmented Large Language Models

注目する理由:本研究は、検索強化型大規模言語モデルが複雑なタスクにおいて、既知または欠落した情報を認識できないことから生じるハルシネーションによる推論や探索の早期終了という重要な課題に対し、テスト時の追加評価を必要としないエンドツーエンドの強化学習手法を提案し、マルチジャンプ推論および深層研究のベンチマークにおいて顕著な性能向上を実現しました。

経緯と関連報道

CiteAnchor:幻影引用の検出と解決のためのソース意識型グラウンディング

arXiv:2610.30355v1 発表タイプ:新規 要旨:幻影引用は、科学的主張の背後にある証拠を追跡し、その信憑性を検証することを困難にします。これらの引用を検出するのは、書誌情報が不完全であったり、ソースの種類や出版物のバージョンによって異なるため、非常に難しいです。妥当な一致だけでは、その引用が正当化されるわけでも、その背後にあるソースが特定できるわけでもありません。私たちは、ソースの復元可能性について注釈付きで構築された、実世界の幻影引用423件からなるベンチマークであるCiteResolveを提案します。さらに、ソースごとに検索とフィールドレベルの検証を適応させ、引用の妥当性および固有のソースが復元可能かどうかを個別に判定する、ソース意識型グラウンディングフレームワークであるCiteAnchorを提案します。既存の検出ベンチマークにおいて、CiteAnchorはGPT-5.6を用いてF1スコア0.841を達成しました。

CiteAnchor: Source-Aware Grounding for Hallucinated Citation Detection and Resolution
経緯と関連報道

新たな研究は、言語間貧刺激(CPOS)実験パラダイムを提案し、言語モデルの階層的汎化能力における条件付き移行を明らかにした

2026年10月24日、arXivは論文2610.30960v1を公開し、言語モデルが多言語間の継続的学習において、源言語(L1)の階層構造に関する証拠を目標言語(L2)へ移行する能力を定量化するための、跨言語貧刺激(CPOS)実験デザインを提案した。実験の結果、この移行は部分的には成立するものの完全ではなく、しかも言語ペアおよび語彙の重複度に大きく依存することが示された。

Once a Tree, Always a Tree? Cross-lingual Transfer of Hierarchical Generalization in Language Models

注目する理由:本研究は、制御可能な言語間の貧刺激フレームワークを初めて構築し、『言語の普遍的構造』が非言語的要因(例えば位置エンコーディングの初期化など)のみによって駆動されるのではなく、言語間移行の認知的基盤を形成しているかどうかを直接検証した。その結論は、大規模言語モデルにおける文法習得メカニズムおよび多言語間のアライメント戦略を理解するうえで、方法論的・理論的な両面において重要な価値を有している。

経緯と関連報道

研究では、自己回帰型の大規模モデルによる制御を戦略的に正確な並列推論へとコンパイルし、階層型RAGの効率を向上させる手法が提案されています。

2026年10月24日付でarXivに掲載された研究論文(ID 2610.30664v1)は、階層型検索強化生成(Hierarchical RAG)における大規模言語モデルの自己回帰制御ロジックを、ポリシー厳密(policy-exact)な並列推論フローへとコンパイルする新手法を提案しており、MetaXデバイス上で制御遅延を35~47%低減しつつ、同時に84~89%のポリシー一貫性を維持しています。

Compiling Autoregressive LLM Control into Policy-Exact Parallel Inference for Hierarchical RAG

注目する理由:本成果は、LLMを構造化された意思決定コントローラとして用いる際に広く見られる、逐次的なテキストデコーディングに依存するボトルネックに対し、理論的に証明可能な並列化コンパイル手法を提案しています。実験は実機(MetaX、H800)および複数のデータ分割を用いて検証されており、高い効率性と明確な技術的詳細を備え、最先端の信頼性あるAIシステムの最適化に関する研究です。

経緯と関連報道

Lighthouse:米国民権運動史に特化した信頼性の高いデジタルアシスタントが初公開

論文arXiv:2610.30158v1は2026年10月24日に公開され、南カロライナ州のアーカイブデータに基づく米国民権運動期の歴史を探索するための初の専用デジタルアシスタント「Lighthouse」について紹介しています。その核心的な革新点は、信頼できるコンテンツとユーザーへの危害軽減を設計原則として掲げ、ニューラル・シンボリックハイブリッドアーキテクチャを採用し、大規模言語モデルと規則ベースのシンボリック推論を統合していることです。

Lighthouse: On Building a Trustworthy Digital Assistant for Exploring History with Civil Rights Archives

注目する理由:本研究は、AIを活用した歴史探求を初めて公民権運動という敏感かつ重要な歴史的時期に焦点を当て、一般的なチャットボットとは異なり、「信頼性」と「被害モデリング」という二重の制約を明示しました。その方法論(ニューラル・シンボリック統合)、評価手法(専門家による合意に基づく主観的設問のゴールドスタンダードを含む)、およびデータ規模(1万8千件を超える一次資料)はいずれも学術的な模範的価値を有しています。

経緯と関連報道

CTCとニューラルトランスクリプターモデルの探索空間の複雑性と効率を比較する研究

この論文は2026年10月24日にarXivに掲載され(番号2610.31259v1)、接続時系列分類(CTC)とニューラルトランスクリプタの二種類のエンドツーエンド音声認識(ASR)モデルについて、異なるプリング戦略および言語モデルの構成下での探索空間の複雑性と推論効率を系統的に比較しています。

A Systematic Comparison of Search Space Complexity and Efficiency for Time-Synchronous End-to-End ASR Models

注目する理由:論文は実証分析に基づき、エンドツーエンドのASRモデルは多くの場合小さな探索空間を維持しているものの、音声の不確実性が高まる時間帯には仮説数が顕著に一時的にピークを示すことを指摘している。また、スコアに基づく動的なプルーニング手法はモデルの不確実性に適応し、リアルタイム係数(RTF)を大幅に低減することで、効率的な探索に向けた実践的な指針を提供する。

経緯と関連報道

低資源言語における研究の進捗と言語的包摂の測定

arXiv:2610.30296v1 発表タイプ:新規 要旨:大規模言語モデル(LLMs)は、低資源言語および多言語NLPに関する研究を加速させてきたが、公平な研究環境の実現にどの程度寄与しているかについては未だ明らかになっていない。本研究では、2020年から2025年にかけて公開された査読付きオープンアクセス論文1,158件を対象に、低資源言語(LRLs)への研究関心や、言語・話者集団間の代表性を分析した。出版数以外の観点から言語的包摂を評価するため、研究成長、代表性拡充、代表性継続性、分布的公正性の4つの次元で言語的包摂を測定する多次元フレームワーク「言語的包摂フレームワーク(LIF)」を提案する。年間の論文数は52件から415件へと5.4倍に増加した一方で、ACLアンソロジーにおける

Measuring Research Progress and Linguistic Inclusion in Low-Resource Languages
経緯と関連報道

Googleのプライバシーポリシーが更新:AI機能の利用により、Gmailおよび写真データが広告ターゲティングに使用される可能性があります

Googleは10月16日にプライバシーポリシーを更新し、新たな例外条項を追加しました。ユーザーが自らGmail、Google Drive、またはGoogle Photosのデータを、AIモードや新バージョンのSearchツールなど、パーソナライズド広告に対応する他のGoogleサービスに連携した場合、これらの個人データが広告のターゲティングに利用される可能性があります。

経緯と関連報道

バイエル・クロップサイエンスは、Amazon Bedrock AgentCoreを基に、マルチエージェント型意思決定エンジンADEを構築しました。

バイエル・クロップサイエンスは、育種専門家、アナリスト、研究者向けの自然言語対応マルチエージェントプラットフォームであるAgentic Decision Engine(ADE)をAmazon Bedrock AgentCore上に構築し、これを既存のConnected Decision Engine(CDE)の強化層として位置付け、代替とはしていません。同システムは本番環境で稼働しており、100名を超えるR&Dユーザーにサービスを提供しています。22の分野特化型エージェントと約20のAPIツールにより、問題の約80%をセルフサービスで解決しています。

経緯と関連報道

アルミン・ロナッハーの引用

AIは確かに楽しいものですが、過去30年間にわたってあまりにも多くの質の低いソフトウェアが作られ、今や宇宙が私たちの過ちを罰しているのです。— アルミン・ロナッハー タグ:セキュリティ、生成型AI、アルミン・ロナッハー、AI、AIセキュリティ研究、大規模言語モデル

経緯と関連報道

AnthropicがClaude Duetアプリをリリース:専門的なシーンに特化したAIエージェント製品

Anthropicは、プロフェッショナルと小規模企業向けのAIエージェントアプリ「Claude Duet」を正式にリリースしました。これはClaude Opus 5.5モデルをベースとしており、6,000を超えるコネクタに対応し、日次レポートの自動生成、ダッシュボードの構築、操作の提案、バックグラウンドタスクの実行が可能です。現在はProおよびMaxのサブスクリプションユーザーのみが、待機リストでの試用にアクセスできます。

経緯と関連報道

IBMはGranite時系列統合予測モデルを発表しました。4つのモデルをゼロチューニングで組み合わせ、堅牢なデフォルトの予測ソリューションを提供します。

IBM Researchは、オープンソースのGranite Timeseries Ensemble(v1)を公開し、PatchTST-FM-r1/r2、FlowState、Tiny Time Mixersの4種類の事前学習アーキテクチャを統合して、ゼロ・ファインチューニングによる確率的アンサンブル予測をサポートしています。デフォルトでは等重みの確率的アンサンブル(Probabilistic Ensemble)を採用しており、四分位範囲に基づく適応的重み付け(IQR Ensemble)も提供されています。GIFT-Evalベンチマーク(2026年10月20日時点のスナップショット)において、点予測誤差(MASE=0.683)は最良の単一モデルをわずかに上回り、全体的なロバスト性が顕著に向上しています。

経緯と関連報道