
Anthropicが大ヒットAIのIPOに向けたS-1書類を提出
人工知能の巨大企業であるAnthropic PBCは本日、米国証券取引委員会に新規株式公開(IPO)のための書類を提出し、先進的なAIに関する警戒が高まる中、今後登場するAI開発企業としてはおそらく最大規模となる株式市場への上場に向けて軌道に乗った。同社は提出書類の中で、[…]に上場する予定であると述べた。記事「Anthropic、大型AI IPO向けのS-1申請書類を提出」は、SiliconANGLEに最初に掲載された。
見出し・要約・本文から、情報のつながりを探します。
人工知能の巨大企業であるAnthropic PBCは本日、米国証券取引委員会に新規株式公開(IPO)のための書類を提出し、先進的なAIに関する警戒が高まる中、今後登場するAI開発企業としてはおそらく最大規模となる株式市場への上場に向けて軌道に乗った。同社は提出書類の中で、[…]に上場する予定であると述べた。記事「Anthropic、大型AI IPO向けのS-1申請書類を提出」は、SiliconANGLEに最初に掲載された。
Anthropicは月曜日、同社の財務状況やリスク要因、そしてAIの未来に関する見解を示す、注目のIPOに先立ち、関連書類を提出した。
Rampは、社内AIを分析エンジニアリングとして扱うことで構築したエージェント、サンドボックス、ダッシュボードを共有しています。
Veriskは、メインフレームからdbtへと、数十年にわたる保険データを近代化し、AI対応の体制を整えました。
データサイエンティストが、dbtプロジェクトだけでは保持できない組織のナレッジ向けのAIコンテキスト層をどのように構築したか。
今日は、AI業界の最近の劇的な変革を詳述した新刊『The AGI Chronicles』の著者でジャーナリストのケビン・ルースとお話しします。ケビンは長年ニューヨーク・タイムズの記者を務め、人気ポッドキャスト「Hard Fork」のホストでもありました。しかし彼と、同番組の友人であるケイシー・ニュートンは、先日[…]を去りました。


機械にとって「夜」とは何でしょうか?
カリフォルニア州の企業が、今年の米国におけるスタートアップ資金調達の4分の3以上を獲得しています。Crunchbaseのデータによれば、これは明らかに過去最高水準のシェアです。なお、今年はまだ数か月残っています。
Coyotecはバイリンガルで、罵倒も織り交ぜながら、リスナーにICEからの身の守り方を伝える。その人気は、より多くの放送局が人工的な人格を試しているなかで高まっている。
arXiv:2610.32114v1 公表タイプ:新規 要旨:AIアライメントの進展を加速する一つの手法は、アライメント研究そのものの一部を自動化することである。そのためには、研究提案における欠陥の特定や、提案された実験が意図した主張を支持するかどうかの評価といった、監督が困難な研究課題に対しても信頼性高く機能するシステムが必要となる。この能力を評価するため、我々はTampered MLを導入する。これは、公開されている機械学習論文から再構成された実験提案と、目的とした方法論的欠陥を導入した最小限に編集された対照案からなる、1,858組の項目ペアからなるベンチマークである。モデルは、提示順序に関わらず、より方法論的に妥当な提案を識別しなければならない。層化抽出サンプルに基づく人間による検証研究では、全体の86%が…
arXiv:2610.32638v1 発表タイプ:新規 要旨:大規模言語モデル(LLM)の推論は、企業向けおよび対話型アプリケーションの基幹サービスとしてますます導入されていますが、主権・コンプライアンス・遅延・リソースの局所性といった要件により、集中型クラウド展開の適応性が制限されることがあります。通信事業者は、これらの制約に対処するため、地理的に分散した計算およびネットワークインフラを提供しています。しかし、既存のLLMサービスフレームワークは、緊密に結合されたデータセンター向けに設計されており、地理的に分散し多様なリソースの調整には十分なサポートを提供していません。そこで私たちは、通信事業者インフラ上でサービスレベル目標(SLO)主導型のLLM推論を実現するためのリファレンスアーキテクチャであるInferSliceを提案します。本アーキテクチャは、ネットワークスライシング、GPUパーティショニング、エラスティックなサービス提供、ならびに可観測性を統合しています。

arXiv:2610.31971v1 発表種別:新規 要旨:大規模言語モデル(LLM)エージェントは、個人や組織に代わって交渉に参加する機会が増加している一方で、特に反復的な多者間のやり取りにおいては、依然として操作のリスクにさらされています。従来のマルチエージェントシステムは、明示的な信頼および評判モデルによってこの課題に対処してきましたが、既存のLLMによる交渉に関する研究では、信頼をむしろ創発的な現象として扱うものが主流です。本研究では、過去の相互作用から有用な信頼評価を形成し、それを活用して将来の交渉結果を改善できるかどうかを検証します。さらに、繰り返し参加するエージェントが一連の交渉ゲームに携わる中で、一方の参加者が密かに合意成立を妨害しようとする、反復的かつ多者間・多問題型の交渉フレームワークを提案します。
arXiv:2610.31721v1 発表タイプ:新規 要旨:評価コストが高く、複雑な制約条件下で高次元の物理系を最適化することは、科学および工学における中心的な課題である。オフラインのモデルベース最適化(MBO)では、テスト時に真の目的関数にアクセスできない状況下で、固定されたデータセットのみを用いて設計を改善しなければならない。しかし、既存の手法は一般的に保守的すぎる、代理モデルの無制限な活用、あるいは精密な物理的目標に対して候補を精緻に修正できない静的な推論時サンプリングとして機能するといった問題を抱えている。本稿では、確定的サンプリングにより逆ノイズ除去チェーンが条件付信号に関して微分可能となるという事実を活用した、オフラインMBO向けの微分可能な拡散条件付け(D2C)を提案する。D2Cは…
arXiv:2610.31966v1 発表タイプ:新規 要旨:文脈内学習におけるデモンストレーションは、しばしば意味的類似性によって取得されるが、これは構造化予測における関連性を十分に反映しない場合がある。本研究では、POSシグネチャーに基づくポリシーを用いて、Universal Dependenciesの構文解析におけるデモンストレーション選択を検討した。このポリシーは文を重み付けされた品詞統計で表現し、ラベル付き訓練分割から長さが一致するゴールド解析済みの例を3つ取得する。我々は、微調整を行わないオープンウェイト言語モデル2種をUD English Web Treebankテストセットの全2,077文に対して評価し、ショット数やフォーマットが一致する固定および意味的3ショットベースライン、さらにゼロショット、チェーンオブソート、クリティック・リファインメントシステムと比較した。POSシグネチャーによる検索は、最も高いラベル付きアタ
arXiv:2610.31846v1 発表タイプ:新規 要旨:知的エージェントは自らのミスから学び、経験を通じて継続的な改善を図るべきである。しかし、今日のエージェントはミスから回復しても、その効果は一時的でしかない。文脈内での振り返りはセッション間で容易に忘れられ、限られた文脈資源と競合する一方で、パラメータ全体の微調整はコストが高く、既存の能力に干渉するおそれがある。そこで私たちは、一時的な文脈内再試行とポリシー更新の利点を組み合わせた、エージェントがミスから学ぶための仕組み「Self-Direction」を提案する。エージェントがタスクに失敗した際、自身の行動経路を振り返って教訓を抽出し、それを即座に軽量な低ランクアダプターへと凝縮する。元の重みを固定することで、Self-Directionはアダプターの学習による上書きを防ぎ
arXiv:2610.32060v1 発表タイプ:新規 要旨:マルチエージェントLLMシステムは、議論や証拠の共有、相互修正を通じて推論能力の向上を図るが、相互作用によっては最終的な精度だけでは説明できないような失敗が生じることもある。エージェントは早期に収束してしまったり、異論を無視したり、正しい少数派の解答を抑圧したり、ラウンド間で誤ったフレーミングを維持したりする場合がある。本研究では、医療QA、コーディング、金融、多段階推論、倫理、そして具現化されたテキストタスクにおいて観察された3,211件のマルチラウンド失敗トラジェクトリーに基づき、コルパスに根ざしたコミュニケーション失敗の分類体系を提示する。この分類体系を用いて、データセットおよびシステム設計ごとの失敗分布、ラウンドレベルでのエラー動態、回復の難易度、多数派への移行、少数派信号の抑制、さらには自己報告された信頼度などを分析する。その結果、
arXiv:2610.31911v1 発表タイプ:新規 要旨:大規模言語モデル(LLMs)がますます長いシーケンスを処理するにつれ、アテンションは主要な計算上のボトルネックとなっています。疎なアテンション手法は主に推論段階での利用を対象としていますが、多くの手法は依然として密集型で学習を行ったり、疎な学習に対応できなかったりします。さらに、その追加の複雑さにより、疎さを実際の実行時間の短縮へと結びつけることが難しく、結果として実用的には密集型アテンションが広く用いられています。本論文では、アテンションの学習は後方パスが支配的であるという観察に基づき、前方パスを完全に密集型に保ちつつ、後方パスを疎にするLazyFlashという手法を提案します。LazyFlashは前方パスを厳密に密集型に維持するため、学習済みモデルは従来の密集型モデルのままであり、vLLMなどの既存システムでも一切変更なしにサービス可能です。一方、後方パスについては、LazyFlashは勾配を…
arXiv:2610.32215v1 発表タイプ:新規 要旨:現代のGPUデータセンターにおける計算能力の向上により、一部の産業大手企業が膨大なデータを用いて大規模言語モデル(LLM)を訓練し、展開できるようになりました。しかし、これらのモデルとその学習データの圧倒的な規模は、集中型の開発をますます維持困難にすると同時に、関連するプライベートデータを保有しながら同等のインフラを持たない小規模機関を排除しています。本論文では、分散型LLMトレーニングに関する我々の立場を、事前学習および微調整のパラダイムを中心に整理し、フェデレーテッド学習、スプリット学習、そして分散型アプローチを取り上げ、それらが地理的に分散した環境下で、多様なハードウェアや信頼性の低い接続状況においてどの程度実用可能かを評価します。さらに、我々は「統一された」システムを提案します。
マイクロソフト研究院は2026年10月25日、中央調整者を必要としないマルチエージェント実行時フレームワークであるAgenshをオープンソース化しました。Agenshは、ProgramBench上で1~1024のLLMベースのコーディングエージェントが自己組織的に協調して動作することを支援します。システムはGitea、Mattermost、DeLMスタイルの共有ボードに基づいて分散型の調整を実現しており、すべてのエージェントが同一のプロンプト駆動型五段階ループを実行します。また、Linux+Docker環境下でスケーラビリティが検証されています。
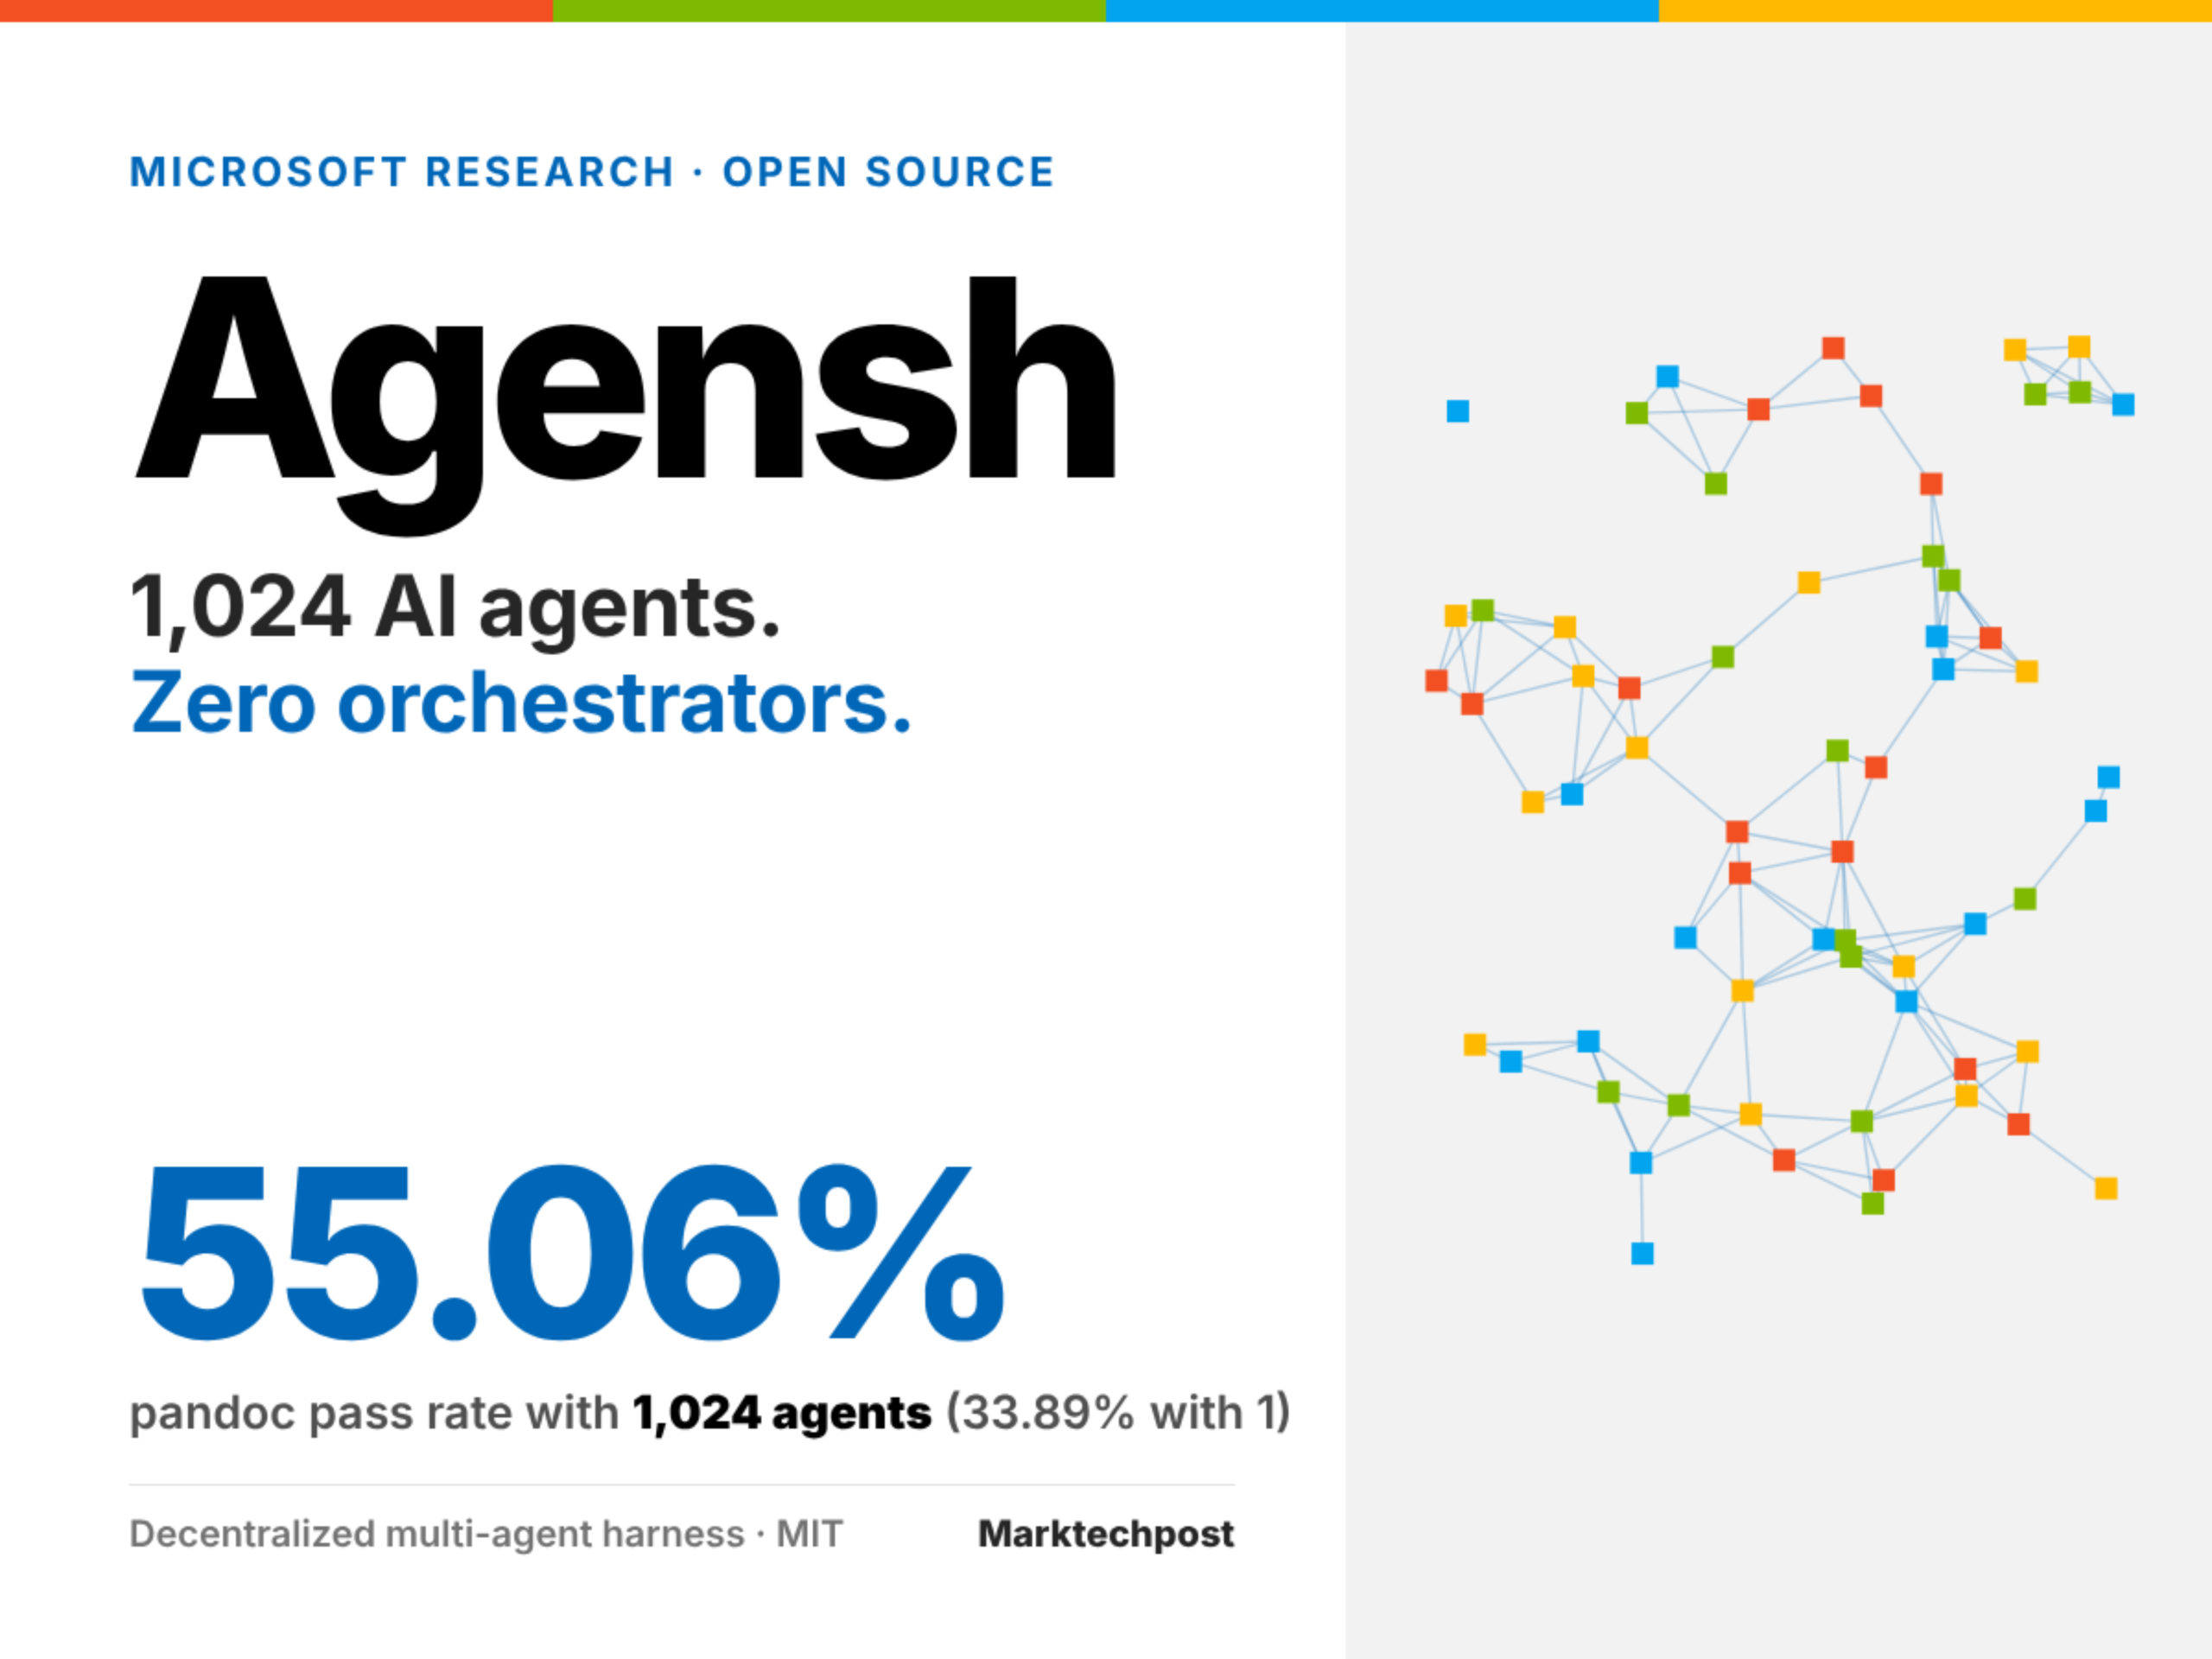
注目する理由:この成果は、マルチエージェントシステムアーキテクチャの重要な進化を示しており、従来の「マスターエージェント」型パラダイムを廃し、プロンプトエンジニアリングと軽量なサービスの組み合わせによって大規模な自己組織化を実現しています。ProgramBenchにおける実証データ(たとえば、128個のエージェントによる5つのタスクの均等分配において49%の性能向上)は、分散型AIの設計・実装に新たなベンチマークを提供しています。また、MITライセンスでオープンソース化されており、Copilot CLIなどの主流な単一エージェントツールとも互換性があるため、実際の開発における参考価値も備えています。
同論文は2026年10月24日、arXivにて公開され(番号2610.30379v1)、MemPlan——大規模言語モデル(LLM)を言語と記号計画の間の制約付き橋渡しとして用いる、記憶条件付PDDL計画フレームワーク——を提案しており、部分観測可能な対話型テキスト環境に適用可能である。
注目する理由:MemPlanは、正のグラフによる記憶と負の記憶メカニズムを用いてPDDL問題を動的に再構築し、タスク完了率と手順数の効率を大幅に向上させるとともに、オンラインでのトークン消費も大きく削減します。また、そのオフライン微調整可能な言語–記号インターフェースはTextWorld系のタスク間で再利用可能で、タスク固有の微調整が不要であるため、本手法の汎用性と実用性が示されています。