本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

LangChainが「企業向けエージェントフレームワーク」の5つの主要コンポーネントを発表

LangChainは2026年10月25日にブログを公開し、マーケティング、セールス、エンジニアリングの各チーム内でAIエージェント(GTM Agent、OpenSWE、Content Studio)を導入する際に蓄積された、以下の5つの一般的なアーキテクチャ原則を体系的に説明しました。すなわち、ネイティブな統合ワーク環境(Slack)、動的なアイデンティティモデル(OBO+固定資格情報)、二層メモリ機構(グローバル/ユーザー単位)、サンドボックス化されたコード実行、そして高い割合でのスケジュール実行(手動トリガーではない)です。すべてのエージェントはManaged Deep Agentsプラットフォームに基づいて構築されています。

注目する理由:この情報はLangChainの公式ブログから引用したもので、公開日時(2026-10-25T18:06:32.000Z)は現在のシステム時刻(2026-10-25T23:01:18.857Z)より前であり、内容はすでに実装された社内用インテリジェントエージェントの実践事例に焦点を当てています。詳細も具体的で(Slackのスレッド分離、GitHubアカウントの所有権帰属ロジック、NotionやTwitterの権限階層など)、未検証の予測や外部からの主張は含まれておらず、時宜性と事実性の要件を満たしています。

経緯と関連報道

llama.cpp がバージョン b11871 をリリース:サービスのクラッシュを防ぐため、JSON のネスト深度に制限を追加

llama.cpp のバージョン b11871 では、重要なセキュリティ修正が導入され、リクエスト内の JSON のネスト階層に対して 128 層のハード制限を設けることで、深い再帰的解析による HTTP スレッドスタックのオーバーフローおよびサービスのクラッシュ(macOS では SIGBUS、Linux では SIGSEGV をトリガー)を防止しています。この対策は、chat インターフェースの複数の入力シナリオに適用され、統一的に HTTP 400 エラーを返します。

経緯と関連報道

アンダードッグ・サルキ27B:GSQ-RCOをベースとした2ビットQwen3.8-27Bのツール呼び出しモデルに関する技術解説

本記事では、Underdogが公開したSaluki 27Bモデル——7.9 GBの2ビット量子化を採用したQwen3.8-27Bの変種——について紹介します。同モデルはISTA-DASLabのGSQ-RCO手法を用いて構築されており、120タスクにおけるBFCL v4ツール呼び出しベンチマークにおいて、元の54 GBのフル精度モデルを上回るとされています。ただし、すべての性能に関する結論は開発者による声明に基づくものであり、独立した検証は行われていません。

How to Run Underdog Saluki 27B: 2-Bit Qwen3.8-27B Tool-Calling Guide
経緯と関連報道

llama.cpp が b11870 バージョンをリリースし、DeepSeek-V4.1-Flash モデルを正式にサポートしました

llama.cppはバージョンb11870において、DeepSeek-V4.1-Flash(deepseek41)モデルへの対応を追加し、そのEngramアーキテクチャに対してKVキャッシュ計算の簡略化、BF16精度によるMXFP8代替、in-graph行gatherなど、複数の低レベル最適化を施しました。同時に、macOS、Linux、Windows、Android、iOSおよびopenEulerを網羅するマルチプラットフォームのバイナリビルドも提供しています。

経緯と関連報道

llama.cpp がバージョン b11869 をリリース:Jinja テンプレート関数の引数処理を修正し、マルチプラットフォーム対応のバイナリを新たに追加

llama.cpp プロジェクトはビルドバージョン b11869 をリリースしました。主な修正点は、Jinja テンプレートにおける select 関数および selectattr 関数の引数解析ロジックであり、macOS、Linux、Windows、Android、iOS、および openEuler に対応した数十種類のハードウェアとバックエンドの組み合わせをカバーするプリコンパイル済みバイナリパッケージを提供しています。

経緯と関連報道

llama.cpp がバージョン b11867 をリリース:サーバーエンジンのエントリーポイントを再構築し、マルチプラットフォームと異種アクセラレーションバックエンドを全面的にサポート

llama.cpp が GitHub 上で正式にバージョン b11867 をリリースしました。主要な変更点として、サーバー側のエントリーポイントの再構築(PR #31113)と、server_role 機構の追加が挙げられます。また、macOS、Linux、Windows、Android、iOS、openEuler を対象とした 40 種類以上の事前ビルド済みバイナリパッケージを提供しており、CPU、CUDA(12.4/12.8/13.4)、Vulkan、ROCm 10.0、OpenVINO、SYCL(FP16/FP32)、Snapdragon(Adreno+Hexagon)など、多様なハードウェアバックエンドをサポートしています。

経緯と関連報道

llama.cpp が b11865 バージョンをリリース:RDMA 受信の境界チェックを追加し、CUDA 13.4、ROCm 10.0、Snapdragon NPU など、複数のプラットフォーム向けバックエンドをサポート

llama.cpp プロジェクトはビルドバージョン b11865 をリリースし、主要な変更点として、RDMA 受信ロジックにメモリ境界チェックを追加(PR #30399)するとともに、ハードウェアアクセラレーションのサポートを大幅に拡張しました。これにより、CUDA 13.4、ROCm 10.0、Vulkan、OpenVINO、SYCL、さらに Qualcomm Snapdragon(CPU+Adreno+Hexagon)によるフルスタックの異種計算バックエンドが対象となります。なお、macOS における KleidiAI のサポートおよび openEuler 上でのビルドは、明示的に DISABLED とマークされています。

経緯と関連報道

llama.cpp がバージョン b11861 をリリース:minimax-m3 モデルの量子化スケーリングテンソルが伝達されないことで生じる推論エラーを修正

llama.cpp v.b11861 では、minimax-m3 モデルにおいて NVFP4/MXFP8 の量子化下でスケールテンソルが計算グラフに注入されないために生じていた重みの歪み問題を修正し、『token soup』や残差の埋没を回避しました。また、macOS、Linux、Windows、Android、iOS、openEuler を網羅するマルチプラットフォーム対応のバイナリビルドも同時に提供されています。

経緯と関連報道

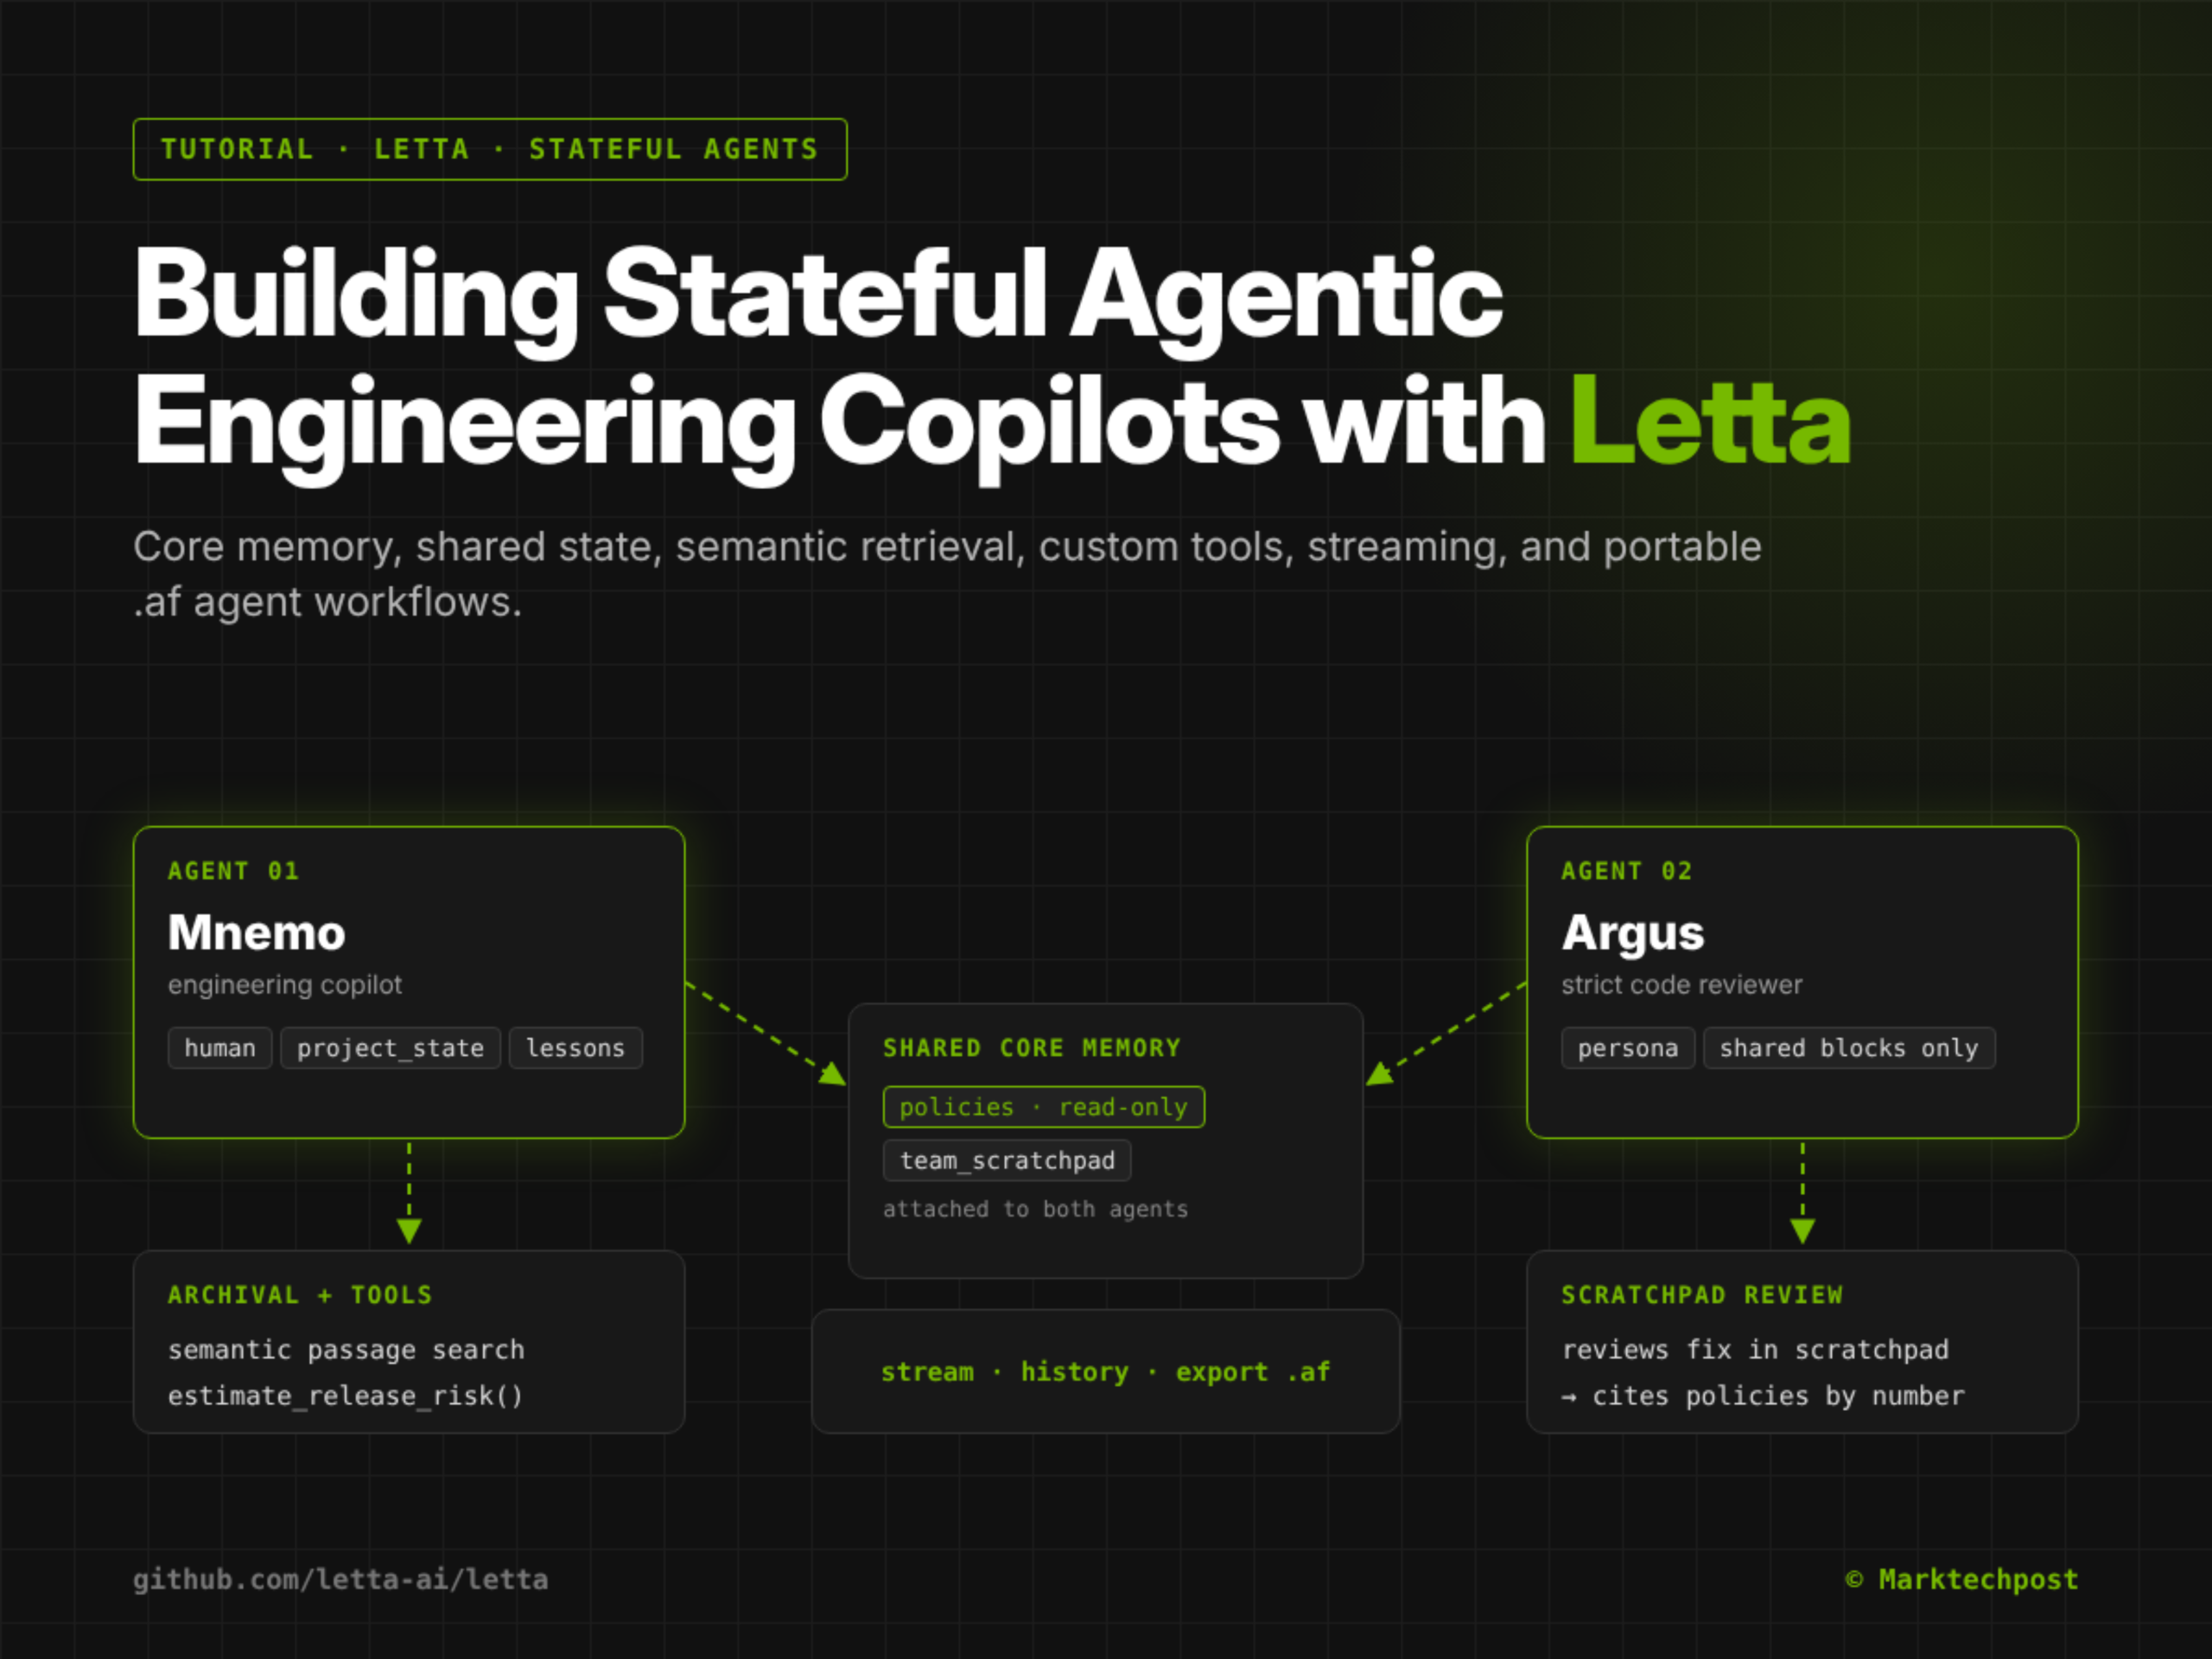
Lettaプラットフォームが、ステートフルなエンジニアリングにおける共同作業者向けの構築チュートリアルを公開:コアメモリ、共有状態、およびポータブルなワークフローをサポート

MarkTechPostは2026年10月24日、Lettaフレームワークを基に永続的状態を備えたエンジニアリング協働者(agentic copilot)を構築する方法を紹介するチュートリアルを公開しました。内容には、検証可能なコアメモリ、マルチエージェント間の共有メモリ、セマンティック検索による知識のアーカイブ、カスタムPythonツールの統合、ストリーミング応答、および .agent形式(.af)でのエクスポートといった機能が含まれます。本稿は技術実践ガイドであり、性能指標やセキュリティ監査、あるいは本番環境での検証については提供されていません。

Stateful Agentic Engineering Copilots with Letta: Core Memory, Shared State, Semantic Retrieval, Custom Tools, Streaming, and Portable Agent Workflows
経緯と関連報道

ULMEフレームワークは、テキスト埋め込みと言語モデリングを真に統合する:arXivの新論文が予測結合メカニズムを提案

2026年10月24日、arXivは論文arXiv:2610.30705v1を公開し、因果推論型デコーダーに基づく大規模言語モデル向けの後訓練フレームワークであるULMEを提案しました。この手法は、予測的結合(predictive coupling)メカニズムを用いることで、テキスト埋め込みと言語生成能力を相互に強化しつつ統合することを初めて実現しました。本手法はQwen2.5/Qwen3シリーズ(0.5B~8Bパラメータ)において有効性が確認されており、MTEBスコアで3.3~4.1ポイントの向上を達成するとともに、生成タスク(MMLUなど)の性能も低下させませんでした。

ULME: Predictive Coupling for Mutually Reinforcing Embedding and Language Modeling

注目する理由:本論文は、現在の多モーダルLLMにおける能力の断片化という核心的な問題を正面から指摘している。すなわち、埋め込みと生成は長らく独立したモデル、あるいはパラメータのみを共有する“疑似統一”モデルによって担われてきた。ULMEは、学習可能なスロットと三目標による共同学習(ストップグレード付き予測損失を含む)により、生成プロセスが埋め込み表現を能動的に形成する仕組みを実現しており、アーキテクチャレベルでの実質的な飛躍である。実験の範囲は広く、ベースラインも強力で、評価指標も網羅的であり、さらに権威あるプレプリントプラットフォームに公開されているため、タイムリーさと技術的厳密性の両面を備えている。

経緯と関連報道

研究により、大規模言語モデルにおける意味の局所的幾何学的構造が明らかになった

2026年10月24日にarXivに掲載された論文(番号2610.30715v1)は、クロス言語プローブおよび細分化プローブを用いて、Gemma 4、Llama 3.2、Qwen 2.5、Pythiaの4つのデコーダーのみの大規模言語モデルにおいて、埋め込み空間における意味的意義の局所的な幾何学的特性を明らかにした。

Meaning Contracts: Local Semantic Geometry in Large Language Models

注目する理由:本研究は、LLMにおける「同一の意味因子」内部の不変性・可変性・細分化メカニズムを初めて体系的に解明し、「局所的異方性近傍」モデルを提案しました。さらに、人間によるブラインド評価によって検証され、手法は厳密でモデルの適用範囲も多様であり、得られた結論はアーキテクチャを問わず一貫しています。

経緯と関連報道

研究は、異なる長さのコンテキストを持つモデル間で、証拠の位置に対する感度に体系的な差異が存在することを明らかにした

2026年10月24日付のarXivに掲載された実証研究(論文番号2610.31135v1)では、長文コンテキストにおける質問応答タスクにおいて、Transformer、状態空間モデル(state-space)、およびハイブリッドMambaアーキテクチャの位置バイアス現象を比較し、Transformerモデルは一般的に開始位置の証拠を活用する優位性を示す一方で、状態空間モデルにはその特性が欠如していることを明らかにしました。一方で、両モデルとも終端位置の証拠を好む傾向が見られました。

Mixing Matters: Evidence Position Bias Across Sequence Mixers in Long-Context Question Answering

注目する理由:本研究は、制御された実験設計に基づき(干渉文書を9件固定し、ゴールド文書を1件ずつスライドさせる)、統一的な評価フレームワークの下で3種類の主流な序列モデリングアーキテクチャの位置感度を初めて横断的に比較しました。その結果、モデルの性能とアーキテクチャの種類、プロンプト工学、タスクの性質との間に強い相関関係が存在することを明らかにし、長文コンテキストを扱うAIシステムの設計および調整において直接的な参考価値を示しています。

経緯と関連報道

自然言語自動符号化器は、大規模モデルの活性化差異を効果的に言語化し、モデルの差分分析および解釈可能性の研究を支援します

2026年10月24日付のarXivに掲載された論文(arXiv:2610.30934v1)は、自然言語自動符号化器(NLAs)の活性化空間における差分表現の一般化能力を体系的に評価し、組み合わせ性、ファインチューニングによるモデル適応、ファインチューニング後のターゲット復元、およびモデル差分の専用化の四つの観点でその性能が安定していることを実証した。

Verbalizing Activation Differences with Natural Language Autoencoders

注目する理由:本研究は、3つのファミリーに属する大規模言語モデル4種を対象とした4つの再現可能な実験設計に基づき、説明可能性という新たな研究領域における「言語化」の活性化に関して、これまでで最も体系的な一般化の証拠を提示している。なお、すべての結論は論文で報告された実験設定および観測結果に厳密に限定されており、未検証のモデル規模やタスクへは外挿されていない。

経緯と関連報道

Lighthouse:米国民権運動史に特化した信頼性の高いデジタルアシスタントが初公開

論文arXiv:2610.30158v1は2026年10月24日に公開され、南カロライナ州のアーカイブデータに基づく米国民権運動期の歴史を探索するための初の専用デジタルアシスタント「Lighthouse」について紹介しています。その核心的な革新点は、信頼できるコンテンツとユーザーへの危害軽減を設計原則として掲げ、ニューラル・シンボリックハイブリッドアーキテクチャを採用し、大規模言語モデルと規則ベースのシンボリック推論を統合していることです。

Lighthouse: On Building a Trustworthy Digital Assistant for Exploring History with Civil Rights Archives

注目する理由:本研究は、AIを活用した歴史探求を初めて公民権運動という敏感かつ重要な歴史的時期に焦点を当て、一般的なチャットボットとは異なり、「信頼性」と「被害モデリング」という二重の制約を明示しました。その方法論(ニューラル・シンボリック統合)、評価手法(専門家による合意に基づく主観的設問のゴールドスタンダードを含む)、およびデータ規模(1万8千件を超える一次資料)はいずれも学術的な模範的価値を有しています。

経緯と関連報道

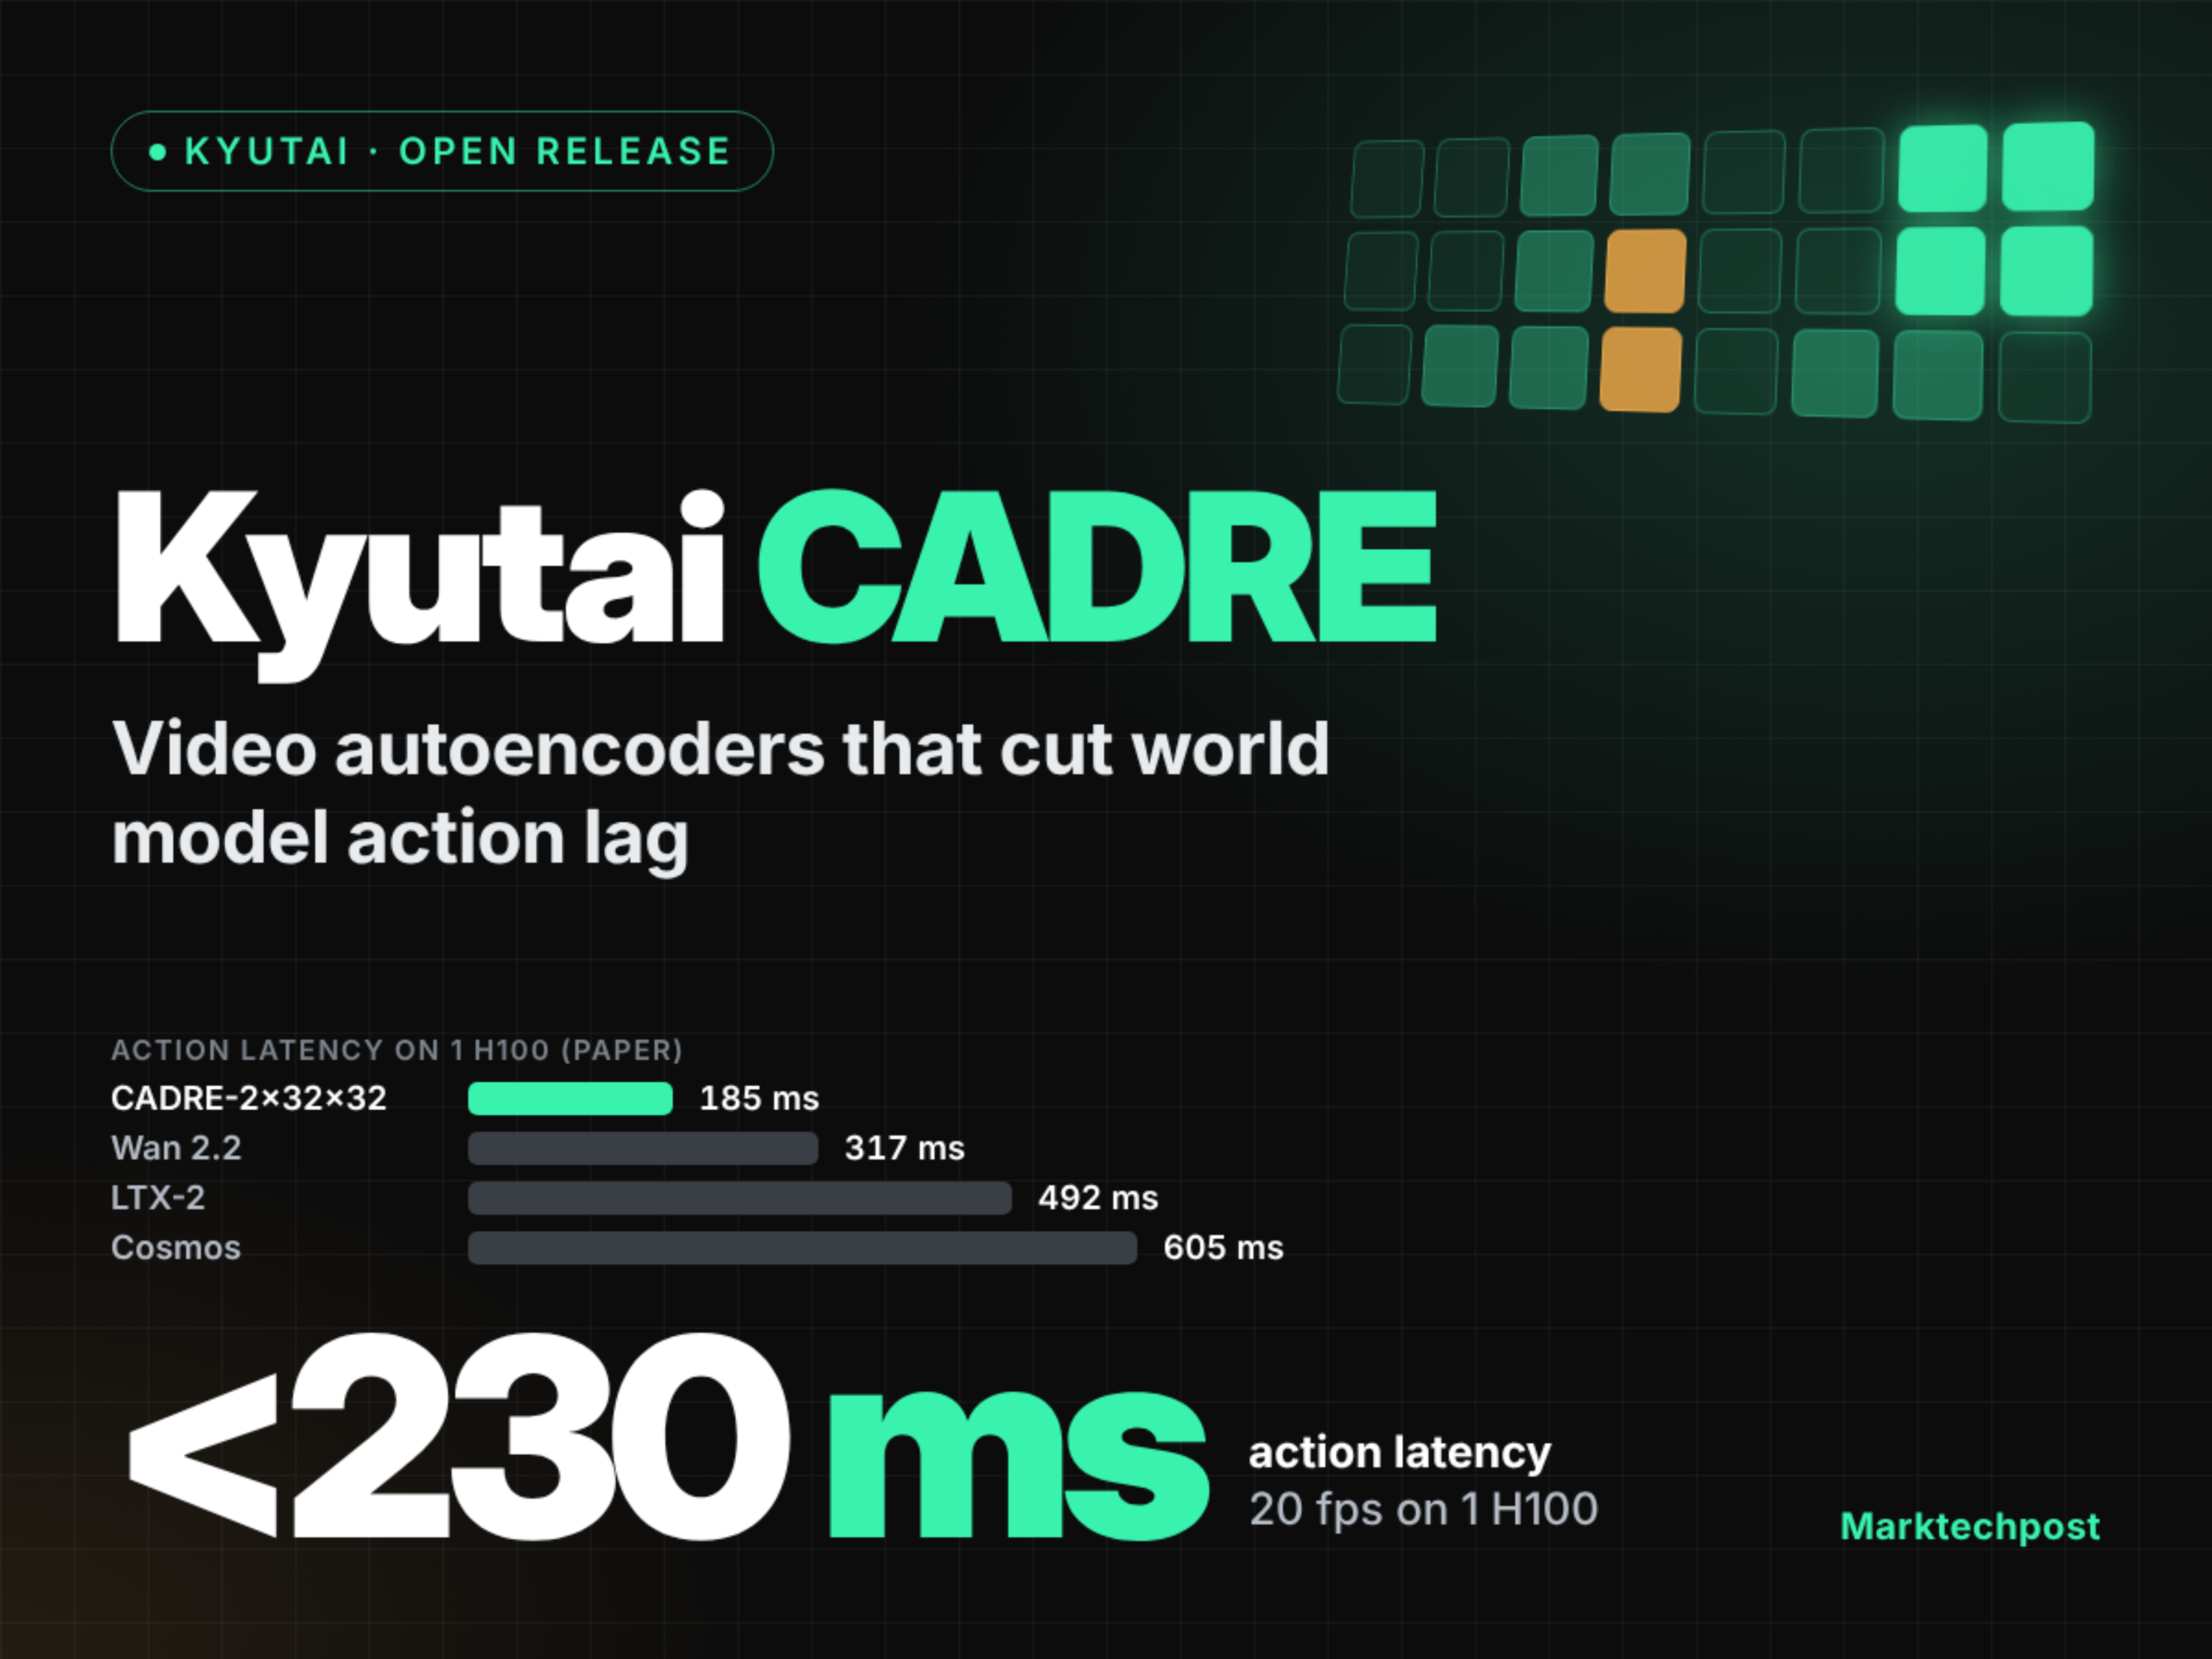
KyutaiがCADREビデオ自己符号化器ファミリーを発表:対話型世界モデル向けで、エンドツーエンドの動作遅延を230ミリ秒以下に抑えます

Kyutaiは2026年10月23日、世界モデルにおける動作遅延の低減を目的とした、7つのオープンソース因果拡散型ビデオ自己符号化器からなるモデルファミリー「CADRE」を公開しました。単一のH100 GPU上で実測した反応遅延は最低185 ms、推論フレームレートは23.4 fpsに達し、シーンFVD指標は162.6まで低下しました(Wan 2.2では599.7)。ただし、ロボット操作タスクにおける動作追従率(ARR)は、Wan 2.2およびCosmosに比べてやや劣る結果となっています。

Kyutai CADRE: Video Autoencoders That Cut World Model Lag Below 230 ms
経緯と関連報道

Blockが新たな音声AIモデル「Dessa」を発表:全工程で実際の対話を基に訓練され、対話のスタイルはややぎこちない印象です

ジャック・ドーシーが率いる企業Blockは、Dessaというエンドツーエンドの音声AIモデルを発表し、完全にゼロから構築され、人間の音声対話データのみで訓練されたと説明しています。公式に公開された対話サンプルでは、自然さとぎこちなさが混在する特徴が見られ、たとえばユーザーを「ロナウド」と誤称するなど、擬人化は進んでいるものの、まだ成熟していない対話能力を示しています。

経緯と関連報道

TechCrunch Founder Summit 2026は11月4日にボストンで開催されます。テーマは顧客獲得、チーム構築、そして合理的な拡張です。

TechCrunchとFidelity Private Sharesが共催するFounder Summit 2026は、2026年11月4日にボストンのSoWa Power Stationで開催されます。本イベントでは、プロダクト・マーケットフィットの検証、創業者のリーダーシップ、ローカル化によるスケールアップの道筋、AIネイティブアーキテクチャといった実践的なテーマに焦点を当て、Toast、Bessemer、Glasswingなどの投資機関の代表者が第一線での経験を共有します。

経緯と関連報道

Amazon QuickSight のレイヤーマップに GeoJSON のポイントおよびライン要素のサポートが追加され、位置と経路を統合して可視化できます。

Amazon QuickSight のレイヤーマップは、GeoJSON 形式の Point(点)および LineString(線)ジオメトリタイプを新たにサポートし、ユーザーは同一マップ上に店舗の位置や配送ルート、フライトの軌跡などを個別に重ねて表示できます。この機能はサードパーティ製サービスを必要としませんが、GeoJSON ファイルの構造が規格に準拠しており、キーと値が一致し、静的更新が行われていることが前提です。

経緯と関連報道

バイエル・クロップサイエンスは、Amazon Bedrock AgentCoreを基に、マルチエージェント型意思決定エンジンADEを構築しました。

バイエル・クロップサイエンスは、育種専門家、アナリスト、研究者向けの自然言語対応マルチエージェントプラットフォームであるAgentic Decision Engine(ADE)をAmazon Bedrock AgentCore上に構築し、これを既存のConnected Decision Engine(CDE)の強化層として位置付け、代替とはしていません。同システムは本番環境で稼働しており、100名を超えるR&Dユーザーにサービスを提供しています。22の分野特化型エージェントと約20のAPIツールにより、問題の約80%をセルフサービスで解決しています。

経緯と関連報道

Canvaは自社開発のAI画像生成モデル「Canva Craft」をリリースし、二段階設計のアーキテクチャを採用しています。

Canvaは、独自開発のAI画像生成モデル「Canva Craft」を初めて導入し、計画段階と生成段階の二段階アーキテクチャにより、デザインの精度・一貫性・制御性を向上させました。2K解像度および30種類以上のアスペクト比に対応し、ソーシャルメディア、マーケティングコンテンツ、デジタルアートなどの用途に適しています。

経緯と関連報道