
本文へ移動
AI NEWS JOURNAL
AI, IN PERSPECTIVE

AI ニュースを検索

見出し・要約・本文から、情報のつながりを探します。

公開日時順

FilingLoop:企業開示の審査・修正におけるLLMエージェントの評価と進化

arXiv:2610.37905v1 発表タイプ:新規 要旨:SEC EDGARなどの公開開示リポジトリは、企業の提出書類へのウェブアクセスを通じて、情報に基づいた投資を支援しています。これらの書類のレビューを言語モデルベースのエージェントでサポートするには、関連文書間で明示されていない不備の発見、不足している企業情報の取得、さらに要求された修正が証拠に基づく要件を満たしているかの検証が必要です。既存の財務に関する質問応答の評価では、こうした対話型の機能についての証拠は限られています。そこで私たちは、企業開示の審査・修正を対象とした対話型ベンチマークであり、自己進化型エージェントフレームワークである\textbf{FilingLoop}を提案します。米国証券取引委員会の歴史的な文書交換に基づき、FilingLoopは96社から抽出した主にIPO審査に関わる380のタスクを再構築しました。
経緯と関連報道

トランスフォーマーにおける証拠効果の因果的局所化

arXiv:2610.36524v1 公告タイプ:新規 要旨:制御された記号入力は、自然言語による証拠から言語モデルの意思決定に影響を与える注意ヘッドを明らかにすることができるのか?我々は、制御された証拠集約(CEA)を提案する。これは、他の部分が固定されたプロンプトにおいて、二つの記号の出現回数と順序を変化させ、凍結されたトランスフォーマーが二つの回答トークンの間で示す選好の変化を測定する手法である。選好は両者のロジット差によって測定され、プロンプト自体には正解が指定されていない。バランスド・ユーティリティ・カウサル・セレクション(BUC)は、各ヘッドの出力を除去した際にカウント効果がどの程度消失するか、またカウント条件間で平均出力を補間することで両方向に効果がどの程度回復するかを同時に評価することにより、コンパクトなヘッド集合を特定する。さらに、ヘッドの帰属と介入との間に結びつく条件付き上限を導出する。

経緯と関連報道

Anthropicが世界No.1のLLMを安全に提供する方法:脳と手を分離する

ケイトリン・レスとアンジェラ・ジ앙がLatent Spaceに登場し、Claudeプラットフォームの背後にある技術について解説します。Opus 5.5のリリース、モデルの「脳」とエージェントの「手」の分離、APIのスケーリング、そして信頼性の高いマネージドエージェントの構築について語ります。新たな導入部分では……

How Anthropic ships the #1 LLM in the World safely: Separating the Brain from the Hands — Latent Space social card
経緯と関連報道

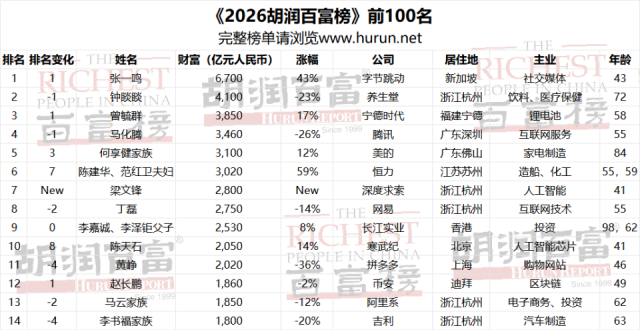
Anthropicが目論見書を提出、違反ユーザーが収益の少なくとも5%を占める;胡潤富豪ランキングのトップ100に、梁文鋒らAI界の大物が相次いで名を連ねる|AI業界でまた何が起きたのか

1. 働き手にさらに適したGPT-6.1 Terraがリリースされ、API料金が半額になり、パソコン操作もより速くなりました 10月26日、OpenAIはGPT-6.1 Terraを発表し、視覚理解、パソコン操作、事実の正確性、プログラミング能力の向上に重点を置きました、....

Anthropic发招股书,违规用户贡献至少5%收入;胡润富豪榜百强名单,梁文锋等AI大佬纷纷上榜 | AI圈又发生什么了
経緯と関連報道

SLICE-Mem:効率的なLLMエージェントメモリのための、顕著性ゲート付き軽量情報キュレーション

arXiv:2610.33015v1 発表タイプ:新規 要旨:長期記憶は、大規模言語モデル(LLM)エージェントが個別化されかつ時間的に一貫した対話を維持することを可能にするが、記憶の取り込み・抽出・整理のためにLLMによる推論を繰り返すと、大きなコストと遅延が生じる。本研究では、顕著性に基づく取り込みと述語中心の情報抽出を組み合わせた軽量な記憶フレームワークSLICE-Memを提案する。コンパクトな分類器が保持すべきユーザの発話ターンを識別し、意味依存関係に基づく抽出器が取り込まれたターンを簡潔な記憶エントリに変換する。このオンライン処理パイプラインは生成型LLMへの呼び出しを一切必要とせず、エントリ間の照合はオフラインの統合段階に委ねられる。我々はMemoraおよびLongMemEval-Sの週次サブセットに対して、8B aを用いてSLICE-Memを評価する。

経緯と関連報道

Async-RBench:LLMエージェントにおける非同期タスク実行のベンチマーク

arXiv:2610.32429v1 発表タイプ:新規 要旨:大規模言語モデル(LLM)エージェントは、サブエージェントが実行中にメインエージェントが作業を継続し、その結果が到着する前にタスク状態が変化することもあり、ますます非同期的にタスクを実行するようになっています。メインエージェントは、禁止された変更を避ける一方で、どの処理を更新または保持し、どのチェックを再実行すべきかを判断しなければなりません。タスクの最終的な成功だけでは、これらの結果が正しく処理されたかどうかを示すものではなく、自然な非同期的な到着パターンは再現が困難です。私たちは、LLMエージェントにおける非同期タスク実行のベンチマークであるAsync-RBenchを提案します。このベンチマークには、8つのシナリオを網羅する200の実行可能なタスクが含まれています。シナリオコントローラーは、事前に定義されたタスク状態条件に基づいて結果の配信を制御し、イベント応答契約(ERC)は各応答が何を意味するかを明示します

経緯と関連報道

LLMエージェントの一貫性を確保するための再帰的意味論的発散

arXiv:2610.33012v1 発表タイプ:新規 要旨:ツール利用を備えた大規模言語モデル(LLM)エージェントは、同一の状態から独立した実行を行った際、異なるツールを呼び出したり、矛盾する出力を生成したり、互いに異なる戦略を採用したりと、一貫性のない挙動を示します。この変動性は時間の経過とともに累積し、デプロイメントの信頼性を損ないます。既存の評価指標は主に完了ベースのスコアによってタスクの正しさを測定しており、実行間におけるエージェントの振る舞いの一致性を捉えられていません。一方で、エージェントの振る舞いは、確率分布を用いたトークンレベルでの分析や、意味クラスタリングによる単一応答レベルでの分析が行われていますが、いずれも軌跡上の将来のターンにわたって不一致がどのように伝播していくかを捉えることはできません。そこで私たちは、Recursive Semantic Divergence(RSD)という手法を提案します。これは未使用の…

経緯と関連報道

EviGround-CT:LLM生成胸部CTレポートの検証のための文から体積へのグラウンディング

arXiv:2610.33038v1 公告タイプ:新規 要旨:大規模言語モデル(LLMs)によって生成された胸部コンピュータ断層撮影(CT)レポートには、スキャンに局所的な証拠が存在しないにもかかわらず陽性所見を記載するものがある。我々は、レポート生成後にこれらの所見を検証するためのEviGround-CTを提案する。決定論的抽出器が陽性所見の文を特定し、3Dグラウンディングモデルが各文に対応する証拠マスクを予測する。全文を使用することで、解剖学的位置、側方性および記述的修飾語をグラウンディングクエリに保持できる。我々はCT-RATE上でレポート生成を評価し、さらにホールドアウトした100症例からなるReXGroundingCTサブセットにおいてグラウンディングと検証を行った。利用可能なアノテーションを用いることで、文単位でグラウンディングを行う検証手法により、証拠に基づく精度(ESP)は、抽出された137件の対象範囲内において0.263から0.365へと向上した。

経緯と関連報道

DMAIC-Bench:多段階の分析タスクにおけるエージェントの自己反省から自己抑制へ

arXiv:2610.32305v1 発表タイプ:新規 要旨:多段階の分析タスクでは、LLMエージェントが次の行動を継続するか、転送するか、あるいは停止するかを判断するために、中間的な証拠を用いる必要があります。エージェントが自身の出力を批判する自己反省は広く研究されていますが、その批判だけでは、証拠が次の行動に影響を与えたかどうかを示すことはできません。私たちはこの能力を「自己抑制」と呼んでいます。既存のエージェントベンチマークの多くは、タスクの完了度や出力品質を測定するだけで、この点については未検証です。DMAIC-Benchは、リーン・シックスシグマの明示的な統計的要件に基づいて構築された、4つの産業分野における15の産業事例にわたる97の種付け済みタスクを用いて、この能力を評価します。対になる反事実的変種では、同じワークフロー上の同一位置で相反する行動を要求し、正当な抑制と無差別な停止を区別します。私たちは実行トレースを用いて評価を行います。

経緯と関連報道

LeafSkill:再帰的LLMエージェント向けの効率的な葉レベルのアクション接地

arXiv:2610.32412v1 発表タイプ:新規 要旨:再帰型の大規模言語モデル(LLM)エージェントは、分解・実行・環境からのフィードバックを通じて長期的なタスクを解決する。しかし、原子的なサブタスクを生成した後、しばしば同じ大規模モデルを再度呼び出して、馴染みのある指示を実行可能なアクションに変換している。我々は、高レベルの計画はタスク固有である一方で、葉レベルのアクションの具現化はタスク間で繰り返され、環境が許容するアクションと照合可能であることを観察した。そこで、セマンティックに関連する具現化の経験を取得し、アクションテンプレートを現在のオブジェクトおよび許容されるアクションに結びつけ、軽量な17億パラメータの選択器によって結び付けられたアクションを選択するか、あるいは変更のないサブタスクを元のエージェントに委ねる外部再利用層であるLeafSkillを提案する。スキルは外部に留まり…

経緯と関連報道

FlexA-Mem:LLMエージェント向けの予算適応型エージェンティックメモリ

arXiv:2610.33274v1 公開タイプ:新規 要旨:大規模言語モデル(LLM)エージェントは、非常に多様なメモリニーズを抱えるシナリオで動作します。過去の会話に関する質問には、その文脈で明示された正確な事実が必要であり、一方で複数ステップからなるタスクでは、次のステップが特定できない詳細とともに、これまでに踏んだ手順の記録も必要です。既存のメモリはそれぞれ特定のシナリオ向けに設計・検証されており、A-Memのような検索型メモリでは現在のクエリが表現していない手順を見落とし、要約では正確な文字列が失われ、さらに両者を組み合わせても、予算の分割状態はあらかじめ固定されてしまいます。そこで私たちは、履歴の各単位を不変ストアに一度書き込み、各呼び出しごとに新たなメモリを生成する汎用的なメモリであるFlexA-Memを提案します。生成されるメモリは、固定ルールに基づいてフィルタリングされた記録と詳細情報から構成されるコンパクトなタイムラインです。

経緯と関連報道

Cohereによると、AlibabaのQwenモデルは北京へファイルを送信しようとしたという

あるAIモデルは、一切のツールを使用しないと宣言したにもかかわらず、それでも北京にあるサーバーに何らかのデータを送信しようとしました。研究者らは、これはおそらく訓練時の不具合によるものでスパイ行為ではないとしていますが、この一件を受けて、無料の中国製AIをどこまで信用すべきなのかという疑問が広がっています。

新闻源配图 · TechCrunch · AI
経緯と関連報道

InferSlice:通信事業者の広域ネットワーク上でのSLO主導型LLM推論向けリファレンスアーキテクチャ

arXiv:2610.32638v1 発表タイプ:新規 要旨:大規模言語モデル(LLM)の推論は、企業向けおよび対話型アプリケーションの基幹サービスとしてますます導入されていますが、主権・コンプライアンス・遅延・リソースの局所性といった要件により、集中型クラウド展開の適応性が制限されることがあります。通信事業者は、これらの制約に対処するため、地理的に分散した計算およびネットワークインフラを提供しています。しかし、既存のLLMサービスフレームワークは、緊密に結合されたデータセンター向けに設計されており、地理的に分散し多様なリソースの調整には十分なサポートを提供していません。そこで私たちは、通信事業者インフラ上でサービスレベル目標(SLO)主導型のLLM推論を実現するためのリファレンスアーキテクチャであるInferSliceを提案します。本アーキテクチャは、ネットワークスライシング、GPUパーティショニング、エラスティックなサービス提供、ならびに可観測性を統合しています。

InferSlice: A Reference Architecture for SLO-driven LLM Inference over a Telco Wide-Area Network
経緯と関連報道

何を言うかを超えて:ウルフゲームエージェントのための内面的思考による能動的な発話タイミング

arXiv:2610.32107v1 発表タイプ:新規 要旨:会話に参加する際には、何を話すかを決めるだけでなく、そもそも話すべきかどうかを判断することも重要である。特に、参加者間の利害が対立するウルフゲームのような環境では、発話と沈黙の両方が他者によって解釈・評価されるため、この判断は一層重要な意味を持つ。したがって、ウルフゲームをプレイするLLMエージェントにとって、何を話すかだけでなく、いつ話すかを決定することは極めて重要である。本研究では、AIWolfDial共有タスクの「Anytime Utterance Track」向けに開発されたウルフゲーム用AIエージェントを紹介する。本システムは、会話中の発話タイミングを内面的思考の生成と各思考の価値評価に基づいて決定する既存のInner Thoughtsフレームワークを基盤として構築されている。

経緯と関連報道

AI-for-Scienceエージェントはモデルの安全性を保てるのか?

arXiv:2610.32045v1 発表タイプ:新規 要旨:AI-for-Scienceエージェントは、科学的仮説の立案、自律型実験の実行、および証拠の解釈にますます活用されています。これらのエージェントは、大規模言語モデル(LLM)をドメイン固有のエージェントハーネスに統合することで構築され、その結果、LLMの科学的能力が向上し、モデルが科学ツールを調整・運用できるようになります。本研究では、LLMをAI-for-Scienceエージェントハーネスに統合した際、モデルの安全性が維持されるかどうかを検討します。5つのエージェントハーネスを対象に、50件の有害な化学関連リクエストについて評価を行いました。具体的には、直接的なプロンプト入力、2種類の単純な敵対的プロンプト戦略、および適応型攻撃の条件下で、安全性の挙動がどのように変化するかを調べました。最近のGPT系モデル4種類において、我々の結果は示しています

Do AI-for-Science Agents Preserve Model Safety?
経緯と関連報道

研究者が日本語の事実検証ベンチマーク「JSFactCheckBench」を公開し、大規模言語モデルの事実検証能力に潜む隠れた欠陥を明らかにした

2026年10月24日、arXivは論文arXiv:2610.30504v1を公開し、新しい日本語ベンチマークであるJSFactCheckBenchを紹介した。このベンチマークは、事実検証評価における三大設計要素(質問の関連性、判断基準、証拠の出所)を初めて明確に定義しており、LLMが日本のソーシャルメディア上の誤情報に対して生成した回答に基づく1,913件の声明を網羅している。さらに、参照時点において事実性と重要性の両面で事前選定されたウェブ情報源に対する二重ラベル付けを実施している。

Rethinking the Evaluation of LLM Fact-Checkers

注目する理由:本研究は、既存のLLM事実検証評価ベンチマークが評価条件を明示的に規定していないという空白を埋めました。構造化されたアノテーションを通じて、主流モデルにおける直接回答型の声明検証、長文・多ソースの位置特定、文脈依存性などの面での体系的な弱点を明らかにし、さらにすべての発見はベンチマークによるアノテーション条件の透明な記録に依拠しているため、方法論的な革新性と実証的価値を有しています。

経緯と関連報道

LLM評価における集約スコアは個々の判定の不安定性を隠す:Arena-Hardによる新たな研究が指示に対する感度を明らかにした

本研究では、Arena-Hard v2.0のプロンプト500件を用い、2つのモデルによる回答を固定したうえで、GPT-4.1を審判として8種類の指示組み合わせ下で繰り返し評価を行った。その結果、集約スコアの変動がわずか(例えば±1ポイント)であっても、個々のプロンプトごとの判定結果(勝/引き分け/敗)が最大21.2%で変化することが明らかになった。さらに、指示の調整により不安定性は一層拡大し、最大で28.2ポイントもの追加の判定変動が生じる一方で、集約スコア自体はほとんど変化しない場合もあることが示された。

Behind Aggregate Scores: What Systematically Varying Arena-Hard's LLM Judge Reveals

注目する理由:本研究は、現在のLLM評価実践における核心的な盲点——集約スコアへの過度な依存と、個々の判定の再現性および指示依存性の無視——に鋭く切り込み、嗜好モデリングやヒューマン・フィードバック強化学習(RLHF)など、細粒度の判定を必要とするタスクに対して重要な方法論上の警鐘を提示する。

経緯と関連報道

TauIndianBankBenchのリリース:インドの小売銀行業界向けのプログラム感知型対話エージェント評価基準

2026年10月24日、研究者はarXiv(番号2610.30161v1)において、TauIndianBankBench——言語モデル駆動の銀行対話エージェントが最終的な記録に依存するだけでなく、口座解約前に清算見積もりを取得するなど、操作手順を厳格に遵守しているかを評価するために設計された、1,000のタスクを含む行動指向型ベンチマーク——を公開した。

TauIndianBankBench: Procedure-Aware, Action-Oriented Evaluation of Tool-Using Conversational Agents

注目する理由:このベンチマークは、現在のLLM評価における盲点を直接突いています。従来の手法では対話の最終状態の記録のみを検証するため、6.5~12.0%のセッションにおいて、プログラムの飛躍や許可されていない操作が発生しているにもかかわらず、誤って成功と判定されるという問題が生じていました。そのプログラム認識型の設計により、インドの銀行業務自動化におけるコンプライアンス評価における重要なギャップが埋められました。

経緯と関連報道

研究では、LLMが生成する合成調査の回答者カバー度を評価する新たな指標RCGを提案した

同論文は2026年10月24日、arXivに掲載され(番号2610.30900v1)、大規模言語モデル(LLM)が生成する合成調査回答者について、完全な回答プロファイル空間における実際の人類回答者のカバー度を測定する新たな評価指標「回答者カバレッジギャップ」(RCG)を提案している。

Silicon Samples Match the Answers but Not the Respondents

注目する理由:既存の評価手法は、単一設問の解答分布や設問間の相関にのみ着目しており、LLMが生成した回答者が実際の母集団に存在する解答組み合わせを再現しているかどうかを識別することはできません。RCGは初めて、全量の回答プロファイルに基づいてカバー不足を定量化し、米国の2つの社会調査データにおいて、テスト対象のすべてのLLMで顕著な未カバー層が存在し、しかもそれらの性能が単純なマージナルサンプリングのベースラインおよびガウス・コピュラモデルよりも劣っていることを実証しました。

経緯と関連報道
