
从芯片到技能,英伟达与韩国拓展主权AI合作
英伟达与韩国科学技术信息通信部(MSIT)正在扩大双方在全国主权人工智能生态系统中的合作,涵盖从AI半导体和数据中心基础设施到人才、初创企业、模型、智能体及安全等各个领域。此次合作为韩国NPU和XPU企业探索参与英伟达NVLink Fusion生态系统奠定了基础,并包括[…]
检索标题、摘要与正文,把分散的信息连起来。
英伟达与韩国科学技术信息通信部(MSIT)正在扩大双方在全国主权人工智能生态系统中的合作,涵盖从AI半导体和数据中心基础设施到人才、初创企业、模型、智能体及安全等各个领域。此次合作为韩国NPU和XPU企业探索参与英伟达NVLink Fusion生态系统奠定了基础,并包括[…]
文章网址:https://sergeykuhne.com/blog/fighting-ai-brain-fry 评论网址:https://news.ycombinator.com/item?id=50416363 积分:83 # 评论:56
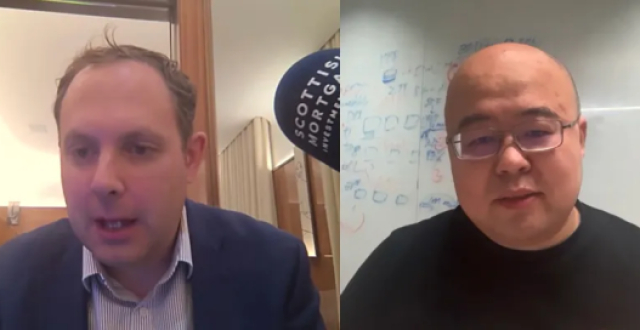
在与Scottish Mortgage投资经理劳伦斯·伯恩斯的对谈中,MiniMax创始人闫俊杰指出中国头部大模型性能已达美国顶尖模型的95%,但剩余5%的差距追赶难度极大;公司坚持极致提效,通过优化架构和自建基础设施提升算力效率,将节省成本投入后训练,目前年化收入超8亿美元,企业级业务占比超80%;创业初衷源于外公无法使用AI撰写回忆录的经历,产品线涵盖M系列(编程与智能体)和H系列(视频生成),正研发下一代M3Pro模型;闫俊杰强调中国AI生态应走高效率协作路径,坚持开源直至AGI实现,认为AGI成果应由全社会共享。
文章网址:https://velorki.com 评论网址:https://news.ycombinator.com/item?id=50419025 积分:3 # 评论:0
达里奥·阿莫迪可以说是现在硅谷最「讨人厌」的人,甚至没有之一。 在曾经共事的人眼中,达里奥是个精力旺盛、极其固执的家伙,吵完架后,他有时会一个人躲进办公室的图书室,看 YouTube 视频....
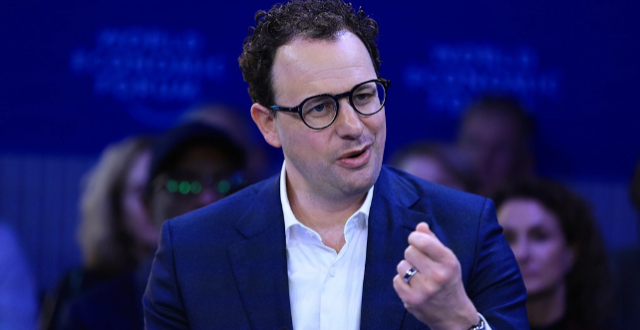
本文事实来自《纽约时报》11 月 5 日的特稿 The Making of Anthropic's C.E.O.(作者 Ryan Mac、Kalley Huang、Cade Metz、Georgia Gee)这个月 Anthropic 即将上市,会是全球最大规模的 IPO 之一。《纽约时报》发了一篇 Dario Amodei 的人物特稿,采访了他二十多位同学、朋友、老师和同事而 Dario 本人,则拒绝了本次采访...

11月5日,第九届进博会在上海国家会展中心开幕,医疗器械及医药保健展区还是很热闹,人气很旺。直观复星的达芬奇5前一直围着人,这台新一代手术机器人是第一次在中国公开亮相。诺和诺德的减重专区人也很多,诺华展台同样人气很旺。今年162个国家、地区和国际组织参展,境外企业4142家,展览面积首次超过44万平方米。全球首...
11 月 5 日,OpenAI 前首席技术官 Mira Murati 创立的 Thinking Machines Lab(TML)交出了第二代模型 Inkling 2 Small。这家成立一年半、正以 400 亿美元投前估值洽谈 50 亿美元融资的硅谷明星实验室,急需用一款足够硬核的新模型向投资人证明自己。评测机构很快给出了“中国以外最高分开源权重模型”的头衔;但当同行翻开...

Shanghai’s Fourier Intelligence built a custom humanoid for Meta’s internal research in months. The company already has a rehab business, modest humanoid shipments, and a disclosed pre-money valuation of about 8 billion yuan. A marquee partner tests its engineering—it does not yet prove the equity story.
中国AI公司正在尝试走出一条与硅谷不同的道路。MiniMax创始人、董事长兼CEO闫俊杰(IO)在首次英文播客访谈中表示,公司将坚持开源,直到实现通用人工智能(AGI);而实现盈利的关键,不是提高模型价格,而是通过技术创新持续压低推理成本。在他看来,美国AI生态依靠巨额资本和算力资源推动模型能力突破,中国公司则必须在...
面壁RSI:AI自研算子,重塑算 力底层。
Anthropic CEO达里奥·阿莫迪。图片经由AI处理文丨苏扬编辑丨徐青阳 AI公司正在变成大型基础设施买家。Anthropic的扩张路径,已经从训练模型、争夺企业客户,延伸到建设数据中心、采购芯片和协调电力资源。为了获得足够的计算能力,这家公司开始直接介入过去主要由云服务商和基础设施运营商承担的工作。美国当地时间11月2日,Anthropic向美国证券交易委员会提交更新后的招股书。文件补充了2026年第三季度相关财务数据,并披露长期采购和租赁安排。文件显示,算力成为Anthropic扩张过程中最重要的成本项。为了满足Claude模型训练和企业客户调用需求,该公司不仅与亚马逊、谷歌、微软等...

据搜索引擎圆桌会议早前报道,OpenAI、Google、微软和Anthropic表示,他们将采用一项新标准,供出版商用来选择是否被人工智能抓取。借助这一控制机制,出版商可以在多家人工智能公司之间统一应用其人工智能训练偏好,而无需逐一设置。共享的“策略令牌”信号……

GitHub于2026年10月28日发布Copilot Fusion正式版,同步推出实验性本地模型路由能力,支持在Windows设备上自动调用MAI Code 1.1 Flash等本地模型,并在VS Code、CLI及Copilot App中启用智能路由;该系统通过Standard/High/Max三档努力等级自动选择并组合云模型(如OpenAI、Anthropic、Google)执行任务,在编码评测中实现接近Claude Code的性能但成本减半。
arXiv:2610.37881v1 发布类型:新 摘要:深度伪造检测模型虽然整体准确率较高,但在不同人口统计群体之间却表现出显著的性能差异,导致某些群体的假阳性率远高于其他群体。现有的公平性感知方法通过约束模型输出以实现各群体预测的一致性来应对这一问题,但并未解决潜在的特征层面偏见。因此,这些模型仍可能依赖于诸如皮肤纹理等人口统计学特征作为检测篡改内容的间接线索。为了解决这一问题,我们提出了交叉性不变学习(IIL)框架,该框架着重改进特征学习,而非仅仅调整模型输出。IIL通过交替识别最具挑战性的群体划分
arXiv:2610.37867v1 发布类型:新 摘要:食物相似性是检索、推荐、替代等食品计算任务的基础,然而目前对食物表征的评估往往仅着眼于身份的保持。我们探讨在身份之外,食物相似性还会发生怎样的变化:不同的视觉表征如何将食物组织成具有特定关系的邻域,这些邻域又揭示或掩盖了哪些烹饪上的关联,以及这些结构在不同表征之间是否具有一致性。印度菜提供了一个颇具挑战性的场景:在视觉上相似的食物可能拥有不同的烹饪身份,而同一烹饪家族内的食物在外观上却可能存在显著差异。本文基于扩展后的Khana数据集,并使用七种涵盖卷积神经网络、Transformer等架构的预训练视觉表征,
arXiv:2610.37905v1 发布类型:新 摘要:诸如美国证券交易委员会EDGAR等公开披露数据库通过网络访问企业申报文件,为知情投资提供支持。借助语言模型智能体对这些文件进行审查时,需要发现相关文档中未明示的缺陷、获取缺失的企业信息,并验证所请求的修订是否符合有据可依的要求。然而,现有的金融问答评测难以充分反映此类交互能力。我们提出了\textbf{FilingLoop},一个用于企业披露审查与修订的交互式基准测试及自进化智能体框架。FilingLoop以美国证券交易委员会的历史往来函件为基础,从96家公司的文件中重构出380项以首次公开募股审查为主的任务。
arXiv:2610.37682v1 发布类型:新 摘要:与成对比较相比,列表式偏好反馈能够为大型语言模型(LLMs)的对齐提供更丰富的监督信号,但完整的排序结果也会暴露更为敏感的用户偏好。现有的隐私保护型对齐方法主要聚焦于成对反馈,而本地差分隐私(LDP)下的列表式对齐仍处于未被探索的状态。将LDP扩展到这一列表式场景时,面临一个关键挑战:由于完整排序空间的高度敏感性,需要引入过量的噪声,从而抵消了列表式监督的优势。为应对这一挑战,我们分析了下游训练中监督粒度与隐私噪声之间的相互作用,并提出了一种排序感知的指数机制,用于对列表式偏好进行隐私保护。
arXiv:2610.37679v1 发布类型:新 摘要:使用工具的语言模型容易受到间接提示注入的影响,而越来越多的研究试图通过探查模型内部来在不安全操作执行前将其捕获,但所得结果却存在严重分歧。我们认为,这种分歧很大程度上源于评估方法上的缺陷,并提出了一种双层评估协议:在评估与训练数据集中,将“提示注入”与“行为承诺”加以分离。在主要的Qwen AgentDojo基准测试集上,那些基于朴素的“不安全与其余”混合对比进行训练的监控器,大多仅学会识别“暴露”:它们会标记出所有被暴露的轨迹,无论智能体是否真正执行了相应操作,且几乎无法预测哪些情况最终会导致不安全行为。而当仅针对已暴露案例重新训练后,同一类探测器便能预测模型自身发出的不安全工具调用,时间延迟长达两秒。
arXiv:2610.37680v1 发布类型:新 摘要:缩小前沿模型与小型语言模型之间的差距,通常采用蒸馏方法:在前沿模型(教师)的输出上对小型模型(学生)进行微调,但这使得迁移过程依赖于训练计算,并且被迁移的知识往往难以解释。我们提出了一种名为“制品蒸馏”的方法:由教师模型解决一系列训练实例,并将其求解过程外化为一个制品库,学生在推理时直接查询该库,而无需进行梯度更新。在四项LiveBench任务中,由Claude Opus 4.5构建的制品库使Claude Haiku 4.5在空间推理任务上的表现(0.707 vs. 0.647)达到其自身成本的60%时,已超越未借助任何辅助的Claude Sonnet 4.5;而在表格连接任务上,该制品库仅以Sonnet 4.5成本的89%便达到了相同水平。同样的原始制品库还提升了