
跳到正文
AI NEWS JOURNAL
AI, IN PERSPECTIVE

搜索 AI 资讯

检索标题、摘要与正文,把分散的信息连起来。

按发布时间排序

n8n@3.0.0

# [3.0.0](https://github.com/n8n-io/n8n/compare/n8n@2.45.0...n8n@3.0.0)(2026-10-27)### 问题修复 * 在工件下载按钮上添加文件类型提示工具提示([#41490](https://github.com/n8n-io/n8n/issues/41490))([4a74f02](https://github.com/n8n-io/n8n/commit/4a74f027e612f31098b354dd3a77b2c2ab98281c)) * **ai-builder:** 检查执行权限:在 Assistant 执行读取时进行检查([#41863](https://github.com/n8n-io/n8n/issues/41863))([a967486](https://github.com/n8n-io/n8n/commit/a9674866d075e989a5ce896432262c9a7dc8b0c7)) * **ai-builder:** 通过已配置的 AI 传输通道发送 Assistant 模型调用([#41948](https://github.com/n8n-io/n8n/issues/41948))([9b63561](https://github.com/n8n-io/n8n/commit/9b63561cbb48f06d216f27be3b77722d97e4e74a)) * 支持自定义 OAuth2 范围([#41249](https://github.com/n8n-

事件进展与其他报道

n8n@2.46.0

# [2.46.0](https://github.com/n8n-io/n8n/compare/n8n@2.45.0...n8n@2.46.0)(2026-10-27)### 修复的缺陷 * 在工件下载按钮上添加文件类型提示工具提示([#41490](https://github.com/n8n-io/n8n/issues/41490))([4a74f02](https://github.com/n8n-io/n8n/commit/4a74f027e612f31098b354dd3a77b2c2ab98281c)) * **ai-builder:** 检查执行权限:在 Assistant 执行读取操作时进行检查([#41863](https://github.com/n8n-io/n8n/issues/41863))([a967486](https://github.com/n8n-io/n8n/commit/a9674866d075e989a5ce896432262c9a7dc8b0c7)) * **ai-builder:** 通过已配置的 AI 传输通道发送 Assistant 模型调用([#41948](https://github.com/n8n-io/n8n/issues/41948))([9b63561](https://github.com/n8n-io/n8n/commit/9b63561cbb48f06d216f27be3b77722d97e4e74a)) * 支持自定义 OAuth2 范围([#41249](https://github.com/n8

事件进展与其他报道

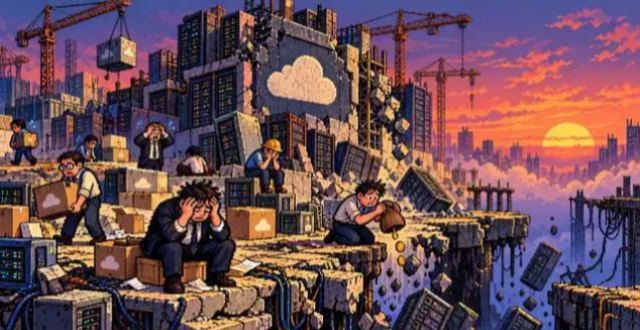
Neocloud这堵快塌的墙,黄仁勋扶,马斯克推

黄仁勋还在努力扶住Neocloud这堵墙,马斯克却已经预言了它的倒塌。AI泡沫的第一张多米诺骨牌,可能就藏在这批公司之中。10月25日,马斯克在X上发出警告:最近几周,债务市场几乎已经不再向那些缺乏AI数据中心之外实质收入的企业提供资金。他预言,200多家Neocloud将迎来“孔雀鱼式”(guppy-level)的死亡与整合,最终可能只有少数公司能够存活。但就在三天前,英伟达CEO黄仁勋给出了几乎相反的判断。10月22日,黄仁勋在接受CNBC采访时坚称,Neocloud的算力需求依然极其旺盛,真正限制它们发展的只是营运资金不足,而融资困难终将得到解决。两人都看好AI算力需求,却对经营算力租赁...

Neocloud这堵快塌的墙,黄仁勋扶,马斯克推
事件进展与其他报道

vLLM 语义路由器发布 d3-ultra:一款 270 亿参数的开源多模态决策模型

vLLM 语义路由器发布了 d3-ultra,一款拥有 270 亿参数的开源多模态决策模型。它能够一次性读取文本、图像和视频,并为每个可能的答案返回概率,在该团队的 SR-Text 测试中取得了 87.2 分。原文“vLLM 语义路由器发布 d3-ultra:一款 270 亿参数的开源多模态决策模型”首发于 MarkTechPost。

新闻源配图 · MarkTechPost
事件进展与其他报道

百度开源无限OCR 2,用于百页文档解析

百度发布了 Unlimited OCR 2,这是一款采用 MIT 许可证的 3B 参数规模的 OCR 模型,能够在一次请求中解析百页文档。其 SR-SWA 注意力机制使每步解码开销几乎保持不变,在 MarathonDocBench 上取得了 77.1 的得分。该文章《百度开源 Unlimited OCR 2,用于百页文档解析》首发于 MarkTechPost。

新闻源配图 · MarkTechPost
事件进展与其他报道

思科合作伙伴峰会:五大洞见将定义人工智能时代的渠道格局

在其30年的历史中,思科合作伙伴峰会大多聚焦于合作伙伴如何销售思科系统公司的技术。而今年在温哥华举行的这场盛会则着眼于一个全新的议题:在交易已不再是核心环节的当下,合作伙伴该如何实现盈利。思科携强劲势头亮相此次盛会,其股价正处于[…]。文章《思科合作伙伴峰会:五大洞见将定义AI时代的渠道生态》首发于SiliconANGLE。

事件进展与其他报道

AdaptTok-Indic:面向印度语言的脚本感知自适应分词

arXiv:2610.33017v1 发布类型:新 摘要:在以英语为主导的语料库上训练的多语言分词器往往会对印度语系语言进行过度切分,导致令牌序列更长,并加剧了不同书写系统之间的分词差异。我们提出了 AdaptTok-Indic,这是一种专为印度语系语言设计的自适应分词扩展方案,它将 Unicode 规范化的预处理与显式的印度语系连字处理、基于书写系统的路由策略,以及与小型 Transformer 语言模型联合训练的字节级边界预测相结合。在孟加拉语和印地语上进行评估,并额外针对古吉拉特语、泰米尔语和泰卢固语进行了测试,AdaptTok-Indic 在令牌生成密度方面优于面向印度语系的基准分词器 SentencePiece BPE,以及独立实现的 MAGNET 式基准。在五项已记录的…

事件进展与其他报道

何时以及为何使用TMA:基于工作负载的NVIDIA Hopper GPU张量内存加速特性分析

arXiv:2610.34907v1 发布类型:新 摘要:在NVIDIA Hopper架构中推出的张量内存加速器(TMA),已在生产环境中的GPU内核中得到广泛应用,但其使用却表现出明显的选择性:CUTLASS、FlashAttention-3和FlashInfer等领域的资深内核开发者仅对内核中的部分张量操作数采用TMA,而对其余操作数则退回到cp.async、直接全局加载或分布式共享内存(DSM)等方式。厂商文档虽已说明了该API,近期的微基准测试也单独刻画了TMA的吞吐性能,但这些研究均未能解答从业者实际面临的疑问:在内核中遇到某个内存操作数时,究竟是否应使用TMA?若使用,又该搭配还是不搭配集群多播?我们通过一项基于工作负载的实证研究,在H100平台上填补了这一空白。我们系统地梳理了TMA、多

事件进展与其他报道

提炼、辩论、发现:以图谱提炼的洞见为多智能体研究构思奠定基础

arXiv:2610.33366v1 发布类型:新 摘要:大型语言模型(LLMs)正越来越多地被用于支持研究思路的生成与科学发现。多智能体辩论通过汇聚多元视角来制定研究构想,为这一任务提供了一种协作式方法。然而,一个关键挑战是如何赋予各智能体独特而有意义的专业知识,以引导其贡献。受研究人员在协作过程中借鉴已有研究经验的启发,我们提出了InsightAgents框架,该框架通过从相关论文的图谱中提炼洞见,构建基于文献的研究型智能体专长。在一条研究脉络中,这些洞见能够追踪研究方法的演进、揭示潜在假设,并识别尚未解决的难题。

事件进展与其他报道

EKT-路由器:面向具身视觉-语言模型的专家证据对齐

arXiv:2610.33044v1 发布类型:新 摘要:具身视觉-语言模型必须根据部分且不断变化的观测结果来回答问题。其成功既取决于所选择的推理能力,也取决于该能力所能获取的证据。专家路由器通过调整内部计算来应对,而工具增强系统则通过获取外部证据来弥补;若单独选择其中一种方式,可能会导致合适的专家缺乏其所需的证据。我们提出了 EKT-Router,这是一种有限框架,能够同时选择能力专家、可选知识以及感知工具。基于结果的特征表示了通用专家、空间推理专家和时空推理专家之间的优势互补。一个联合效用函数在调用预算范围内对完整的专家—证据路径进行评分。获取完成后,数据包验证器会确认有效数据包

新闻源配图 · arXiv cs.CV
事件进展与其他报道

Async-RBench:用于LLM智能体中异步任务执行的基准测试

arXiv:2610.32429v1 发布类型:新 摘要:大型语言模型(LLM)代理正越来越多地以异步方式执行任务:主代理在子代理运行的同时继续工作,而任务状态可能在其结果到达之前就已发生变化。主代理必须决定哪些工作需要更新或保留、哪些检查需要重复,同时避免进行被禁止的修改。仅凭最终任务的成功并不能说明这些结果是否被正确处理,而且自然的异步到达现象也难以复现。我们提出了 Async-RBench,一个用于评估 LLM 代理中异步任务执行的基准测试,包含涵盖八种场景的 200 个可执行任务。场景控制器通过预定义的任务状态条件来调控结果的交付,而事件响应契约(ERC)则规定了每种响应应满足的要求

事件进展与其他报道

用于LLM智能体一致性的递归语义分歧

arXiv:2610.33012v1 发布类型:新 摘要:具备工具调用能力的大型语言模型(LLM)智能体,在从相同初始状态出发的多次独立运行中,表现出行为不一致的现象,例如调用不同的工具、产生相互矛盾的输出,或采取截然不同的策略。这种行为上的波动会随时间累积,从而削弱部署的可靠性。现有的评估指标主要通过基于任务完成度的得分来衡量正确性,而未能捕捉智能体在多次执行中的行为一致性。此外,对智能体行为的分析要么停留在词元层面,借助概率分布进行评估;要么聚焦于单次响应层面,采用语义聚类方法,但两者均无法刻画不一致性如何在轨迹的后续步骤中进一步传播。我们提出了递归语义发散(RSD),一种无

事件进展与其他报道

各有所不足:在不同证据状态下校准语言模型

arXiv:2610.33237v1 发布类型:新 摘要:语言模型如何判断自己是否拥有足够的证据来作答?语言模型往往会在证据不足的情况下仍给出答案。决定是直接作答还是继续收集更多证据,需要对现有证据下答案正确的概率做出精确的校准估计。然而,大多数校准研究都将输入视为固定不变,而未考虑这种估计应如何随证据的变化而调整。我们提出了“证据状态校准”,要求模型在作答前的置信度与其正确作答的概率相匹配,并且每当证据改变这一概率时,置信度也相应调整。我们提出了一种名为\ours{}(即“充分性置信度估计”)的方法,该方法通过微调

事件进展与其他报道

基于扰动的数据选择用于医学问答

arXiv:2610.33440v1 发布类型:新 摘要:从现有问答库中适配医学语言模型时,选择一个紧凑的训练子集是至关重要的一步。我们研究了基于扰动的数据选择方法,该方法利用最终层表示的高斯扰动所衍生的两种信号:预测变化频率与非翻转边际收缩。在经过共享熵预过滤后,表示敏感度优先化(RSP)通过自动均方根缩放将这两种信号进行整合,而RSP-Drop则仅依据收缩程度对候选样本进行排序。这两种选择器在筛选过程中仅使用问题和答案选项。我们在MedGemma-4B上,针对五个医学问答数据集,在保留集规模分别为64、128和256个样本的情况下对其进行了评估。在主要预算为128个样本时,

事件进展与其他报道

超越收益:用于代理技能退役的技能内化度量

arXiv:2610.32322v1 发布类型:新 摘要:LLM智能体从公共技能中心检索技能,这些中心最多可存储约10万条记录,并为众多模型提供服务。随着模型性能的不断提升,技能中心必须识别出某一模型已内化哪些技能——即该模型已不再依赖这些技能——并将其从该模型的技能库中移除;然而,目前尚无可靠的方法来衡量技能的内化程度。现有规则仅依据有无某项技能时的运行表现差异来进行判断,而这种差异往往微乎其微。无论是对于已被内化的技能,还是在模型与该技能均无法实现相应能力的情况下——我们称这种状态为“未被发现”——其收益几乎都接近于零。因此,我们改采另一种做法:暂不启用该技能,而是基于由该技能衍生的任务对模型进行评分,并且只有当另一模型确实因该技能而获益时,才信任模型在无辅助条件下的高分;因为事实上,近一半的高分都来自那些并未真正体现该技能作用的任务。

事件进展与其他报道

溶剂:用于多步逆合成的长 horizon 推理

arXiv:2610.32308v1 发布类型:新 摘要:多步逆合成反应需要通过一系列连续的反应步骤,将目标分子逐步转化为可购买的构建模块;近期的研究开始借助大型语言模型(LLM)的推理能力来解决这一任务。在最新进展中,LLM推理已进入长时序阶段:模型能够在相互依赖的各步之间持续追求目标、与环境交互并根据反馈进行调整。这一转变显著提升了LLM的能力,人工智能驱动的数学研究领域也由此取得了突破性进展。在此前沿领域,我们提出了 Solvent,一款拥有80亿参数的LLM,成功将长时序推理扩展至多步逆合成。通过两轮的后训练课程,Solvent学会了在迭代过程中穿插……

事件进展与其他报道

DMAIC-Bench:面向多阶段分析任务中智能体的自我反思与自我约束

arXiv:2610.32305v1 发布类型:新 摘要:多阶段分析任务要求大型语言模型(LLM)代理利用中间证据来决定是继续、重定向还是停止。自我反思——即代理对其输出进行批判性评估——已得到广泛研究,然而这种反思并不能说明证据是否改变了下一步行动。我们将这一能力称为“自我约束”。现有的代理基准测试大多仅衡量任务完成度或输出质量,而未对这一能力进行检验。DMAIC-Bench 通过围绕精益六西格玛明确的统计前提条件构建的、涵盖四个行业领域中15个工业案例的97个种子任务,对此进行了评估。成对的反事实变体在相同的工作流位置上要求采取相反的操作,从而能够区分有依据的自我约束与无差别的停止行为。我们采用……对执行轨迹进行评估。

事件进展与其他报道

FrontGI:基于小芯片多核系统的架构感知并行GNN推理

arXiv:2610.34911v1 发布类型:新 摘要:高性能计算的范畴已扩展至涵盖多种形态的机器学习任务。图神经网络(GNN)日益受到青睐,其应用领域不断拓展。随着图数据规模的持续增长,包括节点数量、边的数量以及嵌入维度的不断提升,DGL 和 PyG 等标准化库应运而生,旨在简化 GNN 的计算过程。这些库允许以高层次的抽象方式描述计算流程,从而显著提升开发者的生产效率。然而,随着处理器核心数的迅速增加以及多核架构的演进,这类库往往表现出较差的可扩展性,并且无法实

事件进展与其他报道

何时停止惩罚行为?用于VLA强化学习的鞅GRPO

arXiv:2610.32431v1 发布类型:新 摘要:一次失败的视觉—语言—动作(VLA)展开并不意味着所有动作都导致了失败。然而,在群体相对策略优化(GRPO)中,展开中的所有动作都会被赋予单一的轨迹级优势。这样一来,那些本可带来帮助的恢复尝试也可能与其试图纠正的错误一同受到惩罚。我们利用成功概率与策略得分的鞅理论,刻画了用于失败反馈的理想停止条件。在这些停止点上,基于保留信息的条件期望下,被移除的梯度贡献的条件期望为零。因此,截断操作既能保持参考GRPO群体梯度估计器的期望值,又能降低其协方差。其中一种停止情形发生在成功条件概率达到……时。

事件进展与其他报道

