
符合条件的ChatGPT订阅可享API积分福利
符合条件的ChatGPT订阅可享API积分福利。本月早些时候,Anthropic宣布为其Max和Team订阅用户提供一项丰厚的新福利:每月订阅用户将获得等值于100美元、200美元或500美元的(即将到期的)积分,可用于Anthropic API。
检索标题、摘要与正文,把分散的信息连起来。
符合条件的ChatGPT订阅可享API积分福利。本月早些时候,Anthropic宣布为其Max和Team订阅用户提供一项丰厚的新福利:每月订阅用户将获得等值于100美元、200美元或500美元的(即将到期的)积分,可用于Anthropic API。
据消息人士向《纽约时报》透露,一家新加坡人工智能云公司的高管被指控非法向中国出售英伟达芯片,而此人也可能是一名中国间谍。

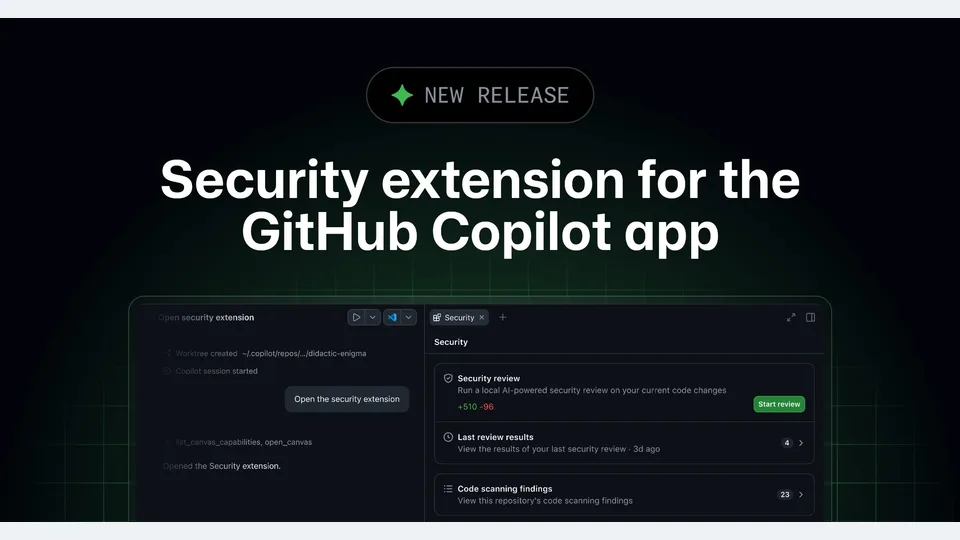
现在,您无需离开 GitHub Copilot 应用,即可处理仓库中的 GitHub 代码扫描警报。全新推出的 GitHub 安全扩展现已进入公开预览阶段,让您能够找到…… 该文章“GitHub Copilot 应用的安全扩展”首发于 GitHub 博客。
DeepSeek、Google和NVIDIA构建智能体技术栈
万亿美元招股书里的五个反常识细节
arXiv:2610.36178v1 发布类型:新 摘要:我们无需抽样误差,即可测量当被要求生成一个随机数时,语言模型为1至N之间的每个整数所分配的概率。对于固定的提示词,模型会定义一个概率向量;我们通过累加每个整数的得分拼写来计算该向量,而非采用抽样估计,从而消除了限制早期研究[1, 4]的噪声。我们在两个推理栈上,针对多达N=100的五个范围,评估了18条开放权重模型系列,并采用了29种解码配置;其中15个模型同时拥有基础版和指令微调版的检查点,且两者均能给出可用的答案。指令微调使这15对模型中的分布更加不均匀,它引入了一种避免使用整数的启发式方法,并强化了另一种避免接近端点的启发式方法。基础检查点
arXiv:2610.36353v1 发布类型:新 摘要:大型语言模型(LLMs)常常将含糊的输入当作具有单一明确含义来回答。这存在严重问题,因为输入歧义是不确定性的一个上游来源:当一个提示可能存在多种有效解释时,关键问题在于模型是否应当直接作出回应。现有的输入不确定性方法通常依赖于由大型语言模型生成的语句或澄清,但这类转换可能在测量歧义之前就已经对输入进行了消歧。我们提出了一种保留标签的扰动框架,用于检测输入歧义,在该框架中,扰动保持与原始输入相近,同时保留其标签。我们通过两种检测器对该原则进行了具体实现:一种是基于规则的黑盒扰动库
arXiv:2610.35925v1 发布类型:新 摘要:训练用于个人身份信息(PII)的上下文化掩码系统,需要能够区分某一实体类型中可掩码与不可掩码提及的示例,但隐私限制使得获取真实数据受到制约。基于作者的增强方法(SPY)会将与作者无关的提及标记为非PII,这种方法假定存在单一的数据主体,而忽视了其他可能的主体。我们提出了ReCoPII(基于关系的上下文化PII掩码),该框架无需这一假设即可构建此类数据:它规划受本体约束的实体关系,编写带有占位符的插入句,通过代码重建标注,利用独立的大型语言模型检查结果,并根据实体关系推导出MASK/KEEP标签。在来自六个领域的韩语文档上,它生成了Re
arXiv:2610.36432v1 发布类型:新 摘要:同形异义字符与不可见字符水印均属于基于编辑的水印技术。它们并非改变模型生成文本的方式,而是在文本生成之后将其隐藏于其中。具体而言,这些水印会用外观相同或极为相似但拥有不同Unicode码点的同形异义字符替换部分字符,或者插入一些不会显示的字符,且整个过程无需访问生成该文本的模型。由于分词器对文本的切分方式,生成时水印在资源匮乏的语言上表现较差。鉴于这类水印作用于单个字符,它们并不会触及分词器,因此我们不禁要问:它们是否能够绕过这一局限?我们在24种文字体系下的40种语言变体中,测量了其容量(即每个字符所能承载的隐秘信息位数),以及其中有多少……
arXiv:2610.35877v1 发布类型:新 摘要:改变部署策略可能会使世界模型的不确定性失效,而同时保持物理转换机制和预测器不变。对于一步预测而言,如果源域与目标域的条件机制 $P(Y|X)=Q(Y|X)$ 相同,则该干预可通过预结果度量的变化 $w(X)=dQ_X/dP_X$ 来识别。对于受策略控制的动力学系统,这一比率可分解为状态占用率与动作倾向性两部分。加权保形校准能够将边际覆盖率迁移至目标分布;在估计出比率 $\hat w$ 的情况下,有 $P_Q\{Y \in C_{\hat w}(X)\} \ge 1-\alpha-TV(Q,\hat Q) \ge 1-\alpha-E_P|w-\hat w|$。源域与目标域分类器的总体对数损失遗憾同样界定了这一比率误差。若 $h$ 是其剪切
arXiv:2610.36709v1 发布类型:新 摘要:推理型语言模型通过撰写长长的思维链条来解答数学问题,而针对每个问题采样多条链条并以多数投票的方式提高准确率,却会大幅增加生成文本的开销。一种常见的降本方法是根据模型对其所写每个标记的置信度为每条链条打分,这里的“标记”指一个词或词的一部分。该方法将这种置信度在滑动窗口内(2048个标记)进行平均,并依据最低平均值决定保留或终止链条。我们将逐标记记录的置信度视为一种类似于音频或无线电信号的信号,并借助频谱分析、统计检验等标准信号处理工具来检测其中是否出现突变。我们从……中为500道题目各采样了16条链条。
arXiv:2610.36668v1 发布类型:新 摘要:阿希服从实验近来作为衡量大型语言模型(LLMs)中从众行为的一种手段而备受关注。尽管先前的研究主要致力于证明大型语言模型中的从众现象,但我们的工作在此基础上进一步引入了定量分析维度。我们并未针对一系列问题对前沿大型语言模型进行抽样,而是通过反复采样同一个问题,利用大型语言模型的概率特性生成答案分布。由此,我们可以比较模型在被呈现人为制造的共识前后答案分布的变化。实验结果证实,前沿大型语言模型确实存在从众现象,这与先前文献的结论相一致;同时,借助我们提出的分布间对比方法,还提供了更多……
如果团队能够解决信任问题,AI 智能体为何能让语义层更加稳固?
LangChain 如何在 Slack 中构建了 Content Studio——一个开源的设计代理,用于制作符合品牌调性的视频、图形和演示文稿,以及为其提供动力的工具链。
Property Finder 发现,其视觉AI评估标签中有96.8%源自现有模型,这掩盖了该模型的真实准确率。了解他们如何构建无偏的真值数据、实施进化式提示优化,并在 Amazon Bedrock 上选择了一款更精准且更具成本效益的模型,从而在11项图像质量指标上将成本降低了86%。
Google DeepMind 在面向可信测试人员的研究预览中发布了 Genie 4,这是一款具备实时音频、更逼真模拟以及中期模拟文本提示的世界模型。
KOHO 解释了为何人工智能自助分析首先需要强大的数据文化以及受管控的 dbt 基础架构。
据TechCrunch独家获悉,罗希特·帕特尔在Meta从事人工智能评估与强化学习工作八年之后即将离职。他的初创公司Ndoc旨在与微软Office套件展开竞争。
有很多视觉素材可供使用和学习。