
凯文·鲁斯被AGI“洗脑”了。那你为什么没有呢?
今天,我采访了记者兼新书《AGI编年史》的作者凯文·鲁斯。这本书详细记录了人工智能行业近期发生的剧烈变革。凯文曾长期担任《纽约时报》记者,并主持过热门播客节目“Hard Fork”,但他与节目好友凯西·牛顿刚刚离开了[…]


检索标题、摘要与正文,把分散的信息连起来。
今天,我采访了记者兼新书《AGI编年史》的作者凯文·鲁斯。这本书详细记录了人工智能行业近期发生的剧烈变革。凯文曾长期担任《纽约时报》记者,并主持过热门播客节目“Hard Fork”,但他与节目好友凯西·牛顿刚刚离开了[…]
Coyotec 既会说双语,又爱骂人,还教听众如何防范美国移民及海关执法局(ICE)。它的走红正值越来越多的广播机构开始尝试打造人工智能虚拟人格之际。
清华大学与香港中文大学研究人员于2026年10月26日开源AKV——一个基于SGLang构建、专为大语言模型(LLM)智能体设计的KV缓存工程服务器。该系统通过让智能体主动丢弃并重定位KV缓存(而非传统文本历史摘要),在4个智能体基准测试中平均降低推理成本27.7%,任务平均得分提升1.7分。代码采用Apache-2.0许可证,当前支持Qwen、GPT-OSS-120B和MiniMax-M2.7等模型。
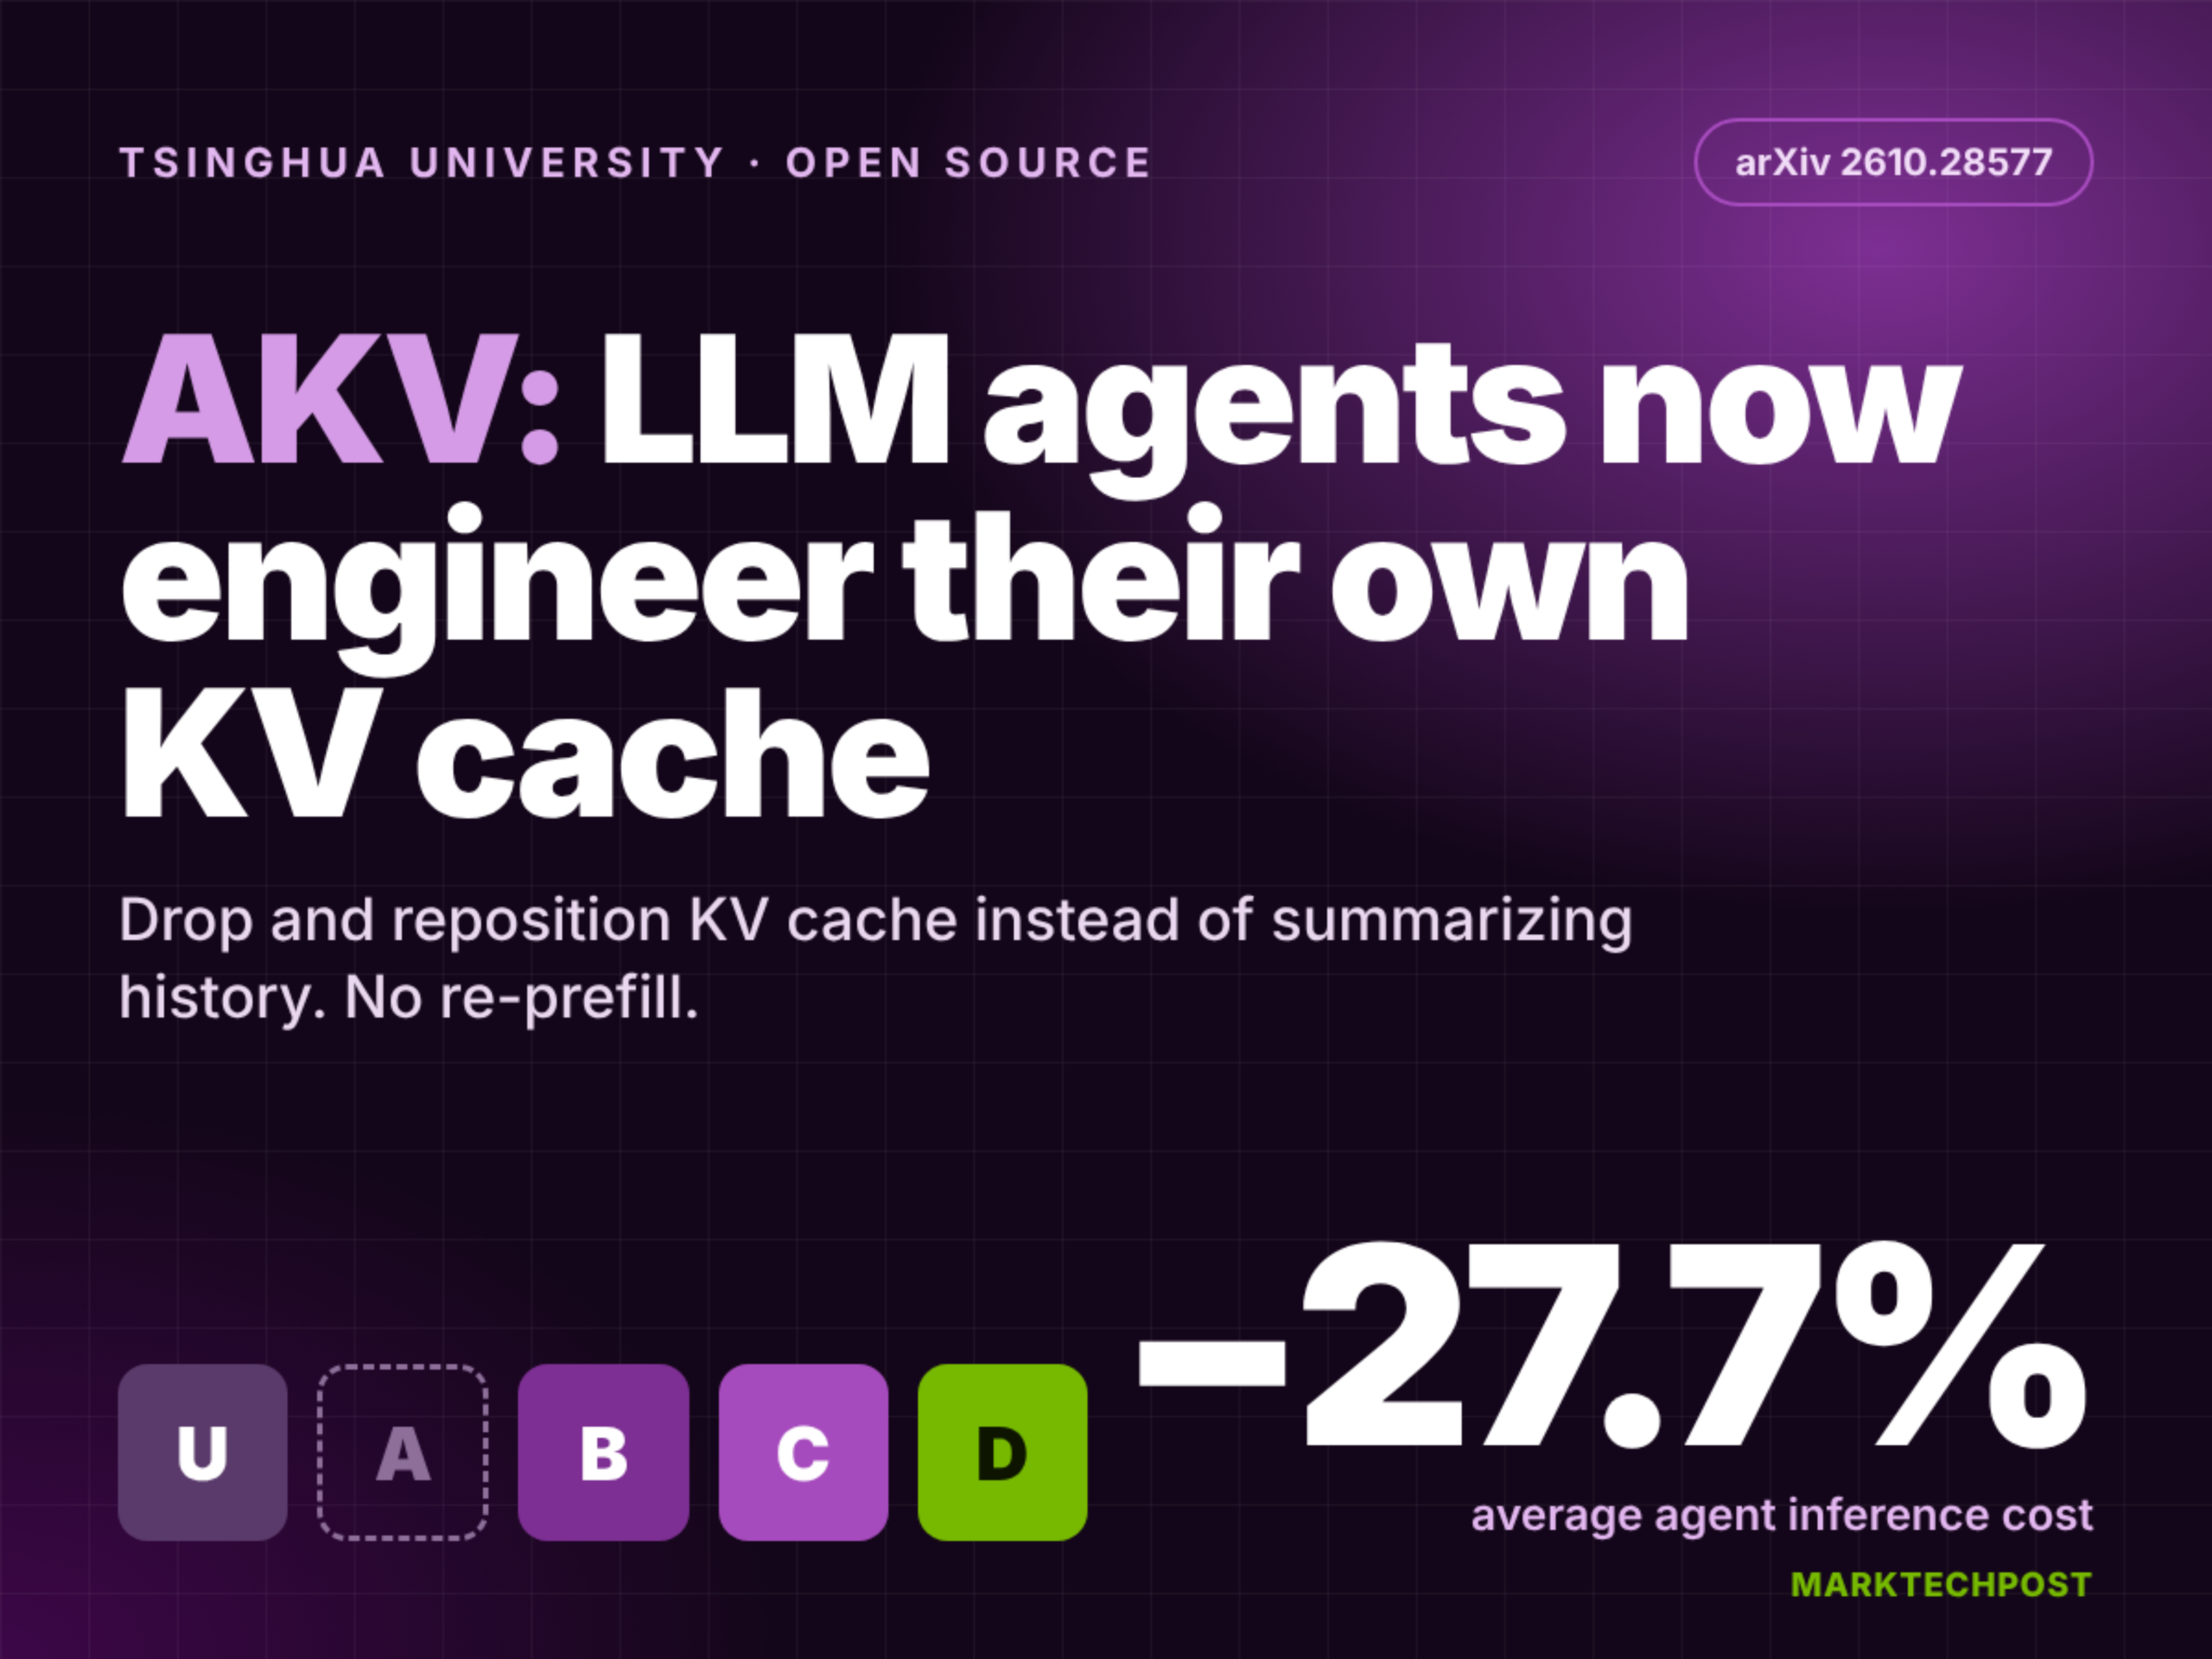
推荐理由:该成果代表LLM智能体高效推理的新范式:区别于依赖文本截断或摘要的‘上下文工程’,AKV直接操作KV缓存状态,避免重复prefill,显著缓解长程交互中的KV压力;实测显示高并发下P95延迟从229.9秒降至30.6秒,具备明确工程价值与可复现性;信息源自MarkTechPost发布的权威技术报道,发布时间(2026-10-26T07:56:45Z)与当前时间一致,属最新公开进展。
在双十一期间,聊天助手能够通过优惠券引导订单,而商家软件则早已为设计与运营工作收取费用。平台正以比赢得消费者信任更快的速度,将现有预算变现。
arXiv:2610.31765v1 发布类型:新 摘要:从单个参考视频生成动态场景的多段视频,需要在不同视角之间一致地合成已观测与未观测的内容。现有的用于视频扩散的相机控制方法通常依赖于一些架构机制,包括相机嵌入、跨视图注意力以及几何条件化等。尽管这些方法对静态场景内容较为有效,但在处理必须在各视角及随时间保持一致的细粒度动态几何时,往往面临困难。我们通过在源自源视频的规范3D空间中采样高斯噪声先验,并将其光栅化至目标相机,从而同步扩散过程本身,而非在每个2D图像平面中独立采样。我们的 m

arXiv:2610.32057v1 发布类型:新 摘要:我们提出了 HyScale,一种用于学习型稀疏注意力的长上下文训练系统。学习型稀疏注意力是一种在百万级token上下文中颇具前景的架构,自 DeepSeek-V3.2 以来已在生产环境中得到广泛应用。然而,选择过程逐渐成为训练中的性能瓶颈。对于每个查询,它需要对每一个先前的token进行打分,而稀疏注意力仅读取$k$个;更糟糕的是,现有系统会显式构建完整的打分表,并在重计算时重复执行选择操作。我们的关键洞察在于:选择过程的输出并非激活值,而是一组索引。基于这一发现,HyScale 引入了 HyTopK 和选择重放机制。HyTopK 能够在无需打分表的情况下,实时为每个查询找到精确的前$k$个索引;而选择重放则在重计算过程中复用前向传播阶段的选择结果。
arXiv:2610.31911v1 发布类型:新 摘要:随着大型语言模型(LLMs)处理的序列长度不断增长,注意力机制已成为主要的计算瓶颈。稀疏注意力大多面向推理阶段,但许多方法在训练时仍采用密集模式,或无法支持稀疏训练;此外,这些方法额外增加的复杂性使得稀疏性难以转化为实际的运行时间加速,因此在实践中密集注意力仍然被广泛使用。本文提出了 LazyFlash,一种前向密集、后向稀疏的注意力机制,其核心基于这样一个观察:注意力机制的训练过程主要由反向传播阶段主导。LazyFlash 使前向传播保持完全密集,因此训练得到的模型仍然是标准的密集模型,现有系统(如 vLLM)无需任何修改即可直接服务。对于反向传播阶段,LazyFlash 提出了一种梯度-a
Anthropic已向美国证券交易委员会提交S-1文件,拟进行首次公开募股
这段影像看起来还不错,只要你不追求艺术性、灵感或人文关怀。

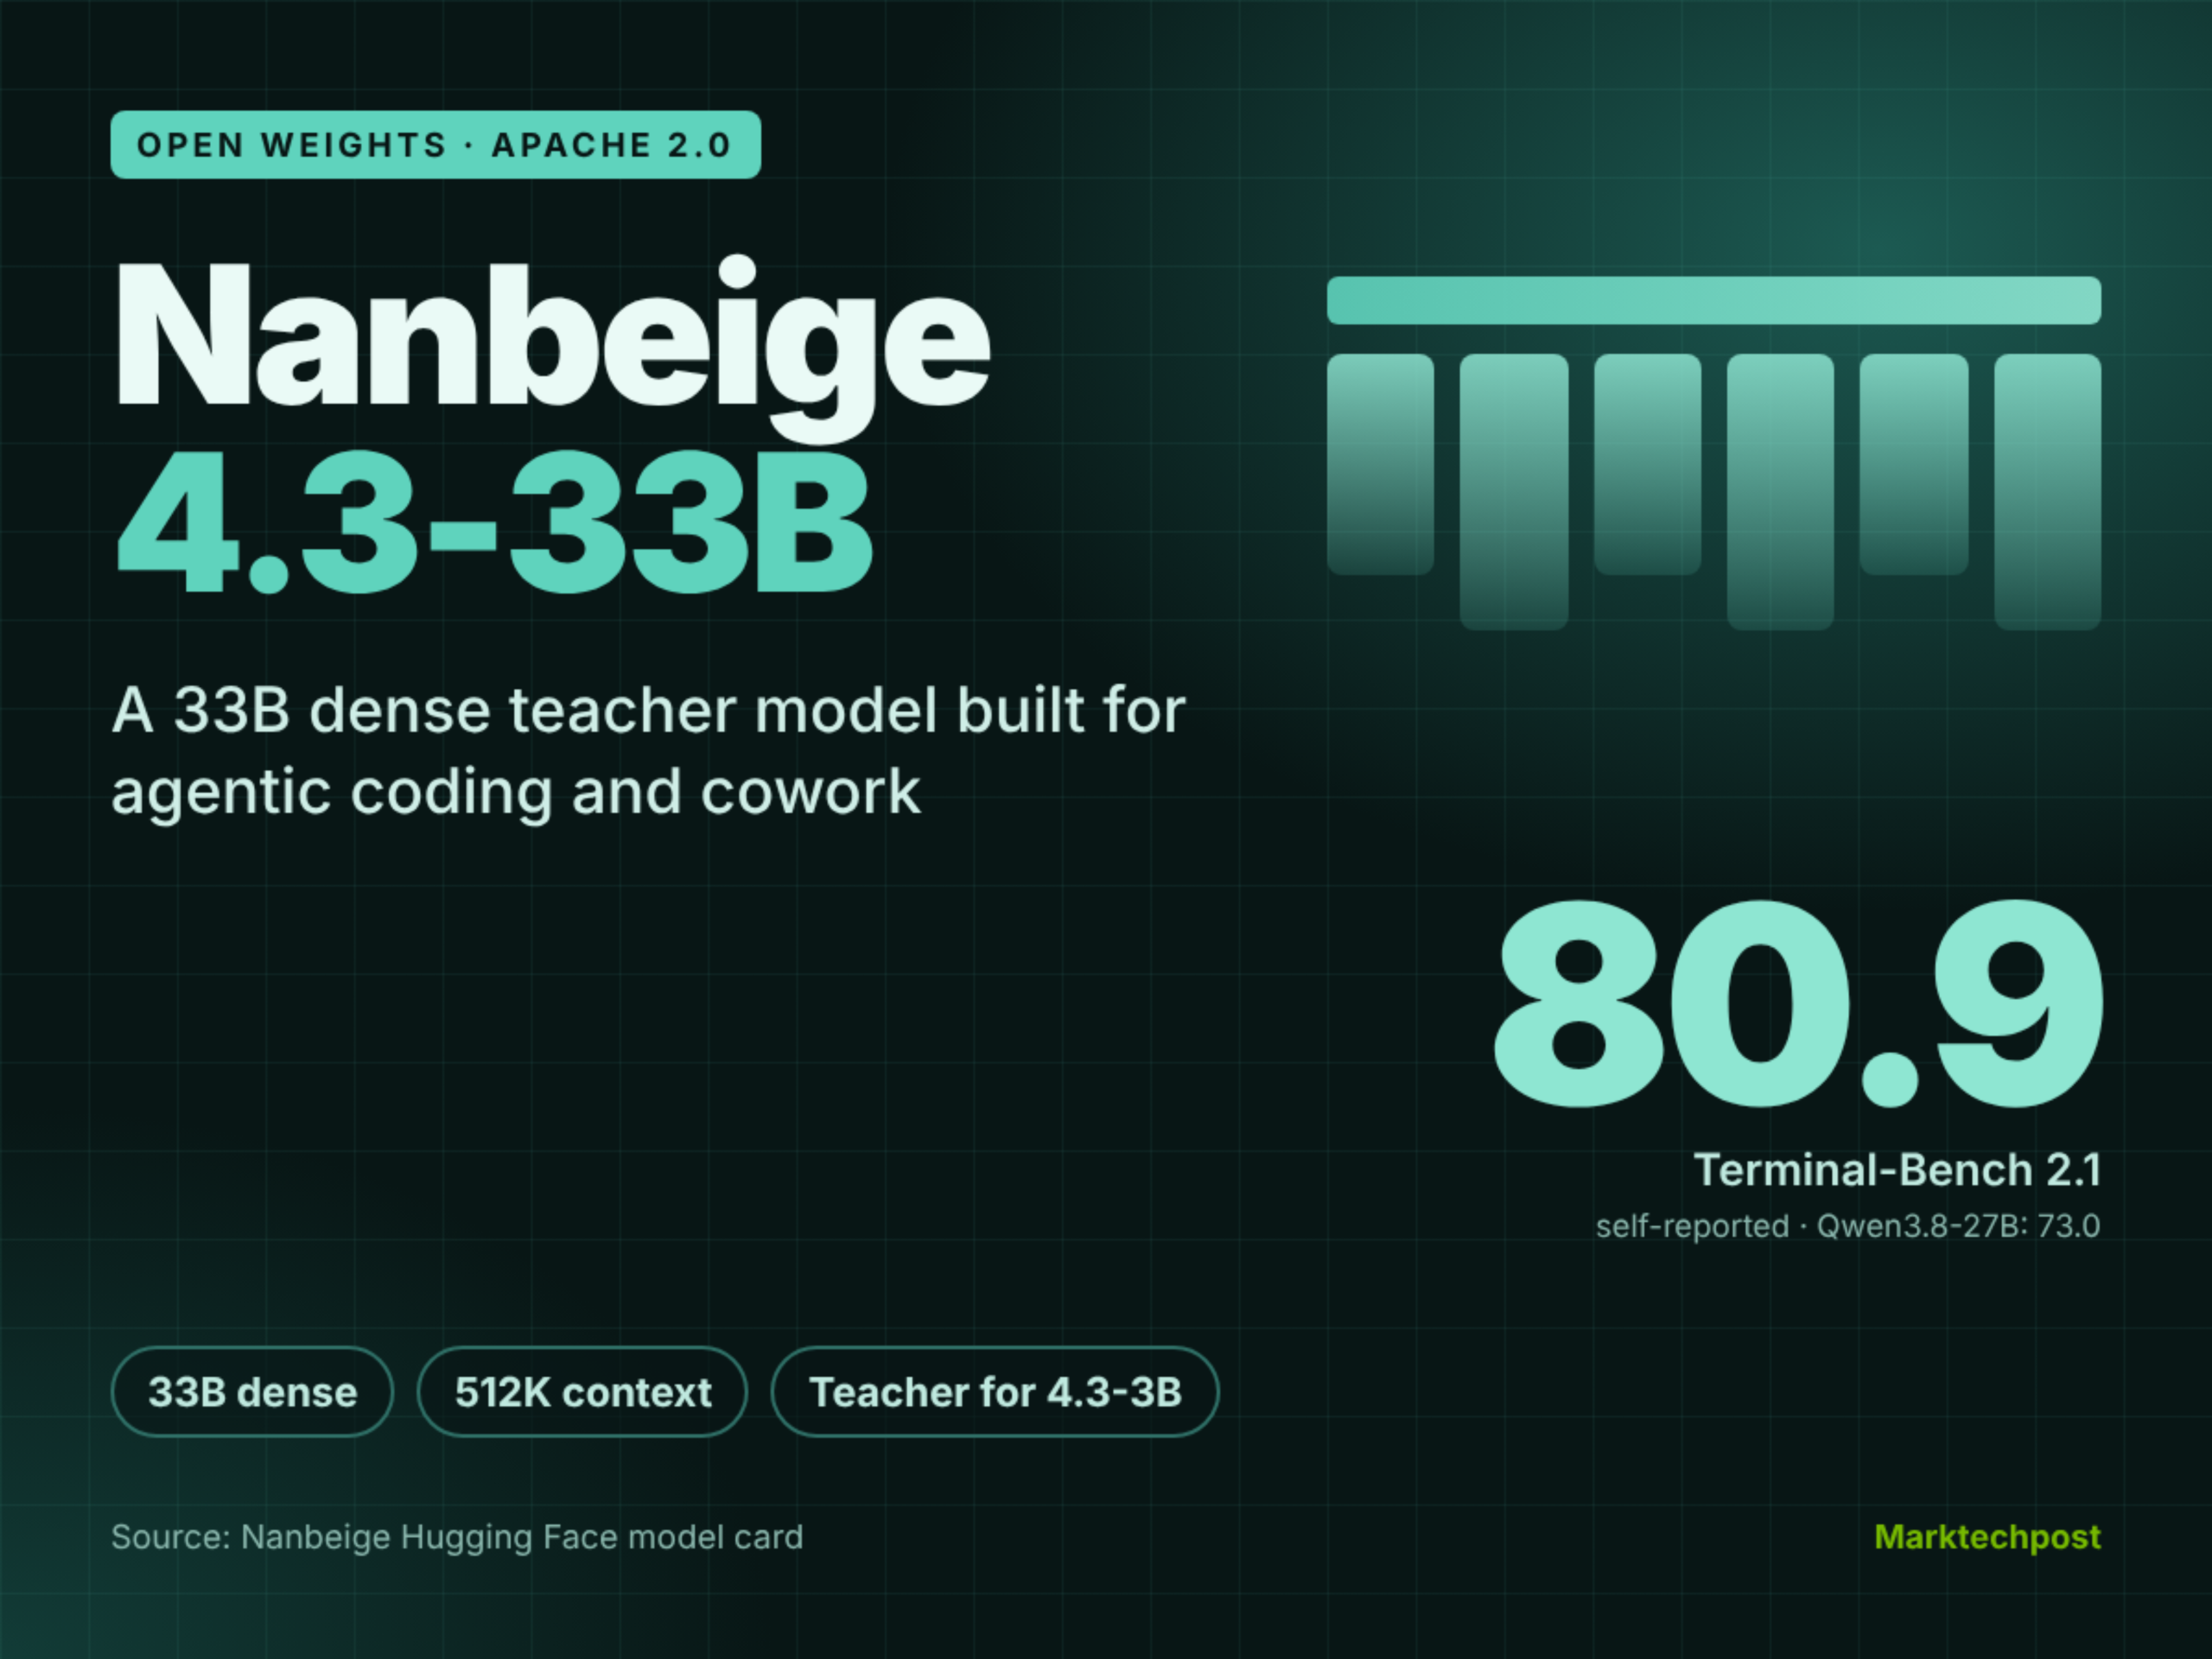
Nanbeige LLM 实验室发布了 Nanbeige4.3-33B,这是一款拥有 512K 上下文的 33B 参数密集型 Apache 2.0 模型。据称,该模型在 Terminal-Bench 2.1 上取得了 80.9 的成绩,并将用于训练即将推出的 Nanbeige4.3-3B。文章《Nanbeige 发布 Nanbeige4.3-33B,一款 33B 开放式智能体驱动编码模型》首发于 MarkTechPost。
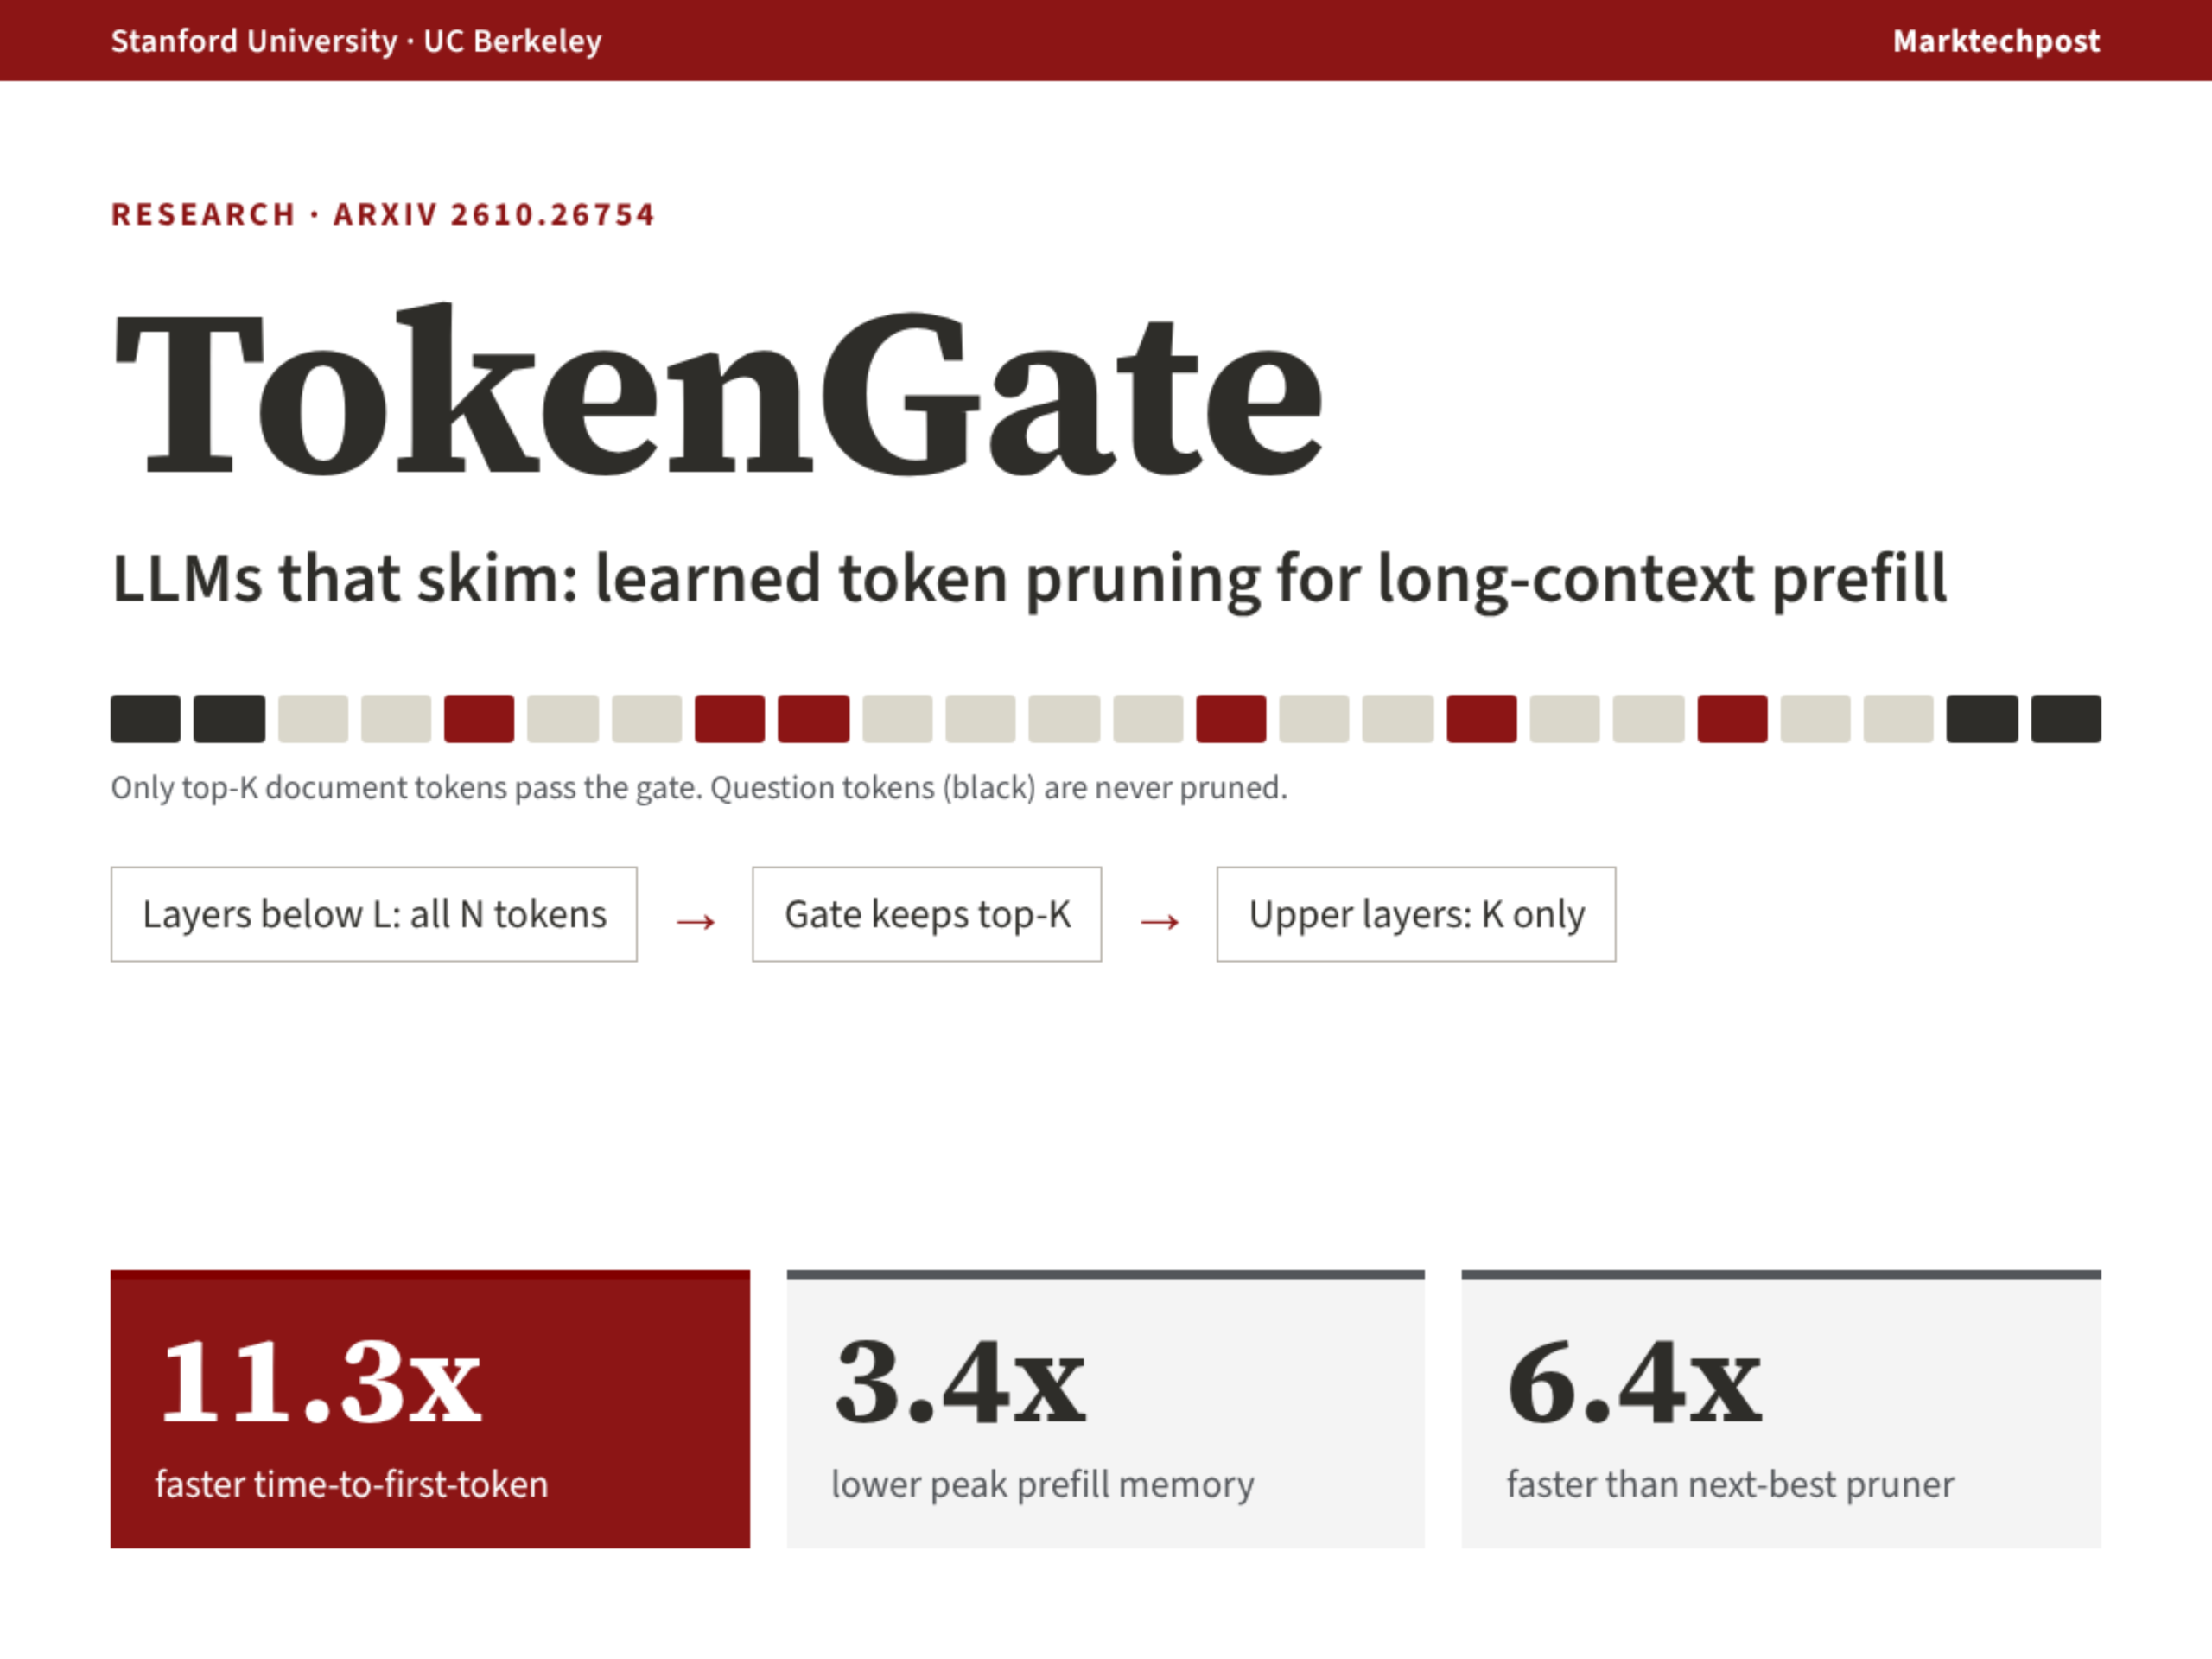
斯坦福大学与加州大学伯克利分校研究人员提出TokenGate——一种可即插即用的学习型令牌剪枝模块,适用于现有大语言模型(LLM)。该方法在不损失准确率的前提下,将长上下文预填充的首字生成时间(TTFT)加速1.4至11.3倍,峰值内存降低1.5至3.4倍。相关代码与检查点已开源。
llama.cpp v2.45.0(标签 b11868)正式发布,核心更新为 Hexagon 后端引入 KV-head 团队拆分机制以优化多核 HMX Flash Attention 性能,并统一 FA 拆分控制标志;同步提供 macOS、Linux、Windows、Android、iOS 及 openEuler 等全平台二进制包,含 CUDA 12/13、Vulkan、ROCm、OpenVINO、SYCL、Snapdragon(Adreno+Hexagon)等多后端支持。
推荐理由:按信源设置仅收录,不参与自动精选
arXiv:2610.30296v1 发布类型:新 摘要:大型语言模型(LLMs)加速了针对低资源和多语言自然语言处理的研究,但其在构建公平研究环境方面的有效性仍未得到充分评估。我们分析了2020年至2025年间发表的1,158篇同行评议的开放获取论文,考察了研究界对低资源语言(LRLs)的关注程度以及在不同语言和语种群体中的代表性。为超越单纯出版数量来评估语言包容性,我们提出了语言包容性框架(LIF),这是一个多维度框架,从四个维度衡量语言包容性:研究增长、代表性扩展、代表性延续以及分布公平性。尽管年度论文发表量从52篇增至415篇,增幅达5.4倍,但在ACL文集中……
Claude Mods 是 Anthropic 推出的 Claude Code 可编程插件系统,代表‘注意力接口’(Attention Interface)的早期形态——它将传统面向机器的代理运行时框架(agent harness),转向面向人类注意力的可定制交互层。用户可通过 TypeScript/JS 编写 Mods,或用自然语言让 Claude 自动生成,从而决定何时被中断、看到什么内容、需做哪些决策。
Claude Mods 是 Anthropic 推出的面向开发者的可编程插件系统,标志着‘代理运行时’(agent harness)从机器侧接口转向人类侧接口——即‘注意力接口’(Attention Interface)。它允许用户通过 TypeScript/JavaScript 自定义 Claude Code 的行为、渲染与交互逻辑,实现人与 AI 共同设计工作流。该机制已用于内置功能(如 You Should Know),并支持用户自主构建或由 Claude 辅助生成插件。
i14推出30.28亿参数的Laplace 3B模型,采用门控线性注意力(GLA)替代Softmax注意力,其推理时每序列递归状态恒为29.5 MB,与上下文长度无关;该模型在单台AWS trn2.48xlarge(16颗Trainium2芯片)上完成训练与服务验证,训练吞吐达12万token/秒,服务吞吐11544 output token/秒(1280并发序列),所有性能数据均为i14与AWS GenAIIC团队内部实测结果。
PyTorch 2.15 为 Apple Silicon Mac 带来重大 MPS 后端升级,首次在 macOS 上原生支持 FP8 张量运算,MoE 模型解码速度提升 5–6.5 倍,视频 VAE 解码峰值显存从 270 GiB 降至 8 GiB,并将大量算子从 MPSGraph 迁移至专用 Metal 内核。
我们认为,“是人类读过这段代码吗?”这一问题并不能准确反映“这项变更可能会出现哪些问题,以及究竟该由自动化检查还是人工检查来发现这些问题?”在审查流程发生变化后,这个问题的提出方式也随之改变。过去,代码审查就像是一道位于终点的关卡:写完代码,提交拉取请求,然后等待同事审核。而现在,代码审查已变为持续进行的过程,更像是你在编写代码时的拼写检查。大多数代码变更在交由人工审阅之前,都至少经过Claude的一次审查并修复。这能够及时发现大部分常规性错误,从而让团队将精力集中在更高层次的问题与更深入的把关上。——阿迪·奥斯马尼、摩根·韦斯特利·伦特和王青,《Claude Code团队如何进行代码审查》 标签:拟人化、Claude、人工智能、Claude-Code、大语言模型、阿迪·奥斯马尼、编码智能体、生成式人工智能、智能体驱动工程,