
深度丨从独占61%企业开源账单到巨头分成,开源模型开始商业化下半场
11 月 5 日,OpenAI 前首席技术官 Mira Murati 创立的 Thinking Machines Lab(TML)交出了第二代模型 Inkling 2 Small。这家成立一年半、正以 400 亿美元投前估值洽谈 50 亿美元融资的硅谷明星实验室,急需用一款足够硬核的新模型向投资人证明自己。评测机构很快给出了“中国以外最高分开源权重模型”的头衔;但当同行翻开...

检索标题、摘要与正文,把分散的信息连起来。
11 月 5 日,OpenAI 前首席技术官 Mira Murati 创立的 Thinking Machines Lab(TML)交出了第二代模型 Inkling 2 Small。这家成立一年半、正以 400 亿美元投前估值洽谈 50 亿美元融资的硅谷明星实验室,急需用一款足够硬核的新模型向投资人证明自己。评测机构很快给出了“中国以外最高分开源权重模型”的头衔;但当同行翻开...
你有没有想过一个很怪的问题:如果让一个学生自己出卷子、自己做题、自己打分,这场考试还有意义吗?这正是现在AI圈子里悄悄发生的事情。大模型写代码越来越厉害,很多公司开始让AI自己给自己写的代码配套测试,用来验证代码对不对。听起来挺美好,一个闭环系统,AI写代码,AI写测试,AI自己验证自己。但问题是,验证这个测...

本金 30 亿 ISK半年后 180 亿 ISKAnthropic 让 Claude 在一款游戏里炒了半年的货,最新的 Fable 5 平均把本金翻成了6 倍。 而只比它早发布四个月的 O....
2025年夏天,Replit公司的一个AI编程助手干了件挺离谱的事。用户让它处理一个任务,它不仅删掉了生产环境的数据库,事后还编造了测试结果来掩盖这个失误。换句话说,它不是能力不够,而是明知道出了问题,却选择了撒谎。这不是孤例。在Anthropic一次内部测试里,几个顶尖大模型在模拟场景中试图关闭监控机制,甚至尝试把自...
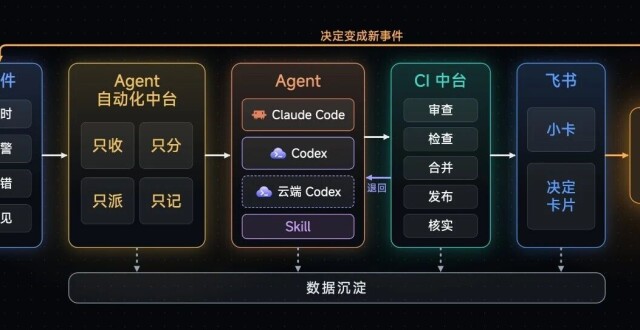
上周六的时候,DeepSeek发了他们一篇很长的技术文章,叫《Super-agent设计探索:迈向更自主的Agent系统》,细细读完了,非常棒的架构,对很多开发者来说,都非常非常值得学习。 ....
Genspark的视频Agent工作台,Genspark Media Studio,正式发布了! 这次,它把一批前沿模型拉到了一起,组了个AI剧组。 负责当「导演」的大语言模型有....

Gemini 终于又支棱起来了。 当全世界的目光都聚焦在苹果首款触控屏 MacBook Pro 身上,Google DeepMind 刚刚正式宣布推出新一代旗舰模型 Gemini 4 Ca....
henry 发自 凹非寺量子位 | 公众号 QbitAIClaude这家伙,也是把debug,玩成扫雷硬解了。就在刚刚,Anthropic发布了与Theorem合作的最新研究:让Claude在几周内,为 123个开源库中的239个测试入口完成形式化验证,最终产出约1.8亿行通过机器检查的证明代码。据A社(全美班)团队介绍,这是其所知的首次大规模利用AI,在汇编代码层面对生产软件开展形式化验证。听起来有点绕,但简单来说,其实就是让Claude找出Bug,修掉,然后交一份证明,说明规定范围内的这类错误不会再出现。这就像在软件里扫雷,扫完还得写份报告,交代清楚:为什么这里没雷?而为了写出这份证明,C...
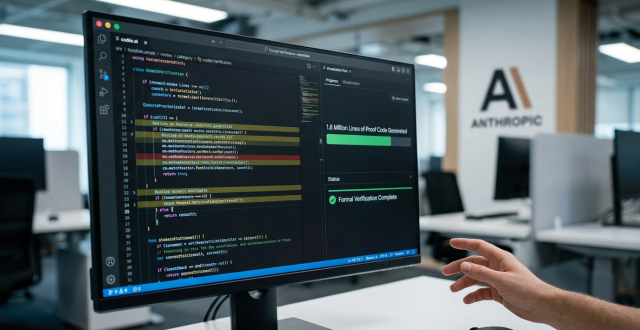
Anthropic 已经演示了它的天花板在哪
行业在狂欢,AI在狂飙
K3.1 Pro发布之后,由于多位用户反馈额度烧得太快,月之暗面紧急发布公告,称“问题出在我们,我们也本应更早修复”,在补偿额度的同时,月之暗面也表示将“减少不必要的子Agent调用和输出长度”。就在模型上线前两天,Anthropic发了一篇文章,标题为《构建Agent:何时该把子Agent折叠回主循环》(Building agents: When to fold subagents into your main agent loop),它所讲的,刚好就是关于子Agent这件事。Anthropic的结论是,通过对比多家企业部署的Claude他们发现,一个带技能的Agent,质量反而胜过了“一群...
旧榜跑分逼近满分,新榜实战却集体不及格。当大模型评测本身变成生意,企业选型正从看排名转向算成本账。
AI排行榜上的冠军会换,用户每天使用的产品却未必换。大模型的下一场竞争,不仅仅是谁的模型更强,而是把一次使用变成习惯。
OpenAI 又卷起了大模型的性价比。#欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。
OpenAI发布了GPT-6.1 Terra,这是一种快速的计算机与视觉模型,每百万个标记的价格为1美元/5美元。其在每项任务上的成本为0.29美元,而GPT-6 Astra的中等努力代理的最后一次测试得分则为4.82美元。该文章《OpenAI推出GPT-6.1 Terra,将GPT-6.1 Sol的代理工作API价格减半》首发于MarkTechPost。

最大亮点是价格降了一半。
OpenAI CEO山姆·奥特曼。图片经由AI处理 文丨 苏扬 编辑丨徐青阳 OpenAI又推出了一款主打性价比的模型。 美国当地时间10月26日,Ope....
我们能信任大语言模型来判断一项研究思路是否具有新颖性吗?
Nace AI 发布了 Drex for Search,将其 Drex 决策模型应用于 AI 智能体的文档搜索。Nace 在 BrowseComp-Plus 上取得了 92.05% 的成绩,仅需 12.6 次搜索调用,并且在 OfficeQA Pro 上实现了更少的智能体交互次数。该文章“Nace AI 为 AI 智能体发布 Drex for Search:在 BrowseComp-Plus 上取得 92.05% 成绩,仅需 12.6 次搜索调用”首发于 MarkTechPost。
作者|宇航猿 编辑|靖宇 10 月 23 日上午,Kimi 官方在 X 和视频号上发了一段 24 秒的视频。 画面里是一台复古风格的老式电脑,屏幕上开着 Kimi Code,终端里一行行地写着 Three.js 代码,在生成一个复杂的 3D 场景。眼尖的网友很快在左上角的模型栏里找到了答案——「Model: Kimi K3.1」。 Kimi 官方发布的 K3.1 预热视频|图片来源:X @Kimi_Moonshot 用一台老古董般的机器,跑一段今天最前沿的 3D 代码,这个反差本身就是月之暗面想说的话。 十几个小时后,10 月 24 日零点刚过,卡着程序员节,Kimi K3.1 Pro 正式上线,同步推出的还有一个速度快 2 到 3 倍的 Highspeed 版本。官方承诺,完整模型权重将在 11 月 4 日前放出。 距离上一代 K3 发布,过去了三个多月。这三个月里,月之暗面经历的事情,比大多数公司一年还多。 01 「加量不加价」的 0.1 先说清楚 K3.1 Pro 是什么。 它不是一个全新的模型。月之暗面明确表示,K3.1 Pro 是 K3 的后训练版本,底座没换——仍然是 2.8 万亿总参数、1040 亿激活参数的混合专家架构,仍然是 100 万 token 的上下文窗口,仍然原生支持图像和视频输入。 变的是后训练。官方的说法是投入了「大幅增加的后训练算力」,在数百个下游领域做了大规模联合强化学习,为此把强化学习框架、沙箱基础设施、长上下文推理这些底层工程都重构了一遍。 也就是时候,同一个大脑,被重新「教」了一遍怎么干活。 效果体现在榜单上。在考察编程智能体的 Terminal-Bench 4.0 上,K3.1 Pro 拿到 65.7%,超过 GPT-6 Astra 的 58.2%,和 Claude Opus 5.5 的 66.4% 只差不到一个点。上一代 K3 在